
OpenAI, Google, dan Anthropic semuanya membangun teknologi yang sama: watermark statistik untuk teks yang dihasilkan oleh AI. OpenAI menahan versi miliknya selama bertahun-tahun dan mulai merilisnya, sebagai textGrain, pada Oktober 2026. Google menyertakan SynthID di dalam Gemini dan mempublikasikan metodenya. Anthropic membuat watermark Claude menjadi wajib untuk setiap pengguna pada Agustus 2026. Jika Anda menulis dengan bantuan AI dalam bentuk apa pun, ketiga keputusan ini sekarang menentukan bagaimana dokumen Anda dinilai.
Watermarking beralih dari topik riset menjadi berita arus utama pada 11 Agustus 2026, ketika Anthropic mengumumkan bahwa setiap model Claude baru menandai keluaran teksnya. Kami membahas pengumuman itu secara mendetail di penjelas watermark Claude. Panduan ini mencakup gambaran lengkap: apa itu watermark teks, bagaimana masing-masing dari tiga lab besar menerapkan atau menahannya, dan apa yang dibuktikan oleh tiap sistem tentang sebuah karya tulis.
Apa itu AI text watermark?
AI text watermark adalah pola statistik yang tersembunyi dalam pilihan kata dari teks yang dihasilkan, ditanam pada saat proses pembuatan sehingga sebuah detektor yang memiliki kunci yang tepat dapat memverifikasi kelak bahwa teks tersebut berasal dari sistem AI tertentu. Ini bukan label yang terlihat, bukan karakter tersembunyi, dan bukan metadata yang menempel pada sebuah file. Tanda tersebut berada di dalam kata-kata itu sendiri.
Perbedaan itu penting, karena istilah "watermark" dipakai secara longgar untuk tiga hal berbeda:
| Apa itu | Berada di mana | Apakah bertahan saat salin-tempel? | |
|---|---|---|---|
| Statistical watermark | Bias di mana model memilih kata | Teks itu sendiri | Ya |
| File metadata (C2PA) | Label asal yang ditandatangani | Wadah file | Tidak, penyalinan teks biasa akan menghilangkannya |
| Karakter berlebar nol | Unicode tak terlihat disisipkan ke dalam teks | Di antara karakter yang terlihat | Tidak, dihapus dengan sangat mudah |
Penyematan watermark statistik adalah satu-satunya dari ketiganya yang bertahan dari penyalinan, penempelan, pengetikan ulang, ke dokumen baru, dan konversi format. Itulah sebabnya ketiga lab besar sepakat menggunakannya untuk teks, dan mengapa "penghapus watermark" yang menghapus karakter tak terlihat tidak berpengaruh terhadapnya. Halaman penghapus watermark Claude gratis kami mendokumentasikan kegagalan ini beserta sumbernya.
Bagaimana watermarking statistik sebenarnya bekerja?
Pada setiap langkah menulis sebuah kalimat, model bahasa memilih di antara beberapa kata yang hampir setara, dan sebuah watermark diam-diam memuat dadu-dadu itu. Resep dasarnya diterbitkan oleh Kirchenbauer dan rekan-rekannya di University of Maryland pada Januari 2023, dalam A Watermark for Large Language Models (ICML 2023). Cara kerjanya seperti ini:
- Sebelum setiap kata dipilih, sebuah kunci rahasia yang diturunkan dari kata-kata sebelumnya membagi kosakata menjadi himpunan yang dipreferred dan himpunan netral.
- Model mengarahkan pilihannya agar condong ke himpunan yang dipreferred. "Suggest" alih-alih "indicate". "Across" alih-alih "among". Setiap pilihan individual terlihat sepenuhnya alami.
- Sebuah detektor yang menyimpan kunci menghitung seberapa sering teks masuk ke himpunan yang dipreferred. Penulisan manusia mencapai tingkat yang diharapkan karena kebetulan. Teks yang diwatermark mencapai tingkat itu jauh terlalu sering, dan uji statistik menandai ketidaksesuaian tersebut.
Tidak ada satu kata pun yang menjadi bukti apa pun. Sinyal muncul hanya ketika mengumpul puluhan atau ratusan pilihan, itulah sebabnya bagian bacaan yang lebih panjang lebih mudah diuji daripada yang pendek, serta itulah sebabnya deteksi selalu bersifat probabilistik, bukan cap ya atau tidak.
Sistem produksi Google DeepMind, yang dipublikasikan di Nature pada Oktober 2024 sebagai Skalabel watermarking untuk mengidentifikasi keluaran model bahasa besar, menyempurnakannya dengan teknik bernama tournament sampling, yang menjaga kualitas teks cukup baik agar bisa berjalan diam-diam di dalam produk konsumen pada skala besar. Artikel itu penting melampaui Google: inilah basis yang dipublikasikan yang Anthropic rujuk untuk implementasi Claude.
Kelemahan utamanya telah dipublikasikan sebelum sebagian besar penerapan dilakukan. Pada Maret 2023, Krishna dan rekan-rekannya menunjukkan dalam Parafrase menghindari detektor teks yang dihasilkan AI (NeurIPS 2023) bahwa mengganti susunan kata dari sebuah paragraf membuat deteksi runtuh lintas metode, termasuk watermarking. Sinyal berada pada urutan token yang tepat dan tidak di mana pun selain itu, jadi apa pun yang menulis ulang urutan tersebut, termasuk editor manusia, menulis ulang buktinya. Setiap vendor yang mengirimkan watermark saat ini menyatakan keterbatasan itu dalam dokumentasinya masing-masing.

OpenAI: perusahaan yang menciptakannya dan merilisnya paling akhir
OpenAI sudah memiliki watermark teks yang berfungsi selama bertahun-tahun dan memilih untuk tidak merilisnya hingga Oktober 2026. Scott Aaronson, saat itu bekerja pada aspek keamanan di OpenAI, pertama kali menjelaskan idenya secara terbuka pada sebuah kuliah November 2022. Metode ini memberi bias pada pilihan model di antara kata-kata yang hampir setara dengan fungsi kriptografis rahasia, sehingga teks itu sendiri menunjukkan asalnya. Kuliah itu lebih tua daripada setiap sistem yang sudah diterapkan.
Pada bulan Mei 2024, OpenAI menjelaskan kondisi proyek tersebut dalam pembaruan provenance-nya, Memahami sumber dari apa yang kita lihat dan dengar di internet. Perusahaan itu mengatakan metode text watermarking-nya akurat dan efektif untuk suntingan kecil, tetapi mereka menunda rilis sambil mempertimbangkan pertukaran risikonya. Dua dari risiko yang dinamai OpenAI sangat relevan bagi penulis akademik:
- Mudah dihindari. Parafrasa atau menerjemahkan teks menghilangkan tanda tersebut, persis seperti yang diprediksi riset pada 2023. Watermark yang terutama hanya menangkap orang yang tidak tahu bahwa watermark itu ada merupakan alat penegakan yang lemah.
- Dampak yang tidak proporsional pada penutur non-Inggris sebagai bahasa pertama. OpenAI menyatakan bahwa watermarking dapat menstigmatisasi penggunaan yang sah atas AI sebagai bantuan menulis bagi orang yang menulis dalam bahasa kedua. Tulisan kami tentang mengapa AI detector menandai penulis non-native membahas masalah yang sama dari sisi detector.
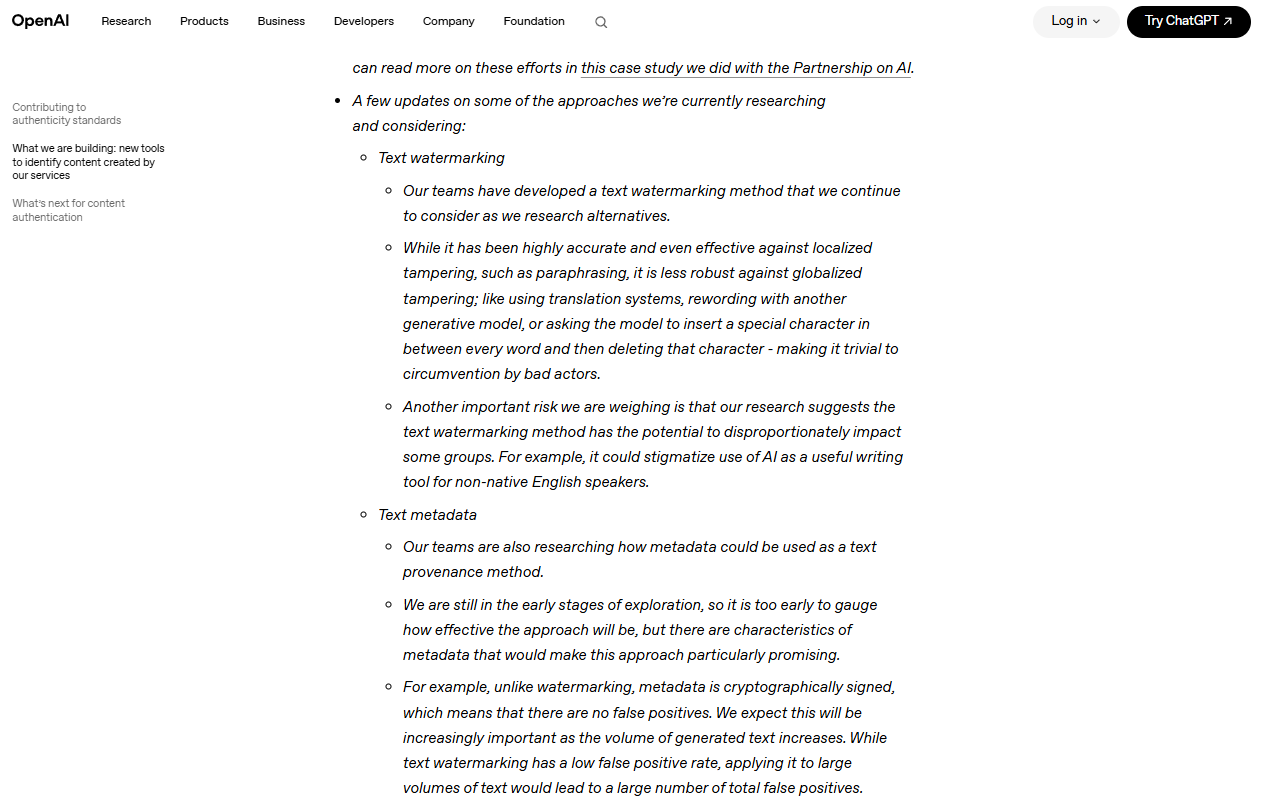
Pembaruan provenance OpenAI tahun 2024: metodenya bekerja, dan perusahaan mencantumkan alasan mengapa mereka menahannya saat itu.
Untuk gambar dan audio, OpenAI mengambil pendekatan yang berbeda: metadata provenance C2PA pada output DALL-E dan Sora, yaitu label pada tingkat file, bukan tanda pada konten. Untuk teks, output ChatGPT tidak memiliki watermark hingga Oktober 2026. Perusahaan yang mengusulkan teknologinya adalah yang terakhir dari ketiga pihak tersebut untuk menerapkannya.
Apakah OpenAI sekarang memberi watermark pada teks?
Ya, OpenAI mulai memberi watermark pada sebagian teks pada 5 Oktober 2026, sebagai respons terhadap EU AI Act. Pengumumannya pengumuman memperkenalkan text watermark bernama textGrain, yang menambahkan sinyal statistik tak terlihat pada pilihan kata model. Peluncurannya memiliki tiga bagian, dan watermark tersebut bukan default global:
- Pelanggan API di mana pun bisa mengaktifkan output yang ber-watermark untuk model tertentu. Secara default, fitur ini tetap mati.
- Dalam beberapa minggu berikutnya, output teks ChatGPT dan Codex yang memenuhi syarat di Uni Eropa mendapatkan watermark, di semua paket.
- Peneliti yang disetujui dan organisasi ahli dapat mengajukan permohonan akses ke detektor text watermark.
OpenAI mengatakan textGrain mencocokkan atau mengungguli metode lain yang mereka uji, termasuk SynthID milik Google untuk teks. Mereka juga mempublikasikan di mana proses pendeteksian menjadi lebih lemah. Dengan tingkat false-positive 1%, detektor mengidentifikasi watermark pada sekitar 80% cuplikan 200 token dan sekitar 95% cuplikan 400 token pada konten psikologi. Untuk matematika, tingkat deteksinya jauh lebih rendah, karena pilihan kata lebih terbatas.
Proses editing melemahkan sinyal dengan cepat. Pada cuplikan 400 token, mengganti 10% kata dengan sinonim menurunkan deteksi dari sekitar 92% menjadi 66%, dan mengganti 25% menurunkannya menjadi 17%.
OpenAI juga mengecek apakah watermark mengubah kualitas jawaban pada Astra, model terbaru mereka, dan mengatakan tidak ada perbedaan yang bermakna. Ini empat dari benchmark yang mereka publikasikan:
| Benchmark | Tanpa watermark (Astra) | Dengan watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 poin | 49.76 poin |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Bagi siswa, tanggal itu penting. Teks ChatGPT yang ditulis sebelum peluncuran, atau di luar Uni Eropa tanpa pengaturan API, tidak memiliki watermark OpenAI. Panduan kami untuk Penjelasan Turnitin Clarity membahas bagaimana sekolah menyiapkan kebijakan penggunaan AI mereka sendiri untuk sementara waktu.
Apakah ada pengecek watermark OpenAI yang bisa diakses publik?
Belum ada pemeriksa watermark OpenAI untuk teks yang tersedia untuk publik. Alat verifikasi gratis OpenAI, alat verifikasi, memeriksa berkas gambar dan audio untuk C2PA Content Credentials serta watermark SynthID, yang disematkan OpenAI pada gambar dan audio yang didukung. OpenAI mengatakan alat ini tidak mendukung teks.
Untuk teks, OpenAI memberikan akses ke detektor secara kasus per kasus kepada peneliti yang disetujui dan organisasi ahli, melalui Form Content Provenance API. OpenAI mengatakan tidak akan memublikasikan detektor teks saat peluncuran karena risiko watermark yang terlewat dan false positive. Detektor melaporkan apakah menemukan watermark OpenAI, dan tidak mengidentifikasi pengguna atau menampilkan prompt mereka.
| Apa yang ingin Anda periksa | Alat | Siapa yang bisa menggunakannya |
|---|---|---|
| Berkas gambar atau audio OpenAI | Alat verifikasi OpenAI | Siapa pun, gratis |
| Output teks OpenAI (textGrain) | Detektor watermark teks OpenAI | Peneliti yang disetujui dan organisasi ahli, berdasarkan pengajuan |
| Output teks Claude | Detektor Watermark Claude | Organisasi yang memenuhi syarat, berdasarkan pengajuan (lihat panduan Watermark Claude dari Anthropic, Dijelaskan (2026)) |
OpenAI juga menjelaskan apa yang tidak bisa disimpulkan dari suatu hasil. Watermark yang terdeteksi tidak mengukur seberapa besar kontribusi seseorang, dan tidak mengidentifikasi siapa yang menulis atau menggunakan teks tersebut. Tidak adanya watermark juga tidak membuktikan kepengarangan manusia, karena teks bisa terlalu singkat, diedit, diterjemahkan, atau berasal dari model yang tidak didukung.
Google: pertama meluncurkan, lalu membagikan resepnya
Google DeepMind meluncur lebih dulu, mempublikasikan sepenuhnya, lalu membuka metode tersebut. Sistemnya, SynthID, awalnya merupakan watermark gambar pada 2023 dan berkembang menjadi teks pada 2024. Saat makalah Nature muncul pada Oktober 2024, SynthID-Text sudah berjalan di dalam Gemini pada produksi, sehingga menjadikannya watermark teks statistik pertama yang diterapkan pada skala konsumen.
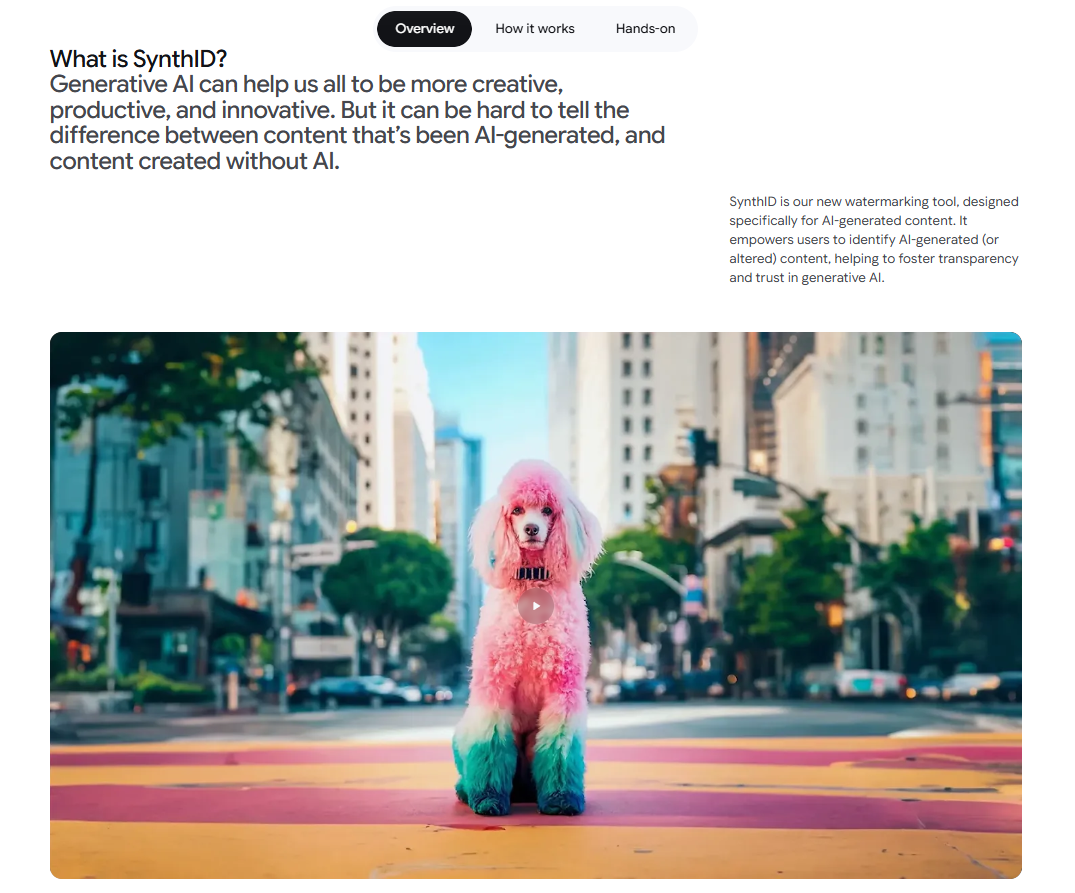
SynthID mencakup teks, gambar, audio, dan video, dan sudah aktif pada output teks Gemini sejak Oktober 2024.
Lalu Google memublikasikan implementasinya sebagai open source di Hugging Face, sehingga setiap pengembang dapat menerapkan skema watermarking yang sama ke model mereka sendiri. Pada Mei 2025, mereka mengumumkan SynthID Detector, sebuah portal verifikasi tempat konten dapat diperiksa untuk tanda SynthID di teks, gambar, audio, dan video.
Satu batasan cakupan yang penting: SynthID hanya memberi tanda dan hanya mendeteksi konten dari model milik Google sendiri. Alat ini tidak mengatakan apa pun tentang output ChatGPT atau Claude, dan pemindaian SynthID yang bersih tidak berarti teks ditulis oleh manusia. Artinya, model Google tidak menulis teks tersebut, klaimnya jauh lebih sempit.
Anthropic: paling akhir bergerak, kebijakan paling ketat
Anthropic menerapkan yang terbaru, dengan cakupan wajib paling luas. Setiap model Claude yang diluncurkan pada atau setelah 2 Agustus 2026 menyematkan watermark statistik pada output teksnya, di seluruh dunia, untuk setiap paket, tanpa opsi untuk menonaktifkan. Perusahaan menjelaskan mekanismenya dalam penjelasannya, Cara kerja watermark teks Claude, dan ruang lingkup kebijakannya dalam artikel help-center, Cara Claude menandai konten yang dihasilkan AI, yang tercakup adalah Claude API, claude.ai, Claude Code, Claude Cowork, dan Claude Tag. Model yang diluncurkan sebelum batas waktu berada dalam masa transisi, dan Anthropic mengatakan mereka juga menambahkan dukungan penandaan untuk model-model tersebut. Selain tanda statistik, berkas yang dihasilkan Claude juga membawa metadata C2PA, sistem kedua yang terpisah, yang hilang saat hanya menyalin teks biasa.
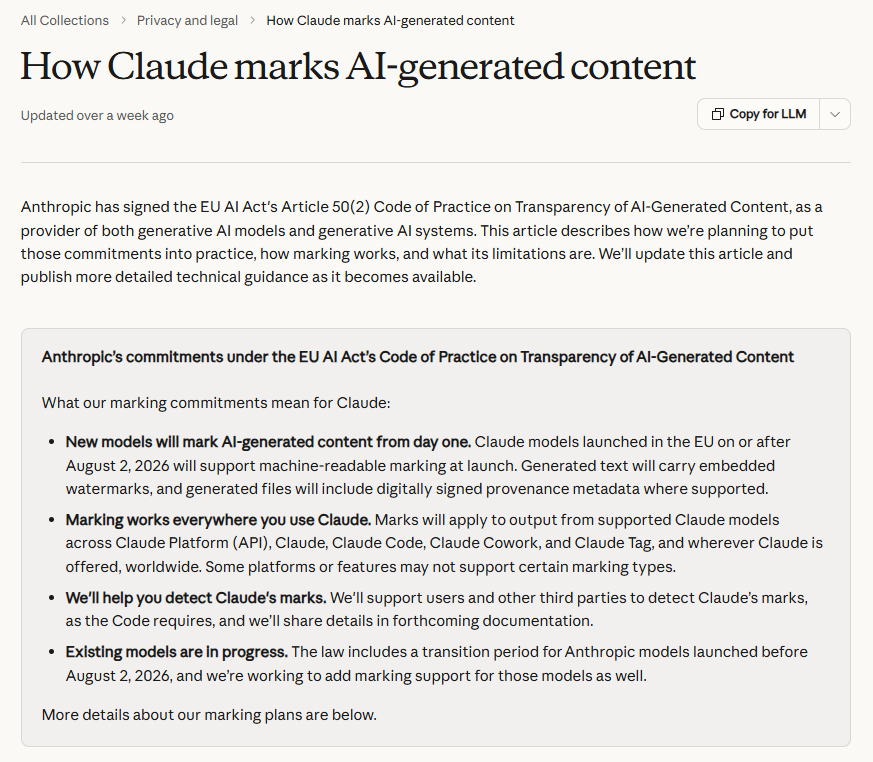
Kebijakan tersebut menurut kata-kata Anthropic sendiri: setiap model baru, setiap platform, di seluruh dunia, dengan model lama sedang ditambahkan.
Dokumentasi Anthropic menyatakan batasannya secara langsung. Deteksi bersifat probabilistik. Penanda tidak dapat membedakan dokumen yang ditulis Claude dari dokumen yang ditulis manusia lalu diedit ringan oleh Claude. Penulisan ulang sepenuhnya akan menghapus penanda itu. Kami membahas semuanya, termasuk apa yang sebenarnya dibuktikan oleh deteksi positif dan apa yang harus dilakukan jika tulisan Anda ikut mendapat penanda, di panduan khusus watermark Claude.
Waktunya mengikuti regulasi. Anthropic telah menandatangani Article 50(2) Code of Practice on Transparency of AI-Generated Content untuk EU AI Act, yang mewajibkan penyedia sistem AI generatif agar output diberi "diberi penanda dalam format yang dapat dibaca mesin dan terdeteksi sebagai buatan." Kewajiban transparansi itu mulai berlaku pada 2 Agustus 2026: tanggal batas yang tepat dalam kebijakan model Anthropic, sembilan hari sebelum pengumuman publik. Anthropic memilih untuk mematuhi secara global daripada mempertahankan perilaku terpisah untuk lalu lintas dari wilayah EU. Google sejak awal sudah patuh berdasarkan desain. Output teks OpenAI yang tidak diberi penanda menjadi pertanyaan kepatuhan terbuka untuk tahun 2027.
Tiga pendekatan, berdampingan
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Watermark teks diterapkan? | Ya (textGrain, peluncuran untuk EU mulai 5 Okt 2026) | Ya (Gemini, sejak Okt 2024) | Ya (model Claude mulai 2 Agu 2026) |
| Teknik | textGrain, sinyal statistik pada pilihan kata | Tourney sampling berbasis SynthID | Penanda berbasis sampling statistik, bergaya SynthID |
| Cakupan | Teks ChatGPT dan Codex yang memenuhi syarat di EU; opt-in melalui API di seluruh dunia | Model Google saja | Semua model Claude yang baru; model lama dalam masa transisi |
| Pilih keluar (opt-out) | Nonaktif secara default di API | Tidak | Tidak |
| Detektor publik | Tidak | Portal SynthID Detector (2025) | Direncanakan, belum dirilis |
| Skema dipublikasikan? | Hanya kuliah konsep | Artikel Nature + sumber terbuka | Penjelasan, berdasarkan karya yang telah dipublikasikan |
| Metadata berkas (C2PA) | Ya, untuk gambar dan audio | Ya, di berbagai media | Ya, pada berkas yang dihasilkan |
| Batasan yang dinyatakan | Penghindaran, stigma ESL | Ruang lingkup terbatas pada model milik sendiri | Bersifat probabilistik, pengeditan mengaburkan atribusi |
Pola di seluruh kolom: OpenAI menganggap penandaan teks sebagai masalah kebijakan yang belum tuntas, Google menganggapnya sebagai infrastruktur untuk distandarkan, dan Anthropic menganggapnya sebagai kewajiban kepatuhan yang harus diimplementasikan sepenuhnya.
Apa artinya bagi peneliti dan penulis akademik
Konsekuensi praktisnya bergantung pada alat mana yang menyentuh teks Anda. Jika Anda menyusun dengan ChatGPT, teks Anda tidak membawa watermark saat ini. Jika Anda menyusun dengan Gemini, teks Anda membawa tanda SynthID yang hanya dapat dibaca oleh detektor Google. Jika Anda menyusun atau mengedit dengan model Claude yang sedang berjalan, teks Anda membawa tanda dari Anthropic, dan tidak ada pengaturan yang dapat mematikannya.
Tiga hal yang sebaiknya diketahui penulis akademik:
Watermark mengidentifikasi alat, bukan penulis. Setiap vendor menyatakan hal ini dalam dokumentasinya masing-masing, dan penting untuk mengulangnya karena kebijakan institusional tidak selalu membedakan. Teks dapat diberi tanda karena AI menyusunnya, karena AI menyunting copy dua kalimat di dalamnya, atau karena paragraf yang diberi tanda dikutip. Jika institusi Anda menjalankan pemeriksaan watermark, yang dibuktikan oleh pemeriksaan itu adalah bahwa model tertentu menyentuh teks tersebut pada suatu waktu, tidak lebih. Panduan kami tentang mengajukan banding atas temuan deteksi AI yang keliru menjelaskan cara menyusun argumen itu saat memang diperlukan.
Watermark dan detektor AI adalah teknologi yang berbeda dengan mode kegagalan yang berbeda. Detektor seperti Turnitin atau GPTZero menebak dari gaya yang bersifat statistik, dengan masalah akurasi yang telah kami dokumentasikan. Deteksi watermark adalah pengujian berbasis kunci dengan tingkat false positive yang sangat rendah pada teks manusia yang tidak diberi tanda. Ketidakseimbangannya berbalik untuk false negative: pemeriksaan watermark melewatkan teks AI apa pun dari model yang tidak melakukan watermarking, yang saat ini mencakup semuanya dari ChatGPT.
Pengungkapan tetap posisi terkuat Anda. Watermarking membuat penggunaan AI secara diam-diam lebih berisiko dan penggunaan AI yang diungkapkan lebih aman, karena proses yang diungkapkan tidak menghadapi risiko apa pun dari tanda positif. Kebanyakan jurnal dan universitas kini memiliki kebijakan eksplisit tentang penggunaan AI; kebijakan penggunaan AI kami menjelaskan cara kami menarik batas-batas tersebut di seluruh alat kami, dan itu merupakan templat yang masuk akal untuk penggunaan yang transparan.
Apa yang menghilangkan watermark teks, dan apa yang tidak
Penulisan ulang akan menghilangkannya; pemformatan ulang tidak. Menyalin, menempel, mengubah font, mengonversi antar format berkas, dan menghapus karakter yang tidak terlihat semuanya mempertahankan watermark statistik sepenuhnya, karena tanda tersebut ada pada pilihan kata. Yang menghilangkannya adalah apa pun yang membuat ulang susunan kalimat: edit manusia yang mendalam, terjemahan, atau parafrasa yang benar-benar berbeda, sebagaimana ditetapkan oleh riset ketahanan NeurIPS 2023 sebelum sistem-sistem ini dirilis.
Kedua arah itu penting di sini. Hilangnya tanda tidak membuat teks menjadi milik Anda, dan bertahannya tanda tidak membuat teks bukan milik Anda. Draf yang ditulis ulang dengan AI tetap merupakan dokumen yang dibantu AI, dan aturan pengungkapan institusi Anda tetap berlaku untuk itu. humanizer AI teks menulis ulang draf berbantuan AI menjadi ragam akademik yang alami, dan karena proses ini menghasilkan ulang urutan token, tanda statistik tidak bertahan di dalamnya. Khusus untuk teks Claude, penghapus watermark Claude gratis menyusun ulang setiap kalimat dengan kata-kata baru sambil menjaga fakta, angka, dan sitasi tetap tidak berubah. Hal yang tidak bisa diubah oleh alat apa pun adalah kewajiban Anda kepada pembaca: transparansi tentang bagaimana dokumen tersebut dibuat.
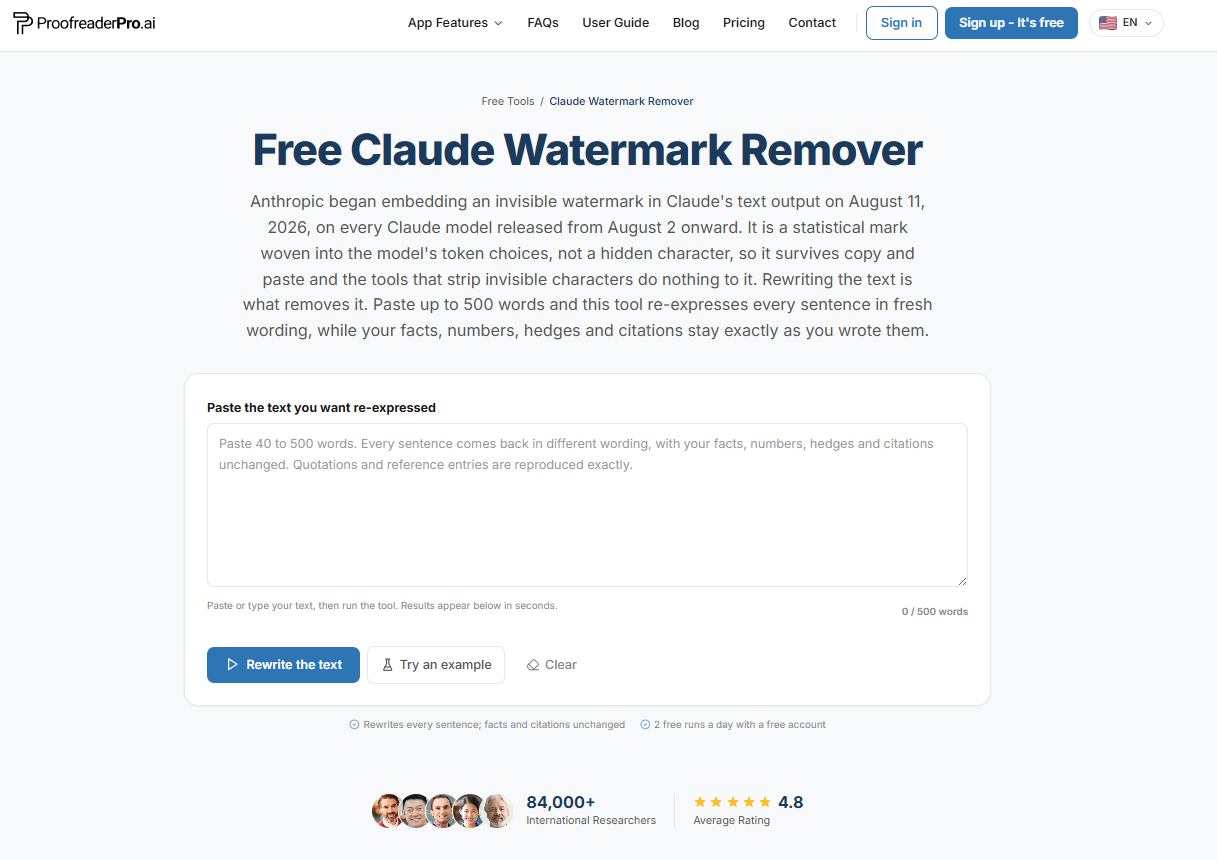
Menulis ulang adalah satu-satunya operasi yang menghapus tanda statistik, dan itulah yang dilakukan alat ini, kalimat demi kalimat.
Ke mana bagian ini selanjutnya
Pantau tiga hal sampai 2027. Pertama, apakah OpenAI membawa textGrain ke luar EU: awalnya terjadi di sana karena penegakan EU atas Pasal 50 mengharuskan adanya tanda yang dapat dibaca mesin pada teks AI. Kedua, apakah detektor konvergen. Jika setiap lab utama membubuhkan watermark dengan skema yang dipublikasikan, universitas dapat memeriksa kunci alih-alih menebak dari gaya tulisan, yang akan menjadi peningkatan dibanding deteksi yang rawan false-positive saat ini. Ketiga, apakah tanda-tanda itu menjadi kompatibel. Saat ini, tiga lab memakai tiga tanda yang berbeda, dan tidak ada satu pemeriksaan yang mencakup semuanya. C2PA mengisi celah itu untuk file, tetapi belum ada yang mengisi celah tersebut untuk teks mentah.
Apakah ChatGPT memberi watermark pada teksnya?
Ya, sebagian, sejak 5 Oktober 2026. OpenAI mulai menambahkan watermark textGrain ke teks ChatGPT dan Codex yang memenuhi syarat di Uni Eropa, dan pelanggan API di mana pun dapat mengaktifkannya. Watermark tersebut adalah sinyal statistik dalam pilihan kata, tanpa karakter tersembunyi. OpenAI juga menerapkan metadata asal C2PA pada berkas media DALL-E dan Sora, yang merupakan sistem terpisah pada level file.
Apakah Google Gemini memberi watermark pada teksnya?
Ya. Output Gemini telah memuat watermark SynthID-Text milik Google DeepMind sejak Oktober 2024. Ini adalah tanda statistik dalam pilihan kata, tidak terlihat oleh pembaca, dan dapat diverifikasi melalui Detektor SynthID milik Google. Hanya berlaku untuk model milik Google sendiri, jadi hasil SynthID yang negatif tidak mengatakan apa pun tentang teks dari sistem AI lain.
Apakah Claude memberi watermark pada teksnya?
Ya. Setiap model Claude yang diluncurkan pada atau setelah 2 Agustus 2026 menyematkan watermark statistik pada keluaran teksnya, di setiap platform dan paket, tanpa opsi untuk menolak, dan berkas yang dihasilkan Claude juga membawa metadata C2PA. Model yang diluncurkan sebelum tanggal tersebut belum menandai keluarannya; Anthropic menyatakan bahwa pihaknya menambahkan dukungan penandaan untuk model-model tersebut selama masa transisi. Detail lengkapnya ada di penjelasan watermark Claude kami.
Bisakah universitas mendeteksi watermark AI?
Hanya dengan kerja sama vendor, karena deteksi memerlukan kunci dari vendor. Google menyediakan portal detektor publik untuk konten SynthID. Anthropic mengatakan dukungan deteksi untuk pengguna dan pihak ketiga direncanakan, tetapi belum merilis detektor publik. Tidak ada paket perangkat lunak pemeriksa plagiarisme arus utama yang saat ini dapat memverifikasi watermark statistik dari lab mana pun, jadi istilah "deteksi AI" oleh institusi saat ini masih berarti menebak berdasarkan gaya, bukan verifikasi watermark.
Apakah watermarking AI diwajibkan oleh hukum?
Di Uni Eropa, ya, pada praktiknya. Pasal 50(2) dari Undang-Undang AI Uni Eropa mewajibkan penyedia AI generatif untuk memastikan keluaran ditandai dalam format yang dapat dibaca mesin dan dapat dideteksi sebagai buatan secara artifisial, dengan kewajiban transparansi yang berlaku mulai 2 Agustus 2026. Anthropic menandatangani Kode Praktik terkait dan memilih kepatuhan di seluruh dunia. Bagaimana regulator memperlakukan watermark teks OpenAI yang belum dirilis menjadi pertanyaan yang perlu dipantau pada 2027.
Apakah watermark AI bertahan terhadap penerjemahan?
Tidak. Watermark statistik hidup dalam urutan kata persis yang dipilih model, dan penerjemahan mengganti setiap kata. Hal yang sama berlaku untuk parafrase mendalam dan penyuntingan manusia yang intens. Keterbatasan ini didokumentasikan dalam literatur yang ditinjau sejawat dan diakui oleh setiap vendor yang menerapkan watermark.
Apakah ada pemeriksa watermark OpenAI untuk teks yang tersedia untuk publik?
Tidak, alat verifikasi publik OpenAI hanya memeriksa file gambar dan audio, untuk metadata C2PA dan watermark SynthID. OpenAI mengatakan tidak mendukung teks. Pendeteksi watermark teksnya hanya dibuka untuk peneliti yang disetujui dan organisasi pakar, kasus per kasus.
Apa itu textGrain?
textGrain adalah watermark teks OpenAI, diumumkan pada 5 Oktober 2026. Ia menambahkan sinyal statistik yang tidak terlihat pada pilihan kata model, sehingga tanda tersebut menjadi bagian dari kata-katanya, tanpa karakter tersembunyi atau metadata file. OpenAI mengatakan metode ini cocok atau mengungguli metode lain yang diuji, termasuk SynthID untuk teks, dan bahwa penyuntingan melemahkannya.
Bisakah peneliti mengajukan akses ke pendeteksi watermark teks OpenAI?
Ya, peneliti yang disetujui dan organisasi pakar dapat mengajukan melalui formulir API Penetapan Asal Konten OpenAI. OpenAI memberikan akses secara kasus per kasus berdasarkan Kode Praktik Uni Eropa. OpenAI mengatakan akan meninjau kembali akses yang lebih luas seiring teknologi dan bukti berkembang.
Sumber
- Anthropic, Cara kerja watermark teks Claude, Agustus 2026
- Pusat Bantuan Anthropic, Cara Claude menandai konten yang dihasilkan AI, 2026
- OpenAI, Memahami sumber dari apa yang kita lihat dan dengar di internet, Mei 2024
- Google DeepMind, SynthID
- Dathathri dkk., Watermarking yang scalable untuk mengidentifikasi keluaran model bahasa besar, Nature, Oktober 2024
- Google, Pengumuman detektor SynthID, Mei 2025
- Hugging Face, Memperkenalkan SynthID Text, Oktober 2024
- Kirchenbauer dkk., Watermark untuk Large Language Models, ICML 2023
- Krishna dkk., Parafrase menghindari detektor teks yang dihasilkan AI, NeurIPS 2023
- Scott Aaronson, Kuliah Keamanan AI saya untuk UT Effective Altruism, November 2022
- Uni Eropa, AI Act, Pasal 50
- C2PA, Koalisi untuk Provenansi dan Autentisitas Konten
Dana adalah pembuat konten di ProofreaderPro, tempat dia menjalankan blog harian dan operasi penulisan. Dia menulis artikel tentang cara kerja platform pengeditan online, dan dia menangani pesan pelanggan setiap hari, dengan skor kepuasan bintang lima untuk menunjukkannya.