
अंग्रेज़ी में लिखने वाले स्वीडिश शोधकर्ताओं के लिए AI Humanizer
स्वीडिश शोधकर्ताओं के लिए AI humanizer। स्वीडिश-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन फ्लैग कम करें, अर्थ और citations बनाए रखें, और ईमानदारी से खुलासा करें।

स्वीडन की धड़कन अंग्रेज़ी पर चलती है। करोलिंस्का इंस्टीट्यूट (Karolinska Institutet) में डॉक्टोरल थीसिस इसी में लिखी और डिफेंड की जाती हैं; लुंड और उप्साला (Lund और Uppsala) की संस्थाओं से आने वाले पेपर भी इसी में ड्राफ्ट होते हैं; और हर साल देश EF English Proficiency Index के शीर्ष पर या उसके क़रीब दिखाई देता है। इसलिए जब किसी स्वीडिश PhD छात्र को पता चलता है कि उसके द्वारा खुद लिखे एक अध्याय को किसी AI डिटेक्टर ने फ्लैग कर दिया है, तो प्रतिक्रिया आम तौर पर सीधी-सी अविश्वसनीयता होती है।
यह प्रतिक्रिया वाजिब है। स्वीडिश शोधकर्ताओं के लिए AI humanizer इसलिए मौजूद है क्योंकि सावधानीपूर्वक, मानक और प्रवाहपूर्ण Swedish-English, यही वह गद्य है जिसे ये डिटेक्टर अक्सर गलत पढ़ते हैं। उत्कृष्ट अंग्रेज़ी भी आपको नहीं बचाती। कभी-कभी समस्या वही होती है।
जब आप इसे समझते हैं, तो तंत्र असहज करने वाला लगता है। डिटेक्टर आश्चर्यजनक शब्द-चयन को पुरस्कृत करते हैं और पूर्वानुमेय (predictable) चयन को दंडित करते हैं। जो लेखक स्पष्ट लिखने के लिए प्रशिक्षित हों, सामान्य शब्दों का उपयोग करें, स्वच्छ वाक्य-संरचना रखें, उनका low-perplexity टेक्स्ट बनता है। और low perplexity वही है जिसे एक डिटेक्टर मशीन-लिखित मानकर स्कोर करता है।
स्वीडिश शोधकर्ता अंग्रेज़ी में प्रकाशन हेतु AI-टेक्स्ट को humanisiera कैसे कर सकते हैं
हमारा humanizer स्वीडिश शोधकर्ताओं को अपने ही ड्राफ्ट में मौजूद AI-text को humanisiera करने में मदद करता है, ताकि शुद्ध और सुव्यवस्थित Swedish-English को गलत तरीके से maskingenererad (मास्किंग-जनरेटेड) मानकर फ्लैग न किया जाए, साथ ही अर्थ, terminologi (शब्दावली) और källhänvisningar (स्रोत-संदर्भ) सुरक्षित रहें।
सीधी English में: यह टूल आपके अपने AI-सहायता प्राप्त ड्राफ्ट को लेकर उसका rhythm और word choice बदलता है, ताकि साफ-सुथरी Swedish-English मुख्य डिटेक्टरों द्वारा गलत पढ़े जाने की संभावना कम हो। यह आपके citations, आपकी technical vocabulary और आपकी दलील (argument) को यथावत रखता है। यह आपका पेपर आपके लिए नहीं लिखता, और इसे किसी चीज़ को छिपाने के लिए बनाया भी नहीं गया है।
क्या स्वीडिश में लिख रहे हैं? यह स्वतः-डिटेक्ट होता है और native रूप से humanized होता है
स्वीडिश शोधकर्ता अक्सर अंग्रेज़ी में प्रवेश करने से पहले अपनी पहली भाषा में ड्राफ्ट बनाते हैं, और humanizer इसमें मदद करता है। स्वीडिश टेक्स्ट पेस्ट करें, और ProofreaderPro भाषा को स्वयं पहचान लेता है, फिर इसे Swedish-aware मॉडल के माध्यम से प्रोसेस करता है जो å, ä और ö को, आपकी terminology को, और आपके citations को बिल्कुल उसी जगह बनाए रखता है। AI-text को humanisiera करने के लिए आप अपने स्वीडिश ड्राफ्ट से शुरुआत कर सकते हैं, जिसे उतनी ही सहजता से दोबारा लिखा जाता है जितना कि अंग्रेज़ी ड्राफ्ट को। यह वही detection है जो साठ से अधिक भाषाओं में फैली है, हर भाषा को उसकी अपनी आवाज़ (voice) में humanized किया जाता है।
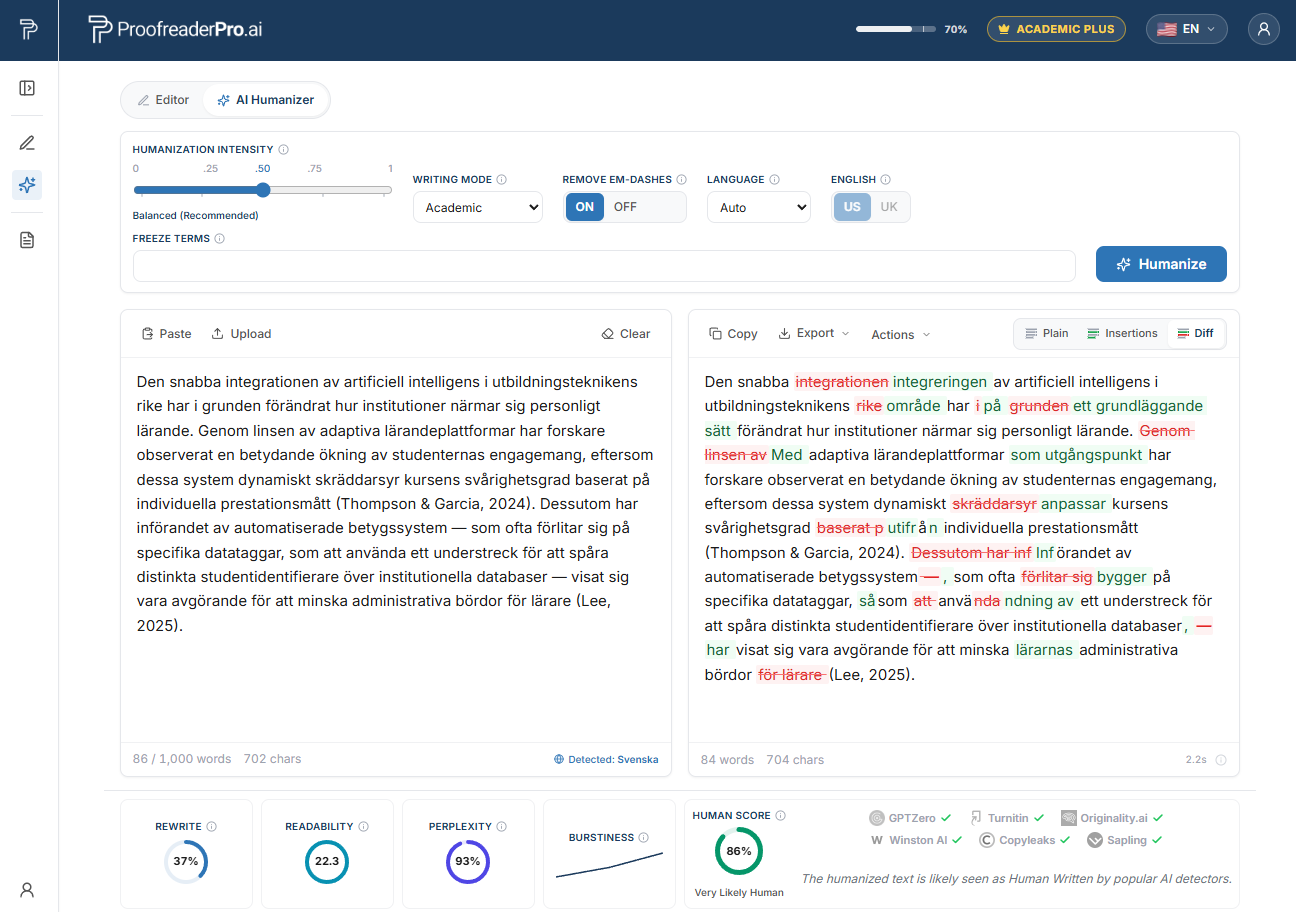
ProofreaderPro AI Humanizer द्वारा स्वीडिश अकादमिक टेक्स्ट का पुनर्लेखन। before-and-after diff आपका अर्थ और citations बनाए रखता है, और detector checks यह पुष्टि करते हैं कि पढ़ना प्राकृतिक, मानव-सा है।
स्वीडिश शोधकर्ताओं को AI डिटेक्टर फ्लैग क्यों करते हैं
समस्या को संख्याओं में देखने वाली उस स्टडी से शुरुआत करें। 2023 में, Liang और उनके सहकर्मियों के नेतृत्व वाली एक Stanford टीम ने Cell Press जर्नल Patterns में "GPT detectors are biased against non-native English writers" प्रकाशित किया। उन्होंने human-written TOEFL essays को सात व्यापक रूप से उपयोग किए जाने वाले डिटेक्टरों में चलाया।
परिणाम चौंकाने वाले थे। औसतन लगभग 61% गैर-देशी (non-native) निबंधों को AI के रूप में फ्लैग किया गया, जबकि देशी अंग्रेज़ी लेखकों के लिए यह करीब 5% था। पैनल के हर डिटेक्टर द्वारा सर्वसम्मति से फ्लैग किए गए गैर-देशी निबंधों में लगभग 1/5 यानी 19.8% शामिल थे। हर एक निबंध एक व्यक्ति द्वारा लिखा गया था।
ऐसा क्यों होता है? कई डिटेक्टर perplexity को स्कोर करते हैं, यह मापता है कि भाषा मॉडल के लिए अगला शब्द कितना ‘surprising’ है। दूसरी भाषा को सावधानी से लिखने वाला लेखक सामान्य शब्द और मानक निर्माण (standard construction) की ओर जाता है, जो अच्छी writing है, लेकिन यह पूर्वानुमेय (predictable), low-perplexity टेक्स्ट भी पैदा करता है। Swedish-English को स्पष्ट बनाने वाली वही आदतें इन सिस्टमों की ‘flag’ करने वाली आदतों में शुमार हैं। हम इस तंत्र को विस्तार से why AI detectors flag non-native English में समझते हैं।
दांव (stakes) अमूर्त नहीं हैं। गैर-देशी शोधकर्ताओं का पहले से ही rejection rate देशी वक्ताओं की तुलना में करीब 2.5 गुना अधिक होता है, वे अपने पेपर लिखने में लगभग 51% अधिक समय देते हैं, और भाषा-गुणवत्ता (language quality) से जुड़ी revision requests का सामना कहीं अधिक करते हैं। गलत AI फ्लैग उस अवरोध के ऊपर आ गिरता है जो पहले से ही काफ़ी ऊँचा है।
false flags के पीछे स्वीडिश-फर्स्ट-लैंग्वेज पैटर्न
स्वीडिश अकादमिक अंग्रेज़ी का एक पहचानने योग्य ढांचा है, और उसमें से कुछ भी गलत नहीं है। ये सही, सावधान और मानक construction हैं। उनकी मानकता ही जाल है, क्योंकि डिटेक्टर के लिए standard का अर्थ low perplexity पढ़ा जाता है।
False friends क्लासिक संकेत हैं। "Aktuell" का मतलब current या relevant है, न कि "actual"; "eventuellt" का अर्थ possibly है, न कि "eventually"; "kontrollera" का अर्थ to check है, न कि "to control"। एक स्वीडिश लेखक यदि "we controlled the temperature" लिखकर वास्तव में "we checked it" कहना चाहता है, तो वह ऐसी सटीक और सोच-समझकर चुनी गई vocabulary इस्तेमाल कर रहा होता है, जिसकी भविष्यवाणी मॉडल आसानी से कर लेता है।
Word order भी साथ चल जाता है। स्वीडिश verb-second भाषा है, इसलिए finite verb को दूसरा स्थान चाहिए। यह आदत मापी-तौली (measured), थोड़ी औपचारिक (slightly formal) वाक्य बनाती है, और correction के बाद ("Therefore the model is robust") जो समान-सा (evenness) बचता है, उसे डिटेक्टर मशीन-सी cadence के रूप में पढ़ लेते हैं।
फिर articles की बात है। स्वीडिश suffix के जरिए definiteness दिखाता है, अलग शब्द के जरिए नहीं, इसलिए अंग्रेज़ी के articles छूट जाते हैं या दोगुने (doubled) हो जाते हैं: "the research show", "result was significant"। जब एक proofreader इन्हें ठीक करता है, तो वे फिर नियमित और साफ-सुथरे दिखते हैं, और regular वही है जो low perplexity के रूप में स्कोर करता है।
कुछ छोटे संकेत भी लगातार दिखते हैं: durations के लिए "since" का "for" की तरह इस्तेमाल, compound nouns का भारी उपयोग, और शब्द "respective", तथा एक understated register जिसे कुछ reviewers सपाट (flat) मान लेते हैं। हर चुनाव (choice) अपने आप में बचाव-योग्य है। साथ में वे ऐसा गद्य बनाते हैं जो smooth, even, और किसी मॉडल के लिए पहले से अनुमान लगाना आसान होता है।
स्वीडन का AI-detection और Turnitin संदर्भ
स्वीडन में थीसिस और manuscripts को routine के तौर पर स्क्रीन किया जाता है। पूरे क्षेत्र में similarity checking मानक प्रक्रिया है, और ऐतिहासिक रूप से कई स्वीडिश विश्वविद्यालयों ने घर में विकसित Urkund और Ouriginal सिस्टमों पर भरोसा किया, जो अब Turnitin का हिस्सा हैं। AI indicators अब तेजी से उन्हीं रिपोर्टों में similarity scores के साथ-साथ बैठते दिख रहे हैं।
मार्गदर्शन भी पकड़ रहा है। Association of Swedish Higher Education Institutions (SUHF) और व्यक्तिगत विश्वविद्यालयों ने generative-AI guidance जारी की है, और funders तथा journals अधिक से अधिक बार यह मांग करते हैं कि AI का उपयोग कैसे किया गया, इस पर स्पष्ट बयान दिया जाए। यात्रा की दिशा निषेध (prohibition) नहीं, बल्कि disclosure की ओर है।
एक बात याद रखना उपयोगी है: detector का score एक दावा (claim) है, फैसला (verdict) नहीं। खुद Turnitin भी low-range scores को संख्या दिखाने के बजाय दबा देता है, और चेतावनी देता है कि उसकी score को अकेले integrity मामलों का निर्णय लेने के लिए इस्तेमाल नहीं किया जाना चाहिए। विदेश के कई विश्वविद्यालयों, जिनमें Vanderbilt भी शामिल है, ने false positives और non-native लेखकों के खिलाफ bias के कारण AI detector को पूरी तरह निष्क्रिय कर दिया था। एक फ्लैग ऐसी चीज़ है जिस पर आपत्ति (contest) की जा सकती है, न कि स्वीकारोक्ति (confession)।
जमा करने से पहले अपनी स्वीडिश-अंग्रेजी की सुरक्षा करें
अपने AI-सहायता प्राप्त मसौदे को मानवीय बनाइए, अपने संदर्भ और अर्थ यथावत रखें, फिर अपने AI उपयोग को प्रकट कीजिए। इसे अपने थीसिस के एक ही पैराग्राफ पर आज़माइए और अंतर देखिए।
Humanizer को निःशुल्क आज़माइएशीर्ष स्वीडिश विश्वविद्यालय और जहाँ AI checks दिखाई देते हैं
यही screening टूल स्वीडन के प्रमुख संस्थानों में, मेडिकल स्कूल से लेकर technical universities तक, लगभग समान रूप से दिखते हैं:
- Karolinska Institutet (KI), Stockholm (medicine)
- Uppsala universitet, Uppsala
- Lunds universitet, Lund
- Kungliga Tekniska högskolan (KTH), Stockholm
- Stockholms universitet (SU), Stockholm
- Göteborgs universitet (GU), Gothenburg
- Chalmers tekniska högskola, Gothenburg
- Linköpings universitet (LiU), Linköping
- Umeå universitet, Umeå
- Sveriges lantbruksuniversitet (SLU), Uppsala
- Örebro universitet, Örebro
- Linnéuniversitetet, Växjö और Kalmar
इन सभी जगहों पर ये स्क्रीन थीसिस और manuscripts को similarity के लिए देखते हैं, और बढ़ती संख्या में उन्हीं वर्कफ़्लो में AI indicators का भी भार जोड़ा जा रहा है। बात यह नहीं है कि इनमें से कोई भी संस्था शत्रुतापूर्ण है। बात यह है कि गलत फ्लैग इनमें से किसी भी जगह आपके सावधानी से किए गए काम पर आ सकता है, इसलिए जमा करने से पहले अपनी लेखन-प्रक्रिया को सुरक्षित रखना समझदारी भरा कदम है।
स्वीडिश शोधकर्ताओं के लिए AI humanizer कैसे काम करता है
वर्कफ़्लो ईमानदार और सरल है, और यह आपके अपने ड्राफ्ट से शुरू होता है।
पहले लिखें। कई स्वीडिश शोधकर्ता पहले स्वीडिश में ड्राफ्ट बनाते हैं, जहाँ thinking सबसे तेज़ होती है; फिर वे अनुवाद करते हैं, जबकि कुछ अन्य सीधे अंग्रेज़ी में ड्राफ्ट बनाते हैं। किसी भी तरह, शब्द और argument, आपके अपने होते हैं।
व्याकरण (grammar) को proofread करें। false friends, छूटे articles, verb-second carryover, इन सबको साफ करें। हमारा AI proofreader आपकी meaning को समतल किए बिना यांत्रिकी (mechanics) ठीक करता है, और जब grammar ठोस हो जाती है, तब आप humanizer पर आगे बढ़ते हैं।
फिर अपने ही AI-assisted गद्य को humanisiera करें। यहीं पर AI humanizer for Swedish researchers rhythm और word choice में विविधता लाता है, लगातार समान-सी cadence को तोड़ता है, और उन repetitive patterns तथा stray em dashes को हटाता है जो डिटेक्टरों को भटकाते हैं। हमारे अपने परीक्षणों में, यह काफी हद तक कम कर देता है कि प्रमुख डिटेक्टर (Turnitin, Originality.ai, GPTZero और समान) सावधानी से लिखे गए non-native Swedish-English को कितनी बार गलत पढ़ते हैं, और साथ ही आपकी meaning, terminology और citations संरक्षित रहते हैं। हम इसे परीक्षण में जो हमने देखा, उसी के रूप में वर्णित करते हैं, वादा (promise) नहीं। डिटेक्टर हर कुछ महीनों में दोबारा ट्रेन होते हैं, और कोई भी ईमानदार टूल 100% undetectable होने का दावा नहीं कर सकता।
Non-English ड्राफ्ट भी संभाले जाते हैं। humanizer 60 से अधिक भाषाओं का समर्थन करता है और non-English टेक्स्ट को language-aware मॉडल के जरिए रूट करता है, जो sentence structure और meaning को अक्षुण्ण रखता है, खासकर तब, जब आप translation से पहले किसी स्वीडिश ड्राफ्ट को humanisiera करते हैं। यह पोस्ट हमारे multilingual AI humanizer hub की एक कड़ी है, और पूर्ण-manuscript कार्य के लिए यह global academic editing hub के साथ-साथ बैठता है।
फिर disclosure करें। अपने लेखन को humanisiera करना उसे छिपाने जैसा नहीं है। अपने department और target journal द्वारा आवश्यक format में यह बताएं कि आपने AI का उपयोग कैसे किया, और आप false flag से अपने काम की रक्षा करते हुए भी integrity के नियमों के भीतर ही बने रहते हैं।
स्थानीय फंडिंग निकाय, जर्नल, और AI-disclosure की अपेक्षाएँ
स्वीडन के funders AI के उपयोग के बारे में बढ़ती पारदर्शिता (transparency) की अपेक्षा करते हैं। Vetenskapsrådet (the Swedish Research Council, VR) मुख्य सार्वजनिक फंडर है, और Knut and Alice Wallenberg Foundation (KAW) एक बड़ा निजी फंडर है। Forte (health, working life, welfare), Formas (environment और agriculture) तथा Vinnova (innovation) अपने-अपने क्षेत्रों को फंड करते हैं; स्वीडिश समूह नियमित रूप से ERC grants जीतते हैं; और ओपन एक्सेस (open access) पूरे तौर पर अनिवार्य है।
पब्लिशिंग पक्ष पर, स्वीडिश शोधकर्ता Web of Science और Scopus-indexed जर्नल को लक्ष्य बनाते हैं और आउटपुट को SwePub में रजिस्टर करते हैं। ये जर्नल AI सहायता पर स्पष्ट नोट की मांग अधिक से अधिक बार करते हैं। अभी एक संक्षिप्त, ईमानदार disclosure सामान्य methods या acknowledgements सेक्शन में होना चाहिए, और इसे सही करना अधिकांश लोगों जितना आसान माना जाता है, उतना ही, बल्कि उससे भी ज्यादा, आसान है। AI disclosure statement लिखने के लिए हमारा गाइड देखें; और यदि स्वच्छ, disclosed काम के बावजूद कोई फ्लैग आ ही जाए, तो appeal playbook बताता है कि कैसे प्रतिक्रिया दें।
यहाँ मूल भावना (through-line) निष्पक्षता (fairness) है। आपने शोध किया, आपने पेपर लिखा, और perplexity स्कोर को इसे पलटने का अधिकार नहीं होना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
प्र: क्या AI humanizer तब भी मदद करेगा जब मेरी अंग्रेज़ी पहले से बहुत अच्छी है?
अक्सर हाँ, और यही इसका counterintuitive हिस्सा है। डिटेक्टर low-perplexity टेक्स्ट को फ्लैग करते हैं, और polished, standard Swedish-English स्वाभाविक रूप से low perplexity होता है। humanizer आपके rhythm और phrasing में बदलाव करता है ताकि साफ लिखाई गलत पढ़े जाने की संभावना कम हो, बिना इस बदले कि आपने सच में क्या कहा था।
प्र: क्या अपनी ही थीसिस में AI-text को humanisiera करना नियमों के खिलाफ है?
अपने ही ड्राफ्ट को humanisiera करना और फिर अपना AI उपयोग disclose करना अधिकतर संस्थानों में नियमों के खिलाफ नहीं है। नियम जिन चीज़ों को लेकर चिंतित हैं, वह है fabricated या undisclosed काम को अपना बताकर प्रस्तुत करना। जब आप अपनी meaning और citations बनाए रखते हैं और यह स्पष्ट बताते हैं कि आपने AI का उपयोग कैसे किया, तब आप integrity फ्रेमवर्क के भीतर ही रहते हैं।
प्र: क्या कोई भी टूल यह गारंटी दे सकता है कि मेरा पेपर Turnitin या GPTZero पास कर जाएगा?
नहीं, और ऐसी किसी भी बात से सावधान रहें जो उल्टा दावा करे। डिटेक्टर हर कुछ महीनों में अपने मॉडल बदलते हैं, इसलिए कोई भी ईमानदार टूल किसी नतीजे का वादा नहीं कर सकता या 100% undetectable होने का दावा नहीं कर सकता। हम यह कह सकते हैं कि हमारे परीक्षण में humanizer सावधानी से लिखे गए non-native गद्य में false flags को सार्थक रूप से कम करता है, जो गारंटी से अलग है।
प्र: क्या humanizer मेरी citations या technical terms बदलता है?
नहीं। इसे citations, technical terminology और आपकी दलील के सार (substance) को संरक्षित रखने के लिए बनाया गया है, जबकि यह rhythm और word choice को समायोजित करता है। आपकी reference list, आपके equations और आपकी domain vocabulary, जैसा आपने लिखा था वैसा ही, बनी रहती है।
प्र: मैंने पहले स्वीडिश में ड्राफ्ट बनाया। क्या इससे फर्क पड़ता है?
कोई समस्या नहीं। humanizer 60 से अधिक भाषाओं का समर्थन करता है और non-English टेक्स्ट को language-aware मॉडल के जरिए प्रोसेस करता है जो sentence structure और meaning की रक्षा करता है, इसलिए आप स्वीडिश में काम कर सकते हैं और अनुवाद कर सकते हैं, या अंग्रेज़ी में अनुवाद करने के बाद humanize कर सकते हैं।
सावधानीपूर्वक लिखी गई गैर-मातृभाषी गद्य पर होने वाले गलत AI संकेत कम करें, अपने अर्थ, शब्दावली और संदर्भों को यथावत रखते हुए। अंग्रेजी में प्रकाशित करने वाले शोधकर्ताओं के लिए बनाया गया।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


