
अंग्रेज़ी में लेखन करने वाले डच शोधकर्ताओं के लिए AI ह्यूमनाइज़र
डच शोधकर्ताओं के लिए AI ह्यूमनाइज़र। डच-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन फ़्लैग कम करें, अर्थ और उद्धरण बनाए रखें, और ईमानदारी से खुलासा करें।

नीदरलैंड्स लगभग पृथ्वी के हर देश की तुलना में प्रति व्यक्ति अधिक उच्च-प्रभाव (high-impact) शोध प्रकाशित करता है, और इनमें से लगभग सब कुछ अंग्रेज़ी में दिखाई देता है। डच शिक्षाविद हर साल EF English Proficiency Index में शीर्ष के आसपास या उसी स्तर पर रैंक करते हैं, इसलिए एम्स्टर्डम या डेल्फ्ट से आने वाला पांडुलिपि आम तौर पर स्वच्छ, सटीक और व्याकरण की दृष्टि से पाठ्यपुस्तक-मानक (textbook) होती है। फिर भी, वही ‘स्वच्छ’ गद्य जब किसी AI डिटेक्टर के पास जाता है, तो वह उच्च "AI-generated" संभावना लौटा देता है, और एक सावधान शोधकर्ता, जिसने हर शब्द हाथ से लिखा, उसे अचानक अपने आप से पूछताछ करनी पड़ती है कि ऐसा क्यों हुआ। यही विशिष्ट समस्या है, जिसे डच शोधकर्ताओं के लिए एक AI ह्यूमनाइज़र हल करने के लिए बनाया गया है।
यहाँ एक असहज विडंबना (irony) है। आपकी अंग्रेज़ी जितनी बेहतर होगी, आपकी अभिव्यक्ति उतनी ही अधिक मानक और अनुमानित (predictable) होने की प्रवृत्ति रखेगी, और अनुमानित शब्द-चयन वही है जिसे वर्तमान डिटेक्टर मशीन लेखन के रूप में स्कोर करते हैं। मजबूत डच इंग्लिश किसी पेपर को गलत फ़्लैग से नहीं बचाती; कुछ मायनों में वह इसके लिए आमंत्रण दे सकती है।
यह गाइड बताती है कि ऐसा क्यों होता है, डच की प्रथम-भाषा (Dutch first-language) की कौन-सी आदतें गलत फ़्लैग को ट्रिगर करती हैं, नीदरलैंड्स के विश्वविद्यालयों में समानता (similarity) और AI स्क्रीनिंग वास्तव में कैसे काम करती है, और आप अपने लेखन को ईमानदारी से कैसे सुरक्षित रख सकते हैं: अपने उस AI-सहायतित ड्राफ्ट को ह्यूमनाइज़ करें जो आपने पहले से लिख लिया है, अपना अर्थ और उद्धरण intact रखें, फिर अपने संस्थान और जर्नल की आवश्यकता के अनुसार अपने AI उपयोग का खुलासा करें।
अंग्रेज़ी में प्रकाशित करने वाले डच शोधकर्ताओं के लिए AI-tekst humaniseren
हमारा ह्यूमनाइज़र डच शोधकर्ताओं को उनके अंग्रेज़ी-भाषी (Engelstalige) पांडुलिपियों को इस तरह प्रकाशित करने में मदद करता है कि सावधानीपूर्वक, सही (correct) गद्य को गलत तरीके से ‘मशीन टेक्स्ट’ नहीं समझा जाए। AI-tekst humaniseren का लक्ष्य सरल है: अर्थ (meaning), शब्दावली (terminologie) और स्रोत-संबंधी संदर्भ (bronvermeldingen) समान बने रहते हैं, जबकि लय (ritme) और शब्द-चयन अधिक स्वाभाविक (natural) हो जाते हैं।
सरल अंग्रेज़ी में: humanizer आपके उस ड्राफ्ट पर काम करता है जो आप पहले से लिख चुके हैं या जिसे आपने AI सहायता के साथ ड्राफ्ट किया है। यह वाक्यों की लय (sentence rhythm) में बदलाव करता है, दोहराव वाली कैडेंस को तोड़ता है, और उन संकेतों (tells) को हटाता है जो किसी डिटेक्टर को भटकाते हैं, लेकिन आपके तर्क (argument), आपके डेटा (data), या आपके संदर्भ (references) को छूता नहीं। गैर-अंग्रेज़ी पाठ के लिए यह भाषा-सचेत (language-aware) मॉडल से होकर गुजरता है, जो साठ से अधिक भाषाओं में संरचना और अर्थ को संरक्षित रखता है।
क्या आप डच में लिखते हैं? यह स्वचालित रूप से पहचाना जाता है और सीधे ह्यूमनाइज़ होता है
ह्यूमनाइज़ करने से पहले किसी ड्राफ्ट का अंग्रेज़ी में अनुवाद करना आवश्यक नहीं है। डच टेक्स्ट पेस्ट करें और ProofreaderPro उसे अपने आप भाषा के रूप में पहचान लेगा, फिर उसे एक ऐसे डच-सचेत मॉडल के माध्यम से चलाएगा जो आपकी शब्दावली, यौगिक शब्द (compound words), और उद्धरणों को ठीक उसी तरह बनाए रखता है जैसे वे लिखे गए हैं। यह आपकी पहली भाषा पर लागू AI-tekst humaniseren है: आपका डच ड्राफ्ट उसी सहजता से ह्यूमनाइज़ होता है जैसे आपका अंग्रेज़ी ड्राफ्ट। वही पहचान साठ से अधिक भाषाओं में फैली है, इसलिए डच को अंग्रेज़ी में “समतल” (flatten) करने की बजाय डच के रूप में ही फिर से लिखा जाता है।
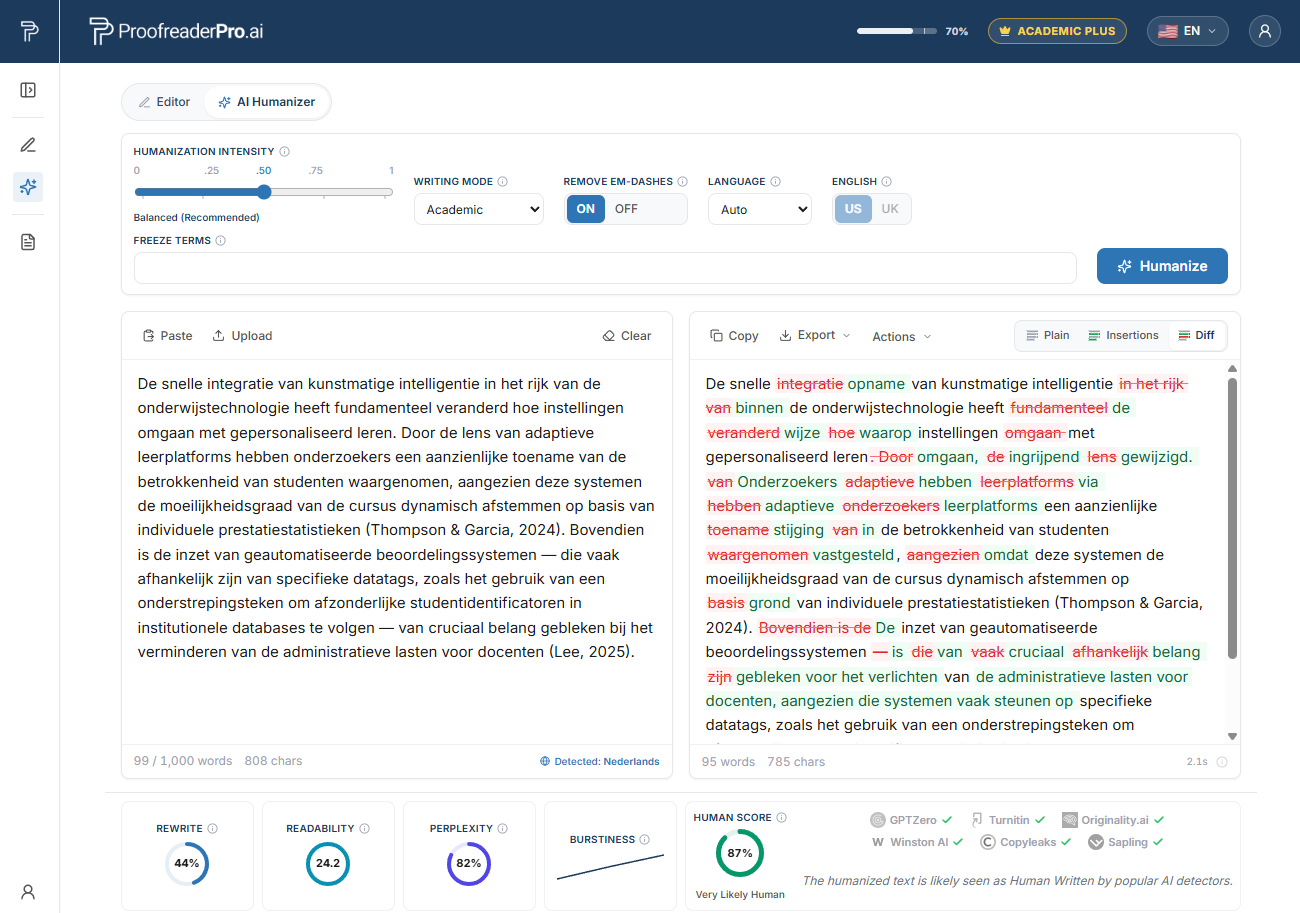
डच शैक्षणिक पाठ को फिर से लिखते हुए ProofreaderPro AI Humanizer। before and after diff आपके अर्थ और उद्धरणों को बनाए रखता है, और डिटेक्टर चेक इस बात की पुष्टि करते हैं कि पाठ स्वाभाविक रूप से मानवीय (human) पढ़ा जाता है।
डच शोधकर्ताओं को AI डिटेक्टरों द्वारा फ़्लैग क्यों किया जाता है
2023 में, Weixin Liang के नेतृत्व वाली एक स्टैनफोर्ड टीम ने Cell Press जर्नल Patterns में एक स्पष्ट (blunt) शीर्षक के साथ एक अध्ययन प्रकाशित किया: "GPT detectors are biased against non-native English writers." उन्होंने मानव-लिखित TOEFL निबंधों को सात व्यापक रूप से इस्तेमाल किए जाने वाले AI डिटेक्टरों के माध्यम से चलाया। औसतन, गैर-मातृभाषी (non-native) निबंधों में लगभग 61% को AI-generated के रूप में फ़्लैग किया गया। मातृभाषा (native) अंग्रेज़ी लिखने वालों के निबंधों के लिए यह आंकड़ा लगभग 5% था। गैर-मातृभाषी निबंधों में से लगभग हर पाँच में से एक, करीब 19.8%, को हर एक डिटेक्टर ने सर्वसम्मति से (unanimously) फ़्लैग किया। उन सबको किसी मानव ने लिखा था।
इस तंत्र (mechanism) को समझना महत्वपूर्ण है, क्योंकि यह बताता है कि fluency (द्रुत/प्रवाहमयता) कोई सुरक्षा कवच (shield) क्यों नहीं है। अधिकांश डिटेक्टर किसी ऐसी चीज़ को स्कोर करते हैं जिसे perplexity कहा जाता है, यह एक भाषा मॉडल के लिए प्रत्येक शब्द-चयन के “कितना आश्चर्यजनक/अनुमान-पर” (surprising) होने का माप है। जो लेखन सामान्य शब्दों को मानक, अपेक्षित संयोजनों में उपयोग करता है, वह कम perplexity स्कोर करता है, और कम perplexity मशीन-टेक्स्ट जैसा पढ़ता है। सावधान अकादमिक लेखक, विशेषकर वे जो दूसरी भाषा में काम करते हैं, स्पष्ट और पारंपरिक (conventional) ढंग से लिखना ठीक उसी कारण अपनाते हैं क्योंकि यह सुरक्षित और सही होता है। वही आदतें जो आपके गद्य को पठनीय बनाती हैं, वही आदतें डिटेक्टर दंडित करने के लिए प्रशिक्षित हैं।
यहाँ डच शोधकर्ता एक अजीब स्थिति में खड़े होते हैं। नीदरलैंड्स में अंग्रेज़ी दक्षता असाधारण है, यानी डच शैक्षणिक अंग्रेज़ी अक्सर औसत मातृभाषी (native) ड्राफ्ट की तुलना में अधिक स्वच्छ और अधिक मानकीकृत होती है। यह पॉलिश आगे perplexity को और घटा देती है। हमने इस गतिशीलता (dynamic) पर why AI detectors flag non-native writers में एक अधिक विस्तृत व्याख्या लिखी है, और नीदरलैंड्स के डच कार्य पर यह असामान्य रूप से अधिक प्रभाव के साथ लागू होती है।
गलत फ़्लैग के पीछे डच प्रथम-भाषा की पैटर्न
नीचे दिए गए किसी भी पैटर्न में त्रुटि नहीं है। वे सही (correct), सावधान (careful), मानक निर्माण (standard constructions) हैं, और उनकी वही मानकता (standardness) है जिसे डिटेक्टर कम-perplexity, मशीन-जैसे टेक्स्ट के रूप में पढ़ते हैं। कुछ उदाहरण दिखाते हैं कि डच आदतें अंग्रेज़ी गद्य को कैसे आकार देती हैं।
डच और अंग्रेज़ी में बड़ी मात्रा में शब्दावली साझा है, जिससे ‘विश्वसनीय’ false friends पैदा होते हैं। "Actueel" का अर्थ current होता है, न कि "actual"; "eventueel" का अर्थ possibly होता है, न कि "eventually"; "controleren" का अर्थ to check होता है, न कि "to control"। एक डच शोधकर्ता जो इन जालों से बचना सीख चुका है, अक्सर ऐसी जानबूझकर (deliberate) और सावधानीपूर्ण सटीकता के साथ लिखता है जो विविधता (variation) को कम कर देता है। परिणाम सुसंगत (consistent) और सही (correct) होता है, और consistency एक perplexity संकेत है।
शब्द-क्रम (word order) एक और सूक्ष्म संकेत है। डच में किसी clause के भीतर finite verb दूसरे स्थान पर आती है, इसलिए एक adverb-fronted sentence अंग्रेज़ी में इस तरह उभर सकती है: "Therefore is the result significant" या "In this study investigate we the effect." अधिकांश डच लेखक इसे जमा करने से पहले सुधार देते हैं, लेकिन यह सुधार उसी तरह की tidy, canonical sentence संरचना पैदा करता है जिसे डिटेक्टर generated text के साथ जोड़ते हैं।
फिर लेख (articles) भी हैं। डच में generic और abstract nouns से पहले definite articles की अनुमति होती है, इसलिए ड्राफ्ट में ऐसे निर्माण आते हैं जैसे "the research shows," "the society," या "the nature of the problem," जहाँ अंग्रेज़ी आम तौर पर article छोड़ देती। यह औपचारिक (formal) और सटीक लगता है। यह बहुत नियमित (very regular) भी पढ़ता है।
अंत में दो और आदतें इसे पूरा करती हैं। डच भारी noun phrases और nominalization को प्राथमिकता देता है, जैसे "the realisation of the implementation of" जैसी संरचनाओं को एक के ऊपर एक रखकर, और वह discourse markers जैसे "namely" (namelijk) और "respectively" (respectievelijk) पर भी झुकता है; अक्सर ऐसा डाइरेक्ट, blunt रजिस्टर होता है जिसे समीक्षक (reviewers) कभी-कभी terse की तरह पढ़ लेते हैं। इन सबमें व्याकरण की दृष्टि से सब कुछ ठीक है। साथ मिलकर ये एक चिकनी (smooth), कम-आश्चर्य (low-surprise) बनावट बनाते हैं जिसे डिटेक्टर आपके विरुद्ध स्कोर करते हैं।
अपने लेखन की सुरक्षा करें, ईमानदारी से
अपने AI-सहायता प्राप्त मसौदे को मानवीय बनाइए, अपने अर्थ, शब्दावली और संदर्भों को यथावत रखते हुए, फिर अपने AI उपयोग को वैसा ही प्रकट कीजिए जैसा आपका जर्नल मांगता है।
Humanizer को निःशुल्क आज़माइएनीदरलैंड्स' AI-डिटेक्शन और Turnitin का संदर्भ
नीदरलैंड्स के भीतर डच थीसिस और जर्नल सबमिशनों की similarity के लिए नियमित रूप से जाँच होती है, अधिकतर Turnitin या iThenticate के साथ, और संस्थान अब पुराने plagiarism checks के साथ-साथ AI संकेतकों (AI indicators) को भी बढ़ते तौर पर महत्व दे रहे हैं। यह अब अपवाद (exception) नहीं, बल्कि सबमिशन पाइपलाइन का सामान्य हिस्सा है।
नीदरलैंड्स के विश्वविद्यालयों (UNL) और व्यक्तिगत संस्थानों ने जनरेटिव AI (generative-AI) पर दिशा-निर्देश जारी किए हैं, और समग्र दिशा स्पष्ट है: AI टूल्स को कई कार्यों के लिए अनुमति है, लेकिन उनके उपयोग का खुलासा छिपाने की बजाय किया जाना चाहिए। फंडर (funders) और जर्नल भी इसी दिशा में बढ़ रहे हैं, लेखकों से पूछा जा रहा है कि उन्होंने अपने काम में AI का उपयोग कहाँ और कैसे किया।
यह याद रखना उपयोगी है कि डिटेक्टर का स्कोर वास्तव में कितना वज़न रखता है। Turnitin 1 से 19% की रेंज में AI स्कोर को दबाता है और चेतावनी देता है कि उसके नंबर का उपयोग अकेले ही integrity संबंधी निर्णय लेने के लिए नहीं किया जाना चाहिए। कुछ बड़े संस्थान इससे भी आगे हट गए हैं: Vanderbilt ने 2023 में Turnitin के AI डिटेक्टर को false positives और non-native writers के विरुद्ध bias का हवाला देते हुए निष्क्रिय कर दिया, और Michigan State, Northwestern, तथा University of Pittsburgh ने भी तुलनीय कदम उठाए। एक डिटेक्शन फ़्लैग वह दावा (claim) है जिसे आप चुनौती दे सकते हैं, न कि कोई ऐसा अंतिम फैसला (verdict) जो थमा दिया जाए।
डच के शीर्ष विश्वविद्यालय और जहाँ AI जाँचें दिखती हैं
स्क्रीनिंग डच सिस्टम के विभिन्न हिस्सों में होती है। नीचे दिए गए सभी संस्थान थीसिस और पांडुलिपियों में similarity की जाँच करते हैं, अक्सर Turnitin या iThenticate के साथ, और बढ़ते तौर पर AI संकेतकों को भी शामिल करते हैं:
- Universiteit van Amsterdam (UvA), Amsterdam
- Universiteit Utrecht, Utrecht
- Universiteit Leiden, Leiden
- Technische Universiteit Delft (TU Delft), Delft
- Erasmus Universiteit Rotterdam (EUR), Rotterdam
- Rijksuniversiteit Groningen (RUG), Groningen
- Wageningen University & Research (WUR), Wageningen
- Radboud Universiteit, Nijmegen
- Vrije Universiteit Amsterdam (VU), Amsterdam
- Technische Universiteit Eindhoven (TU/e), Eindhoven
- Universiteit Twente (UT), Enschede
- Universiteit Maastricht (UM), Maastricht
- Tilburg University, Tilburg
यदि आप Leiden में किसी डिसर्टेशन का बचाव (defend) कर रहे हैं या WUR की किसी लैब से सबमिट कर रहे हैं, तो आपका दस्तावेज़ इस तरह की जाँच से गुज़रेगा। इसे पहले से जानना आपके अंतिम ड्राफ्ट को तैयार करने के तरीके को बदल देता है।
डच शोधकर्ताओं के लिए AI ह्यूमनाइज़र कैसे काम करता है
ईमानदार वर्कफ़्लो के तीन चरण हैं, और उसमें disclosure (खुलासा) भी उसका हिस्सा है, कोई बाद का विचार नहीं (afterthought) है।
पहला, ड्राफ्ट। अंग्रेज़ी में लिखें, या डच में लिखकर अनुवाद करें, यदि इससे आपकी सोच तेज़ होती है तो AI सहायता का उपयोग करें। जब तक तर्क (argument), विश्लेषण (analysis), और साक्ष्य (evidence) वास्तव में आपके अपने हैं, AI-सहायतित पहला ड्राफ्ट बनाने में कोई समस्या नहीं है।
दूसरा, प्रूफरीड और ह्यूमनाइज़ करें। पहले अपना व्याकरण साफ़ (clean) कर लें, फिर ड्राफ्ट को AI humanizer से गुज़ारें। यह वाक्यों की लंबाई (sentence length) में विविधता लाता है, उस दोहराव वाली कैडेंस को तोड़ता है जो मशीन टेक्स्ट का संकेत देती है, और इधर-उधर की फॉर्मैटिंग की अटपटी आदतों (formatting tics) को हटाता है, जबकि आपका अर्थ, आपकी तकनीकी शब्दावली, और हर citation ठीक उसी जगह संरक्षित रहती है जहाँ आप उसे रखते हैं। हमारे अपने परीक्षण में, यह काफी हद तक कम कर देता है कि सावधान, मानक (standard) गैर-मातृभाषी अंग्रेज़ी को Turnitin, Originality.ai और GPTZero जैसे प्रमुख डिटेक्टर कितनी बार गलत तरीके से पढ़ लेते हैं; साथ ही यह अकादमिक अर्थ (academic meaning) और व्याकरण को सुरक्षित रखता है। हम इसे परीक्षण में जो हमने देखा है उसी रूप में प्रस्तुत करते हैं, इसे कोई वादा (promise) नहीं कहते। डिटेक्टर हर कुछ महीनों में अपने मॉडल पुनः प्रशिक्षित (retrain) करते हैं, और कोई भी ईमानदार टूल 100% undetectable होने का दावा नहीं कर सकता। जो कोई भी इसकी गारंटी देता है, वह आपको कुछ बेच रहा होता है।
तीसरा, खुलासा (disclose)। अपने supervisor, अपने संस्थान, और आपके लक्षित जर्नल की अपेक्षाओं के अनुरूप अपने AI उपयोग का विवरण दें। यही पूरे का पूरा मुद्दा है। उद्देश्य AI को छिपाना या similarity checker को धोखा देना नहीं है; उद्देश्य सावधानीपूर्वक, सही लेखन को गलत तरीके से machine text की तरह पढ़े जाने से बचाना है, और काम करते समय integrity के नियमों के भीतर पूरी तरह रहना है।
यह अनुभाग हमारे multilingual AI humanizer hub के भीतर आता है, जो दर्जनों भाषा-परंपराओं (language backgrounds) से लिखने वाले शोधकर्ताओं के लिए वही वर्कफ़्लो कवर करता है। यदि आपकी बड़ी ज़रूरत detection fairness की बजाय लाइन-लेवल भाषा संपादन (line-level language editing) है, तो हमारी global academic editing hub शुरुआत के लिए बेहतर जगह है।
स्थानीय फंडिंग निकाय, जर्नल, और AI-disclosure की अपेक्षाएँ
डच प्रतिस्पर्धी (competitive) फंडिंग बड़े हिस्से में NWO (Nederlandse Organisatie voor Wetenschappelijk Onderzoek, the Dutch Research Council) के माध्यम से चलती है, जिसमें इसके Talent कार्यक्रम के अनुदान Veni, Vidi, और Vici शामिल हैं। स्वास्थ्य और चिकित्सा से जुड़े कार्य ZonMw के जरिए फंड होते हैं, और KNAW (Koninklijke Nederlandse Akademie van Wetenschappen, the Royal Netherlands Academy of Arts and Sciences) राष्ट्रीय शोध समुदाय के केंद्र में स्थित है। डच समूह यूरोपियन रिसर्च काउंसिल (ERC) के अनुदानों का बड़ा हिस्सा भी जीतते हैं, और Plan S के तहत ओपन-एक्सेस प्रकाशन NWO-फंडेड आउटपुट के लिए अनिवार्य है।
प्रकाशन पक्ष (publishing side) पर, डच शोधकर्ता Web of Science और Scopus-indexed जर्नलों को लक्ष्य करते हैं, आउटपुट को संस्थागत रिपॉज़िटरी में जमा करते हैं, और SURF तथा विश्वविद्यालयों के माध्यम से समन्वित राष्ट्रीय इन्फ्रास्ट्रक्चर का उपयोग करते हैं। फंडर और जर्नलों के बीच, AI को लेकर अपेक्षा एक ही सिद्धांत पर अभिसरित हो रही है: आप अपने उपयोग का खुलासा करें, उसे छिपाएँ नहीं। उस स्थान का संक्षिप्त, ईमानदार रिकॉर्ड रखना जहाँ AI ने आपके ड्राफ्टिंग में सहायता की, जब किसी ग्रांट रिपोर्ट या सबमिशन फ़ॉर्म में इसकी मांग हो, तब इस disclosure को सरल बना देता है। यदि आपको कभी अपने ही पेपर लिखने के बावजूद फ़्लैग किया जाता है, तो appealing a false AI detection flag पर हमारी गाइड बताती है कि कैसे जवाब देना है।
अक्सर पूछे जाने वाले प्रश्न
प्र: क्या मेरे पेपर पर AI ह्यूमनाइज़र का उपयोग करना cheating (धोखा) माना जाएगा?
नहीं, यदि आप इसे वैसा उपयोग करते हैं जैसा हमने बताया है। आप अपने ही AI-सहायतित ड्राफ्ट को ह्यूमनाइज़ करते हैं, अपना तर्क, डेटा, और citations intact रखते हैं, और फिर अपने AI उपयोग का disclosure अपने संस्थान और जर्नल को देते हैं। यह किसी बात को छिपाने के उलट है। यह जिस समस्या को हल करता है वह तकनीकी प्रकृति की है, सावधान लेखन को मशीन टेक्स्ट समझ लिए जाने की, ना कि किसी integrity-सम्बंधी (ईमानदारी) समस्या की।
प्र: मेरी अंग्रेज़ी सच में बहुत उत्कृष्ट है। फिर डिटेक्टर मेरा काम क्यों फ़्लैग करेगा?
क्योंकि डिटेक्टर यह नहीं मापते कि लेखन अच्छा है या नहीं; वे मापते हैं कि वह कितना अनुमानित (predictable) है। मजबूत, मानक (standard), और दूसरी भाषा की अंग्रेज़ी आम तौर पर बहुत सुसंगत (very consistent) होती है, और यही सुसंगतता वह कम perplexity उत्पन्न करती है जिसे डिटेक्टर AI टेक्स्ट से जोड़ते हैं। स्टैनफोर्ड अध्ययन में पाया गया कि मानव-लिखित गैर-मातृभाषी निबंधों को मातृभाषी की तुलना में कहीं अधिक बार फ़्लैग किया गया, वही पैटर्न वह है जिसमें बहुत से प्रवाही डच शोधकर्ता फँसते हैं।
प्र: क्या ह्यूमनाइज़र मुझे Turnitin या GPTZero में पास होने की गारंटी दे सकता है?
नहीं, और आपको ऐसे किसी भी टूल से सावधान रहना चाहिए जो ऐसा कहता हो। डिटेक्टर कुछ महीनों के भीतर अपने मॉडल बदल लेते हैं, इसलिए कोई भी ईमानदार प्रोडक्ट किसी विशिष्ट परिणाम का वादा या 100% undetectable होने का दावा नहीं कर सकता। हम यह कह सकते हैं कि, हमारे परीक्षण में, यह ह्यूमनाइज़र सावधान गैर-मातृभाषी गद्य (prose) के गलत तरीके से फ़्लैग होने की आवृत्ति को काफी हद तक कम करता है, जबकि आपका अर्थ और citations बिना बदले छोड़ देता है।
प्र: क्या ह्यूमनाइज़ करने से मेरी citations, शब्दावली (terminology), या डेटा बदल जाएगा?
नहीं। ह्यूमनाइज़र तकनीकी शब्दों, reference markers, और आपके तर्क की substance को संरक्षित रखने के लिए बनाया गया है। यह तथ्यों (facts), संख्याओं (numbers), या जिन स्रोतों (sources) को आप cite करते हैं, उनमें बदलाव नहीं करता; यह केवल rhythm और word choice को अधिक स्वाभाविक बनाने के लिए समायोजित करता है। फिर भी, सबमिट करने से पहले आपको परिणाम पढ़ना चाहिए, जैसा आप किसी भी संपादन (edit) के बाद करते हैं।
प्र: मैं पहले डच में लिखता/लिखती हूँ और अनुवाद करता/करती हूँ। क्या यह फिर भी काम करता है?
हाँ। आप डच में ड्राफ्ट कर सकते हैं, फिर उसका अनुवाद कर सकते हैं, और फिर अंग्रेज़ी संस्करण को ह्यूमनाइज़ कर सकते हैं। यह टूल गैर-अंग्रेज़ी और अनुवादित पाठ को language-aware मॉडल से गुज़ारता है जो sentence structure और meaning को स्थिर रखता है, इसलिए वर्कफ़्लो वह तरीके से फिट बैठता है जैसा बहुत से डच शोधकर्ता वास्तव में लिखते हैं।
सावधानीपूर्वक लिखे गए गैर-मातृभाषी अंग्रेजी पर होने वाले गलत AI संकेत कम करें, अपने अर्थ, शब्दावली और संदर्भों को यथावत रखते हुए। निःशुल्क आज़माएं, शोधकर्ताओं के लिए बनाया गया।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


