
अंग्रेज़ी में लिख रहे फ्रांसीसी शोधकर्ताओं के लिए AI ह्यूमनाइज़र
फ्रांसीसी शोधकर्ताओं के लिए AI ह्यूमनाइज़र। फ्रेंच-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन अलर्ट कम करें, अर्थ और उद्धरण बनाए रखें, और ईमानदारी से जानकारी दें।

फ्रांस प्रति वर्ष लगभग 62,200 Scopus-इंडेक्स्ड शोध-पत्र प्रकाशित करता है, दुनिया में शोध-उत्पादन के मामले में यह 11वां सबसे बड़ा आउटपुट है, जिसे सकल घरेलू उत्पाद (GDP) का लगभग 2.2% समर्थन देता है और विश्वविद्यालयों, grandes ecoles, तथा CNRS, INSERM, INRIA और CEA सहित अनेक राष्ट्रीय निकायों के घने नेटवर्क का साथ मिलता है। 300,000 से अधिक शोधकर्ता इस तंत्र को चलाए रखते हैं, और लगभग सभी उनमें से अपना कार्य अंग्रेज़ी में प्रकाशित करते हैं।
अब कई लोग ChatGPT, Claude या किसी अनुवाद उपकरण की मदद से लिखना शुरू करते हैं, फिर परिणाम को निखारते हैं। ठीक इसी क्षण के लिए फ्रांसीसी शोधकर्ताओं हेतु एक AI ह्यूमनाइज़र मौजूद है: आपका अर्थ और आपके उद्धरण यथावत रहें, जबकि आपकी “पॉलिश्ड” गद्य-शैली कम संभावना के साथ मशीन-लिखित समझी जाए। यह साधारण अकादमिक व्यवहार है, और समस्या तब शुरू होती है जब कोई डिटेक्टर, सावधानीपूर्वक, मानक अंग्रेज़ी पढ़कर, उसे generated कह देता है।
गलत अलर्ट कोई दुर्लभ दुर्घटना नहीं है। दूसरी भाषा के रूप में सावधानी से बनाई गई अंग्रेज़ी, वह प्रकार की लेखन-शैली जिसे फ्रांसीसी शोधकर्ता मेहनत से तैयार करते हैं, डिटेक्टरों द्वारा सबसे अधिक बार गलत आँकी जाने वाली लेखन-शैली है।
les chercheurs et chercheuses francais के लिए AI texte humaniseur
हमारा AI texte humaniseur फ्रैंकोफ़ोन शोधकर्ताओं को अंग्रेज़ी में प्रकाशित करने में मदद करता है, ताकि उनका काम अनुचित रूप से मशीन द्वारा “genere” (जनरेट) होने का संकेत न पाए। यह आपके अर्थ (sens), आपके तकनीकी शब्द (vos termes techniques) और आपके उद्धरणों (vos citations) को संरक्षित रखते हुए, आपके पाठ की लय (rythme) और शब्दावली (vocabulaire) में बदलाव करता है, जिससे आपकी लेखन-शैली अधिक प्राकृतिक लगे।
सरल शब्दों में, यह ह्यूमनाइज़र उस अंग्रेज़ी पर काम करता है जो आप पहले से लिख चुके हैं, या जिसे आप AI की मदद से ड्राफ्ट करके फिर संशोधित कर चुके हैं। यह कोई नए निष्कर्ष (findings) गढ़ता नहीं, और यह इस तथ्य को भी छुपाता नहीं कि आपने AI का उपयोग किया है। यह उस सपाट, दोहरावदार “cadence” को नरम करता है जिससे डिटेक्टर अक्सर जुड़ जाते हैं, ताकि आपका सावधानी से लिखा हुआ पाठ वैसा ही पढ़े जैसा वह वास्तव में है: एक मानवीय शोधकर्ता का कार्य।
फ़्रेंच में ड्राफ्ट कर रहे हैं? ह्यूमनाइज़र इसे भी पहचानकर प्रोसेस करता है
हर ड्राफ्ट शुरुआत अंग्रेज़ी में नहीं होती, और ह्यूमनाइज़र इसे अनिवार्य नहीं मानता। फ्रेंच टेक्स्ट पेस्ट करें और ProofreaderPro अपने आप भाषा पहचान लेगा, फिर उसे एक ऐसे French-aware मॉडल से गुजारेगा जो एक्सेंट, टर्मिनोलॉजी और संदर्भों को जगह पर बनाए रखता है। एक humaniseur de texte IA के रूप में यह आपकी फ्रेंच गद्य-शैली को सीधे फिर से लिखता है, ताकि आप अनुवाद करने से पहले मानवीकरण कर सकें, बाद में नहीं। यही स्वचालित पहचान साठ से अधिक भाषाओं तक फैली है, और हर भाषा को उसके अपने रजिस्टर में संभाला जाता है।
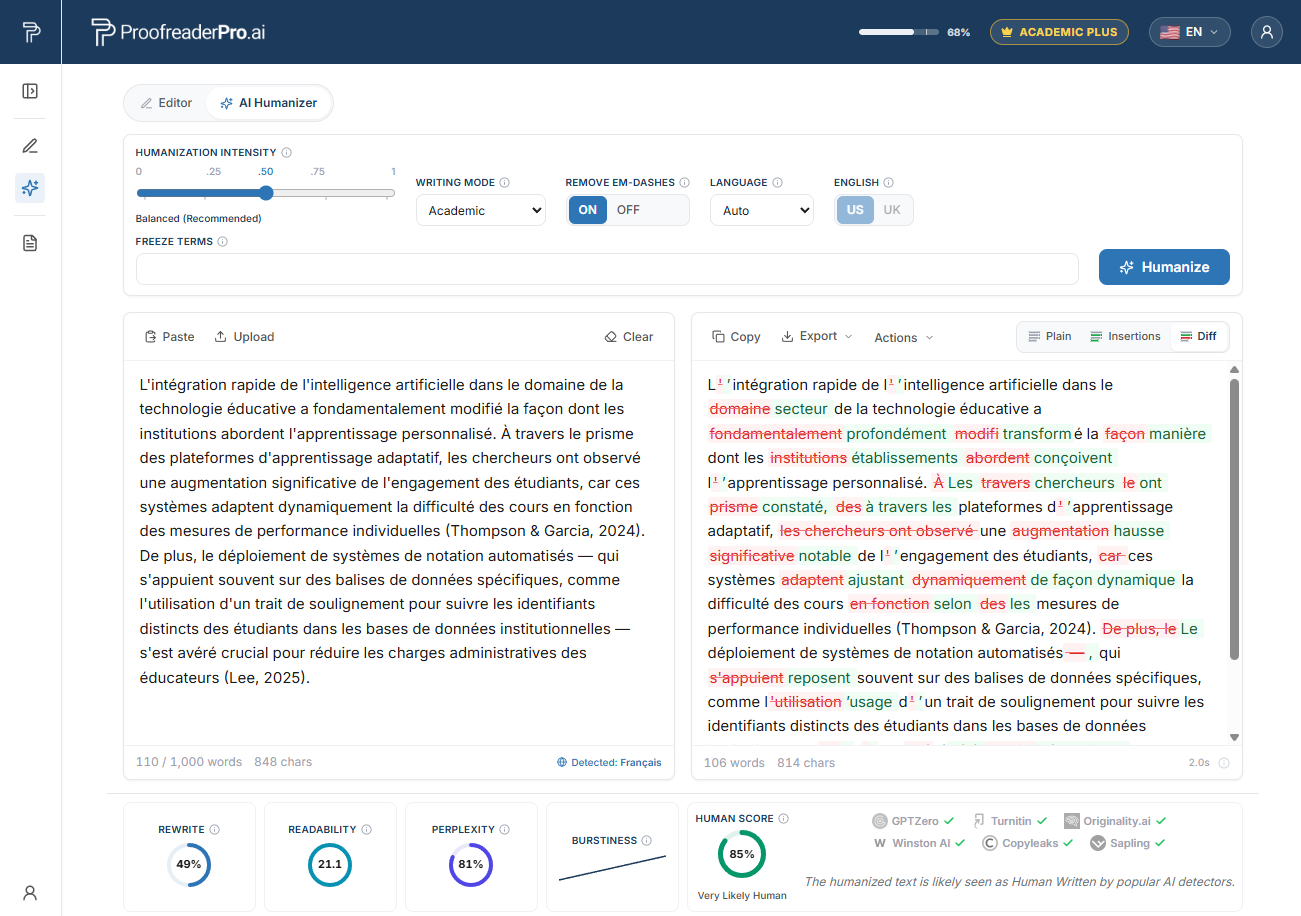
फ्रांसीसी शैक्षणिक पाठ को फिर से लिखता हुआ ProofreaderPro AI Humanizer। पहले/बाद का diff आपके अर्थ और उद्धरण बनाए रखता है, और डिटेक्टर चेक यह पुष्टि करते हैं कि पाठ स्वाभाविक, मानवीय रूप में पढ़ा गया।
फ़्रांसीसी शोधकर्ताओं को AI डिटेक्टरों द्वारा क्यों “फ्लैग” किया जाता है
सबसे स्पष्ट प्रमाण 2023 की स्टैनफोर्ड (Stanford) स्टडी से मिलता है, Liang और सहयोगियों द्वारा, जो Cell Press जर्नल Patterns में “GPT detectors are biased against non-native English writers.” शीर्षक के तहत प्रकाशित हुई थी। टीम ने मानव-लिखित TOEFL निबंधों को सात व्यापक रूप से उपयोग होने वाले डिटेक्टरों से चलाया।
औसतन, गैर-मातृभाषी (non-native) निबंधों में लगभग 61% को AI के रूप में फ्लैग किया गया, जबकि मातृभाषी अंग्रेज़ी (native English) लेखकों के लिए यह लगभग 5% था। गैर-मातृभाषी निबंधों में लगभग पाँच में से एक (लगभग 19.8%) को, हर डिटेक्टर ने, एकमत होकर फ्लैग किया। हर एक निबंध मनुष्य द्वारा लिखा गया था।
इसके पीछे तंत्र (mechanism) “perplexity” है। कई डिटेक्टर यह आँकते हैं कि भाषा मॉडल के लिए प्रत्येक शब्द-चयन कितना “surprising” है। सावधानी से लिखने वाले दूसरी भाषा के लेखक सामान्य शब्दों और मानक, अनुमान-योग्य phrasing का अधिक प्रयोग करते हैं, जिससे कम perplexity पैदा होती है और वह मशीन-टेक्स्ट की तरह पढ़ा जाता है। वे आदतें जो गैर-मातृभाषी अकादमिक गद्य को स्पष्ट बनाती हैं, वही आदतें डिटेक्टरों को “संदेह” के रूप में देखने के लिए प्रशिक्षित की गई थीं। हम पूरी प्रक्रिया why AI detectors flag non-native writers में विस्तार से बताते हैं।
गलत फ्लैग के पीछे फ्रांसीसी प्रथम-भाषा के पैटर्न
फ्रेंच और अंग्रेज़ी के बीच हजारों शब्द साझा हैं और उनके बीच सदियों का आदान-प्रदान रहा है, इसलिए फ्रांसीसी शोधकर्ताओं के पास बड़ी “passive” अंग्रेज़ी शब्दावली होती है। इस साझा शब्द-संग्रह (shared lexicon) के भीतर मौजूद जालों से बचने के लिए वे लेखन को “defensive” तरीके से लिखते हैं। यह defensive सतर्कता अच्छी scholarship है, और यही डिटेक्टर द्वारा जनरेटेड (generated) पढ़ी जाने वाली कम-perplexity cadence को भी प्रेरित करती है।
Faux amis लेखकों को सबसे सुरक्षित शब्द की ओर धकेलते हैं। गलत संज्ञेय (false cognates) सबसे तीखा जाल है: “actually” ≠ “actuellement” (वर्तमान), “eventually” ≠ “eventuellement” (संभवतः), और “experience” का प्रयोग अक्सर “experiment” के लिए किया जाता है। अनुभवी फ्रांसीसी लेखक हर बार सबसे सामान्य और कम-जोखिम वाले अंग्रेज़ी शब्द का चुनाव करके इनसे बचना सीखते हैं। यही वह सामान्य शब्दावली है जिसे डिटेक्टर मशीन-टेक्स्ट से जोड़ते हैं।
Uncountable nouns over-correction को आमंत्रित करते हैं। फ्रेंच उन संज्ञाओं को बहुवचन बनाता है जिन्हें अंग्रेज़ी एकवचन रखती है: “informations,” “researches,” “equipments,” “evidences,” “advices.” एक बार सुधार हो जाने के बाद, शोधकर्ता अक्सर सरल, पाठ्यपुस्तक-शैली की रचनाओं से समस्या के “आसपास” लिखने लगते हैं। समीक्षक के लिए पूर्वानुमेय (predictable) सुरक्षित है, और डिटेक्टर के लिए वही संदिग्ध बन जाता है।
Abstract के साथ article का प्रयोग सपाट (flat) कर दिया जाता है। फ्रेंच लगभग हर संज्ञा से article जोड़ता है (“la science,” “le bonheur”), इसलिए सावधानीपूर्वक लिखने वाले अपने आप को अंग्रेज़ी के generalizations में उसे छोड़ना सिखाते हैं। परिणामस्वरूप, वाक्य-रचना साफ़-सुथरी होती है, नियमों के अनुरूप (rule-perfect) phrasing, और rule-perfect phrasing वही है जिसे perplexity स्कोर स्वचालित मान लेता है।
Adverb की स्थिति मानकीकृत हो जाती है। फ्रेंच adverb को क्रिया के बाद रखता है (“We analyzed carefully the results”). अंग्रेज़ी नियम सीख चुके लेखक उसे conventional slot में ले जाते हैं (“We carefully analyzed the results”). उनके वाक्य smooth और uniform हो जाते हैं, और पूरी अनुच्छेद-रचना में uniform cadence perplexity को घटा देती है।
Prepositions को याद करके एकसमान तरीके से लागू किया जाता है। फ्रेंच prepositions को अलग तरह से मैप करता है: “consist in,” “depend of,” “interested to,” “responsible of.” सावधान लेखक अंग्रेज़ी के इन जोड़ों को सीखते हैं और उन्हें पूर्ण स्थिरता (total consistency) के साथ लागू करते हैं। बिल्कुल consistent गद्य, डिटेक्टर के लिए एक और संकेत है कि वह जनरेटेड जैसा पढ़ता है।
लंबी clause-chains काटकर छोटी कर दी जाती हैं। फ्रांसीसी अकादमिक शैली stack किए गए subordinate clauses के साथ लंबे वाक्यों को प्राथमिकता देती है। जब Anglophone पाठकों के लिए छोटे वाक्य पसंद किए जाते हैं, यह सुनकर फ्रांसीसी शोधकर्ता अपने गद्य को अक्सर छोटे, even, घोषणात्मक (declarative) हिस्सों में काट देते हैं। कई वाक्यों के बीच वाक्य-लंबाई की यह समानता भी डिटेक्टर द्वारा इस्तेमाल किए जाने वाले सबसे मजबूत संकेतों में से एक है।
इनमें से कोई भी गलती नहीं है, एक सुधार होने के बाद भी नहीं। ये एक diligent non-native लेखक की पहचान हैं, और वही diligence गलत पढ़ी जाती है।
फ्रांस का AI-डिटेक्शन और Turnitin संदर्भ
फ्रांस में अधिकांश doctoral स्कूल (ecoles doctorales) और जर्नल थीसिस तथा मैनुस्क्रिप्ट्स को similarity के लिए Turnitin या iThenticate से स्क्रीन करते हैं, और कई अब similarity के आँकड़े के साथ एक AI-writing संकेतक भी सामने लाते हैं। फ्रांस में शोध-ईमानदारी (research-integrity) का माहौल इसी के समानांतर सख्त हुआ है: विश्वविद्यालय referents integrite scientifique (research integrity officers) नियुक्त करते हैं, और फंडर्स तथा जर्नल लेखक से तेजी से यह पूछते हैं कि क्या उन्होंने AI सहायता का उपयोग किया था।
इन सबका अर्थ यह नहीं कि AI का उपयोग निषिद्ध है। इसका अर्थ यह है कि पूर्ण प्रकटीकरण (full disclosure) की अपेक्षा है। जोखिम “प्रकटीकरण” नहीं है। जोखिम यह है कि डिटेक्टर का स्कोर, जब वह केवल एक दावा (claim) हो, उसे निर्णय (verdict) की तरह मान लिया जाए।
यह सावधानी उचित है। Vanderbilt ने 2023 में Turnitin के AI detector को बंद कर दिया था, false positives और non-native writers के खिलाफ पक्षपात (bias) का हवाला देते हुए। Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, और Waterloo ने भी इसी तरह के कदम उठाए। स्वयं Turnitin भी 1 से 19% रेंज में स्कोर दबा देता है, संख्या के बजाय एक asterisk दिखाता है, और चेतावनी देता है कि उसका स्कोर अपने आप में किसी integrity मामले का फैसला नहीं होना चाहिए। कोई फ्लैग, चुनौती देने योग्य चीज़ है, कोई इकबालिया बयान नहीं।
अपने सावधानी से लिखे अंग्रेजी को गलत AI अलर्ट से सुरक्षित रखिए
कुछ ही सेकंड में अपने AI-सहायता प्राप्त मसौदे को मानवीय बनाइए। अपना अर्थ, शब्दावली और उद्धरण सुरक्षित रखें, फिर अपने जर्नल की अपेक्षा के अनुसार अपने AI उपयोग का खुलासा करें। अंग्रेजी में प्रकाशित करने वाले फ्रांसीसी शोधकर्ताओं के लिए बनाया गया।
Humanizer को निःशुल्क आज़माइएशीर्ष फ्रांसीसी विश्वविद्यालय और जहाँ AI जांच दिखाई देती है
फ्रांस विश्वविद्यालयों, grandes ecoles, और राष्ट्रीय शोध संगठनों के जरिए चलता है, और उसके सबसे मजबूत शोध-उत्पादक तीनों में फैले हैं। थीसिस और मैनुस्क्रिप्ट्स को similarity तथा AI संकेतकों के लिए जांचना अब उनके यहाँ एक नियमित प्रक्रिया है।
- Sorbonne Universite (पेरिस), UPMC और Paris-Sorbonne से मिलकर बना, गणित, भौतिकी, चिकित्सा और मानविकी में मजबूत, और CNRS के साथ गहरी सहयोग-परियोजनाएँ।
- Universite Paris-Saclay (Saclay और Orsay), शंघाई रैंकिंग में लगातार दुनिया के शीर्ष 15 में शामिल, तथा प्रमुख राष्ट्रीय प्रयोगशालाओं की मेजबानी।
- Universite PSL (Paris Sciences et Lettres) (पेरिस), एक collegiate विश्वविद्यालय समूह जिसमें ENS, Dauphine, ESPCI और Mines Paris शामिल हैं।
- Universite Paris Cite (पेरिस), Paris Descartes और Paris Diderot से निर्मित, और चिकित्सा व जीवन-विज्ञान में INSERM के साथ मजबूत साझेदारियाँ।
- Universite Grenoble Alpes (Grenoble), भौतिकी और condensed matter का केंद्र, ESRF और Institut Laue-Langevin का घर।
- Aix-Marseille Universite (Marseille), फ्रांस का सबसे बड़ा विश्वविद्यालय, दर्जनों संयुक्त CNRS शोध इकाइयों के साथ।
- Universite de Strasbourg (Strasbourg), रसायन विज्ञान और life-sciences की ताकत, और League of European Research Universities का सदस्य।
- Universite de Bordeaux (Bordeaux), न्यूरोसाइंस, सामग्री-विज्ञान (materials science) और लेज़र भौतिकी में मजबूत।
- Universite Claude Bernard Lyon 1 (Lyon), रसायन, जीवविज्ञान और भौतिकी में एक प्रमुख शोध-स्थल।
- Ecole Polytechnique (Palaiseau), फ्रांस का सबसे प्रतिष्ठित विज्ञान व अभियांत्रिकी grande ecole, Institut Polytechnique de Paris का भाग।
- Ecole Normale Superieure (ENS) (पेरिस), अत्यंत उच्च per-capita शोध-उत्पादन वाला एक elite grande ecole, PSL का हिस्सा।
- Universite Toulouse III - Paul Sabatier (Toulouse), एयरोस्पेस, एस्ट्रोफिज़िक्स और रसायन विज्ञान में मजबूत।
इन प्रत्येक संस्थान में अंग्रेज़ी-भाषा में प्रकाशन HDR योग्यता, Professeur des Universites के पदोन्नयन, और प्रतिस्पर्धी CNRS भर्ती को आगे बढ़ाता है। आपकी अंग्रेज़ी पर दांव जितना ऊँचा होगा, उतना ही एक अकेला गलत AI फ्लैग आपको भारी कीमत चुका सकता है।
फ्रांसीसी शोधकर्ताओं के लिए AI ह्यूमनाइज़र कैसे काम करता है
इस वर्कफ़्लो में चार चरण हैं, और इनमें से कोई भी आपके कार्य को छिपाने से संबंधित नहीं है।
पहला: ड्राफ्ट करें। अंग्रेज़ी में लिखें, या फ्रेंच में ड्राफ्ट करें जहाँ आपकी reasoning बहती हो, फिर उसका अनुवाद कर दें, दोनों ही स्थितियों में ideas और evidence आपके अपने हैं। दूसरा: व्याकरण (grammar) को प्रूफरीड करें, ताकि faux amis, preposition slips और article errors किसी के पढ़ने से पहले ही हट जाएँ। तीसरा: अपने AI-assisted अंग्रेज़ी पर AI humanizer चलाएँ, ताकि सपाट, दोहरावदार cadence टूटे, जबकि आपका अर्थ, आपकी terminology, और आपके उद्धरण बिल्कुल वैसी ही तरह रहें जैसे आपने उन्हें लिखा था। चौथा: अपने AI उपयोग को उस प्रारूप में बताएं जिसकी मांग आपका संस्थान और लक्ष्य जर्नल करता है।
प्रमुख डिटेक्टरों के विरुद्ध परीक्षण किया गया, हमारा ह्यूमनाइज़र AI टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में फिर से लिखता है, जिससे AI signal घटता है और कठिन डिटेक्टरों के विरुद्ध इसके अवसर बेहतर होते हैं, साथ ही अकादमिक टेक्स्ट में व्याकरण की सटीकता उच्च बनी रहती है। ये परीक्षण-आधारित परिणाम हैं, गारंटी नहीं। डिटेक्टर हर कुछ महीनों में फिर से प्रशिक्षण (retrain) लेते हैं, इसलिए कोई भी गंभीर टूल 100% या स्थायी bypass का वादा नहीं कर सकता। टूल जो विश्वसनीय रूप से करता है, वह यह है कि आपकी scholarship बनी रहे और उन मशीन-जैसी पैटर्नों को कम करे जो गलत फ्लैग ट्रिगर करते हैं।
यह वास्तविक कार्य के लिए निष्पक्षता है, छिपाव नहीं। यदि आप इन गलत फ्लैग्स के पीछे अलग-अलग भाषाओं में प्रमाण देखना चाहते हैं, तो हमारा multilingual AI humanizer hub उन्हें संकलित करता है, और फ्रांस में शोधकर्ताओं के लिए academic editing guide व्याकरण वाले पक्ष को विस्तार से कवर करता है।
स्थानीय फंडिंग निकाय, जर्नल, और AI-प्रकटीकरण की अपेक्षाएँ
फ्रांस में प्रकाशन (publication) का दबाव उसके फंडर्स और मूल्यांकनकर्ताओं (evaluators) के माध्यम से चलता है। ANR (Agence Nationale de la Recherche) प्रतिस्पर्धी परियोजनाओं को फंड करता है और उन्हें उच्च-रैंकिंग अंग्रेज़ी भाषा के जर्नलों में प्रकाशितियों के आधार पर जज करता है। CNRS 1,000 से अधिक प्रयोगशालाओं में फैले 30,000 से अधिक शोधकर्ताओं को रोजगार देता है, और उसका Comite National हर प्रमोशन में प्रकाशन रिकॉर्ड को तौलता है। INSERM, CEA और CNES के शोधकर्ता भी अंतरराष्ट्रीय जर्नलों में स्वाभाविक रूप से प्रकाशित करते हैं। HCERES हर पाँच साल में शोध इकाइयों का मूल्यांकन करता है, और CNU योग्यता (qualification) को संभालता है, जहाँ publication output केंद्र में होता है।
यहाँ तक कि फ्रांसीसी जर्नल्स को भी विदेश भेजे जाने पर अंग्रेज़ी में पेपर रखने होते हैं। प्रमुख शीर्षकों में Comptes Rendus Mathematique, Comptes Rendus Physique, Comptes Rendus Chimie, Comptes Rendus Biologies (Academie des Sciences), Annales de l'Institut Fourier (Grenoble), Annales de l'Institut Henri Poincare (गणित और सैद्धांतिक भौतिकी), और European Physical Journal (EDP Sciences के साथ सह-प्रकाशित)।
अब इन फंडर्स और जर्नलों में से कई AI उपयोग के बारे में एक संक्षिप्त बयान (short statement) की अपेक्षा करते हैं। क्योंकि humanizer आपके उद्धरण और अर्थ को संरक्षित रखता है, यह प्रकटीकरण लिखना सरल हो जाता है: आपने AI सहायता और एक ह्यूमनाइज़र का उपयोग करके अपने ही ड्राफ्ट को पॉलिश किया, और निष्कर्ष आपके अपने हैं। यदि आपको वाक्य-रचना (wording) चाहिए, तो हमारा AI disclosure statement guide देखें, और यदि फ्लैग पहले ही लग चुका है, तो हमारा appeal playbook for a false AI flag प्रतिक्रिया के तरीके को चरण-दर-चरण बताता है।
अक्सर पूछे जाने वाले प्रश्न
प्र: क्या फ्रांसीसी शोधकर्ताओं के लिए AI ह्यूमनाइज़र मुझे किसी डिटेक्टर को “चिट” करने में मदद करता है?
नहीं। यह टूल आपके अपने AI-assisted ड्राफ्ट को humanize करने के लिए है, किसी गढ़े हुए (fabricated) या उधार लिए गए काम को छिपाने के लिए नहीं। यह आपके अर्थ और उद्धरणों को यथावत रखता है और उन low-perplexity पैटर्नों को घटाता है जो गलत फ्लैग का कारण बनते हैं। फिर भी आप अपने AI उपयोग की घोषणा उसी तरह करते हैं जैसा आपका संस्थान और जर्नल आवश्यक मानता है।
प्र: क्या ह्यूमनाइज़र मेरे उद्धरणों या तकनीकी शब्दों को बदलेगा?
नहीं। यह आपके संदर्भों (references), आपकी discipline-specific terminology, और हर दावे (claim) के सार (substance) को संरक्षित रखता है। यह लय और शब्द-चयन (word choice) में बदलाव करता है और repetitive cadence हटाता है, ताकि आपका तर्क वही बना रहे, और मशीन-जैसा “texture” कम हो जाए।
प्र: क्या यह सुनिश्चित कर सकता है कि मेरा पेपर Turnitin या GPTZero पास कर जाए?
नहीं। कोई भी विश्वसनीय टूल यह गारंटी नहीं दे सकता। हमारे परीक्षण में ह्यूमनाइज़र AI टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में फिर से लिखता है, जिससे AI signal घटता है और कठिन डिटेक्टरों के विरुद्ध इसकी संभावनाएँ बेहतर होती हैं, साथ ही व्याकरण की सटीकता उच्च बनी रहती है। ये परीक्षण-आधारित परिणाम हैं, वादे नहीं। डिटेक्टर अक्सर फिर से प्रशिक्षित (retrain) होते हैं, इसलिए किसी भी स्कोर को ऐसे “दावे” की तरह मानें जिसे आप चुनौती दे सकते हैं, न कि किसी अंतिम निर्णय (verdict) की तरह।
प्र: मैंने फ़्रेंच में ड्राफ्ट किया और उसे अंग्रेज़ी में अनुवाद किया। क्या मैं इसे फिर भी उपयोग कर सकता/सकती हूँ?
हाँ। अनूदित अकादमिक गद्य अक्सर खास तौर पर smooth और मानक (standard) होता है, और डिटेक्टर अक्सर वही चीज़ गलत समझते हैं। अपने अनुवादित अंग्रेज़ी को ह्यूमनाइज़र के माध्यम से चलाने से प्राकृतिक विविधता (natural variation) वापस आती है, जबकि अर्थ सुरक्षित रहता है। यह फ्रेंच और 60 से अधिक अन्य भाषाओं में भी काम करता है।
प्र: ANR या CNRS की integrity नियमों के अंतर्गत humanizer का उपयोग अनुमत है?
अपने लेखन को निखारना और AI सहायता का प्रकटीकरण करना मानक integrity अपेक्षाओं के अनुरूप है। इस बात की “लाइन” ईमानदारी है: उस लेखन को humanize करें जो वास्तव में आपका अपना है, निष्कर्ष (findings) अपरिवर्तित रखें, और जब आपका फंडर या जर्नल पूछे तो यह बताएं कि आपने AI टूल्स का उपयोग किया। यह संयोजन नियम तोड़े बिना सावधानीपूर्ण non-native लेखन की सुरक्षा करता है।
बार-बार होने वाली लय के उन संकेतों को तोड़िए जिन्हें डिटेक्टर चिन्हित करते हैं, जबकि आपके उद्धरण और तकनीकी शब्द अक्षुण्ण रहें। Turnitin, Originality.ai, और GPTZero के विरुद्ध परीक्षण किया गया, और गैर-मातृभाषी शैक्षणिक अंग्रेजी के लिए अनुकूलित किया गया।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


