OpenAI वॉटरमार्क, SynthID और Claude: टेक्स्ट वॉटरमार्क की तुलना
क्या OpenAI अपने टेक्स्ट पर वॉटरमार्क लगाता है, क्या कोई सार्वजनिक OpenAI वॉटरमार्क चेकर उपलब्ध है, और SynthID तथा Claude वॉटरमार्क में अकादमिक लेखकों के लिए क्या अंतर है?
OpenAI, Google और Anthropic ने सभी ने एक ही तकनीक बनाई है: AI-जनित टेक्स्ट के लिए एक सांख्यिकीय वॉटरमार्क। OpenAI ने अपना संस्करण कई सालों तक रोके रखा और अक्टूबर 2026 में इसे textGrain के रूप में लागू करना शुरू किया। Google ने Gemini के अंदर SynthID भेजा और उसकी विधि प्रकाशित की। Anthropic ने अगस्त 2026 में हर उपयोगकर्ता के लिए Claude के वॉटरमार्क को अनिवार्य कर दिया। आप किसी भी रूप में AI सहायता से लिखते हैं, तो अब ये तीनों फैसले यह तय करते हैं कि आपके दस्तावेजों का मूल्यांकन कैसे होगा।
वॉटरमार्किंग 11 अगस्त 2026 को रिसर्च विषय से मुख्यधारा की खबर बन गई, जब Anthropic ने घोषणा की कि हर नया Claude मॉडल अपने टेक्स्ट आउटपुट पर वॉटरमार्क लगाता है। हमने उस घोषणा को विस्तार से अपने Anthropic का Claude वॉटरमार्क, समझाया गया (2026) में कवर किया था। यह गाइड पूरी तस्वीर बताता है: टेक्स्ट वॉटरमार्क क्या है, तीनों प्रमुख लैबों ने इसे लागू करने या रोकने का निर्णय कैसे लिया, और हर सिस्टम किसी लिखित सामग्री के बारे में क्या साबित करता है।
AI टेक्स्ट वॉटरमार्क क्या है?
AI टेक्स्ट वॉटरमार्क जनित टेक्स्ट की शब्द-चयन में छिपा एक सांख्यिकीय पैटर्न होता है। इसे जेनरेशन के समय लगाया जाता है ताकि सही कुंजी रखने वाला डिटेक्टर बाद में यह सत्यापित कर सके कि यह टेक्स्ट किसी विशिष्ट AI सिस्टम से आया था। यह कोई दिखाई देने वाला लेबल नहीं होता, कोई छिपा हुआ कैरेक्टर नहीं होता, और यह फ़ाइल पर अटैच किया गया मेटाडेटा भी नहीं होता। यह निशान खुद शब्दों के भीतर रहता है।
यह फर्क महत्वपूर्ण है, क्योंकि "वॉटरमार्क" शब्द का इस्तेमाल ढीलेपन से तीन अलग-अलग चीज़ों के लिए किया जाता है:
| यह क्या है | यह कहाँ रहता है | कॉपी-पेस्ट के बाद भी टिकता है? | |
|---|---|---|---|
| सांख्यिकीय वॉटरमार्क | एक पक्षपात जिसमें मॉडल कुछ शब्द चुनता है | खुद टेक्स्ट | हाँ |
| फ़ाइल मेटाडेटा (C2PA) | एक हस्ताक्षरित प्रोवेनेंस लेबल | फ़ाइल कंटेनर | नहीं, साधारण-प्लेन टेक्स्ट कॉपी इसे खत्म कर देती है |
| शून्य-चौड़ाई वर्ण | पाठ में अदृश्य यूनिकोड डाला जाता है | दिखने वाले वर्णों के बीच | नहीं, आसानी से हट जाता है |
तीनों में से सांख्यिकीय वॉटरमार्किंग ही एकमात्र है जो कॉपी, पेस्ट, दोबारा टाइप करने और नए दस्तावेज़ में फॉर्मैट रूपांतरण करने पर भी बची रहती है। इसलिए तीनों प्रमुख लैब्स ने टेक्स्ट के लिए इसी पर अभिसरण किया, और इसलिए ऐसे "वॉटरमार्क रिमूवर्स" जो अदृश्य वर्णों को हटाते हैं, इसके खिलाफ कुछ नहीं कर पाते। हमारे Claude वॉटरमार्क रिमूवर को लेकर पेज पर इस विफलता वाले मोड को स्रोतों के साथ दिखाया गया है।
सांख्यिकीय वॉटरमार्किंग वास्तव में कैसे काम करती है?
वाक्य लिखने के हर चरण में, एक भाषा मॉडल कई लगभग-समान शब्दों में से चुनता है, और वॉटरमार्क चुपचाप उन पासों को लोड कर देता है। मूल नुस्खा जनवरी 2023 में यूनिवर्सिटी ऑफ मैरीलैंड में Kirchenbauer और उनके सहकर्मियों द्वारा प्रकाशित किया गया था, बड़े भाषा मॉडल्स के लिए एक वॉटरमार्क (ICML 2023) में। यह ऐसे काम करता है:
- प्रत्येक शब्द के चुने जाने से पहले, उससे पहले के शब्दों से निकली एक गुप्त कुंजी शब्दावली को एक पसंदीदा सेट और एक न्यूट्रल सेट में बाँट देती है।
- मॉडल अपने चुनाव को पसंदीदा सेट की ओर थोड़ा झुकाता है। "Suggest" की जगह "indicate"। "Across" की जगह "among"। हर एक व्यक्तिगत चुनाव पूरी तरह स्वाभाविक लगता है।
- कुंजी रखने वाला एक डिटेक्टर यह गिनता है कि टेक्स्ट पसंदीदा सेटों में कितनी बार पहुँचता है। सामान्य मानव लेखन संयोग से अपेक्षित दर पर पहुँचता है। वॉटरमार्क वाला टेक्स्ट इससे कहीं अधिक बार पहुँचता है, और सांख्यिकीय परीक्षण इस अंतर को पकड़ लेता है।
कोई भी एक शब्द किसी भी चीज़ का सबूत नहीं है। संकेत दर्जनों या सैकड़ों चुनावों के पार ही उभरता है, इसलिए लंबे अंश छोटे अंशों की तुलना में जाँचने में आसान होते हैं, और इसलिए पहचान हमेशा संभाव्य होती है, न कि हाँ/नहीं की मोहर।
Google DeepMind की उत्पादन प्रणाली, जिसे अक्टूबर 2024 में Nature में बड़े भाषा मॉडल के आउटपुट की पहचान के लिए स्केलेबल वॉटरमार्किंग के रूप में प्रकाशित किया गया, ने इसे tournament sampling नाम की तकनीक से और बेहतर बनाया। इससे टेक्स्ट की गुणवत्ता इतनी अच्छी बनी रहती है कि इसे बड़े पैमाने पर उपभोक्ता उत्पाद के भीतर चुपचाप चलाया जा सके। यह पेपर Google से आगे भी मायने रखता है: यह वही प्रकाशित आधार है जिसे Anthropic, Claude के कार्यान्वयन के लिए इंगित करता है।
मुख्य कमजोरी अधिकांश तैनाती से पहले ही प्रकाशित हो चुकी थी। मार्च 2023 में, Krishna और उनके सहकर्मियों ने AI-generated टेक्स्ट के डिटेक्टरों को Paraphrasing से चकमा (NeurIPS 2023) में दिखाया कि किसी अंश के शब्दों का पुनर्लेखन, पद्धतिों में फैली पहचान को, वॉटरमार्किंग सहित, ढहा देता है। संकेत उसी सटीक टोकन अनुक्रम में रहता है और कहीं नहीं, इसलिए अनुक्रम को फिर से लिखने वाला कुछ भी, मानव संपादक सहित, सबूत को उसी तरह मिटा देता है। आज जो भी विक्रेता वॉटरमार्क भेज रहा है, वह अपनी अलग दस्तावेज़ीकरण में इस सीमा को बताता है।
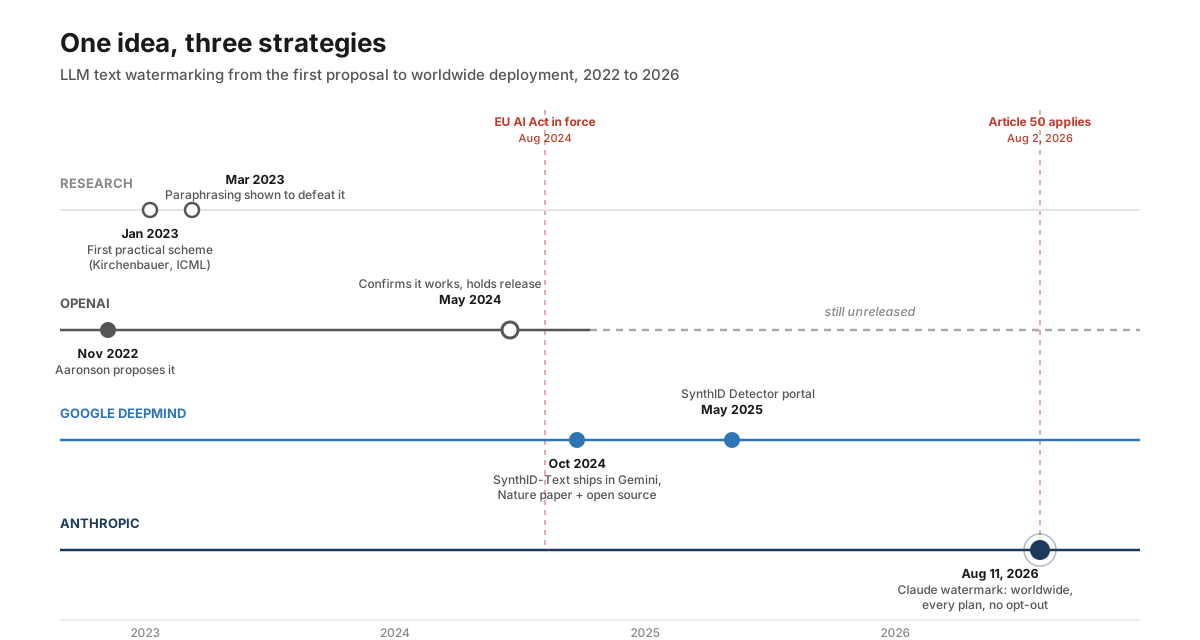
OpenAI: वह कंपनी जिसने इसे बनाया और सबसे आखिर में इसे शिप किया
OpenAI के पास वर्षों से एक कार्यशील टेक्स्ट वॉटरमार्क मौजूद था और उसने उसे अक्टूबर 2026 तक जारी नहीं करने का निर्णय लिया। Scott Aaronson, तब OpenAI में सेफ्टी पर काम कर रहे थे, ने इस विचार को सार्वजनिक रूप से पहली बार नवंबर 2022 की एक व्याख्यान में बताया। यह तरीका गुप्त क्रिप्टोग्राफ़िक फ़ंक्शन के जरिए मॉडल के चुनावों को लगभग-समान शब्दों के बीच पक्षपाती बनाता है, इसलिए टेक्स्ट खुद बताता है कि वह कहाँ से आया है। वह व्याख्यान हर तैनात सिस्टम से पुराना है।
मई 2024 में, OpenAI ने provenance अपडेट में परियोजना की स्थिति का वर्णन किया, हम ऑनलाइन जो देखते और सुनते हैं उसके स्रोत को समझना। कंपनी ने कहा कि उसकी टेक्स्ट वॉटरमार्किंग विधि छोटे बदलावों पर सटीक और प्रभावी थी, लेकिन वह फायदे-नुकसान का आकलन करते हुए रिलीज़ रोककर रखे हुए थी। OpenAI द्वारा बताए गए दो जोखिम शैक्षणिक लेखकों के लिए सीधे मायने रखते हैं:
- आसानी से बच निकलना। टेक्स्ट का पराफ्रेज़ करना या अनुवाद करना उस निशान को हटा देता है, ठीक वैसे ही जैसा 2023 के शोध ने अनुमान लगाया था। जो वॉटरमार्क अधिकतर उन लोगों को पकड़ता है जो जानते ही नहीं कि यह मौजूद है, वह एक कमजोर प्रवर्तन उपकरण है।
- दूसरी भाषा के बोलने वालों पर असमान प्रभाव। OpenAI ने कहा कि वॉटरमार्किंग, दूसरी भाषा में लिखने वालों के लिए लेखन सहायता के रूप में AI के वैध उपयोग को कलंकित कर सकती है। क्यों AI डिटेक्टर गैर-देशी अंग्रेज़ी लिखने वालों को निशाना बनाते हैं पर हमारा लेख डिटेक्टर के नजरिये से यही समस्या कवर करता है।
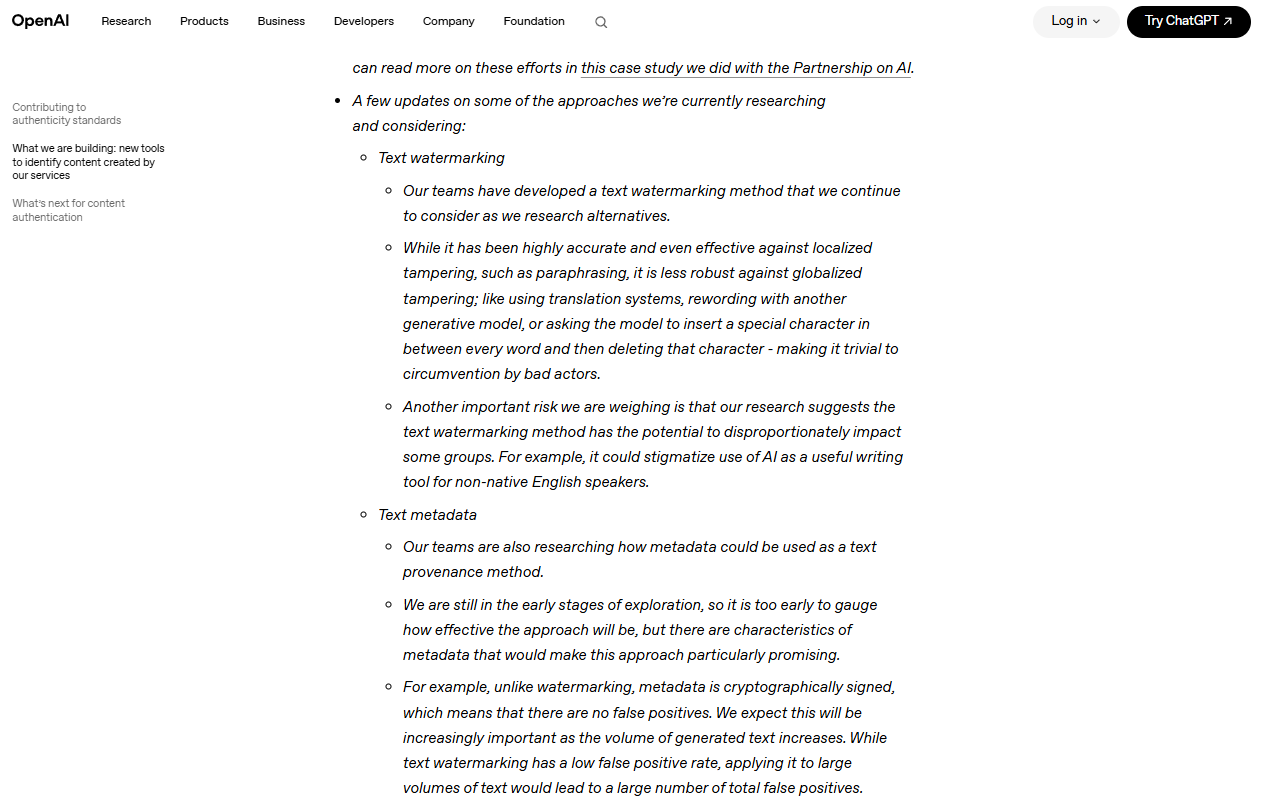
OpenAI का 2024 provenance अपडेट: यह विधि काम करती है, और कंपनी उस समय इसे रोककर रखने के कारण भी सूचीबद्ध करती है।
छवियों और ऑडियो के लिए, OpenAI ने अलग रास्ता अपनाया: DALL-E और Sora के आउटपुट में C2PA provenance मेटाडेटा, जो कंटेंट के अंदर कोई निशान नहीं बल्कि फाइल-स्तरीय लेबल है। टेक्स्ट के लिए, ChatGPT के आउटपुट में अक्टूबर 2026 तक कोई वॉटरमार्क नहीं था। जिस कंपनी ने यह तकनीक प्रस्तावित की थी, वह तीनों में आखिरी थी जिसने इसे लागू किया।
क्या OpenAI अब टेक्स्ट पर वॉटरमार्क लगाता है?
हाँ, OpenAI ने EU AI Act के जवाब में 5 अक्टूबर 2026 से कुछ टेक्स्ट पर वॉटरमार्किंग शुरू की। उसका घोषणा-पत्र textGrain नामक एक टेक्स्ट वॉटरमार्क पेश करता है, जो मॉडल के शब्द चयन में एक अदृश्य सांख्यिकीय संकेत जोड़ता है। इस रोलआउट के तीन चरण हैं, और वॉटरमार्क वैश्विक डिफ़ॉल्ट नहीं है:
- किसी भी जगह के API ग्राहक चुनिंदा मॉडल्स के लिए वॉटरमार्क्ड आउटपुट चालू कर सकते हैं। यह डिफ़ॉल्ट रूप से बंद रहता है।
- आने वाले हफ्तों में, यूरोपीय संघ में पात्र ChatGPT और Codex के टेक्स्ट आउटपुट को सभी योजनाओं पर वॉटरमार्क मिलेगा।
- स्वीकृत शोधकर्ता और विशेषज्ञ संगठन टेक्स्ट वॉटरमार्क डिटेक्टर तक पहुँच के लिए आवेदन कर सकते हैं।
OpenAI का कहना है कि textGrain ने जिन अन्य तरीकों का उसने परीक्षण किया, उनमें या तो बराबरी की या बेहतर प्रदर्शन किया, जिनमें टेक्स्ट के लिए Google का SynthID शामिल है। उसने यह भी प्रकाशित किया कि डिटेक्शन कहाँ कमजोर पड़ता है। 1% false-positive दर पर, डिटेक्टर ने साइकोलॉजी सामग्री वाले 200-टोकन के लगभग 80% पैसज में और 400-टोकन के लगभग 95% पैसज में वॉटरमार्क की पहचान की। गणित के लिए डिटेक्शन काफी कम था, जहाँ शब्द चयन की स्वतंत्रता कम होती है।
एडिटिंग सिग्नल को तेजी से कमजोर करती है। 400-टोकन पैसज में, शब्दों के 10% को synonyms से बदलने पर डिटेक्शन लगभग 92% से घटकर 66% हो गया, और 25% बदलने पर यह 17% रह गया।
OpenAI ने यह भी जाँचा कि Astra, उसके नवीनतम मॉडल, पर वॉटरमार्क उत्तर की गुणवत्ता को बदलता है या नहीं, और उसका कहना है कि उसे कोई सार्थक अंतर नहीं दिखा। ये चार बेंचमार्क हैं जो उसने प्रकाशित किए:
| बेंचमार्क | बिना वॉटरमार्क (Astra) | वॉटरमार्क के साथ (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 अंक | 49.76 अंक |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
छात्रों के लिए तारीख मायने रखती है। रोलआउट से पहले लिखा गया ChatGPT टेक्स्ट, या API सेटिंग के बिना EU के बाहर लिखा गया टेक्स्ट, उसमें OpenAI वॉटरमार्क नहीं होता। Turnitin Clarity समझाया गया पर हमारी गाइड में बताया गया है कि फिलहाल स्कूल अपने AI-उपयोग नीतियां कैसे निर्धारित कर रहे हैं।
क्या कोई सार्वजनिक OpenAI वॉटरमार्क चेकर है?
अभी टेक्स्ट के लिए OpenAI का कोई सार्वजनिक watermark जांचक उपलब्ध नहीं है। OpenAI का निःशुल्क वेरिफिकेशन टूल इमेज और ऑडियो फाइलों को C2PA Content Credentials और SynthID watermark के लिए जांचता है। OpenAI उन समर्थित इमेज और ऑडियो में SynthID watermark एम्बेड करता है। OpenAI के अनुसार, यह टूल टेक्स्ट को सपोर्ट नहीं करता।
टेक्स्ट के लिए, OpenAI स्वीकृत शोधकर्ताओं और विशेषज्ञ संगठनों को हर मामले की अलग जाँच के बाद डिटेक्टर की सुविधा देता है, जिसके लिए उसके कंटेंट प्रोवेनेंस API फ़ॉर्म से आवेदन करना होता है। उसका कहना है कि छूटे हुए वॉटरमार्क और ग़लत पहचान के जोखिम के कारण वह शुरुआत में टेक्स्ट डिटेक्टर को सार्वजनिक नहीं कर रहा है। डिटेक्टर बताता है कि उसे OpenAI का वॉटरमार्क मिला या नहीं, और वह उपयोगकर्ता की पहचान नहीं बताता और न ही उसके निर्देश दिखाता है।
| आप किस चीज़ की जांच करना चाहते हैं | टूल | इसे कौन उपयोग कर सकता है |
|---|---|---|
| OpenAI की कोई इमेज या ऑडियो फाइल | OpenAI का verification tool | कोई भी, निःशुल्क |
| OpenAI का टेक्स्ट आउटपुट (textGrain) | OpenAI का टेक्स्ट watermark detector | आवेदन के जरिए स्वीकृत शोधकर्ता और विशेषज्ञ संगठन |
| Claude का टेक्स्ट आउटपुट | Claude Watermark Detector | आवेदन के जरिए योग्य संगठन (हमारा Anthropic का Claude वॉटरमार्क, समझाया गया (2026) देखें) |
OpenAI यह भी साफ करता है कि कोई परिणाम आपको क्या नहीं बता सकता। मिला हुआ watermark यह नहीं मापता कि किसी व्यक्ति का योगदान कितना था, और यह यह भी नहीं बताता कि किसने टेक्स्ट लिखा या उसका उपयोग किया। watermark का न मिलना भी यह साबित नहीं करता कि लेखन मानव का है, क्योंकि टेक्स्ट बहुत छोटा हो सकता है, संपादित या अनुवादित हो सकता है, या किसी असमर्थित मॉडल से आया हो सकता है।
Google: पहले लॉन्च किया, फिर रेसिपी भी खोल दी
Google DeepMind ने पहले शिप किया, फिर पूरी तरह प्रकाशित किया, और बाद में तरीका खोल दिया। इसकी प्रणाली, SynthID, 2023 में इमेज watermark के रूप में शुरू हुई और 2024 में टेक्स्ट तक विस्तारित हुई। Nature का पेपर अक्टूबर 2024 में सामने आने तक, SynthID-Text पहले से Gemini में production में चल रहा था, जिससे यह कंज्यूमर स्केल पर तैनात पहला statistical टेक्स्ट watermark बना।
SynthID टेक्स्ट, इमेज, ऑडियो और वीडियो को कवर करता है, और अक्टूबर 2024 से Gemini टेक्स्ट आउटपुट में लाइव है।
फिर Google ने इस कार्यान्वयन को Hugging Face पर ओपन सोर्स के रूप में प्रकाशित किया, जिससे कोई भी डेवलपर अपने स्वयं के मॉडलों पर वही वॉटरमार्किंग योजना लागू कर सके। मई 2025 में उसने SynthID डिटेक्टर की घोषणा की, जो एक सत्यापन पोर्टल है जहां टेक्स्ट, छवियों, ऑडियो, और वीडियो के पूरे कंटेंट को SynthID मार्क्स के लिए जांचा जा सकता है।
एक महत्वपूर्ण scope सीमा यह है: SynthID केवल Google के अपने मॉडल की सामग्री को ही mark करता है और केवल वही detect करता है। यह ChatGPT या Claude के आउटपुट पर कुछ नहीं कहता, और एक साफ SynthID स्कैन यह मतलब नहीं निकालता कि टेक्स्ट मानव द्वारा लिखा गया है। इसका मतलब यह है कि Google के मॉडल ने इसे नहीं लिखा, जो कि एक काफी संकीर्ण दावा है।
Anthropic: सबसे बाद में कदम, सबसे कड़ी नीति
Anthropic ने सबसे बाद में और सबसे व्यापक अनिवार्य कवरेज के साथ तैनाती की। 2 अगस्त 2026 या उसके बाद लॉन्च हुआ हर Claude मॉडल अपने टेक्स्ट आउटपुट में हर योजना पर, दुनिया भर में, एक statistical watermark एम्बेड करता है, और किसी भी opt-out की सुविधा नहीं देता। कंपनी अपने explainer, Claude के टेक्स्ट वॉटरमार्क का काम, में इस मैकेनिज़्म का वर्णन करती है, और help-center लेख, Claude AI द्वारा जनरेट किए गए कंटेंट को कैसे मार्क करता है में policy scope बताती है: Claude API, claude.ai, Claude Code, Claude Cowork, और Claude Tag सभी कवर किए गए हैं। कटऑफ से पहले लॉन्च हुए मॉडल एक ट्रांज़िशन अवधि में हैं, और Anthropic कहता है कि वह उन पर भी marking सपोर्ट जोड़ रहा है। statistical mark के साथ-साथ, Claude द्वारा जनरेट की गई फाइलों में C2PA metadata भी होता है, जो एक अलग, दूसरा सिस्टम है जिसे plain-text कॉपी कर लेने पर हटा दिया जाता है।
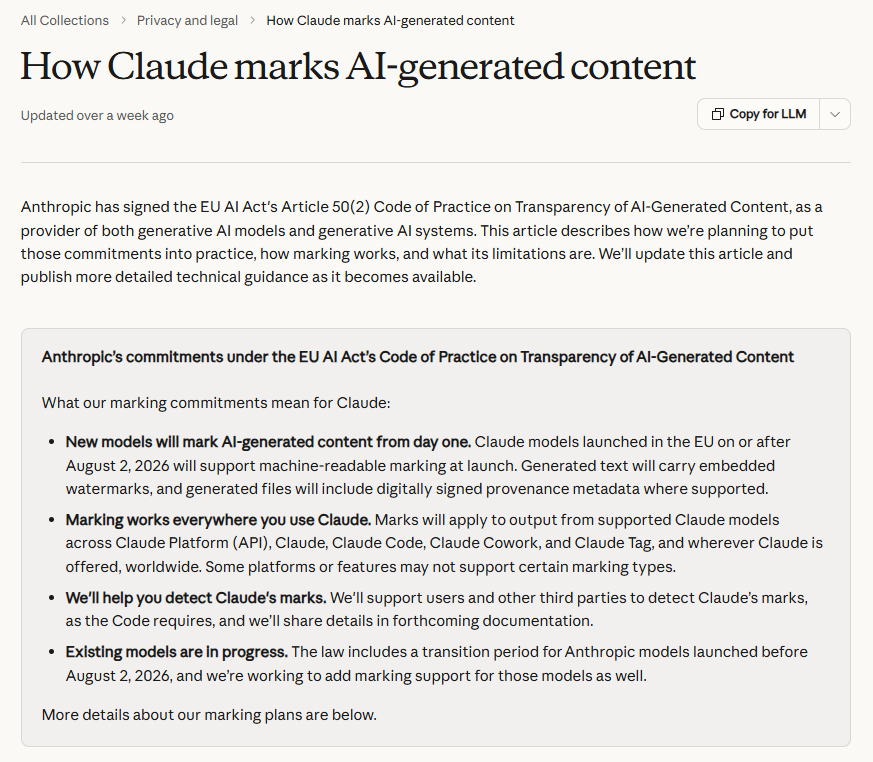
Anthropic के अपने शब्दों में नीति: हर नया मॉडल, हर प्लेटफॉर्म, दुनिया भर में, और पुराने मॉडल धीरे-धीरे जोड़े जा रहे हैं।
Anthropic का दस्तावेज़ीकरण सीमाएं सीधे बताता है। डिटेक्शन संभाव्य (probabilistic) है। यह मार्क किसी दस्तावेज़ को जो Claude ने लिखा है, उससे अलग नहीं कर सकता कि वही दस्तावेज़ किसी मानव ने लिखा है और Claude ने उसे हल्का संपादित किया है। पूरी तरह से फिर से लिखने पर यह मार्क हट जाता है। हमने इसमें सब कुछ समझाया, जिसमें यह भी शामिल है कि सकारात्मक डिटेक्शन वास्तव में क्या साबित करता है और अगर आपकी अपनी लिखाई को मार्क किया जाए तो क्या करें, Claude watermark के लिए समर्पित गाइड में।
समय-निर्धारण नियमन के अनुसार है। Anthropic ने EU AI Act के अंतर्गत Article 50(2) Code of Practice on Transparency of AI-Generated Content पर हस्ताक्षर किए हैं, जो जनरेटिव AI सिस्टम प्रदान करने वालों से यह सुनिश्चित करने को कहता है कि आउटपुट "मशीन-पठनीय प्रारूप में मार्क किए जाएं और कृत्रिम रूप से जनरेट होने के रूप में पहचाने जा सकें।" ये पारदर्शिता संबंधी दायित्व 2 अगस्त 2026 से लागू हो गए: Anthropic की मॉडल नीति में यही सटीक कटऑफ तारीख है, सार्वजनिक घोषणा से ठीक नौ दिन पहले। Anthropic ने EU ट्रैफिक के लिए अलग व्यवहार बनाए रखने के बजाय वैश्विक स्तर पर अनुपालन चुन लिया। Google पहले से ही डिजाइन के हिसाब से अनुपालक था। OpenAI का बिना मार्क किया हुआ टेक्स्ट आउटपुट 2027 के लिए खुला अनुपालन प्रश्न है।
तीन दृष्टिकोण, एक साथ तुलना में
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| क्या टेक्स्ट वॉटरमार्क तैनात है? | हाँ (textGrain, 5 अक्टूबर 2026 से EU रोलआउट) | हाँ (Gemini, अक्टूबर 2024 से) | हाँ (Claude मॉडल, 2 अगस्त 2026 से) |
| तकनीक | textGrain, शब्द-चयन में एक सांख्यिकीय संकेत | SynthID-Text tournament sampling | सांख्यिकीय सैंपलिंग मार्क, SynthID शैली |
| कवरेज | EU में eligible ChatGPT और Codex टेक्स्ट; API के लिए दुनिया भर में ऑप्ट-इन | केवल Google मॉडल | सभी नए Claude मॉडल; पुराने मॉडल संक्रमण में |
| ऑप्ट-आउट | API में डिफॉल्ट रूप से बंद | नहीं | नहीं |
| पब्लिक डिटेक्टर | नहीं | SynthID Detector पोर्टल (2025) | योजना बनाई गई है, अभी तक जारी नहीं |
| क्या स्कीम प्रकाशित हुई? | केवल कॉन्सेप्ट लेक्चर | Nature पेपर + ओपन सोर्स | व्याख्या, प्रकाशित कार्य पर आधारित |
| फ़ाइल मेटाडेटा (C2PA) | हाँ, चित्र और ऑडियो | हाँ, अलग-अलग माध्यमों में | हाँ, जनरेटेड फ़ाइलों पर |
| घोषित सीमाएँ | चोरी-छिपे बच निकलना, ESL का कलंक | दायरा अपने ही मॉडलों तक सीमित | संभाव्य प्रकृति, संपादनों से लेखन श्रेय धुंधला |
स्तंभों में पैटर्न यह है: OpenAI टेक्स्ट वॉटरमार्किंग को एक अनसुलझा नीति-समस्या मानता है, Google इसे मानकीकरण के लिए अवसंरचना मानता है, और Anthropic इसे पूरी तरह लागू करने योग्य अनुपालन दायित्व मानता है।
शोधकर्ताओं और अकादमिक लेखकों के लिए इसका क्या अर्थ है
व्यावहारिक परिणाम इस बात पर निर्भर करते हैं कि कौन-से उपकरण आपके टेक्स्ट को छूते हैं। यदि आप ChatGPT से ड्राफ्ट करते हैं, तो आज आपके टेक्स्ट में कोई वॉटरमार्क नहीं है। यदि आप Gemini से ड्राफ्ट करते हैं, तो उसमें SynthID का निशान होता है जिसे केवल Google का डिटेक्टर ही पढ़ सकता है। यदि आप किसी वर्तमान Claude मॉडल से ड्राफ्ट या संपादन करते हैं, तो उसमें Anthropic का निशान होता है, और इसे बंद करने के लिए कोई सेटिंग नहीं है।
तीन बातें जो अकादमिक लेखकों को जाननी चाहिए:
वॉटरमार्क किसी टूल की पहचान करता है, किसी लेखक की नहीं। हर विक्रेता इसे अपने दस्तावेज़ों में अलग से बताता है, और इसे फिर से दोहराना उपयोगी है क्योंकि संस्थागत नीतियाँ हमेशा इस फर्क को स्पष्ट नहीं करतीं। टेक्स्ट पर निशान इस वजह से लगाया जा सकता है कि उसे किसी AI ने ड्राफ्ट किया, किसी AI ने उसमें दो वाक्यों का कॉपी-एडिट किया, या किसी निशान वाले पैराग्राफ का उद्धरण दिया गया। यदि आपका संस्थान वॉटरमार्क जांच चलाता है, तो जांच यह साबित करती है कि एक विशिष्ट मॉडल ने किसी न किसी बिंदु पर टेक्स्ट को छुआ, इससे अधिक कुछ नहीं। हमारे गाइड गलत AI डिटेक्शन फ़्लैग को अपील करने में बताया गया है कि कब इसकी ज़रूरत हो तो इस तर्क को कैसे रखा जाए।
वॉटरमार्क और AI डिटेक्टर अलग-अलग तकनीकें हैं, और इनके विफल होने के तरीके भी अलग हैं। Turnitin या GPTZero जैसे डिटेक्टर सांख्यिकीय शैली से अनुमान लगाते हैं, जिनकी हमने दस्तावेज़ किए गए सटीकता संबंधी समस्याएँ हैं। वॉटरमार्क डिटेक्शन एक की-आधारित परीक्षण है, जिसमें बिना-निशान वाले मानव टेक्स्ट पर बहुत कम फॉल्स-पॉज़िटिव दर होती है। फॉल्स-नेगेटिव के लिए यह असमिति पलट जाती है: कोई वॉटरमार्क जांच किसी ऐसे AI टेक्स्ट को चूक सकती है जो किसी गैर-वॉटरमार्किंग मॉडल से आया हो, और आज इसमें सभी ChatGPT टेक्स्ट शामिल हैं।
जाहिर करना आपका सबसे मजबूत पक्ष बना रहता है। वॉटरमार्किंग से मौन (silent) AI उपयोग का जोखिम बढ़ जाता है और घोषित (disclosed) AI उपयोग सुरक्षित हो जाता है, क्योंकि घोषित वर्कफ़्लो को सकारात्मक निशान से डरने की ज़रूरत नहीं होती। अब अधिकांश जर्नल और विश्वविद्यालयों के पास AI-उपयोग की स्पष्ट नीतियाँ हैं; हमारा AI उपयोग नीति बताता है कि हम अपने ही टूल्स में उन सीमाओं को कैसे तय करते हैं, और यह पारदर्शी उपयोग के लिए एक उचित नमूना है।
कौन-सी चीज़ें टेक्स्ट वॉटरमार्क हटाती हैं, और कौन-सी नहीं
पुनर्लेखन इसे हटाता है; रिफॉर्मैटिंग नहीं। कॉपी करना, पेस्ट करना, फ़ॉन्ट बदलना, फ़ाइल फ़ॉर्मैट के बीच रूपांतरण करना, और अदृश्य अक्षर हटाना सब सांख्यिकीय वॉटरमार्क को पूरी तरह अक्षुण्ण रखते हैं, क्योंकि यह निशान शब्द-चयन में होता है। इसे हटाने वाली चीज़ वह है जो शब्दावली को फिर से जनरेट करे: गहन मानव संपादन, अनुवाद, या वास्तविक परा-लेखन (paraphrase), जैसा कि NeurIPS 2023 की robustness पर की गई रिसर्च ने इन सिस्टमों के शिप होने से पहले दिखाया।
यहाँ दोनों दिशाएँ मायने रखती हैं। चिह्न का गायब हो जाना यह नहीं बनाता कि पाठ आपका है, और चिह्न का बना रहना यह नहीं बनाता कि पाठ आपका नहीं है। पुनर्लिखित AI मसौदा फिर भी एक AI-सहायता प्राप्त दस्तावेज है, जिस पर आपकी संस्था के खुलासा नियम लागू होते हैं। हमारा AI text humanizer AI-सहायता प्राप्त मसौदों को प्राकृतिक शैक्षणिक शैली में फिर से लिखता है, और क्योंकि यह प्रक्रिया टोकन क्रम (token sequence) को पुनर्जीवित करती है, इसलिए सांख्यिकीय चिह्न उस पर टिकते नहीं। खास तौर पर Claude टेक्स्ट के लिए, claude वॉटरमार्क रिमूवर तथ्यों, संख्याओं और उद्धरणों को अपरिवर्तित रखते हुए हर वाक्य को नई ताज़ा शब्दावली में फिर से व्यक्त करता है। कोई भी उपकरण आपके पाठक के प्रति आपकी ज़िम्मेदारी में बदलाव नहीं कर सकता: यह कि दस्तावेज़ कैसे बनाया गया, इसके बारे में पारदर्शिता
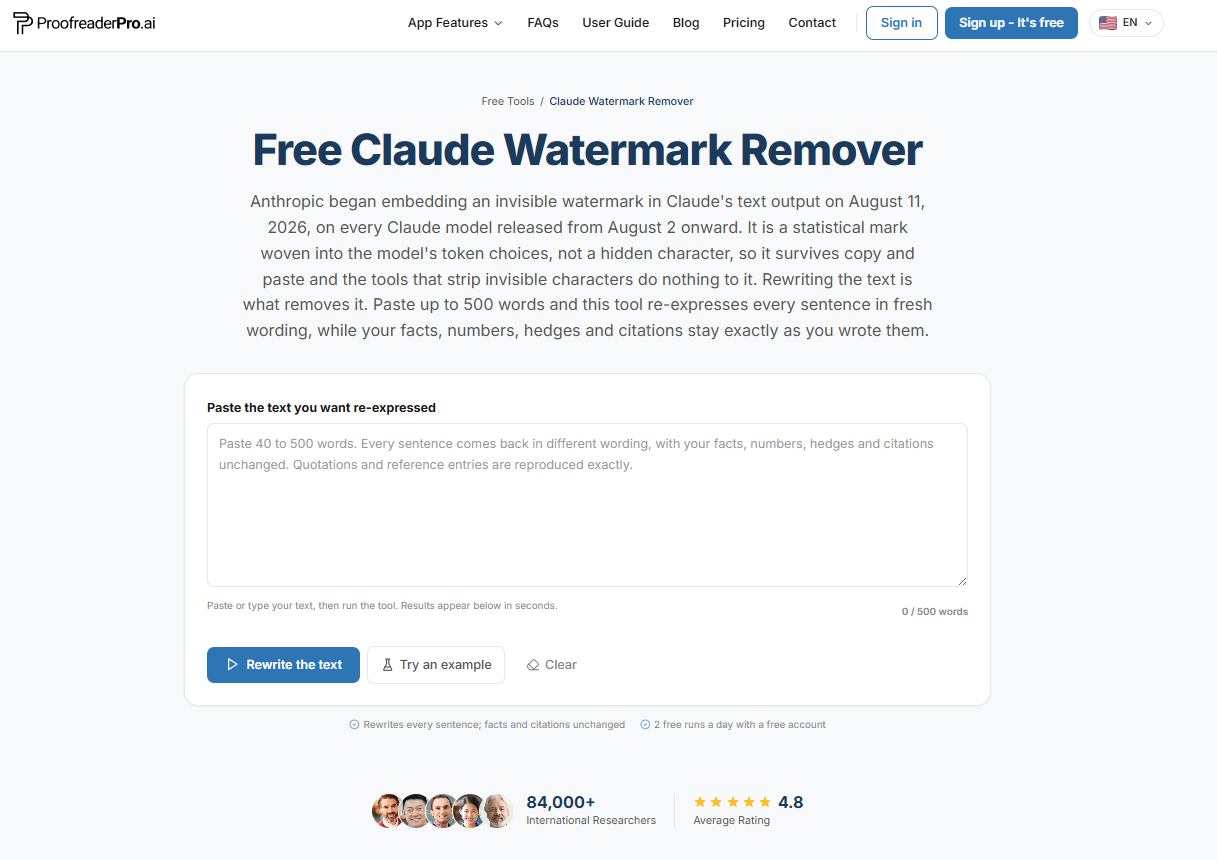
पुनर्लेखन वह एकमात्र प्रक्रिया है जो सांख्यिकीय चिह्न को हटाती है, और यही काम यह उपकरण करता है, वाक्य दर वाक्य।
यह आगे कहाँ जाता है
2027 तक तीन चीज़ें परखते रहें। पहला, क्या OpenAI textGrain को EU से आगे ले जाता है: यह वहीं से शुरू हुआ क्योंकि EU में Article 50 लागू होने के लिए AI टेक्स्ट पर मशीन-पढ़ने योग्य चिह्न आवश्यक हैं। दूसरा, क्या डिटेक्टर एक-दूसरे से मेल खाने लगते हैं। अगर हर प्रमुख लैब प्रकाशित योजना के साथ वॉटरमार्क लगाती है, तो विश्वविद्यालय अनुमान के बजाय कुंजी जाँचकर सत्यापित कर सकते हैं, जिससे आज की 2026 में AI डिटेक्टर कितने सटीक हैं? परीक्षण की गई सटीकता और false positives में सुधार हो सकता है। तीसरा, क्या चिह्न संगत बनते हैं। आज तीन लैब तीन अलग-अलग चिह्न इस्तेमाल करती हैं, और ऐसा कोई एकल चेक उन सबको कवर नहीं करता। फाइलों के लिए C2PA इस अंतर को भरता है; कच्चे टेक्स्ट के लिए अभी तक कुछ भी यह काम नहीं कर रहा है।
क्या ChatGPT अपने टेक्स्ट पर वॉटरमार्क लगाता है?
हाँ, कुछ हद तक, 5 अक्तूबर 2026 से। OpenAI ने यूरोपीय संघ में योग्य ChatGPT और Codex टेक्स्ट में अपना textGrain वॉटरमार्क जोड़ना शुरू किया, और API ग्राहक दुनिया में कहीं से भी इसे चालू कर सकते हैं। यह वॉटरमार्क शब्द-चयन में एक सांख्यिकीय संकेत है, जिसमें कोई छिपे हुए अक्षर नहीं होते। OpenAI DALL-E और Sora मीडिया फाइलों पर अलग तरह की, फाइल-स्तरीय प्रणाली के रूप में C2PA provenance metadata भी लागू करता है।
क्या Google Gemini अपने टेक्स्ट पर वॉटरमार्क लगाता है?
हाँ। Gemini आउटपुट में 2024 अक्तूबर से Google DeepMind का SynthID-Text वॉटरमार्क लगा हुआ है। यह शब्द-चयन में एक सांख्यिकीय चिह्न है, जो पाठकों को दिखाई नहीं देता, और Google के SynthID Detector के जरिए जाँच योग्य है। यह केवल Google के अपने मॉडलों पर लागू होता है, इसलिए SynthID का नकारात्मक परिणाम अन्य AI सिस्टम के टेक्स्ट के बारे में कुछ नहीं कहता।
क्या Claude अपने टेक्स्ट पर वॉटरमार्क लगाता है?
हाँ। 2 अक्तूबर 2026 को या उसके बाद लॉन्च हुए हर Claude मॉडल के टेक्स्ट आउटपुट में एक सांख्यिकीय वॉटरमार्क अंतर्निहित होता है, हर प्लेटफॉर्म और प्लान पर, बिना किसी opt-out के, और Claude-generated फाइलों में अतिरिक्त रूप से C2PA metadata भी रहता है। उस तारीख से पहले लॉन्च किए गए मॉडल अभी तक अपने आउटपुट पर चिह्न नहीं लगाते; Anthropic का कहना है कि वे एक संक्रमण अवधि के दौरान उनमें marking support जोड़ रहे हैं। पूरी जानकारी हमारे Claude watermark explainer में है।
क्या विश्वविद्यालय AI वॉटरमार्क पहचान सकते हैं?
केवल विक्रेता के सहयोग से, क्योंकि पहचान के लिए विक्रेता की key चाहिए होती है। Google SynthID सामग्री के लिए एक सार्वजनिक detector portal उपलब्ध कराता है। Anthropic का कहना है कि उपयोगकर्ताओं और तृतीय पक्षों के लिए detection समर्थन योजनाबद्ध है, लेकिन अभी तक उन्होंने कोई सार्वजनिक detector जारी नहीं किया है। कोई भी प्रमुख plagiarism suite वर्तमान में किसी भी लैब के सांख्यिकीय वॉटरमार्क की पुष्टि नहीं कर सकती, इसलिए संस्थागत "AI detection" आज भी व्यावहारिक रूप से लेखन-शैली पर आधारित अनुमान ही है, न कि वॉटरमार्क सत्यापन।
क्या AI वॉटरमार्किंग कानून द्वारा आवश्यक है?
EU में, हां, प्रभावी रूप से. यूरोपीय संघ के AI Act के अनुच्छेद 50(2) के अनुसार जनरेटिव AI प्रदाताओं को यह सुनिश्चित करना होगा कि आउटपुट को मशीन-पठनीय प्रारूप में चिह्नित किया जाए और कृत्रिम रूप से जनरेट किए गए के रूप में पहचाना जा सके, तथा पारदर्शिता की बाध्यताएं 2 अगस्त 2026 से लागू होंगी. Anthropic ने संबंधित Code of Practice पर हस्ताक्षर किए और पूरे विश्व में अनुपालन चुन लिया. 2027 में OpenAI के अप्रकाशित टेक्स्ट वॉटरमार्क को नियामक कैसे व्यवहार करेंगे, यही देखने वाली बात है.
क्या AI वॉटरमार्क अनुवाद के बाद भी टिकते हैं?
नहीं. सांख्यिकीय वॉटरमार्क उस शब्दों की सटीक अनुक्रम में रहता है जो मॉडल ने चुने, और अनुवाद हर शब्द को बदल देता है. यही बात डीप पैराफ्रेज़िंग और भारी मानव संपादन पर भी लागू होती है. यह सीमा पीयर-रिव्यूड साहित्य में दर्ज है और वॉटरमार्क शिप करने वाले हर विक्रेता द्वारा स्वीकार की गई है.
क्या टेक्स्ट के लिए कोई सार्वजनिक OpenAI वॉटरमार्क चेकर है?
नहीं. OpenAI का सार्वजनिक सत्यापन टूल केवल इमेज और ऑडियो फाइलों की जांच करता है, C2PA मेटाडाटा और SynthID वॉटरमार्क के लिए. OpenAI कहता है कि वह टेक्स्ट को सपोर्ट नहीं करता. इसका टेक्स्ट वॉटरमार्क डिटेक्टर केवल अनुमोदित शोधकर्ताओं और विशेषज्ञ संगठनों के लिए, केस-बाय-केस आधार पर उपलब्ध है.
textGrain क्या है?
textGrain OpenAI का टेक्स्ट वॉटरमार्क है, जिसकी घोषणा 5 अक्टूबर 2026 को की गई. यह मॉडल की शब्द-चयन संबंधी प्रक्रिया में एक अदृश्य सांख्यिकीय संकेत जोड़ता है, इसलिए यह चिह्न शब्दों का हिस्सा बनता है, न कि कोई छिपा हुआ कैरेक्टर या फाइल मेटाडाटा. OpenAI कहता है कि उसने जिन अन्य तरीकों का परीक्षण किया, उनमें वह मेल खाता है या उन्हें पछाड़ देता है, जिसमें टेक्स्ट के लिए SynthID भी शामिल है, और कि संपादन इसे कमजोर करता है.
क्या शोधकर्ता OpenAI के टेक्स्ट वॉटरमार्क डिटेक्टर तक पहुंच के लिए आवेदन कर सकते हैं?
हां. अनुमोदित शोधकर्ता और विशेषज्ञ संगठन OpenAI के Content Provenance API फॉर्म के जरिए आवेदन कर सकते हैं. EU Code of Practice के तहत OpenAI केस-बाय-केस आधार पर पहुंच देता है. उसका कहना है कि जैसे-जैसे तकनीक और साक्ष्य विकसित होंगे, वह व्यापक पहुंच पर दोबारा विचार करेगा.
स्रोत
- Anthropic, Claude का टेक्स्ट वॉटरमार्क कैसे काम करता है, अगस्त 2026
- Anthropic Help Center, Claude कैसे AI-जनरेटेड कंटेंट को चिह्नित करता है, 2026
- OpenAI, ऑनलाइन हम जो देखते और सुनते हैं, उसके स्रोत को समझना, मई 2024
- Google DeepMind, SynthID
- Dathathri et al., बड़े भाषा मॉडल के आउटपुट की पहचान के लिए स्केलेबल वॉटरमार्किंग, Nature, अक्टूबर 2024
- Google, SynthID डिटेक्टर की घोषणा, मई 2025
- Hugging Face, SynthID Text का परिचय, अक्टूबर 2024
- Kirchenbauer et al., बड़े भाषा मॉडल्स के लिए एक वॉटरमार्क, ICML 2023
- Krishna et al., पैराफ्रेज़िंग AI-जनरेटेड टेक्स्ट के डिटेक्टरों को चकमा देती है, NeurIPS 2023
- Scott Aaronson, UT Effective Altruism के लिए मेरा AI Safety लेक्चर, नवंबर 2022
- यूरोपीय संघ, AI Act, अनुच्छेद 50
- C2PA, Content Provenance and Authenticity के लिए Coalition
डाना ProofreaderPro में एक सामग्री निर्माता है, जहां वह दैनिक ब्लॉग और लेखन कार्य चलाती है। वह इस पर लेख लिखती है कि ऑनलाइन संपादन प्लेटफ़ॉर्म कैसे काम करता है, और वह हर दिन ग्राहक संदेशों को संभालती है, जिसमें पांच सितारा संतुष्टि स्कोर दिखाया जाता है।