
ইংরেজিতে লিখছেন এমন ইন্দোনেশীয় গবেষকদের জন্য AI হিউম্যানাইজার
ইন্দোনেশীয় গবেষকদের জন্য AI হিউম্যানাইজার। ইন্দোনেশীয়-প্রভাবযুক্ত ইংরেজিতে ভুলভাবে AI-ডিটেকশন ফ্ল্যাগ পড়ার ঘটনা কমান, অর্থ ও উদ্ধৃতি (citation) অক্ষুণ্ণ রাখুন, এবং সৎভাবে ব্যবহারের কথা জানান।

ইন্দোনেশিয়া এখন ASEAN অঞ্চলে গবেষণা উৎপাদনের প্রধান শক্তি। কেবল ২০২০ সালেই দেশটির বিশ্ববিদ্যালয়গুলো ৫০,৮৬৮টি Scopus-সূচিবদ্ধ প্রবন্ধ প্রকাশ করেছে, ২০১৫ সালের তুলনায় এটি ৫৮৪% বৃদ্ধি। আর দেশের ৩০৩,০৬৭ জন লেকচারারকে সর্বদা চাপ নিতে হয় যেন তারা ইংরেজি ভাষার আন্তর্জাতিক জার্নালে নিজেদের উপস্থিতি নিশ্চিত করতে পারেন। অনেকেই এখন ভাষাগত ব্যবধান কমাতে ChatGPT, Claude বা Gemini দিয়ে খসড়া তৈরি করেন, তারপর নতুন সমস্যার মুখোমুখি হন: AI ডিটেক্টর তাদের যত্নে লেখা, মানবসৃষ্ট ইংরেজিকেও মেশিন-লেখা হিসেবে চিহ্নিত করে। এই নির্দিষ্ট পরিস্থিতির জন্যই ইন্দোনেশীয় গবেষকদের উপযোগী একটি AI হিউম্যানাইজার আছে, এবং এই গাইডটি দেখায় কীভাবে তা দায়িত্বশীলভাবে ব্যবহার করবেন।
EF English Proficiency Index–এ ইন্দোনেশিয়ার স্কোর ৪৭১, বিশ্বব্যাপী ৮০তম স্থানে, এবং এটি "Low Proficiency" ক্যাটাগরির অধীনে। কিন্তু এই সংখ্যাটি ইন্দোনেশীয় বিজ্ঞানের মান সম্পর্কে কিছু বলে না। এটি Bahasa Indonesia এবং ইংরেজির মধ্যকার কাঠামোগত দূরত্বকে প্রতিফলিত করে: কাল (tense) ব্যবস্থার অনুপস্থিতি, আর্টিকেলের (articles) অনুপস্থিতি, বহুবচন-সংক্রান্ত (plural inflection) রূপ বদলের অনুপস্থিতি, এবং বাধ্যতামূলক copula-এর অনুপস্থিতি। যখন ইন্দোনেশীয় গবেষকেরা একাডেমিক ইংরেজিতে লেখেন, তারা সতর্কভাবে এবং পূর্বানুমানযোগ্যভাবে লেখেন, আর সেই সতর্কতাই একটি perplexity-ভিত্তিক ডিটেক্টরের কাছে কৃত্রিম (artificial) মনে হতে পারে।
এখন আসি অযাচিত অংশটিতে। আপনার ইংরেজিটা UGM Yogyakarta বা ITB Bandung-এর একজন রিভিউয়ারের কাছে পরিষ্কার শোনাতে যে অভ্যাসগুলো কাজ করে, সেই একই অভ্যাসই একটি ডিটেক্টরকে প্রশিক্ষিত করা হয়েছে "AI" হিসেবে স্কোর করতে। একটি হিউম্যানাইজার আপনার কাজ লুকায় না। এটি সেই স্বাভাবিক ভ্যারিয়েশন ফিরিয়ে আনে, যা সতর্ক দ্বিতীয়-ভাষার লেখালেখি স্বাভাবিকভাবেই অনেক সময় সমান-সমান করে ফেলে। ফলে প্রকৃত খসড়া কেবল বাক্যের ছন্দ (sentence rhythm) নয়, মূল ধারণাগুলোর ভিত্তিতে বিচার পায়।
Humanizer AI untuk peneliti Indonesia yang menerbitkan dalam bahasa Inggris
আমাদের AI হিউম্যানাইজার পরিষেবাটি ইন্দোনেশীয় গবেষকদের তাদের কাজ ইংরেজিতে প্রকাশ করতে সহায়তা করে, যাতে তা AI ডিটেক্টর ভুলভাবে চিহ্নিত না করে। সরলভাবে বললে: আমাদের হিউম্যানাইজার আপনার নিজের AI-সহায়ক খসড়ায় কাজ করে, আপনার অর্থ, আপনার টেকনিক্যাল শব্দভান্ডার, এবং প্রতিটি উদ্ধৃতি (citation) একই জায়গায় রেখে দেয়; এরপর এমনভাবে ছন্দ ও শব্দচয়েস পরিবর্তন করে, যেটার দিকে ডিটেক্টরগুলো বিশেষভাবে নজর দেয়। লক্ষ্য, ছদ্মবেশ নয়; বরং প্রকৃত ইন্দোনেশীয় গবেষণার জন্য ন্যায্যতা নিশ্চিত করা।
যেসব গবেষক Bahasa Indonesia-তে চিন্তা ও খসড়া বেশি সাবলীলভাবে তৈরি করেন, তাদের জন্য পথটিও একই। আগে আপনার ধারণাগুলো লিখুন, প্রয়োজনে সেটি অনুবাদ করুন, ব্যাকরণ প্রুফরিড করুন, তারপর আমাদের টেক্সট হিউম্যানাইজার ব্যবহার করে আপনার নিজের গদ্যকে হিউম্যানাইজ করুন। এরপর আপনার AI ব্যবহারের বিষয়টি আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যেভাবে চায় সেভাবে সৎভাবে প্রকাশ করুন।
ইন্দোনেশীয় ভাষায় লিখছেন? এটিও স্বয়ংক্রিয়ভাবে শনাক্ত হয় এবং মানবিক করা হয়
ইন্দোনেশীয় গবেষকেরা প্রায়ই ইংরেজিতে যাওয়ার আগে Bahasa Indonesia-তে খসড়া তৈরি করেন, এবং সেই কারণেই হিউম্যানাইজারটি এই চর্চার জন্য নির্মিত। ইন্দোনেশীয় টেক্সট পেস্ট করুন, ProofreaderPro নিজেই ভাষাটি শনাক্ত করে, তারপর এমন একটি ভাষাজ্ঞান-সমৃদ্ধ মডেলের মাধ্যমে প্রক্রিয়াজাত করে যা আপনার পরিভাষা ও উদ্ধৃতিগুলো (citations) হুবহু একই জায়গায় রাখে। একটি humanizer AI হিসেবে এটি আপনার ইন্দোনেশীয় খসড়ায় ঠিক ততটাই কাজ করে যতটা ইংরেজি খসড়াতেও করে, ফলে আপনি অনুবাদের আগেই হিউম্যানাইজ করতে পারেন। একই শনাক্তকরণ প্রক্রিয়া ষাটেরও বেশি ভাষায় প্রযোজ্য, এবং প্রতিটি ভাষাকে তার নিজস্ব ভঙ্গিতে (voice) পুনর্লিখন করা হয়।
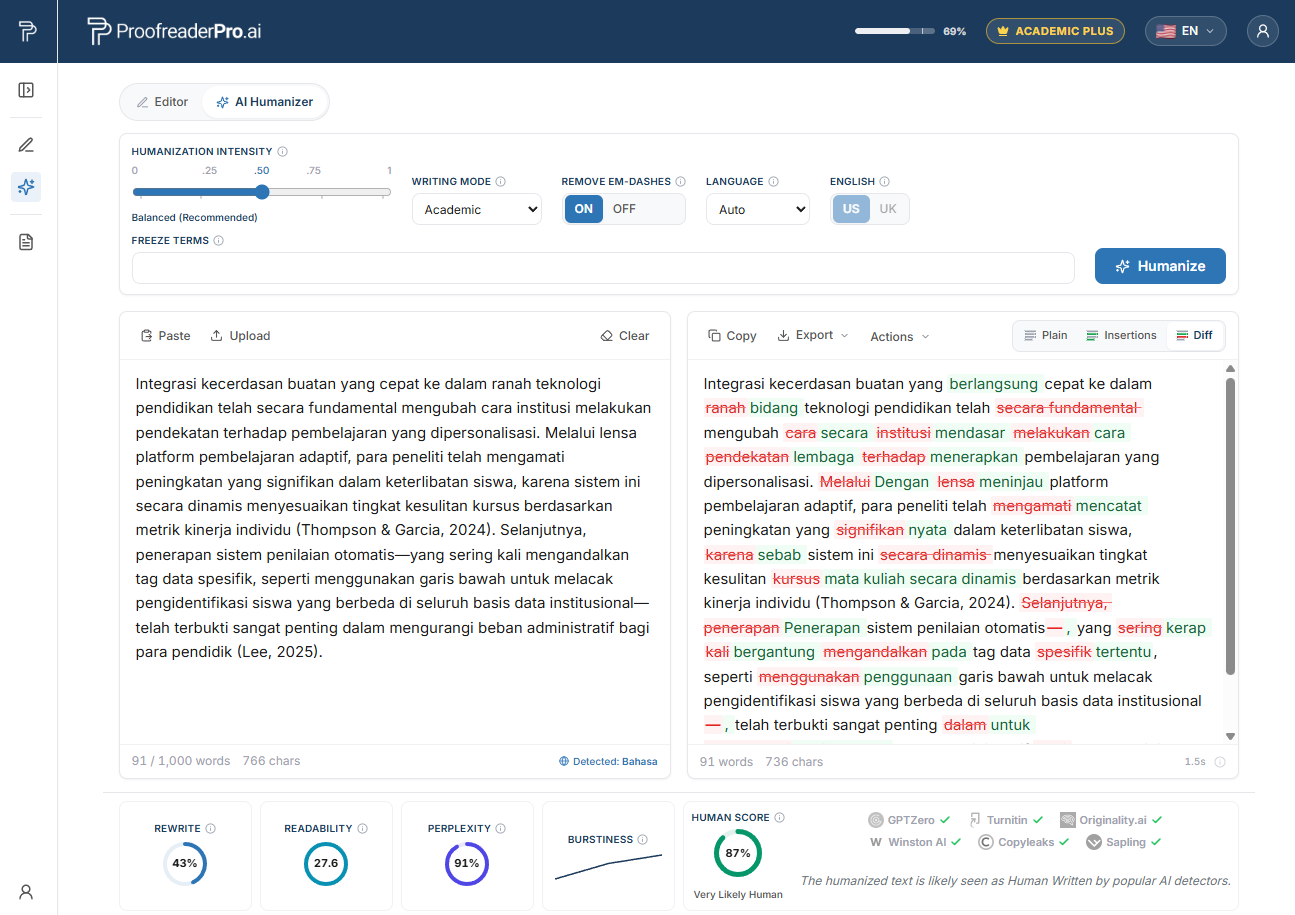
ProofreaderPro AI Humanizer যে ইন্দোনেশীয় একাডেমিক টেক্সটকে পুনর্লিখন করে। before এবং after diff অর্থ ও citations অক্ষুণ্ণ রাখে, আর detector checks নিশ্চিত করে যে পাঠটি স্বাভাবিকভাবে মানব-লেখা মতো পড়ে।
কেন ইন্দোনেশীয় গবেষকেরা AI ডিটেক্টরে ফ্ল্যাগ পড়েন
২০২৩ সালে Stanford-এর একটি দল, Weixin Liang-এর নেতৃত্বে, Cell Press জার্নাল Patterns-এ "GPT detectors are biased against non-native English writers" প্রবন্ধটি প্রকাশ করে। গবেষকেরা মানব-লিখিত TOEFL প্রবন্ধে (সবগুলোই বাস্তব মানুষের লেখা) সাতটি জনপ্রিয় AI ডিটেক্টর পরীক্ষা করে দেখেন। গড় হিসেবে প্রায় ৬১% অ-নেটিভ প্রবন্ধ AI-জনিত হিসেবে শনাক্ত হয়েছিল, যেখানে নেটিভ ইংরেজি লেখকদের ক্ষেত্রে তা প্রায় ৫%। প্রায় পাঁচটির মধ্যে একটির মতো (প্রায় ১৯.৮%) অ-নেটিভ প্রবন্ধ, সব ডিটেক্টর দ্বারা একযোগে (unanimously) ফ্ল্যাগ হয়।
মেকানিজমটি হচ্ছে perplexity। অনেক ডিটেক্টর স্কোর করে, ভাষা মডেলের কাছে শব্দচয়েস কতটা "আশ্চর্য/অপ্রত্যাশিত"। স্ট্যান্ডার্ড ও পূর্বানুমানযোগ্য ক্রমে থাকা সাধারণ শব্দ কম perplexity তৈরি করে, এবং কম perplexity মেশিন-টেক্সট হিসেবে ধরা পড়ে। ইন্দোনেশীয় গবেষকেরা, যেহেতু ইংরেজি দ্বিতীয় ভাষা, ঠিক সেই নিরাপদ, সাধারণ, পাঠ্যবই-ধাঁচের নির্মাণগুলোর দিকে ঝোঁকে, ফলে তাদের সবচেয়ে যত্নশীল বাক্যগুলোই বেশি পরিমাণে এমন স্কোর দেয় যা মেশিন-লেখার মতো। আমরা এই ফাঁদটি বিস্তারিতভাবে ব্যাখ্যা করেছি why AI detectors flag non-native writers প্রবন্ধে।
মিথ্যা ফ্ল্যাগের পেছনে ইন্দোনেশীয় প্রথম-ভাষার ধরণ
Bahasa Indonesia একটি অস্ট্রোনেশীয় ভাষা, যেখানে isolating morphology আছে। এটি inflection-এর মাধ্যমে নয়, বরং word order ও context-এর মাধ্যমে অর্থ বহন করে। এর কিছু বৈশিষ্ট্য একাডেমিক ইংরেজিতে একটি পূর্বানুমানযোগ্য, মানক ধরনের চিহ্ন রেখে যায়। নিচের প্রতিটি প্যাটার্নই সঠিক এবং যত্নশীল। সমস্যা হলো, এর সেই উচ্চমাত্রার নিয়মিততা একটি ডিটেক্টরের কাছে low-perplexity হিসেবে ধরা পড়ে।
No tense system. Bahasa Indonesia sudah, sedang, এবং akan-এর মতো adverb দিয়ে সময় বোঝায়, এবং ক্রিয়া (verb) কখনো রূপ বদলায় না। ইংরেজি লেখার সময় ইন্দোনেশীয় গবেষকেরা সাধারণত প্রতিটি সেকশনের জন্য একটি পরিষ্কার, সামঞ্জস্যপূর্ণ tense বেছে নেন, প্রায়ই methods প্যারাগ্রাফে flat simple present। এই সমতা (evenness) ডিটেক্টরগুলো যে generated text-এর সঙ্গে যুক্ত করে সেই মসৃণ, কম-ভ্যারিয়েশন সংকেতেরই মতো।
No articles. Bahasa Indonesia-তে "the," "a," বা "an" নেই। যত্নশীল লেখকেরা নিয়মগুলো শেখে এবং সেগুলো অভিন্নভাবে প্রয়োগ করে। ফলে একটি পূর্ণ পান্ডুলিপিতে uniform rule-book অনুযায়ী article ব্যবহারের উপস্থিতি মানব-ভ্যারিয়েশনের বদলে মেশিন-সঙ্গত (machine-consistent) আচরণ বলে মনে হয়।
Preposition mapping. একটি ইন্দোনেশীয় preposition একাধিক ইংরেজি prepositionকে কভার করে: "di" in, at, এবং on, সবটির মধ্যে পড়ে, আর "dengan" with এবং by, দুটোর সঙ্গেই মিলে যায়। নিরাপদ থাকতে দ্বিতীয় ভাষার লেখকেরা সাধারণত সবচেয়ে স্ট্যান্ডার্ড ইংরেজি preposition-এ স্থির হয়ে সেটি বারবার ব্যবহার করেন। প্রত্যাশিত পছন্দ পুনরাবৃত্তি করলে perplexity আরও কমে যায়।
No verb conjugation. ইন্দোনেশীয় ক্রিয়াগুলো ব্যক্তি (person) বা সংখ্যা (number)-এর জন্য রূপ বদলায় না। তাই লেখকেরা ইংরেজি subject-verb agreement-কে মুখস্থ করা নিয়ম হিসেবে প্রয়োগ করেন এবং সেটি কঠোরভাবে বজায় রাখেন। এই কঠোর, নিয়মিত agreement, আরেকটি মার্কার, যেটা পূর্বানুমানযোগ্য গদ্যকে চিহ্নিত করতে ডিটেক্টরগুলো প্রশিক্ষণ পেয়েছিল।
Optional plural marking. ইন্দোনেশীয় বহুবচন দেখায় reduplication (buku-buku) কিংবা context-এর মাধ্যমে। ইংরেজিতে যত্নশীল লেখকেরা প্রতিটি "-s" যান্ত্রিকভাবে যোগ করেন, ফলে ঝরঝরে, পাঠ্যবই-ধাঁচের noun phrase তৈরি হয়, যা মসৃণ এবং অপ্রত্যাশিতহীন (unsurprising) হিসেবে পড়ে।
No required copula. "Dia guru" মানে "she is a teacher", এখানে linking verb নেই। এর ক্ষতিপূরণ দিতে ইন্দোনেশীয় লেখকেরা copula সবচেয়ে স্ট্যান্ডার্ড জায়গাগুলোতে বসিয়ে দেন; ফলে আরেকবার এমন পরিষ্কার, প্রত্যাশিত বাক্যরূপ তৈরি হয়, যেগুলো ডিটেক্টর কৃত্রিম হিসেবে স্কোর করে।
প্যাটার্নটি লক্ষ করুন। এগুলো কোনো চিন্তার ভুল (errors of thinking) নয়। এগুলো একটি দ্বিতীয় ভাষায় একদম নির্ভুলভাবে লিখতে গিয়ে কারো করা শৃঙ্খলাবদ্ধ, মানক (disciplined, standard) পছন্দ, এবং সেই standardness-ই ঠিক সেই বিষয়, যেটাকে perplexity মডেল শাস্তি দেয়।
আপনার নিজস্ব AI-সহায়তাপ্রাপ্ত ইন্দোনেশীয় গবেষণা খসড়াকে Humanize করুন
আপনার অর্থ, প্রযুক্তিগত পরিভাষা, এবং উদ্ধৃতি বজায় রাখুন। সাবধানী দ্বিতীয় ভাষার ইংরেজিতে প্রাকৃতিক ছন্দ ফিরিয়ে আনুন, তারপর আপনার জার্নাল যেভাবে চায় সেভাবে আপনার AI ব্যবহারটি প্রকাশ করুন।
Humanizer ফ্রি করে দেখুনইন্দোনেশিয়ার AI-ডিটেকশন ও Turnitin প্রসঙ্গ
ইন্দোনেশিয়ায় থিসিস ও জার্নাল সাবমিশনগুলো সাধারণত Turnitin বা iThenticate দিয়ে স্ক্রিন করা হয়, সাদৃশ্য (similarity) এবং ক্রমেই বাড়তে থাকা AI সূচক (AI indicators) দেখার জন্য। বেশিরভাগ ইন্দোনেশীয় বিশ্ববিদ্যালয় এই যাচাইগুলোকে একটি রুটিন গেট হিসেবে চালায়, প্রতিরক্ষা (defence) বা সাবমিশনের আগে; এবং অনুদানদাতা সংস্থা ও আন্তর্জাতিক জার্নালগুলোও ক্রমেই লেখকদের AI সহায়তা থাকলে তা প্রকাশ (disclose) করতে বলে।
এই AI স্কোরগুলো কতটা বিতর্কিত, তা জানা কাজে লাগে। Turnitin নিজেই ১ থেকে ১৯% রেঞ্জের মধ্যে AI indicator স্কোরগুলো দমন (suppress) করে, অর্থাৎ সংখ্যা না দেখিয়ে একটি অ্যাস্টেরিস্ক দেয়, এবং সতর্ক করে যে তার স্কোর একাই কোনো integrity সিদ্ধান্ত চালিত করা উচিত নয়। ২০২৩ সালে Vanderbilt Turnitin-এর AI detector পুরোপুরি বন্ধ করে দেয়, false positives এবং অ-নেটিভ লেখকদের বিরুদ্ধে পক্ষপাতের কথা উল্লেখ করে। Michigan State, UT Austin, Northwestern, Pittsburgh, SMU এবং Waterloo-ও অনুরূপ পদক্ষেপ নেয়। তাই কোনো AI ফ্ল্যাগকে এমন একটি দাবি হিসেবে ধরুন, যেটি আপনি চ্যালেঞ্জ করতে পারেন, এটি কোনো চূড়ান্ত রায় (verdict) নয়। বিশেষ করে যখন আপনার কাজ সতর্কভাবে লেখা, উদ্ধৃতিতে (citations) সমৃদ্ধ, এবং আপনার নিজের।
শীর্ষ ইন্দোনেশীয় বিশ্ববিদ্যালয় ও যেখানে AI চেক দেখা যায়
ইন্দোনেশিয়ায় QS World University Rankings–এ ২৬টি বিশ্ববিদ্যালয় রয়েছে, এবং গবেষণা আউটপুট মূলত জাভা ও বাইরের দ্বীপপুঞ্জজুড়ে পাবলিক ও প্রাইভেট, একাধিক প্রতিষ্ঠানের একটি নেটওয়ার্কে কেন্দ্রীভূত। এগুলো সেই ক্যাম্পাসগুলো, যেখানে সাদৃশ্য (similarity) ও AI স্ক্রিনিং প্রায়ই সিদ্ধান্ত নেয়, থিসিস বা পান্ডুলিপি এগোবে কি না:
- Universitas Indonesia (UI), Depok এবং Jakarta
- Universitas Gadjah Mada (UGM), Yogyakarta
- Institut Teknologi Bandung (ITB), Bandung
- Universitas Airlangga (Unair), Surabaya
- Institut Pertanian Bogor (IPB University), Bogor
- Institut Teknologi Sepuluh Nopember (ITS), Surabaya
- Universitas Padjadjaran (Unpad), Bandung
- Universitas Diponegoro (Undip), Semarang
- Universitas Brawijaya (UB), Malang
- Universitas Hasanuddin (Unhas), Makassar
- Universitas Sebelas Maret (UNS), Surakarta
- BINUS University, Jakarta
- Telkom University (Tel-U), Bandung
সবগুলোর ক্ষেত্রেই নির্দেশনা একই: Scopus-সূচিবদ্ধ আন্তর্জাতিক জার্নালে প্রকাশ করুন, অথবা আপনার ক্যারিয়ার অগ্রগতি থমকে যাওয়ার ঝুঁকি নিন। এই চাপই অনেক ইন্দোনেশীয় লেকচারারকে AI লেখায় সহায়তা নিতে ঠেলে দেয়, এবং তারপর তাদের দরকার হয় একটি ন্যায্য, ঠিকঠাক উপায়, যাতে তাদের প্রকৃত কাজ ভুলভাবে পড়া না হয়।
ইন্দোনেশীয় গবেষকদের জন্য AI হিউম্যানাইজার কীভাবে কাজ করে
ওয়ার্কফ্লো চার ধাপে সম্পন্ন হয়, এবং শুরু হয় আপনার নিজের খসড়া দিয়ে। প্রথমে লিখুন, প্রয়োজনে Bahasa Indonesia-তে, তারপর ইংরেজিতে অনুবাদ করুন, যাতে আপনার যুক্তিটি সম্পূর্ণভাবেই আপনার নিজস্ব থাকে। দ্বিতীয়ত, ব্যাকরণ প্রুফরিড করুন, যাতে tense, articles, prepositions, এবং agreement সঠিক হয়। তৃতীয়ত, আপনার AI-সহায়ক গদ্যকে আমাদের টেক্সট হিউম্যানাইজার-এর মাধ্যমে চালান, যা ছন্দ ও শব্দচয়েস বদলে দেয়, সতর্ক দ্বিতীয়-ভাষার লেখার সমতল ও পুনরাবৃত্ত ধারা ভেঙে দেয়, এবং আপনার অর্থ, টেকনিক্যাল পরিভাষা ও উদ্ধৃতি (citations) বজায় রেখেই নীরবে বিচ্ছিন্ন em dashes সরিয়ে দেয়। চতুর্থত, আপনার প্রতিষ্ঠান ও জার্নাল যেভাবে চায় সেভাবে আপনার AI ব্যবহারের বিষয়টি প্রকাশ (disclose) করুন।
আমাদের হিউম্যানাইজার প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করা হয়েছে। এটি AI টেক্সটকে আরও স্বাভাবিক মানবীয় রূপে পুনর্লিখন করে, যা Turnitin, Originality.ai এবং GPTZero, সবগুলিতেই মানব-লেখা মতো পড়ে। একাডেমিক টেক্সটে ব্যাকরণগত নির্ভুলতা ৯৬%–এর বেশি। এটি কোনো নিশ্চয়তা নয়; পরীক্ষার ফলাফল। ডিটেক্টরগুলো প্রতি কয়েক মাস অন্তর পুনরায় প্রশিক্ষিত (retrain) হয়, তাই আমরা কখনোই প্রতিশ্রুতি দিই না যে টেক্সট "100% undetectable" হবে বা কোনো চেকার এড়িয়ে যাওয়া সম্ভব। তবে টুলটি যেটা নির্ভরযোগ্যভাবে করে তা হলো, যত্নশীল অ-নেটিভ গদ্যে যে প্রাকৃতিক ভ্যারিয়েশন অনুপস্থিত ছিল, সেটি ফিরিয়ে দেওয়া।
হিউম্যানাইজারটি ভাষাজ্ঞান-সমৃদ্ধ (language-aware) এবং ৬০টিরও বেশি ভাষা সমর্থন করে বলেই, ইন্দোনেশীয়-প্রভাবযুক্ত ইংরেজিতেও বাক্যগঠন ও অর্থ স্থির রাখে। আপনার পেপারে de-flattening নয়, বরং এখনও ব্যাকরণের কাজ দরকার হলে, সেটিকে আমাদের ইন্দোনেশিয়ায় গবেষকদের জন্য একাডেমিক এডিটিং–এর সঙ্গে যুক্ত করুন। আর আপনি যদি একাধিক ভাষায় প্রকাশ করেন, তাহলে আমাদের multilingual AI humanizer hub এক জায়গায় দেশভিত্তিক গাইডগুলো সংগ্রহ করে।
স্থানীয় অর্থায়ন সংস্থা, জার্নাল, এবং AI-প্রকাশের প্রত্যাশা
ইন্দোনেশিয়ার গবেষণা অর্থায়ন কিছু সীমিত জাতীয় ব্যবস্থার মাধ্যমে পরিচালিত হয়, এবং প্রতিটিই প্রকাশিত ইংরেজি-ভাষার আউটপুটকে গুরুত্ব দেয়। LPDP (Lembaga Pengelola Dana Pendidikan), শিক্ষা অনুদান তহবিল, দেশি-বিদেশি, দুটো জায়গাতেই ডক্টরাল স্টাডিকে সমর্থন করে এবং প্রত্যাশা করে যে তাদের স্কলাররা Scopus-সূচিবদ্ধ প্রকাশনা তৈরি করবেন। SINTA (Science and Technology Index) প্ল্যাটফর্মটি জার্নাল ও গবেষকদের র্যাঙ্ক করে এবং প্রমোশনের জন্য কী ধরা হবে তা গঠন করে, যেখানে ফুল প্রফেসর হতে হলে Scopus SJR 0.15 বা তার বেশি একটি মানদণ্ড। Serdos (Sertifikasi Dosen) লেকচারারের সার্টিফিকেশন ও ভাতা (allowance) নির্ভর করে ধারাবাহিক প্রকাশনার ওপর, আর Ministry of Education, Culture, Research and Technology (Kemendikbudristek) আন্তর্জাতিক প্রকাশনার সংখ্যা প্রতিটি রেক্টরের মূল কর্মক্ষমতা সূচকে (key performance indicators) অন্তর্ভুক্ত করে।
জার্নালগুলোর দিক থেকেও এখন আপনার পান্ডুলিপির সঙ্গে একটি AI-use statement যোগ করার প্রত্যাশা ক্রমেই বাড়ছে। ইন্দোনেশিয়া এখন ইংরেজি-ভাষার বেশ কিছু প্রকাশনা চালায়, যার মধ্যে রয়েছে Indonesian Journal of Science and Technology (UPI Bandung), Makara Journal of Science (Universitas Indonesia), ITB Journal of Science, Jurnal Ilmu Ternak dan Veteriner, Biodiversitas (UNS Surakarta), এবং Indonesian Journal of Chemistry (UGM)। সবার ক্ষেত্রেই নিরাপদ অবস্থানটি একই: কেবল আপনার নিজের AI-সহায়ক খসড়াকে হিউম্যানাইজ করুন, প্রতিটি উদ্ধৃতি (citation) অক্ষুণ্ণ রাখুন, এবং আপনি AI ব্যবহার করেছেন, এটি ঘোষণা করুন। এই সমন্বয় আপনাকে ইন্টেগ্রিটি রুলসের ভেতরে রাখে, একই সঙ্গে সতর্ক লেখাকে একটি ভুল ফ্ল্যাগ থেকে সুরক্ষিতও করে।
Frequently asked questions
Q: Is an AI humanizer for Indonesian researchers a way to cheat Turnitin?
না। সঠিক ব্যবহার হলো, আপনার নিজের AI-সহায়ক খসড়াকে হিউম্যানাইজ করা; জাল বা ধার করা কাজ লুকিয়ে রাখার উদ্দেশ্যে নয়। টুলটি সতর্ক দ্বিতীয়-ভাষার ইংরেজিতে প্রাকৃতিক ভ্যারিয়েশন ফিরিয়ে দেয়, যাতে তা ধারণার ভিত্তিতে বিচার হয়। আর আপনি এখনও আপনার AI ব্যবহারের বিষয়টি আপনার প্রতিষ্ঠান ও জার্নালে প্রকাশ করবেন।
Q: Will a humanizer AI change my citations or technical terms?
না। আমাদের হিউম্যানাইজার অর্থ (meaning), টেকনিক্যাল পরিভাষা এবং প্রতিটি উদ্ধৃতি (citation) বজায় রাখতে নির্মিত, এবং ছন্দ ও শব্দচয়েস বদলালেও এগুলো অপরিবর্তিত রাখে। এটি বাক্য কীভাবে প্রবাহিত হয় সেটি বদলায়, কিন্তু যা বলা হচ্ছে বা কাকে কৃতিত্ব দেওয়া হচ্ছে, সেটি নয়।
Q: Can Indonesian researchers really be flagged for writing they did themselves?
হ্যাঁ, এবং প্রমাণ স্পষ্ট। ২০২৩ সালের একটি Stanford গবেষণায় দেখা গেছে, মানব-লিখিত অ-নেটিভ প্রবন্ধের প্রায় ৬১% AI হিসেবে ফ্ল্যাগ হয়েছিল, যেখানে নেটিভ লেখকদের ক্ষেত্রে তা প্রায় ৫%। কারণ সতর্ক, পূর্বানুমানযোগ্য দ্বিতীয়-ভাষার গদ্য low-perplexity মেশিন টেক্সটের মতো স্কোর করে। এটি ন্যায্যতার সমস্যা, অসদাচরণের (misconduct) প্রমাণ নয়।
Q: Do I still need to disclose AI use after humanizing my draft?
হ্যাঁ। হিউম্যানাইজ করা এবং প্রকাশ (disclosing) করা, দুটি আলাদা ধাপ, যেগুলো একসাথে কাজ করে। হিউম্যানাইজ করা সতর্ক লেখাকে ভুল ফ্ল্যাগ থেকে রক্ষা করে, আর প্রকাশ করা নিশ্চিত করে যে আপনি আপনার বিশ্ববিদ্যালয় এবং লক্ষ্য জার্নালের নিয়ম মেনে চলছেন।
Q: Does the humanizer work if I draft in Bahasa Indonesia first?
হ্যাঁ। কারণ টুলটি ভাষা-সচেতন (language-aware) এবং ৬০টিরও বেশি ভাষা সমর্থন করে, আপনি Bahasa Indonesia-তে খসড়া লিখতে পারেন, অনুবাদ করতে পারেন, প্রুফরিড করতে পারেন, তারপর ইংরেজিকে হিউম্যানাইজ করতে পারেন; এতে বাক্যগঠন ও অর্থ অক্ষুণ্ণ থাকে। অনেক LPDP স্কলার এই ওয়ার্কফ্লোটি ইংরেজিতে সরাসরি লেখার চেয়ে দ্রুত বলে মনে করেন।
আপনার নিজস্ব AI-সহায়তাপ্রাপ্ত খসড়াকে Humanize করুন। অর্থ এবং উদ্ধৃতি সংরক্ষণ করুন, সাবধানী নন-নেটিভ ইংরেজিতে ভুলভাবে AI চিহ্নিত হওয়া কমান, তারপর আপনার AI ব্যবহারটি প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


