
Humanizer AI dla szwedzkich badaczy piszących po angielsku
Humanizer AI dla szwedzkich badaczy. Ograniczaj fałszywe flagi wykrywania AI w angielskim pod wpływem języka szwedzkiego, zachowaj sens i cytowania, a także rzetelnie ujawniaj użycie.

Szwecja działa po angielsku. Prace doktorskie na Karolinska Institutet są w nim pisane i bronione, artykuły z Lund i Uppsali przygotowuje się w nim, a kraj od lat plasuje się blisko czołówki EF English Proficiency Index. Gdy więc szwedzki doktorant dowiaduje się, że wykrywacz AI oznaczył rozdział, który napisał samodzielnie, reakcja jest zwykle prosto mówiąc: niedowierzaniem.
Taka reakcja jest uzasadniona. Istnieje humanizer AI dla szwedzkich badaczy, ponieważ staranna, standardowa i płynna szwedzko-angielska proza to dokładnie ten typ wypowiedzi, który te narzędzia błędnie odczytują. Doskonały angielski nie ochroni cię. Czasem to właśnie on jest problemem.
Mechanizm staje się niekomfortowy, gdy go zobaczysz. Wykrywacze premiują zaskakujące dobory słów i karzą przewidywalne. Autorzy, którzy zostali wytrenowani w jasnym przekazie, używaniu powszechnych słów i w uporządkowanej strukturze zdań, wytwarzają tekst o niskiej „perplexity”, a niska perplexity to dokładnie to, co wykrywacz punktuje jako tekst maszynowy.
Tak szwedzcy badacze mogą humanizować tekst AI do publikacji po angielsku
Nasz humanizer pomaga szwedzkim badaczom humanizować tekst AI w ich własnych szkicach, tak aby poprawna i dobrze napisana szwedzko-angielska fraza nie była błędnie oznaczana jako maskowanie generacji AI, przy jednoczesnym zachowaniu sensu, terminologii i odnośników do źródeł.
In plain English: narzędzie bierze twój własny szkic wspierany przez AI i zmienia jego rytm oraz dobór słów, aby czysta szwedzko-angielska proza była mniej podatna na błędne odczytanie przez główne wykrywacze. Zachowuje twoje cytowania, twoją techniczną terminologię i nienaruszony tok argumentacji. Nie pisze twojej pracy za ciebie i nie zostało stworzone po to, by cokolwiek ukrywać.
Piszesz po szwedzku? Jest wykrywane automatycznie i humanizowane natywnie
Szwedzcy badacze często tworzą najpierw szkic w swoim języku ojczystym, a dopiero potem przechodzą na angielski, i humanizer to wspiera. Wklej tekst po szwedzku, a ProofreaderPro sam wykryje język, następnie przetworzy go w modelu uwzględniającym język szwedzki, który zachowuje Twoje „å”, „ä” i „ö”, terminologię oraz cytowania dokładnie na swoim miejscu. Aby humanizować tekst AI, możesz zacząć od szwedzkiego szkicu, a zostanie on przepisany równie sprawnie, jak twoja wersja angielska. Ten sam mechanizm wykrywania obejmuje ponad sześćdziesiąt języków, a każdy jest humanizowany „we własnym głosie”.
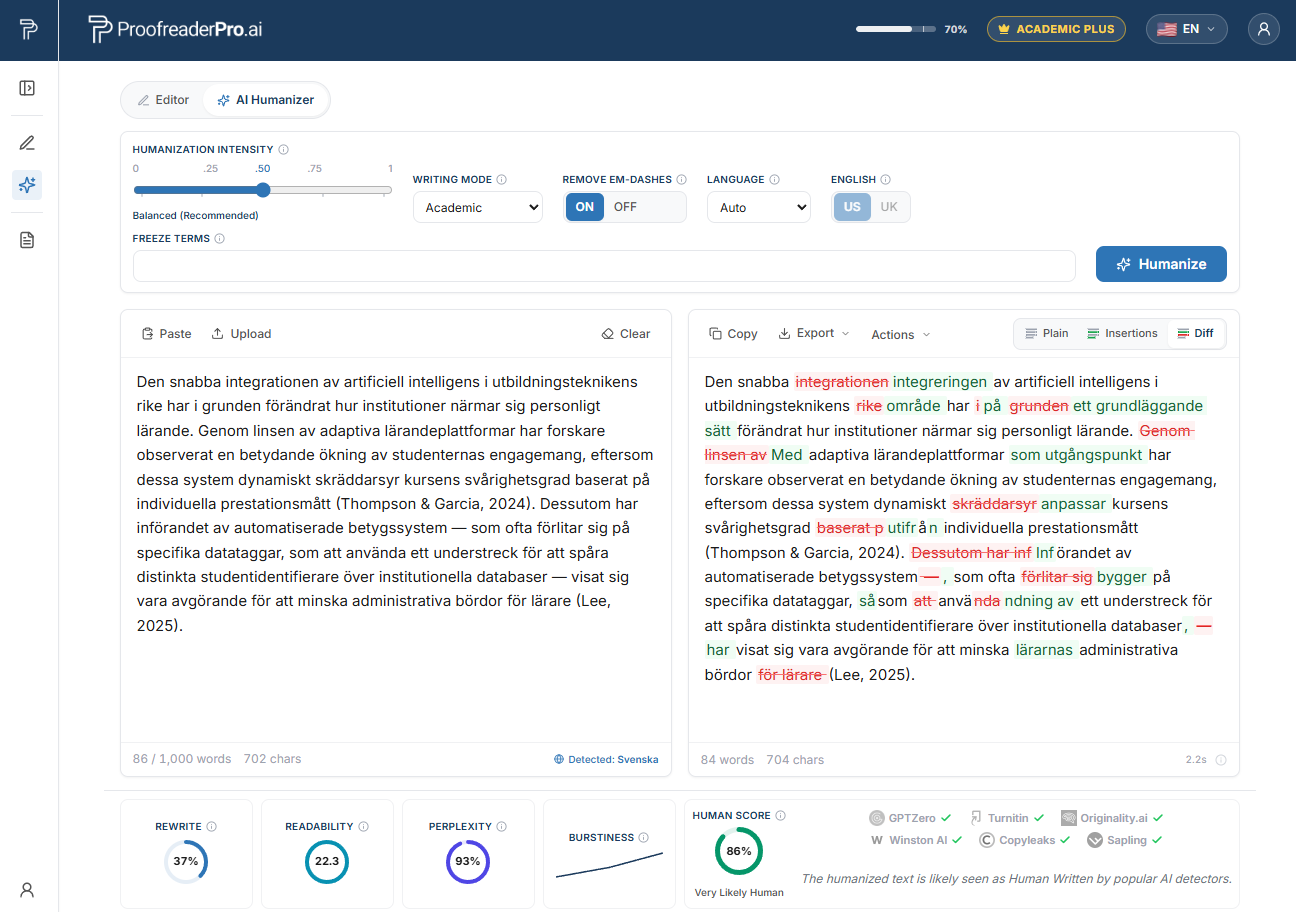
ProofreaderPro AI Humanizer przepisuje szwedzki tekst akademicki. Różnica „przed i po” zachowuje sens i cytowania, a testy wykrywaczy potwierdzają naturalny, ludzki odczyt.
Dlaczego szwedzcy badacze są oznaczani przez wykrywacze AI
Zacznijmy od badania, które ujęło problem w liczby. W 2023 r. zespół ze Stanford, kierowany przez Lianga i współpracowników, opublikował w czasopiśmie Cell Press „GPT detectors are biased against non-native English writers”. Wykorzystali oni napisane przez ludzi eseje TOEFL i uruchomili je przez siedem powszechnie stosowanych wykrywaczy.
Wyniki były wyraźne. Średnio około 61% esejów autorów niebędących native speakerami zostało oznaczonych jako AI, wobec mniej więcej 5% w przypadku autorów piszących po angielsku jako języku ojczystym. Prawie co piąty esej niebędącego native speakerem, około 19,8%, został oznaczony jednogłośnie przez każdy wykrywacz z panelu. Każdy esej był napisany przez człowieka.
Dlaczego tak się dzieje? Wiele wykrywaczy opiera się na „perplexity”, miarze tego, jak zaskakujące jest kolejne słowo dla modelu językowego. Staranny autor uczący się drugiego języka sięga po typowe słowo i standardową konstrukcję, co jest przejawem dobrej pisarskiej praktyki, ale jednocześnie prowadzi do przewidywalnego tekstu o niskiej perplexity. To właśnie te nawyki, które sprawiają, że szwedzko-angielski jest klarowny, systemy zostały wytrenowane do flagowania. Dokładniej omawiamy mechanizm w dlaczego wykrywacze AI oznaczają angielski autorów niebędących native speakerami.
Stawka nie jest abstrakcyjna. Badacze niebędący native speakerami mierzą się już z odsetkami odrzuceń około 2,5 razy wyższymi niż u native speakerów, spędzają około 51% więcej czasu na pisaniu swoich prac i otrzymują znacznie więcej prośb o poprawki związane z jakością języka. Fałszywa flaga trafia więc na barierę, która i tak jest już wysoka.
Szwedzkie wzorce języka ojczystego stojące za fałszywymi flagami
Szwedzki akademicki angielski ma rozpoznawalny kształt i nic z tego nie jest błędne. To poprawne, staranne, standardowe konstrukcje. Ich „standardowość” jest pułapką, ponieważ dla wykrywacza standardowy zapis czyta się jako niską perplexity.
Klasyczne sygnały dają fałszywi przyjaciele. „Aktuell” oznacza „current” lub „relevant”, a nie „actual”; „eventuellt” znaczy „possibly”, a nie „eventually”; „kontrollera” znaczy „to check”, a nie „to control”. Szwedzki autor, który pisze „we controlled the temperature”, mając na myśli „we checked it”, stosuje precyzyjnie dobrane, świadomie użyte słownictwo, takie, które model łatwo przewiduje.
Przenosi się także szyk. Szwedzki to język z pozycją czasownika na drugiej kolejności (verb-second), więc czasownik skończony chce zająć drugie miejsce. Ten nawyk wytwarza uporządkowane, nieco formalne zdania, a po korekcie („Therefore the model is robust”) pozostającej równomierności wykrywacz niechętnie przypisuje się „kadencji maszynowej”.
Są też rodzajniki. Szwedzki oznacza określoność końcówką zamiast osobnego słowa, więc w angielskim rodzajniki bywają opuszczane lub dublowane: „the research show”, „result was significant”. Gdy robi to korektor, wszystko się porządkuje i staje się regularne, a „regularność” jest dokładnie tym, co punktuje niska perplexity.
Pewne mniejsze sygnały pojawiają się stale: „since” używane do „for” w kontekście czasu trwania, częste stosowanie rzeczowników złożonych oraz słowa „respective”, a także nieco przytłumiony rejestr, który niektórzy recenzenci mylą z płaskością. Każdy z tych wyborów jest obronny sam w sobie. Razem składają się na prozę gładką, równą i łatwą dla modelu do przewidywania.
Kontekst wykrywania AI w Szwecji i Turnitin
Prace doktorskie i manuskrypty w Szwecji są weryfikowane rutynowo. Sprawdzanie podobieństw to standard w całym sektorze, a wiele szwedzkich uczelni historycznie opierało się na rozwiązaniach Urkund i Ouriginal opracowanych lokalnie, które obecnie są częścią Turnitin. Wskaźniki AI coraz częściej współistnieją w tych samych raportach obok wyników podobieństwa.
Wytyczne nadążają. Stowarzyszenie szwedzkich instytucji szkolnictwa wyższego (SUHF) oraz poszczególne uczelnie wydały zalecenia dotyczące generatywnej AI, a instytucje finansujące i czasopisma coraz częściej proszą o jasne oświadczenie, w jaki sposób użyto AI. Kierunek zmian idzie w stronę ujawniania, a nie zakazywania.
Jedna rzecz warta zapamiętania: wynik wykrywacza to twierdzenie, a nie wyrok. Sam Turnitin ukrywa wyniki z niskiego zakresu zamiast podawać liczbę, i ostrzega, że jego wynik nie powinien być używany samodzielnie do rozstrzygania spraw dotyczących integralności. Kilka uczelni za granicą, w tym Vanderbilt, wyłączyło wykrywacz AI całkowicie ze względu na fałszywe trafienia i uprzedzenia wobec autorów niebędących native speakerami. Flaga to rzecz, którą trzeba kwestionować, a nie wyznanie winy.
Chroń swój szwedzko-angielski przed złożeniem pracy
Uhumanizuj własny szkic wspomagany AI, zachowaj cytowania i znaczenie, a następnie ujawnij użycie AI. Wypróbuj na jednym akapicie swojej pracy dyplomowej i zobaczy Pan/Pani różnicę.
Wypróbuj darmowy HumanizerNajważniejsze szwedzkie uczelnie i miejsce, gdzie pojawiają się kontrole AI
Te same narzędzia przesiewowe występują na wiodących instytucjach w całej Szwecji, od szkół medycznych po uczelnie techniczne:
- Karolinska Institutet (KI), Sztokholm (medycyna)
- Uppsala universitet, Uppsala
- Lunds universitet, Lund
- Kungliga Tekniska högskolan (KTH), Sztokholm
- Stockholms universitet (SU), Sztokholm
- Göteborgs universitet (GU), Göteborg
- Chalmers tekniska högskola, Göteborg
- Linköpings universitet (LiU), Linköping
- Umeå universitet, Umeå
- Sveriges lantbruksuniversitet (SLU), Uppsala
- Örebro universitet, Örebro
- Linnéuniversitetet, Växjö i Kalmar
Każda z tych instytucji przesiewa prace doktorskie i manuskrypty pod kątem podobieństw, a coraz częściej waży także wskaźniki AI w tym samym workflow. Chodzi nie o to, że którąkolwiek z nich można uznać za wrogą. Chodzi o to, że fałszywa flaga może trafić w starannie przygotowaną pracę na dowolnej z nich, dlatego rozsądny krok to zabezpieczenie własnego pisania jeszcze przed złożeniem manuskryptu.
Jak działa humanizer AI dla szwedzkich badaczy
Workflow jest uczciwy i prosty, a zaczyna się od twojego własnego szkicu.
Najpierw pisz. Wielu szwedzkich badaczy szkicuje po szwedzku, tam myśli się najszybciej, a potem tłumaczy. Inni szkicują od razu po angielsku. Niezależnie od tego, słowa i argumentacja są twoje.
Sprawdź i popraw gramatykę. Uporządkuj fałszywych przyjaciół, pominięte rodzajniki i przeniesienie szyku z języka z czasownikiem na drugiej pozycji. Nasz AI proofreader naprawia mechanikę bez spłaszczania twojego sensu, a gdy gramatyka jest już solidna, przechodzisz do humanizera.
Następnie humanizuj własny tekst wspierany przez AI. To tutaj humanizer AI dla szwedzkich badaczy różnicuje rytm i dobór słów, rozbija równą kadencję i usuwa powtarzalne schematy oraz „zagubione” pauzy (em dash), które potykają wykrywacze. W naszych własnych testach w istotnym stopniu zmniejsza to, jak często staranna, standardowa szwedzko-angielska proza jest odczytywana błędnie przez główne wykrywacze (Turnitin, Originality.ai, GPTZero i podobne), przy zachowaniu twojego sensu, terminologii i cytowań. Opisujemy to jako to, co zaobserwowaliśmy w testach, a nie jako obietnicę. Wykrywacze trenują się co kilka miesięcy i żadne uczciwe narzędzie nie może obiecać, że będzie „w 100% niewykrywalne”.
Obsługiwane są też szkice w językach innych niż angielski. Humanizer obsługuje ponad 60 języków i kieruje tekst nieangielski przez model rozpoznający język, który zachowuje strukturę zdań i sens, to ma znaczenie, jeśli humanizujesz szwedzki szkic przed tłumaczeniem. Ten wpis to jeden węzeł w naszym wielojęzycznym hubie do humanizacji AI i stoi obok globalnego huba do redakcji akademickiej przeznaczonego do prac obejmujących pełny manuskrypt.
Na koniec, ujawnij użycie. Humanizowanie własnego tekstu nie jest tym samym co ukrywanie. Zapisz, jak użyto AI, w formacie wymaganym przez twoją jednostkę i docelowe czasopismo, a pozostaniesz wprost w ramach zasad dotyczących integralności, jednocześnie chroniąc swoją pracę przed fałszywą flagą.
Lokalne instytucje finansujące, czasopisma i oczekiwania dotyczące ujawniania użycia AI
W Szwecji instytucje finansujące coraz częściej oczekują przejrzystości w zakresie użycia AI. Vetenskapsrådet (Szwedzka Rada ds. Badań Naukowych, VR) jest głównym publicznym finansującym, a Fundacja Knuta i Alice Wallenberg (KAW), znaczącym prywatnym. Forte (zdrowie, życie zawodowe, dobrostan), Formas (środowisko i rolnictwo) oraz Vinnova (innowacje) finansują swoje własne obszary, szwedzkie zespoły regularnie zdobywają granty ERC, a otwarty dostęp obowiązuje w całym zakresie.
Od strony publikacji szwedzcy badacze celują w czasopisma indeksowane w Web of Science i Scopus oraz rejestrują wyniki w SwePub. Coraz więcej z tych czasopism prosi o wyraźną notę dotyczącą pomocy AI. Krótkie, uczciwe ujawnienie powinno znaleźć się już teraz w standardowej sekcji dotyczącej metod lub podziękowań, a „zrobienie tego dobrze” jest łatwiejsze, niż większość osób zakłada. Zobacz nasz przewodnik dotyczący pisania oświadczenia o AI disclosure statement, a jeśli mimo wszystko flaga pojawi się nawet przy czystej, ujawnionej pracy, appeal playbook opisuje, jak zareagować.
Wspólnym mianownikiem jest tu sprawiedliwość. To ty wykonałeś badania, to ty napisałeś artykuł, a wynik oparty na perplexity nie powinien zdominować tej rzeczywistości.
Najczęściej zadawane pytania
P: Czy humanizer AI pomoże, jeśli mój angielski jest już bardzo dobry?
Często tak, i to jest część intuicyjnie trudna. Wykrywacze oznaczają tekst o niskiej perplexity, a wypolerowana, standardowa szwedzko-angielska proza z natury ma niską perplexity. Humanizer różnicuje rytm i sformułowania, dzięki czemu czyste pisanie jest mniej podatne na błędny odczyt, bez zmieniania tego, co faktycznie powiedziałeś.
P: Czy łamanie zasad polega na humanizowaniu tekstu AI w mojej własnej pracy doktorskiej?
Humanizowanie własnego szkicu, a następnie ujawnienie użycia AI, nie łamie zasad w większości instytucji. Chodzi o to, że zasady koncentrują się na tym, czy ktoś „oddaje jako swoje” prace wytworzone, sfałszowane lub niezadeklarowane. Gdy zachowujesz sens i cytowania oraz jasno informujesz, jak użyto AI, pozostajesz w ramach uczciwości akademickiej.
P: Czy jakiekolwiek narzędzie może zagwarantować, że moja praca przejdzie Turnitin lub GPTZero?
Nie, i uważaj na każdego, kto mówi coś przeciwnego. Wykrywacze zmieniają swoje modele co kilka miesięcy, więc żadne uczciwe narzędzie nie może obiecać konkretnego wyniku ani twierdzić, że zapewnia „100% niewykrywalności”. To, co można powiedzieć, jest takie: w naszych testach humanizer w istotny sposób ogranicza fałszywe flagi w przypadku starannej prozy pisanej przez autorów niebędących native speakerami, co jest czymś innym niż gwarancja.
P: Czy humanizer zmienia moje cytowania lub terminy techniczne?
Nie. Został zaprojektowany tak, aby zachować cytowania, techniczną terminologię i merytoryczną treść argumentacji, a jednocześnie dopasować rytm i dobór słów. Twoja bibliografia, równania i słownictwo dziedzinowe pozostają takie, jak je napisałeś.
P: Najpierw pisałem po szwedzku. Czy to ma znaczenie?
Nie. Humanizer obsługuje ponad 60 języków i przetwarza tekst nieangielski w modelu rozpoznającym język, który chroni strukturę zdań i sens, dzięki temu możesz pracować po szwedzku i tłumaczyć, albo humanizować dopiero po przetłumaczeniu na angielski.
Zmniejsz liczbę fałszywych alarmów AI w przypadku starannej prozy niebędącej językiem ojczystym, zachowując znaczenie, terminologię i cytowania. Stworzone z myślą o badaczach publikujących po angielsku.

Moe jest inżynierem NLP z PhD w przetwarzaniu języka naturalnego. Jego badania obejmują lingwistykę obliczeniową, analizę tekstu i uczenie maszynowe, a następnie zostały wykorzystane bezpośrednio w modelach edycji i humanizacji stojących za ProofreaderPro. Pisze o części procesu, której większość ludzi nigdy nie widzi: o tym, jak model językowy czyta zdanie, ocenia je i decyduje, co zmienić.


