
AI humanizer dla hiszpańskich badaczy piszących po angielsku
AI humanizer dla hiszpańskich badaczy. Ogranicz liczbę fałszywych alarmów wykrywania AI dla angielskiego inspirowanego językiem hiszpańskim, zachowaj sens i cytowania oraz uczciwie ujawniaj użycie AI, zgodnie z oczekiwaniami uczelni i czasopisma.

Hiszpania należy do większych europejskich producentów badań, konsekwentnie plasując się w światowej czołówce, między 10 a 12. Prawie całość tych prac trafia do odbiorców w języku angielskim, będącym drugim językiem dla większości osób, które je piszą. Ta luka, między myśleniem po hiszpańsku a publikowaniem po angielsku, jest dokładnie tam, gdzie AI humanizer dla hiszpańskich badaczy znajduje swoje miejsce.
Oto problem, którego nikt nie przewidział. Detektory tekstu generowanego przez AI trafiły już do narzędzi przesiewowych, które sprawdzają prace licencjackie i dyplomowe oraz zgłoszenia do czasopism. Zbudowano je do wykrywania tekstu maszynowego, ale rutynowo oznaczają jako AI staranne, poprawne i napisane przez człowieka prace piszących niebędących rodzimymi użytkownikami angielskiego. To nie Twoje słownictwo ani styl stanowią problem. Problemem jest przewidywalność.
Badacz z Madrytu lub Barcelony, który najpierw szkicuje po hiszpańsku, tłumaczy i dopracowuje treść w czystym, akademickim angielskim, może zostać odebrany jako bardziej „maszynowy” niż nieuważny rodzimy użytkownik języka, który nigdy nie korzystał z narzędzi językowych. Ten wpis dotyczy domknięcia tej luki wprost: ulepszenia własnego draftu, zachowania sensu i cytowań oraz uczciwego ujawnienia użycia AI w sposób, jakiego oczekują zarówno uczelnia, jak i redakcja czasopisma.
Un humanizador de texto de IA para investigadores españoles
Nasz humanizador de texto de IA pomaga hiszpańskim badaczom publikować po angielsku bez tego, by ich staranne pisanie zostało pomylone z tekstem wygenerowanym przez maszynę. Zachowuje Twoje znaczenie, terminologię techniczną i cytowania, a także różnicuje tempo oraz dobór słów, które detektor interpretuje jako automatyczne.
W prostych słowach: narzędzie przepracowuje rytm i dobór wyrazów Twojego własnego draftu tak, aby starannie pisany tekst w drugim języku był mniej narażony na błędną interpretację, podczas gdy Twoja argumentacja i odniesienia pozostają dokładnie tam, gdzie je umieściłeś. Zbudowano je do realnej pracy wykonywanej przez realnych autorów, nie do ukrywania czegokolwiek.
Humanizuj też swój hiszpański bezpośrednio: nie tylko angielski
Nie musisz przechodzić na angielski, zanim zaczniesz humanizować swoją pracę. Wklej fragment po hiszpańsku, a ProofreaderPro automatycznie wykryje język, po czym poprowadzi go przez model świadomy języka hiszpańskiego, zachowując akcenty, terminologię i cytowania dokładnie w takiej postaci, w jakiej zostały zapisane. Jako humanizador de texto de IA działa na Twoim hiszpańskim draftcie tak samo, jak na angielskim, zachowując sens, jednocześnie sprawiając, że sformułowania brzmią naturalnie. Wykrywanie obejmuje ponad sześćdziesiąt języków, więc hiszpański jest przepisywany jako hiszpański, a nie spłaszczany do angielskiego.
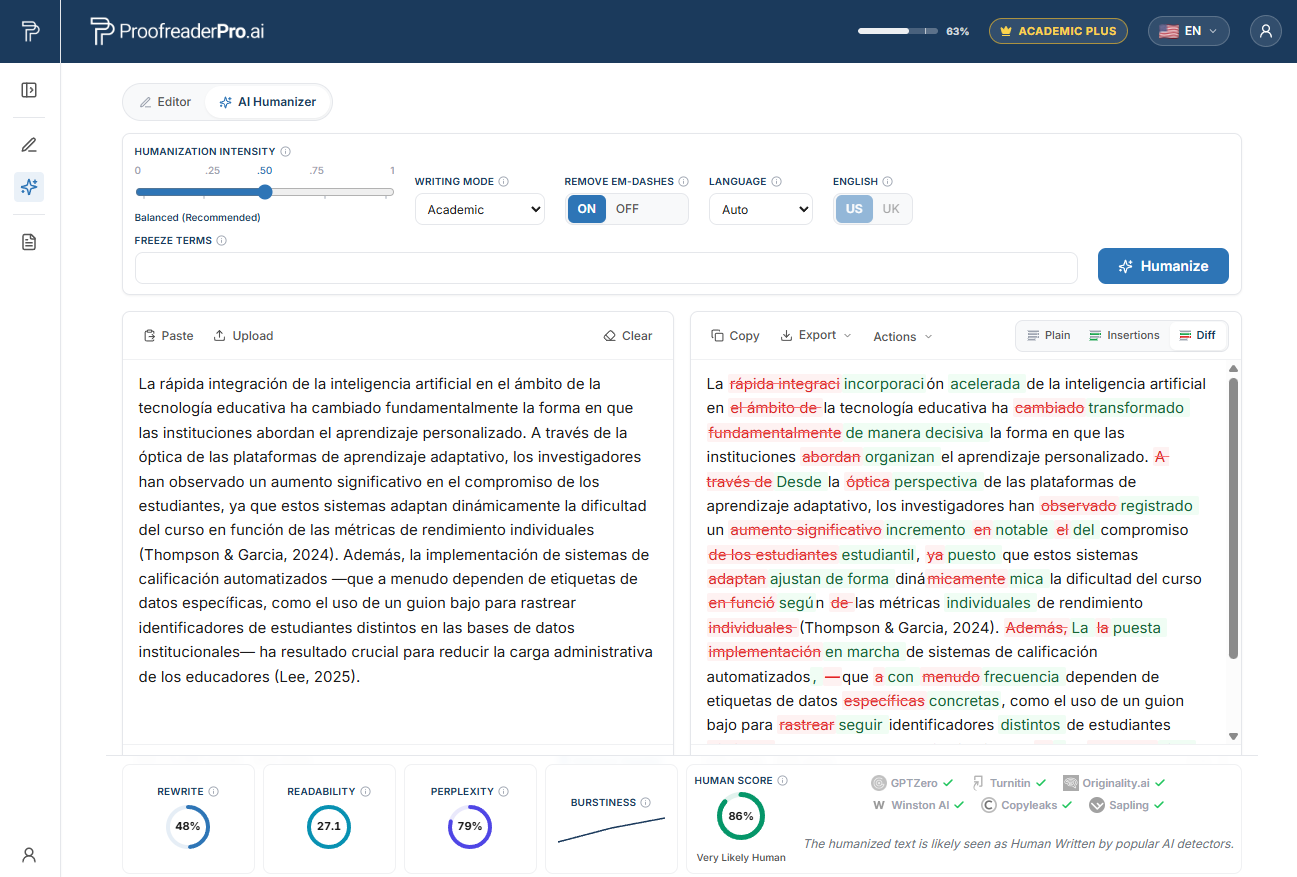
The ProofreaderPro AI Humanizer rewriting Spanish academic text. Różnica „przed i po” zachowuje sens i cytowania, a sprawdzenia detektora potwierdzają naturalny, ludzki odbiór.
Dlaczego hiszpańskich badaczy oznacza się jako tekst z AI
Najbardziej jednoznaczne dowody pochodzą z badania Stanforda z 2023 roku autorstwa Lian i współpracowników, opublikowanego w czasopiśmie Cell Press „Patterns” pod tytułem "GPT detectors are biased against non-native English writers." Zespół przepuścił przez siedem powszechnie używanych detektorów eseje napisane przez ludzi, w tym takie, które pochodziły z TOEFL.
Wynik powinien niepokoić każdego, kto publikuje w drugim języku. Około 61% nie-rodzimych esejów zostało średnio oznaczonych jako AI, w porównaniu z ok. 5% w przypadku autorów anglojęzycznych. Prawie co piąty esej nie-rodzimy, tj. ok. 19,8%, został oznaczony jednomyślnie przez wszystkie detektory. Wszystkie eseje zostały napisane przez ludzi.
Mechanizm nazywa się „perpleksyjnością” (perplexity): miarą tego, jak zaskakujący jest wybór każdego słowa dla modelu językowego. Staranni autorzy piszący w drugim języku sięgają po powszechne słowa i standardowe, przewidywalne sformułowania, co prowadzi do niskiej perpleksyjności, a detektor interpretuje to jako tekst maszynowy. Te same nawyki, które sprawiają, że angielski hiszpańskich badaczy jest jasny i poprawny, są jednocześnie nawykami, których uczą się te narzędzia. Dokładnie rozkładamy pełny mechanizm w naszym przewodniku dlaczego AI detektory oznaczają autorów niebędących rodzimymi użytkownikami.
Hiszpańskie wzorce języka ojczystego stojące za fałszywymi alarmami
Hiszpański jest językiem romańskim, a jego wzorce przenoszą się do angielskiego w sposób w pełni poprawny, lecz jednocześnie bardzo regularny. Ta regularność stanowi pułapkę. Oto te wzorce, które najczęściej obserwujemy w manuskryptach autorów hiszpańskich.
Fałszywe przyjazne słowa (false cognates). „Actual” i „actually” bywają używane w znaczeniu „current” i „currently” (hiszpańskie „actual” oznacza „current”), „realize” zastępuje „carry out” (realizar), „assist”, „attend” (asistir), a „sensible”, „sensitive”. Każdy z tych przypadków jest standardową, możliwą do nauczenia zamianą, dlatego brzmi to tak przewidywalnie.
Przewaga rodzajników przy rzeczownikach abstrakcyjnych. W hiszpańskim przed rodzajnikami określonymi poprzedza się rzeczowniki ogólne, więc „the research shows,” „the science,” i „the society” pojawiają się tam, gdzie angielski zwykle pomija rodzajnik. To konsekwentny, regułowy wzorzec, a właśnie konsekwencja obniża perpleksyjność.
Długie zdania podrzędne, pełne zależności. Romański styl akademicki preferuje długie, okresowe zdania ze skumulowanymi zdaniami przydawkowymi. Są one poprawne gramatycznie, ale ich równy, „zdanie po zdaniu” rytm wygląda detektorowi jak gładki, maszynowy przepływ.
Transfer przyimków. „Depend of” (depender de), „consist on” (consistir en), „different to” oraz „in relation with” pochodzą prosto z hiszpańskiej rekcji przyimków. To uważne i systematyczne przeniesienie, a zatem łatwe do przewidzenia dla modelu.
Silna nominalizacja i sztywny szyk wyrazów. Konstrukcje typu „the realization of the analysis of” gromadzą rzeczowniki abstrakcyjne w ustalonym układzie. Dodaj nadmiarowe użycie przydawki względnej „which” oraz kalkowane otwarcie „On the other hand” na początku wielu zdań, a tekst staje się wyraźnie regularny.
Żaden z tych elementów nie jest błędem w myśleniu. To poprawne, staranne i standardowe konstrukcje, a właśnie ich „standardowość” sprawia, że detektor przypisuje im niską perpleksyjność, a niska perpleksyjność jest tym, co detektor etykietuje jako tekst maszynowy.
Kontekst wykrywania AI w Hiszpanii i Turnitin
Awans zawodowy hiszpańskich naukowców zależy od sexenios de investigación, sześcioletniej oceny badań przeprowadzanej przez ANECA i CNEAI. Punkty przyznaje się za publikacje w czasopismach ujętych w Journal Citation Reports (Web of Science) oraz w Scopus. System ten tworzy stałą presję na hiszpańskich badaczy, by publikowali w czasopismach o wysokim wpływie (impact) w języku angielskim, gdzie detektory „czekają”.
Prace dyplomowe w Hiszpanii trafiają do repozytoriów instytucjonalnych takich jak TDX oraz do krajowego rejestru TESEO, a screening podobieństwa z użyciem Turnitin lub iThenticate jest standardową procedurą już na tym etapie. Coraz częściej te same platformy wyświetlają wskaźnik AI obok wyniku podobieństwa.
Pomaga utrzymać ten wskaźnik we właściwej proporcji. Vanderbilt wyłączył detektor AI w Turnitin w 2023 roku, powołując się na fałszywe trafienia i uprzedzenia wobec autorów niebędących rodzimymi użytkownikami, podobnie jak zrobiły to Michigan State, UT Austin, Northwestern, Pittsburgh, SMU i Waterloo. Turnitin tłumi wyniki w zakresie 1–19% i ostrzega przed poleganiem wyłącznie na samym wyniku przy podejmowaniu decyzji dotyczących integralności. Flaga detektora jest roszczeniem do zakwestionowania, a nie wyrokiem. Jednocześnie sponsorzy i redakcje czasopism coraz częściej proszą o proste ujawnienie tego, jak użyto AI, zamiast zgadywanego procentu.
Chroń swój starannie napisany angielski przed fałszywym oznaczeniem AI
Uhumanizuj własny szkic wspomagany przez AI, utrzymując każde cytowanie i termin techniczny na swoim miejscu, a następnie ujawnij swoje wykorzystanie AI dokładnie tak, jak prosi Twoje czasopismo.
Wypróbuj darmowy HumanizerNajważniejsze hiszpańskie uniwersytety i miejsca, w których pojawiają się kontrole AI
Badania w Hiszpanii są rozproszone w ramach silnego systemu uniwersytetów publicznych. Instytucje te sprawdzają prace dyplomowe i manuskrypty pod kątem podobieństwa, najczęściej z użyciem Turnitin, a coraz częściej uwzględniają też wskaźniki AI:
- Universitat de Barcelona (UB), Barcelona
- Universidad Autónoma de Madrid (UAM), Madrid
- Universidad Complutense de Madrid (UCM), Madrid
- Universitat Autònoma de Barcelona (UAB), Barcelona
- Universitat de València (UV), Valencia
- Universidad de Granada (UGR), Granada
- Universidad Politécnica de Madrid (UPM), Madrid
- Universitat Politècnica de València (UPV), Valencia
- Universidad de Sevilla (US), Seville
- Universidad del País Vasco / Euskal Herriko Unibertsitatea (UPV/EHU), Bilbao
- Universidad de Salamanca (USAL), Salamanca
- Universitat Pompeu Fabra (UPF), Barcelona
- Universidad de Navarra (UNAV), Pamplona
- Universidad de Zaragoza (UNIZAR), Zaragoza
Niezależnie od tego, czy Twoja praca trafi do UB, UAM czy UNIZAR, etap przesiewu jest w dużej mierze podobny, podobnie jak ryzyko, że starannie napisany angielski w drugim języku zostanie odebrany w niewłaściwy sposób.
Jak działa AI humanizer dla hiszpańskich badaczy
Proces jest prosty i trzyma Cię w ramach zasad. Szkicuj pracę tak, jak pozwala Ci najlepiej myśleć, często najpierw po hiszpańsku, a następnie tłumacz. Popraw gramatykę tak, by sens był dokładny; jeśli chcesz wykonać drugi przebieg bezpośrednio na samym angielskim, nasz przewodnik korekty AI dla hiszpańskich badaczy prowadzi przez ten etap. Dopiero wtedy humanizujesz własny tekst wspomagany AI, aby staranne, nisko-perpleksyjne pisanie było mniej podatne na błędny odczyt.
Ten ostatni krok wykonuje nasz AI humanizer. Zachowuje Twoje znaczenie, terminologię techniczną i cytowania oraz różnicuje rytm i dobór słów, które detektor odczytuje jako „maszynową” kadencję. Obsługuje ponad 60 języków, kierując tekst nieangielski przez model świadomy języka, tak, by struktura zdań i sens pozostały nienaruszone.
Dbamy o to, czego naprawdę możemy dowieść. Humanizer przepisuje tekst AI na bardziej naturalną, „ludzką” formę, co obniża sygnał AI i zwiększa szanse w starciu z trudnymi detektorami, przetestowanymi na głównych detektorach. W przypadku gramatyki w tekstach akademickich uzyskuje też wyniki lepsze niż 96%. To rezultaty testów, nie gwarancje. Detektory przeuczą się co kilka miesięcy, dlatego nigdy nie obiecujemy konkretnej liczby ani sposobu na „obejście” czegokolwiek.
Następnie, ujawnij. Dodaj oświadczenie o użyciu AI w formacie, którego wymaga Twoja instytucja i docelowe czasopismo, aby narzędzie chroniło staranne pisanie bez ukrywania tego, jak zostało wytworzone. To „oświadczenie” mieści się w naszym wielojęzycznym hubie do AI humanizacji i uzupełnia globalny hub do redakcji akademickiej, jeśli chcesz dodać warstwę ludzkiej edycji.
Lokalni grantodawcy, czasopisma i oczekiwania dotyczące ujawniania użycia AI
Konkurencyjne finansowanie w Hiszpanii płynie przez Agencia Estatal de Investigación (AEI) oraz Ministerio de Ciencia, Innovación y Universidades, natomiast Consejo Superior de Investigaciones Científicas (CSIC) jest największą publiczną instytucją badawczą w kraju. Stanowiska akademickie są akredytowane przez ANECA, a FECYT przyznaje hiszpańskim czasopismom naukowym pieczęć jakości, dlatego zarówno indeksowanie, jak i jakość językowa mają realne znaczenie dla kariery w Hiszpanii.
Od strony publikacji hiszpańscy badacze celują w czasopisma indeksowane w Web of Science (JCR) i Scopus; w niektórych dziedzinach znaczenie mają również indeksy krajowe i dyscyplinarne, a prace dyplomowe trafiają do TDX oraz do rejestru TESEO. W obrębie tych wszystkich instytucji ujawnianie użycia AI przesuwa się z trybu „opcjonalnego” do „oczekiwanego”. Bezpieczna postawa jest taka sama wszędzie: korzystaj z narzędzi na własnych materiałach, zachowaj dokładność cytowań i jasno opisz, w jaki sposób AI pomogło. Wykonaj ten końcowy przebieg przez humanizator, a chronisz treść bez zniekształcania jej rzeczywistego charakteru.
Najczęściej zadawane pytania
P: Czy korzystanie z AI humanizera dla hiszpańskich badaczy jest uznawane za oszustwo?
Nie, jeśli używasz go do własnego draftu wspomaganego AI, a następnie to ujawniasz. Narzędzie przestawia rytm pisania, który już sam przygotowałeś, zachowując sens i cytowania, tak, by staranny angielski niebędących rodzimymi użytkownikami nie był odczytywany jako tekst maszynowy. Ujawnienie użycia AI w formacie, jakiego wymaga Twoje czasopismo lub uczelnia, sprawia, że cały proces pozostaje w ramach zasad integralności.
P: Czy humanizador de texto de IA zmieni moje cytowania lub terminy techniczne?
Nie. Humanizator został zaprojektowany tak, aby zachować terminologię techniczną, odniesienia oraz strukturę Twojej argumentacji, jednocześnie zmieniając dobór słów i kadencję. Twoje klucze cytowań, ryciny i słownictwo specjalistyczne pozostają dokładnie tam, gdzie je umieściłeś, ponieważ ich zmiana niweczyłaby sens narzędzia.
P: Dlaczego mój poprawny angielski został w pierwszej kolejności oznaczony jako AI?
Ponieważ wiele detektorów ocenia perpleksyjność, czyli to, jak przewidywalne są Twoje wybory słów. Staranni autorzy hiszpańskojęzyczni używają typowych słów i standardowego sformułowania, co daje niską perpleksyjność, a to z kolei jest odczytywane jako tekst maszynowy. W badaniu Stanforda ok. 61% ludzkopisanych esejów niebędących rodzimymi użytkownikami zostało oznaczonych, w porównaniu z ok. 5% w przypadku autorów rodzimych, więc flaga na Twojej pracy jest częsta i możliwa do zakwestionowania.
P: Jakie faktycznie wyniki przepuszczania ma humanizator?
Przetestowany na głównych detektorach, przepisuje tekst AI na bardziej naturalną formę ludzką, co obniża sygnał AI i poprawia jego szanse w starciu z trudnymi detektorami, przy jednoczesnym zachowaniu wysokiej dokładności gramatyki w tekstach akademickich. To wyniki testów, nie gwarancje. Detektory przeuczą się często, więc opisujemy to, co mierzyliśmy, a nie obiecujemy stały rezultat.
P: Moja praca dyplomowa będzie sprawdzana w Turnitin na mojej uczelni. Co powinienem zrobić?
Traktuj wskaźnik AI jako jeden sygnał, a nie wyrok. Pisząc, wybieraj język, w którym myślisz najlepiej, zadbaj o poprawność edycji, humanizuj swój własny draft, by zmniejszyć ryzyko fałszywej flagi, i dołącz jasne ujawnienie użycia AI. Jeśli flaga pojawi się mimo to, masz dowody na własny proces przygotowania treści, by ją zakwestionować.
Humanizer dopasowany do języka, który zachowuje Twoje znaczenie, terminologię i cytowania, ograniczając jednocześnie fałszywe alarmy AI, które trafiają szczególnie u uważnych autorów publikujących po hiszpańsku.

Moe jest inżynierem NLP z PhD w przetwarzaniu języka naturalnego. Jego badania obejmują lingwistykę obliczeniową, analizę tekstu i uczenie maszynowe, a następnie zostały wykorzystane bezpośrednio w modelach edycji i humanizacji stojących za ProofreaderPro. Pisze o części procesu, której większość ludzi nigdy nie widzi: o tym, jak model językowy czyta zdanie, ocenia je i decyduje, co zmienić.


