
스리랑카 연구자를 위한 영어 글쓰기 AI 휴머니저
스리랑카 연구자를 위한 AI 휴머니저입니다. 싱할라어·타밀어의 영향을 받은 영어에서 발생하는 잘못된 AI 탐지 경고(오탐)를 줄이면서, 의미와 인용문을 유지하고 정직하게 공개하세요.

스리랑카는 Nature Index에서 98위를 기록하고 있으며, 17개 국립대학, 6,064명의 연구자, 그리고 국경 안에 SCIE 색인 저널은 단 한 곳뿐입니다. 즉, 승진에 반영되는 거의 모든 논문은 영어로 된, 다른 어딘가의 저널에서 언어 장벽을 통과해야 합니다. 스리랑카 연구자를 위한 AI 휴머니저가 존재하는 이유는 단 하나입니다. 이제는 2차 언어의 신중하고 정확한 영어가 기계가 쓴 글로 오독되고 있으며, 그 결과는 실제 사람들의 실제 출판으로 직결되기 때문입니다.
문제를 간단히 말하면 이렇습니다. 스리랑카의 전체 EF 영어 능력지수 점수는 486으로, “저숙련(Low Proficiency)” 범위에 확실히 들어갑니다. 국가 인구의 약 10%가 영어에 유창합니다. 영어 학술 문장을 쓰려는 싱할라어 화자의 오류율은 54%입니다. 타밀어를 사용하는 경우에도 상황은 크게 다르지 않습니다. 그 언어에서 흔히 나타나는 패턴 때문입니다. 많은 경우, 문제는 과학 그 자체가 아닙니다. 영어가 제출물을 걸림돌로 만들고 있는 것입니다.
이제 여기에 AI 탐지기까지 더해집니다. 2차 언어 학습자가 목표로 삼도록 훈련받는, 평이하고 표준적이며 예측 가능한 영어로 글을 쓰면, 탐지기는 당신의 진짜 사람 글(사람이 쓴 문단)을 기계가 생성한 것으로 표시할 수 있습니다. 이 가이드는 그 이유가 무엇인지, 싱할라어·타밀어와 어떻게 맞물리는지, 그리고 무엇도 숨기지 않으면서 자신의 AI 보조 초안을 어떻게 ‘휴머니즈’할 수 있는지 설명합니다.
ශ්රී ලාංකික පර්යේෂකයන් සඳහා AI පෙළ මානවකරණය
AI පෙළ මානවකරණය ශ්රී ලාංකික පර්යේෂකයන්ට තම පර්යේෂණ ඉංග්රීසියෙන් ප්රකාශයට පත් කිරීමට උපකාර කරයි.
쉬운 말로: 우리의 text humanizer는 스리랑카 전역의 연구자들이, 자신의 연구 결과를 바꾸지 않고(발견·용어·인용문을 변경하지 않고) 싱할라어의 영향 또는 타밀어의 영향이 반영된 학술 문장을 자연스러운 영어로 바꾸도록 돕습니다. 문장 리듬과 단어 선택이 달라지면서, 신중한 비원어민 글쓰기는 기계 출력물로 오독될 가능성이 줄어듭니다.
이 점은 특히 타밀어 매체로 연구해 온 연구자들에게도 똑같이 중요합니다. 예컨대 ‘자프나 대학교’처럼 타밀에서 영어 출판으로 이동하는 연구자들입니다. 두 공동체는 동일한 ‘벽’을 만나며, 동일한 워크플로의 이점을 누릴 수 있습니다. 즉, 글을 쓰고, 교정한 뒤, 자신의 초안을 휴머니즈하고, 그리고 공개(disclose)하는 것입니다.
싱할라 또는 타밀어로 초안을 작성하나요? 휴머나이저가 이를 감지하고 처리합니다
모든 초안이 영어로 시작되는 것은 아니며, 휴머니저도 영어를 요구하지 않습니다. 싱할라어 텍스트를 붙여 넣으면 ProofreaderPro가 스크립트를 스스로 인식하고, 그런 다음 용어와 인용문을 작성 그대로 정확히 유지하는 언어 인식 모델로 전달합니다. AI පෙළ මානවකරණය는 당신의 싱할라어 문장을 직접 다시 써 주기 때문에, 번역 후가 아니라 번역 전에 휴머니즈할 수 있습니다. 동일한 탐지는 60개가 넘는 언어를 포괄하므로, 타밀어 초안도 마찬가지로 손쉽게 인식되고 휴머니즈됩니다.
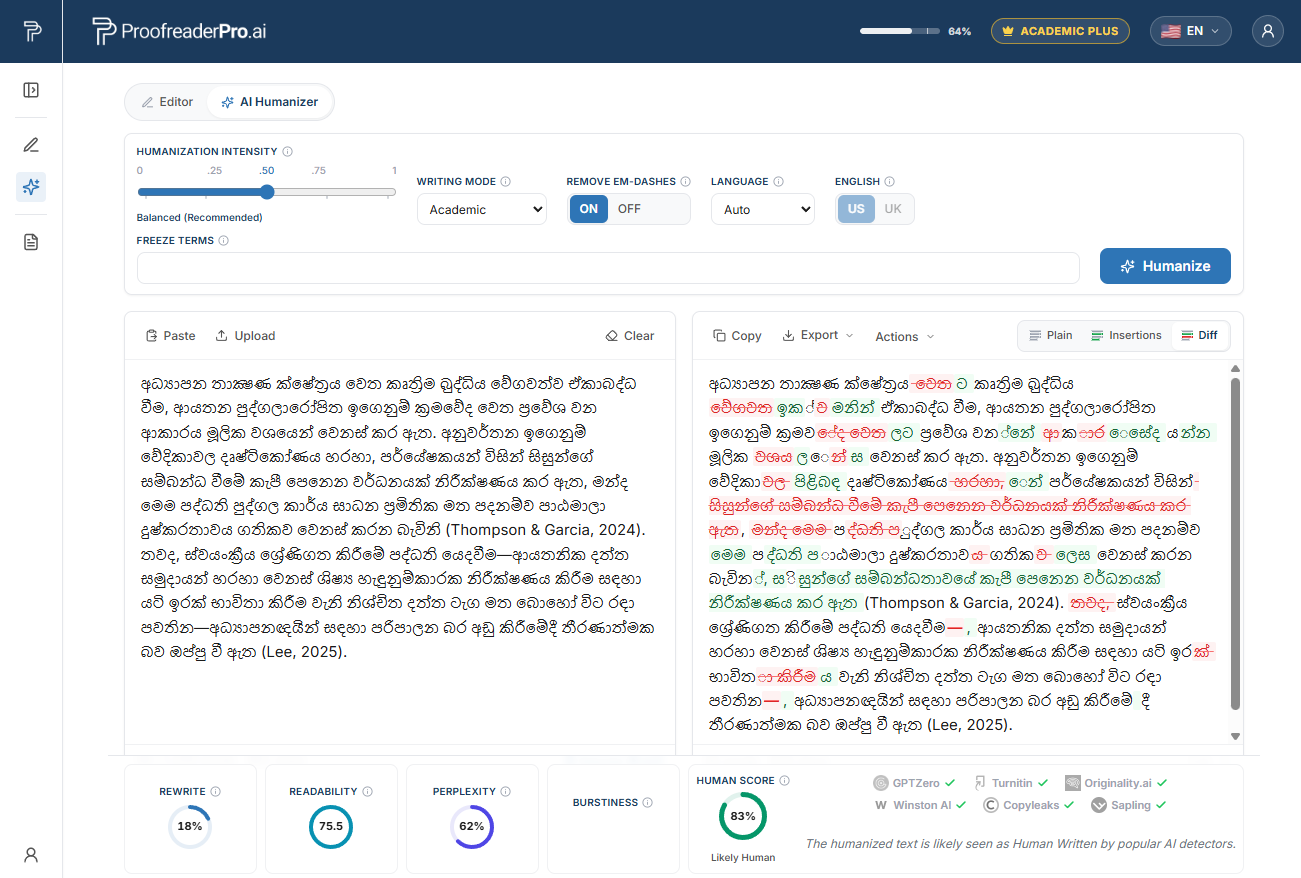
ProofreaderPro AI Humanizer가 싱할라어 학술 텍스트를 다시 쓰는 모습입니다. 전후 diff는 의미와 인용문을 유지하며, 탐지기 확인이 자연스럽고 사람답게 읽히는지 확인해 줍니다.
Why Sri Lankan researchers get flagged by AI detectors
2023년, 스탠퍼드 팀의 Liang과 동료들은 Cell Press 저널 Patterns에 ‘GPT detectors are biased against non-native English writers’라는 제목의 연구를 발표했습니다. 이들은 사람이 쓴 TOEFL 에세이를 일곱 가지 널리 사용되는 AI 탐지기에 넣었습니다. 평균적으로 비원어민 에세이의 약 61%가 AI로 표시된 반면, 원어민 에세이는 약 5%에 그쳤습니다. 비원어민 에세이 가운데 약 5분의 1(약 19.8%)은 모든 탐지기에 의해 만장일치로 표시되었습니다. 모든 에세이는 사람이 작성했습니다.
그 메커니즘은 불공정을 설명합니다. 많은 탐지기는 “퍼플렉서티(perplexity)” 점수를 매기는데, 이는 각 단어 선택이 언어 모델에 얼마나 ‘놀라운지’를 나타내는 지표입니다. 신중한 2차 언어 작가들은 흔한 단어와 표준적이고 예측 가능한 표현을 사용합니다. 그러면 퍼플렉서티가 낮아지고, 탐지기는 이를 기계 텍스트로 읽습니다. 스리랑카 학술 문장이 명확하고 정확해지는 습관은, 이런 도구들이 처벌하도록 훈련된 바로 그 습관입니다.
왜 AI 탐지기는 비원어민 작가를 플래그하는가에서 전체 메커니즘을 확인할 수 있습니다. 짧게 요약하면, 글에서 플래그가 뜨는 것은 종종 ‘기계가 썼는지’가 아니라 당신의 영어 숙련도에 관한 진술일 때가 많다는 뜻입니다.
오탐의 배경에 있는 싱할라 및 타밀어 모어 패턴
2차 언어 영어가 퍼플렉서티가 낮게 읽히게 만드는 요소들은 실수가 아닙니다. 그것들은 올바르고, 신중하며, 표준적인 구성입니다. 더 열심히 다듬을수록 글은 더 관습적으로 변하며, ‘관습적’이라는 사실이야말로 퍼플렉서티 기반 탐지기가 의심스러운 신호로 취급하는 지점입니다.
Article omission. 싱할라어와 타밀어에는 영어와 동등한 관사(article) 체계가 없습니다. 두 언어 어느 쪽에서도 “the,” “a,” “an”의 직접적인 번역이 없으며, 관사 누락은 스리랑카 학술 글쓰기에서 관사 관련 오류의 약 51%를 차지합니다. 예를 들어 “Result showed that method was effective”를 “The result showed that the method was effective”로 고친 저자는 완벽하고, 매우 표준적인 문장을 만든 것입니다. 그 표준성이야말로 퍼플렉서티가 낮게 점수화되는 이유입니다.
Copula and be-verb dropping. 두 언어 모두 공통적으로 연결동사(copula)를 생략합니다. 싱할라어에서 “Oya lassanai”는 “is”가 없이도 “She is beautiful”을 뜻합니다. 타밀어에서는 “Avan periyavan”이 “is” 없이 “He is big”을 의미합니다. 이렇게 쓰면 “The result significant at p < 0.05.”처럼 문장으로 드러납니다. 이를 “The result was significant at p < 0.05.”로 바로잡으면, 문장은 탐지기가 모델에서 기대하는 바로 그 교과서적이고 관습적인 영어가 됩니다.
Tense from simpler systems. 타밀어는 영어의 12개 시제-상 결합에 비해 3개의 시제를 사용하고, 싱할라어는 더 풍부하긴 하지만 영어의 완료(perfect)와 진행(progressive) 형태가 여전히 부족합니다. 그래서 “We collected samples since 2019”는 수정된 “We have collected samples since 2019.”로 바뀝니다. 저널 표준에 맞춘 시제 사용은 매우 예측 가능하며, 예측 가능한 문체가 바로 탐지기에 의해 표시됩니다.
Prepositions from postpositions. 싱할라어와 타밀어는 표지(전치사 역할)를 명사 뒤에 둡니다. 싱할라어의 “mese uda”는 문자 그대로 “table on(테이블 위에)”이고, 타밀어의 “mesei mel”도 같은 방식입니다. 그러면 영어가 원하는 “on the table”이 아니라 “in the table”이 만들어지곤 합니다. 올바른 전치사를 익혀 일관되게 적용하면, 가능한 한 가장 표준적인 영어를 만들어 다시금 퍼플렉서티가 낮아집니다.
Pronoun and register patterns. 싱할라어는 엄격한 he, she, it 체계가 아니라 사회적 언어 수준(register)에 따라 대명사를 선택하고, 타밀어는 성별을 반영한 형태와 함께 성중립적인 공식 대명사(“avar”)를 사용합니다. 이를 올바른 영어 대명사로 일관되게 고치면 매끄럽고 관습적인 문장이 됩니다. 이 모든 것은 편법이 아닙니다. 탐지기가 기계 글과 구분하지 못할 만큼 정교한 2차 언어 글쓰기이기 때문입니다.
Sri Lanka's AI-detection and Turnitin context
스리랑카에서 학위논문과 저널 투고 원고는 텍스트 유사도 검사를 위해 흔히 Turnitin 또는 iThenticate로 선별되며, 이제 이 도구들은 유사도 점수와 함께 AI 지표도 함께 노출합니다. UGC 승진 기준 하에서는 진로가 색인된 출판과 연결되므로, 스리랑카 연구자가 수개월간 작업해 온 원고가 단 한 번의 오독 플래그로 멈출 수 있습니다.
도구 자체가 논쟁적이라는 점도 아는 것이 도움이 됩니다. Vanderbilt는 2023년에 비원어민 작가에 대한 편향과 오탐을 이유로 Turnitin의 AI 탐지기를 비활성화했고, Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, Waterloo도 유사한 조치를 취했습니다. Turnitin은 1~19% 범위의 점수를 억제해 숫자 대신 별표를 표시하며, 점수가 단독으로 무결성(integrity) 사건의 판단에 사용되어서는 안 된다고 경고합니다.
핵심은 실용적입니다. 탐지기 점수는 ‘수용해야 하는 판결’이 아니라 ‘이의를 제기할 수 있는 주장’입니다. 저널과 연구기금은 점점 더 AI 사용 공개를 요구하고 있으며, 올바른 대응은 사용한 도구를 숨기는 것이 아니라, 솔직하게 글을 쓰고 명확히 공개하는 것입니다.
세심한 영어를 잘못된 플래그로부터 보호하세요
싱할라의 영향 또는 타밀의 영향이 반영된 영어로 된, 본인의 AI 보조 원고를 사람답게 다듬으세요. 의미, 용어, 인용문을 그대로 유지한 뒤, 저널에서 요구하는 방식대로 AI 사용을 공개하십시오.
Humanizer를 무료로 사용해 보세요Top Sri Lanka universities and where AI checks appear
스리랑카의 17개 국립대학은 모두 UGC 승진 기준 하에서 운영되며, 색인된 출판을 요구하고, 모든 학위논문과 원고는 발송 전에 유사도 및 AI 지표를 확인합니다:
- University of Colombo, Colombo. 대부분의 지표에서 선두를 달리고, 해당 국가에서 Scopus 색인 출판물의 최대 생산처인 대학.
- University of Peradeniya, Peradeniya, Kandy. 스리랑카 최대 캠퍼스이며 농업, 과학, 공학, 수의학 분야가 강점.
- University of Moratuwa, Moratuwa. 최고의 공과대학으로, 토목공학, 컴퓨터과학, 건축에서 선도.
- University of Kelaniya, Kelaniya. 인문학, 사회과학, 과학, 상학(커머스)이 강하며 보건과학 분야의 산출도 성장 중.
- University of Jaffna, Jaffna. 북부주에서 가장 선도적인 대학으로, 영어 출판으로 이동하는 타밀어 매체 연구자들에게 특히 의미가 큽니다.
- University of Sri Jayewardenepura, Nugegoda. 경영, 응용과학, 의학 분야가 강점.
- University of Ruhuna, Matara. 남부주에서 가장 선도적인 대학으로, 농업, 수산, 공학, 의학 분야가 강점.
- University of Rajarata, Mihintale. 농업, 사회과학, 기술에 초점을 두며, 전통유산 및 환경학 분야 연구도 확대되고 있습니다.
- Sabaragamuwa University of Sri Lanka, Belihuloya. 식품과학, 농업, 지리정보(geomatics) 분야가 강점.
- Wayamba University of Sri Lanka, Makandura and Kuliyapitiya. 농업과 기술에 특화되어 있으며, 식품기술과 생명공학에서 특히 주목할 만한 성과가 있습니다.
- Uva Wellassa University, Badulla. 과학과 기술에 집중하며, 동물과학과 컴퓨팅 연구도 성장 중.
- Open University of Sri Lanka, Nawala. 이 나라의 원격 교육 기관으로, 연구 경력을 추구하는 재직 전문가들에게 서비스를 제공합니다.
국가 단위로 활동 연구자가 6,064명뿐인 만큼 언어 지원에 대한 수요는 높고, 그들 거의 모두가 신중한 비원어민 문체가 오탐으로 표시되는 일을 막아야 합니다.
스리랑카 연구자를 위한 AI 휴머나이저는 어떻게 작동하나요
여기 워크플로가 있습니다. 먼저 논증을 초안으로 작성하되, 추론이 가장 자연스럽게 흐르는 곳이 있다면 싱할라어 또는 타밀어로 선택적으로 작성할 수 있습니다. 문법을 교정하여 위에서 언급한 관사, 연결동사, 시제, 전치사 패턴이 수정되도록 합니다. 그런 다음, 자신의 AI 보조 초안을 우리 text humanizer에 실행해 넣으면, 신중하고 표준화된 문장이 자연스러운 ‘사람의 리듬’으로 다시 돌아가며 오독될 가능성이 줄어듭니다. 당신의 의미, 용어, 인용문은 그대로 유지됩니다.
우리는 결과에 대해 구체적입니다. 과장된 홍보(hype)가 아니라, 당신이 정직함을 누릴 자격이 있기 때문입니다. 주요 탐지기에 대해 테스트한 결과, 휴머니저는 AI 텍스트를 더 자연스러운 사람의 형태로 다시 써서 AI 신호를 낮추고, 까다로운 탐지기들에 대한 대응 가능성을 개선합니다. 동시에 학술 텍스트에서 문법 정확도는 높은 수준으로 유지됩니다. 이는 보장이 아니라 테스트 결과입니다. 탐지기는 몇 달마다 재학습하므로, 어떤 신뢰할 만한 도구도 100% 탐지 불가 또는 체크기를 영구적으로 우회할 수 있다고 약속할 수 없습니다.
그리고 당신을 안전하게 하는 단계가 이어집니다. 바로 공개(disclose)입니다. 소속 기관과 목표 저널이 요구하는 형식에 맞춰 AI 사용을 명시하세요. 잘못된 플래그로부터 글을 보호하기 위해 자신의 글을 휴머니즈한 뒤, AI 보조를 사용했다고 공개하는 것은 숨기는 것과 정반대입니다. 그것은 실제 작업에 대한 공정성입니다. 만약 먼저 문법과 구조가 먼저 바로잡혀야 한다면, 스리랑카 연구자를 위한 학술 편집 가이드에서 그 측면을 다루며, 이 게시물은 동일한 워크플로를 여러 언어로 다루는 다국어 AI 휴머니저 허브 안에 포함되어 있습니다.
Local funding bodies, journals, and AI-disclosure expectations
스리랑카의 주요 지원기관은 자금을 ‘출판 성과’에 연결합니다. **National Science Foundation (NSF)**는 Competitive Research Grants에 자금을 지원하며, 갱신 평가는 국제적으로 인정된 저널에 출판된 실적을 바탕으로 평가합니다. **National Research Council (NRC)**은 5년 동안 최대 Rs 50 million 규모의 보조금을 제공하며, 이에 비례한 출판 기대치가 함께 적용됩니다. **University Grants Commission (UGC)**는 승진을 위해 저널 논문에서 최소 12점을 요구하고, 선임 직책에는 5편의 우수 논문이 필요하며, 가장 높은 점수는 SCIE, SSCI, Scopus 색인 저널에 부여합니다.
국내 저널 생태계는 규모가 작습니다. **Journal of the National Science Foundation of Sri Lanka (JNSF)**는 이 나라의 유일한 SCIE 색인 저널로, 14년 연속 해당 색인을 유지하고 있습니다. 그와 함께 Ceylon Journal of Science(남아시아에서 가장 오래된 과학 저널 중 하나), Ceylon Medical Journal(스리랑카 의학협회가 1887년부터 발간), Sri Lanka Journal of Social Sciences, Journal of the Rubber Research Institute of Sri Lanka, 그리고 Tropical Agricultural Research(Peradeniya의 농업 대학원 연구소에서 발간)가 있습니다. **SLJOL (Sri Lanka Journals Online)**은 오픈액세스를 위한 172개의 국내 저널을 호스팅합니다.
대부분의 높은 비중을 가진 저널이 영어로 출판되고 국외에 위치하기 때문에, 대부분의 커리어는 국제 투고에 달려 있으며, 그 과정에서 편집자들은 점점 더 AI 사용 공개 성명서를 요구하는 추세입니다. 공개문은 명확하게 작성하고 정확성을 유지하되, 만약 부당하게 플래그가 뜬다면 이를 ‘수용할 판결’이 아니라 ‘답변할 수 있는 주장’으로 다루세요. AI disclosure statement 원고 작성법과 허위 AI 탐지 플래그에 항소하는 방법에 관한 가이드가 두 경우 모두를 다룹니다.
Frequently asked questions
Q: Is an AI humanizer for Sri Lankan researchers a way to cheat Turnitin?
아니요. 올바른 사용은 AI 보조 초안을 ‘휴머니즈’해서, 싱할라어 또는 타밀어의 영향을 받은 영어가 기계 텍스트로 오독되지 않도록 하는 것입니다. 동시에 의미와 인용문은 당신이 작성한 그대로 정확히 유지됩니다. 그리고 AI 사용은 저널이 요구하는 형식에 따라 공개하므로, 무결성(integrity) 규정의 범위 안에 머물게 됩니다. 이는 무엇이든 숨기는 것과 정반대입니다.
Q: Why do AI detectors flag my writing when I wrote every word myself?
많은 탐지기가 퍼플렉서티(perplexity), 즉 단어 선택이 얼마나 예측 가능한지에 해당하는 지표를 점수화하기 때문입니다. 신중한 2차 언어 작가들은 흔한 단어와 표준적인 표현을 사용하며, 이는 낮은 퍼플렉서티를 만들어 기계 출력물로 읽히게 됩니다. 2023년 스탠퍼드 연구에 따르면 사람이 쓴 비원어민 에세이의 약 61%가 AI로 표시된 반면, 원어민 작가의 경우는 약 5% 수준이었습니다. 즉, 이 패턴은 문서화되어 있으며 당신의 잘못이 아닙니다.
Q: Does the humanizer work for Sinhala and Tamil influenced English?
네. 언어 인식 기능이 있고 60개가 넘는 언어를 지원하므로, 싱할라어와 타밀어 화자가 영어로 옮길 때 함께 가져오는 관사 누락, 연결동사 생략, 시제 단순화, 그리고 후치사(postposition)에서 전치사로 이어지는 패턴을 인식합니다. 리듬과 단어 선택은 조정하되, 기술 용어, 결과, 참고문헌은 그대로 보존합니다.
Q: Can you guarantee my paper will pass every AI detector?
아니요. 이를 보장한다고 말하는 어떤 도구든 믿지 않는 편이 좋습니다. 주요 탐지기에 대해 테스트했을 때, 우리의 휴머니저는 AI 텍스트를 더 자연스러운 사람의 형태로 다시 써서 AI 신호를 낮추고, 까다로운 탐지기에 대한 대응 가능성을 개선합니다. 동시에 문법 정확도도 높은 수준으로 유지됩니다. 다만 이는 몇 달마다 탐지기가 재학습하기 때문에 ‘보장’이 아니라 테스트 결과입니다.
Q: Will humanizing change my citations or my results?
아니요. 휴머니저는 의미, 기술 용어, 인용문을 APA, MLA, Chicago, IEEE에서 그대로 보존합니다. 또한 리듬과 문장 표현을 조정하고 반복적인 어조와 불필요한 긴 대시(em dash)를 제거하므로, 당신이 보고한 과학 내용은 동일하게 유지되면서 문장은 자연스럽게 읽히게 됩니다.
스리랑카 연구자분들을 위한 언어 인식 AI 텍스트 휴머니저입니다. 의미, 용어, 인용문을 그대로 보존하면서, 싱할라와 타밀의 영향을 받은 영어가 자연스럽고 공정하게 읽히도록 돕습니다.

Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.


