
AI शोध-पत्रों, थीसिस और डिसर्टेशन को मानवीय (Humanize) कैसे बनाएं
बिना किसी उद्धरण को तोड़े या किसी परिणाम को बदले, AI शोध-पत्र, थीसिस या डिसर्टेशन को मानवीय बनाइए। शोधकर्ताओं के लिए एक खंड-दर-खंड (section-by-section) पद्धति। इसे निःशुल्क आज़माएँ।

आपने अपने पेपर के कुछ हिस्से ड्राफ्ट करने में AI का इस्तेमाल किया होगा। हो सकता है कि इससे एक ढीला-सा methods वाला पैराग्राफ कसा हुआ लगने लगा हो, या आपके बुलेट-पॉइंट परिणाम बहते हुए वाक्यों में बदल गए हों, या फिर आपने चर्चा (discussion) के लिए एक शुरुआती ड्राफ्ट पा लिया हो जब आप खाली पेज घूर रहे थे। यह काम करने का वैध तरीका है, और अब अधिकांश जर्नल इसे disclosing (खुलासा) के साथ स्वीकार करते हैं।
किसी AI-समर्थित शोध-पत्र को मानवीय बनाने का अर्थ है, जिस ड्राफ्ट को बनाने में AI ने मदद की है, उसे फिर से पूरी तरह अपना बनाना। यह धोखाधड़ी छुपाने या किसी “मैजिक डिटेक्टर” स्कोर का लक्ष्य रखने के बारे में नहीं है। यह, सबसे पहले, वही आवाज़ (voice), टोन (tone), और वह सावधानी (care) वापस जोड़ने की बात है जो आपने पेपर में शुरुआत से लानी चाही थी, और यह सब सही जगहों पर सभी उद्धरण (citations) और तकनीकी शब्द (technical terms) के साथ होना चाहिए। सही ढंग से किया जाए तो यह आपकी पेपर को वास्तव में मजबूत बनाएगा (सिर्फ डिटेक्टर से कम “शोर” वाला नहीं),
यह सुनने में जितना आसान लगता है उतना नहीं, क्योंकि शोध-पत्र एक लापरवाह री-राइट के लिए सबसे खराब जगह है। एक शब्द बदल जाना, या किसी उद्धरण को हटा कर किसी और जगह बैठा देना, आपके साक्ष्य (evidence) जो दावा करते हैं, उसे बदल सकता है। पद्धति (method) मायने रखती है। नीचे बताया गया है कि हम इसे कैसे करते हैं, हर खंड (section) के हिसाब से, और हर चरण में अर्थ (meaning) व जिम्मेदारी (attribution) सुरक्षित रहती है।
ProofreaderPro आपकी शोध-लेखन को कैसे मानवीय बनाता है
मॉडल से सीधे निकला अकादमिक गद्य अक्सर स्मूद और समान रूप से वज़नी (evenly weighted) पढ़ता है, वह सपाट रजिस्टर जिसे रिव्यूअर जल्दी पहचान लेते हैं। ProofreaderPro का Academic मोड किसी पेपर के हर खंड के अनुसार काम करता है: वह framing और rhythm को रीवर्क करता है ताकि लेखन टेम्पलेट की तरह नहीं, बल्कि शोधकर्ता (researcher) की तरह लगे। यह वाक्य की लंबाई (sentence length) में बदलाव लाता है, उस अत्यधिक आत्मविश्वासी phrasing को नरम करता है जिसकी ओर मॉडल अक्सर चला जाता है, और सावधानी भरे hedging (जैसे "suggests," "is associated with") को बहाल करने पर काम करता है, जो सामान्यतः generic drafts में जाकर झूठी निश्चितता (false certainty) में बदलने लगती है।
हालाँकि यह wording और संरचना (structure) बदलता है, इसे इस तरह डिज़ाइन किया गया है कि पेपर के वे हिस्से सुरक्षित रहें जिन पर पेपर निर्भर करता है। लक्ष्य यह है कि आपके citations, संख्याएँ (numbers), सांख्यिकीय शब्द (statistical terms) और परिणाम (results) वैसे ही रहें जैसे आप ने लिखे थे, ताकि अर्थ वही रहे, जबकि phrasing अधिक स्वाभाविक (natural) हो जाए। जो आपको वापस मिलता है, वह उस anonymous रजिस्टर से अधिक आपके अपने scholarly voice के करीब होता है, जिस पर मॉडल डिफॉल्ट कर देता है।
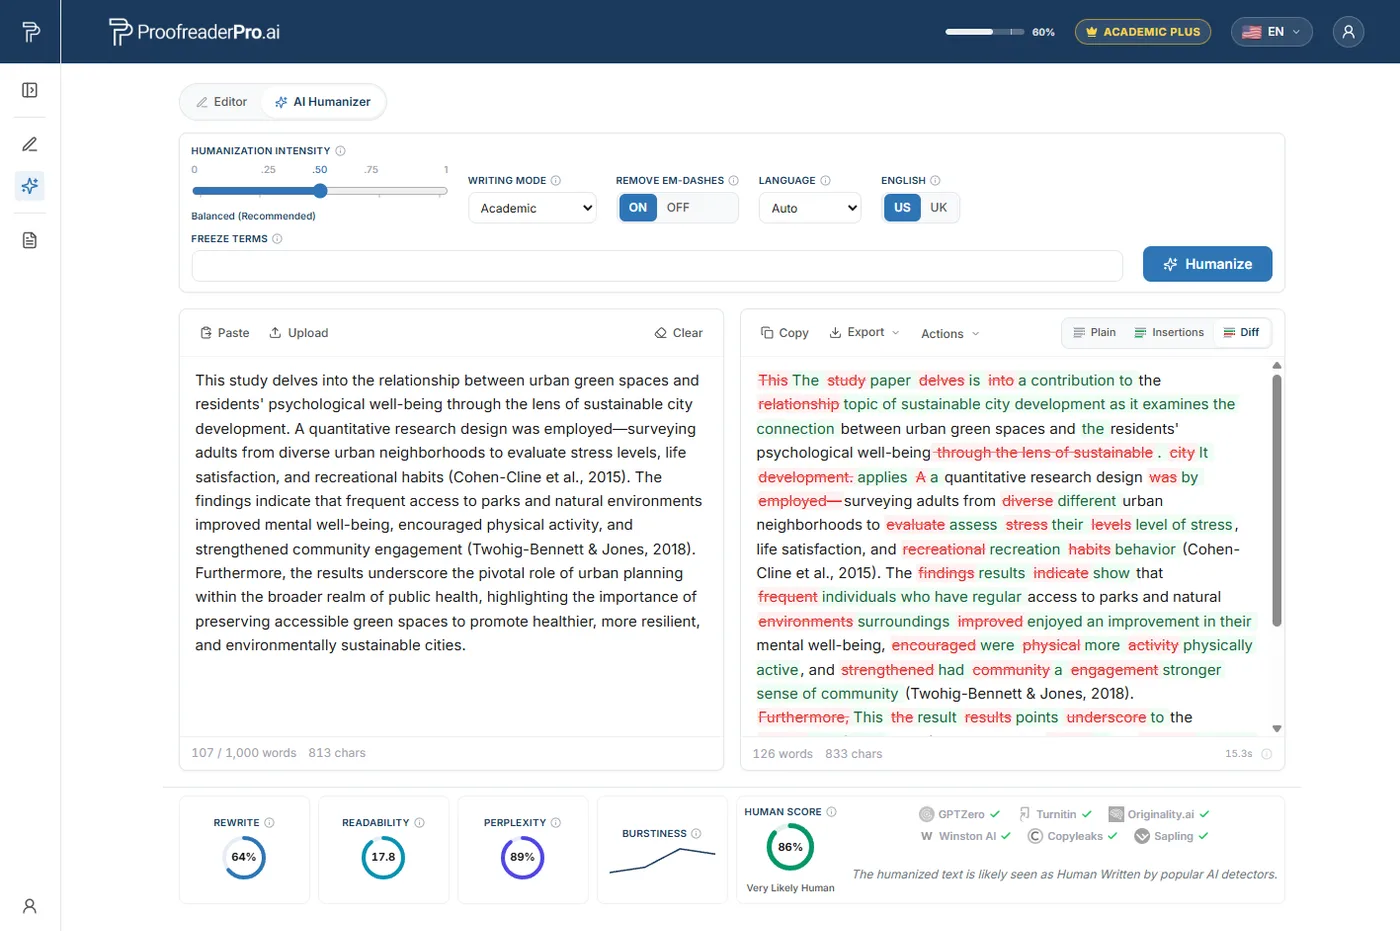
AI शोध-पत्र को मानवीय (humanize) बनाने का अर्थ क्या है
AI मॉडल एक पहचाने जाने योग्य ढंग से लिखते हैं। वाक्य स्मूद और समान वज़न वाले होते हैं, शब्दावली (vocabulary) सामान्य (generic) होती है, और rhythm लाइन-दर-लाइन मुश्किल से बदलता है। डिटेक्टर इसे कम burstiness और कम perplexity कहते हैं, लेकिन आपको इन शब्दों (jargon) की ज़रूरत नहीं, आप इसे सपाट (flat) होने की तरह महसूस कर लेते हैं।
मानवीय बनाना इस सपाटपन को इस तरह ठीक करता है कि आपके निर्णय (judgment) फिर से गद्य (prose) में आ जाएँ। इसका मतलब है कि argument के लिए जो emphasis ज़रूरी है उसे जोड़ना, जहाँ मॉडल ने एक neutral summary लिख दी थी। इसका मतलब यह भी है कि दावे (claim) को उस सीमा तक कैलिब्रेट करना, जहाँ मॉडल ने बहुत कम या बहुत ज़्यादा hedging कर दी है और आपके डेटा (data) सच में जितना सपोर्ट करते हैं, उतना ही रखा जाए। लक्ष्य ऐसा लेखन है जो लगे कि किसी सावधानी बरतने वाले शोधकर्ता ने इसे सोचा-समझा है, क्योंकि आपने किया।
मानवीय बनाना कभी भी आपके निष्कर्षों (findings) को बदलना नहीं चाहिए। ऐसा री-राइट जो p-value बदल दे, किसी limitation को नरम कर दे, या किसी प्रभाव (effect) को बढ़ा-चढ़ा कर पेश करे, आपकी मदद नहीं करता; वह वैज्ञानिक रिकॉर्ड (scientific record) में एक त्रुटि जोड़ देता है। यही वह रेखा है जो एक अकादमिक humanizer और एक सामान्य (generic) humanizer को अलग करती है। हमारा text humanizer citations, statistics और technical terms को protected तत्वों की तरह मानता है, इसलिए आपके साक्ष्य (evidence) के आसपास की भाषा बदलती है, पर साक्ष्य स्वयं नहीं।
एक और कारण: non-native English writers को native speakers की तुलना में कहीं अधिक flagged किया जाता है। 2023 में जर्नल Patterns में प्रकाशित एक अध्ययन में शोधकर्ताओं ने गैर-मातृभाषी और मातृभाषी अंग्रेज़ी लेखकों द्वारा लिखे गए ऐसे निबंधों (essays) का परीक्षण किया, जिन्होंने एक standardized English proficiency test दिया था। उन्होंने पाया कि सात डिटेक्टर लगभग 61 प्रतिशत non-native English test essays को AI के रूप में flag करते हैं (और native writers के लिए लगभग 5 प्रतिशत), लेकिन यह मुख्यतः इसलिए था कि सरल शब्दावली (simple vocabulary) को अत्यधिक predictable माना गया। यदि अंग्रेज़ी आपकी दूसरी भाषा (second language) है, तो अपने लेखन को आत्मविश्वासी, स्वाभाविक गद्य में मानवीय बनाना आंशिक रूप से उस bias को उलटने की प्रक्रिया है, कुछ छुपाने की नहीं।
चरण 1: खंड-दर-खंड काम करें
पूरा manuscript एक साथ paste न करें। पेपर के हर हिस्से की voice अलग होती है, और एक अच्छा री-राइट उसका सम्मान करता है। आपकी methods सटीक और impersonal बनी रहनी चाहिए। आपकी discussion में interpretation और argument अधिक जगह पा सकते हैं। सब कुछ एक ही ब्लॉक में feed कर देने से ये भिन्नताएँ सपाट (flatten) हो जाती हैं।
methods से शुरू करें। यहीं generic humanizers सबसे अधिक नुकसान करते हैं, क्योंकि वे instrument names, reagents और statistical tests को ऐसे सामान्य शब्दों की तरह ट्रीट करते हैं जिनका “बदलाव” किया जा सके। स्पष्टता (clarity) और flow के लिए री-राइट करें, लेकिन हर प्रक्रिया (procedure) को verbatim रखें। अगर draft में "multicollinearity" लिखा है, तो उसे "multiple connections" नहीं बनाना चाहिए।
फिर results। यहाँ संख्याएँ (numbers), इकाइयाँ (units), और प्रभाव (effect) की दिशाएँ (directions) पवित्र (sacred) हैं। उन framing वाक्यों को मानवीय बनाइए जो आपके निष्कर्षों (findings) को प्रस्तुत और जोड़ते हैं, और report किए गए मानों (reported values) को बिल्कुल न छेड़ें। हर re-written वाक्य को अपनी data तालिका (data table) के सामने पढ़कर पुष्टि करें कि कुछ भी “drift” न हो गया हो।
परिचय (introduction) और discussion के साथ समाप्त करें। इन खंडों में आपकी voice सबसे अधिक होती है, इसलिए मानवीय बनाना यहाँ सबसे अधिक फ़ायदेमंद है। यही वह जगह है जहाँ आप argue करते हैं, contextualize करते हैं, और hedge करते हैं, और जहाँ flat AI phrasing रिव्यूअर को सबसे साफ दिखाई देती है।
चरण 2: citations और तकनीकी शब्दों को सुरक्षित रखें
ऑटोमेटेड री-राइट में citations सबसे आम रूप से सबसे पहले प्रभावित होते हैं।
Generic humanizers एक citation जैसे "(Smith et al., 2024)" को किसी ऐसे टेक्स्ट के रूप में देखते हैं जिसे किसी न किसी तरह बिगाड़ा जा सकता है, चाहे उसे reformat करना हो, गलत clause में ले जाना हो, या साल (year) भूल जाना हो। अस्सी (eighty) in-text citations वाले पेपर में यह काम घंटे ले सकता है और गलत व्यक्ति को श्रेय (credit) दे देने का वास्तविक जोखिम बनता है। citations रखना कोई कला-परियोजना (art project) नहीं है। यह उस maze में पाठक को मार्गदर्शन देने का तरीका है, उन बयानों (statements) के लिए जो आपने किए हैं और उनके लिए प्रस्तुत evidence के लिए।
री-राइट से पहले अपनी terminology को “freeze” करें। उन terms की एक छोटी सूची बनाइए जिन्हें बदलना नहीं चाहिए: आपके key variables, आपकी methods, और आपका discipline-specific vocabulary। एक अकादमिक-स्तर (academic-grade) टूल APA, MLA, Chicago, IEEE, और Turabian जैसे citation styles को पहचानता है और उन्हें स्वचालित रूप से जगह पर बनाए रखता है, यही वह कारण है कि हमने citation protection को humanizer that preserves citations में अंतर्निहित किया, बजाय इसके कि बाद में जोड़कर काम चलाया जाए।
हर पास के बाद सत्यापित करें। कभी-कभी सावधान टूल भी किसी ऐसे term को बदलकर दे सकते हैं जिसे छोड़ देना चाहिए था। अपने citations को reference list से मिलाकर देखें और पुष्टि करें कि आपके key terms बच गए। tracked-changes वाला दृश्य इसे तेज़ बनाता है, क्योंकि आप साफ देखते हैं कि क्या-क्या बदला और आप अपनी पसंद से इतर किसी भी चीज़ को अस्वीकार कर सकते हैं।
चरण 3: hedging, voice और disclosure को वापस लाएँ
अच्छा शोध-लेखन hedges करता है। वह "these results suggest" कहता है, न कि "these results prove,", और यह calibration आपकी credibility का हिस्सा है। AI drafts अक्सर hedging को या तो झूठे आत्मविश्वास (false confidence) में समतल (flatten) कर देते हैं, या फिर उसे अस्पष्ट (vague) गूंध (mush) में बदल देते हैं। इसलिए उसे वापस लाना उन सबसे मूल्यवान edits में से है जो आप कर सकते हैं।
अपने re-written हिस्सों को ज़ोर से पढ़िए। जहाँ कोई दावा आपके साक्ष्य से ज़्यादा मज़बूत लगे, उसे पीछे खींचिए। जहाँ आपने अपनी वास्तविक contribution को बहुत सावधानी से “गला साफ़” करते-करते दबा दिया है, उसे और धार (sharpen) दीजिए। यह वह हिस्सा है जिसे कोई टूल आपके लिए नहीं कर सकता, क्योंकि सिर्फ आपको पता है कि अध्ययन क्या-क्या दावा कर सकता है और क्या नहीं।
फिर disclosure। अब अधिकांश विश्वविद्यालय और जर्नल (Elsevier और Springer सहित) यह AI-use statement की अपेक्षा करते हैं, यदि आपने टेक्स्ट ड्राफ्ट करने में AI से मदद ली है। Disclosure गलत काम स्वीकारने (admission of wrongdoing) नहीं है, यह वही चीज़ है जो पूरे workflow को वैध बनाती है। अपने द्वारा बनाए गए helped draft को मानवीय बनाना और सहायता का खुलासा करना वास्तविक scholarship है। इसे छुपाना नहीं, चाहे स्कोर कितना भी कम क्यों न हो।
यह भी ज़रूरी है कि आप स्पष्ट रहें कि humanizers क्या कर सकते हैं और क्या नहीं। वे भरोसेमंद ढंग से कमजोर, रोबोटिक phrasing को सुधारते हैं और वास्तविक लेखन पर false positives कम करते हैं। लेकिन वे किसी विशिष्ट detector परिणाम की गारंटी नहीं दे सकते, क्योंकि डिटेक्टर लगातार बदलते रहते हैं और सबसे मजबूत डिटेक्टर मशीन-रीलिखे टेक्स्ट को बढ़ती हुई दर से पकड़ रहे हैं। ऐसे पेपर का लक्ष्य रखें जिसे आप बचाव (defend) करने में सहज हों, किसी डैशबोर्ड पर मौजूद संख्या (number) के पीछे नहीं।
बिना किसी संदर्भ को तोड़े, शोध लेखन को मानवीय बनाएं
एक अकादमिक-स्तर का मानववीकरण टूल, जो आपकी उद्धृतियां, सांख्यिकी, और शब्दावली को सुरक्षित रखते हुए आपकी शैली को परिष्कृत करता है। पाँच डिटेक्टरों के विरुद्ध परीक्षण किया गया, और ट्रैक्ड-चेंजेज समीक्षा के साथ उपलब्ध।
ProofreaderPro.ai को निःशुल्क आज़माएँकिसी पेपर का कितना हिस्सा humanize करना चाहिए?
केवल वे हिस्से जिन्हें AI ने वास्तव में लिखा है।
अगर आपने अपनी methods खुद लिखीं और केवल discussion को smoothe करने के लिए AI का इस्तेमाल किया, तो discussion को humanize कीजिए और अपने खुद के गद्य (prose) को वैसे ही रहने दीजिए। अगर आप “साफ़” human writing को किसी भी rewriter से गुज़ारते हैं, तो उस टेक्स्ट में त्रुटियाँ आने का जोखिम रहता है।
ऐसे खंड (section) के लिए जो भारी तौर पर AI द्वारा ड्राफ्ट किया गया हो, पूरे आउटपुट को wholesale स्वीकार करने के बजाय review में वास्तविक समय देने की अपेक्षा करें। साहित्य-समीक्षा (review of the literature) जैसी citations से भरपूर synthesis में भी यही अनुशासन लागू होता है, जिसे हम humanize an AI-drafted literature review वाली गाइड में कवर करते हैं। किसी भी दस्तावेज़ (document) में सामान्य तकनीक के लिए, how to humanize AI text पर हमारी walkthrough fundamentals को कवर करती है।
सीधी बात: humanizing संपादन (editing) है, न कि सफाई करके (laundering) छुपाना। यह वैध रूप से आपकी सहायता प्राप्त ड्राफ्ट को आप जैसा बनाता है, आपके evidence को सुरक्षित रखता है, और disclosure के साथ मिलकर चलता है। यह ऐसा workflow है जिसे आप किसी भी समिति (committee) के सामने उचित ठहरा सकते हैं।
थीसिस या डिसर्टेशन को अध्याय-दर-अध्याय (chapter by chapter) humanize करना
ऊपर की हर बात में थीसिस या डिसर्टेशन का दांव (stakes) और बढ़ जाता है, क्योंकि दस्तावेज़ लंबा होता है, महीनों के अंतर से लिखे गए अध्यायों के पार voice को संगत (consistent) रखना होता है, और एक समिति उसे धीरे-धीरे पढ़ती है। अगर आपने सितंबर में किसी literature chapter को ड्राफ्ट करने के लिए AI का सहारा लिया और मार्च में discussion के लिए, तो दोनों ऐसा लग सकते हैं जैसे वे दो अलग-अलग लेखकों (authors) ने लिखे हों, और सावधान परीक्षक (examiner) ठीक वही “जुड़ाव” (seam) पकड़ता है।
इसे उसी तरह ट्रीट करें जैसे आपने पेपर को किया था, बस अधिक सावधानी से। एक समय में एक अध्याय (chapter) को humanize करें, और पूरे manuscript को single pass में किसी rewriter से न चलाएँ। आपके methods वाले अध्याय का सटीक, impersonal रजिस्टर बना रहना चाहिए। आपकी discussion और conclusion आपकी argument को लेकर चलती हैं, और वे आपकी voice के लिए सबसे ज्यादा योग्य हैं। लंबे दस्तावेज़ में असली “ट्रिक” संगति (consistency) है: तय करें कि आपकी औपचारिकता (formal) कैसी होगी, आप कितना hedge करेंगे, और आप कौन-से शब्द हमेशा इस्तेमाल करेंगे, फिर उसी मानक को पहले अध्याय से लेकर अंतिम तक बनाए रखें।
लंबाई (length) का मतलब अधिक citations भी है, और ऑटोमेटेड टूल के लिए साल (year) गिराने या किसी reference को गलत clause में ले जाने के लिए अधिक जगह भी। एक अंतिम sweep पर भरोसा करने के बजाय sections में सत्यापित करें, और review करते समय reference manager खुला रखें। शोधकर्ता, अकादमिक और PhDs के लिए इस स्तर पर अनुशासन (discipline) वही है जो पेपर में अधिक धैर्य के साथ लागू होता है: rhythm और voice बदलिए, evidence की रक्षा कीजिए, और हर अध्याय को उस चीज़ के खिलाफ पढ़िए जो आपका डेटा (data) और स्रोत (sources) सच में कहते हैं।
एक काम किया हुआ उदाहरण: एक results पैराग्राफ, humanized
Method advice पर भरोसा करना आसान होता है जब आप उसे लागू हुआ देख सकते हैं। नीचे उस तरह का एक छोटा results passage है जो AI assistant पैदा करने की प्रवृत्ति रखता है, और उसके बाद वह संस्करण है जिसे हम वास्तव में जमा करेंगे। यह passage गढ़ा गया (invented) है, लेकिन विफलता (failure) का पैटर्न बिल्कुल वही है जो हम वास्तविक ड्राफ्ट में देखते हैं।
Before (AI-typical): "The proposed model demonstrates a robust improvement in classification accuracy, achieving 94.2% across the benchmark datasets. This substantial gain underscores the effectiveness of the attention mechanism and highlights its broad applicability to real tasks. These findings confirm the superiority of the approach (Chen et al., 2024)."
After (humanized and edited): "Our model reached 94.2% classification accuracy on the benchmark datasets, the highest of the systems we compared. We think the attention mechanism drives most of that gain, though we have not isolated it fully, so we treat the result as promising rather than settled. It is consistent with Chen et al. (2024), who reported a similar pattern for attention-based models."
अब वाक्यों में बदलाव आता है। मूल पाठ तीन मध्यम (medium) clauses को एक ही समान गति (even pace) पर चलाता है, यही वह चीज़ है जिसे detectors “machine-written” समझते हुए low-variation rhythm की तरह पढ़ते हैं। संपादन (edit) एक लंबा वाक्य एक साथ एक छोटा, hedged वाक्य मिलाकर करता है। sentence-length variation में यह बढ़त वही है जिसे लोग burstiness कहते हैं; और यह perplexity भी बढ़ाता है, क्योंकि शब्द-चयन (word choices) मॉडल की डिफॉल्ट सेटिंग्स से कम predictable हैं।
hedging वापस है। "Demonstrates", "confirm the superiority", और "broad applicability" वाले दावे चार से अधिक datasets का समर्थन नहीं पा सकते। वास्तविक शोधकर्ता hedges करते हैं: "we think", "not isolated it fully", "promising rather than settled". रिव्यूअर overclaiming को किसी भी detector से तेज़ पकड़ लेता है। यह सावधानी (caution) वास्तविक है, और यह generated draft की सपाट confidence से बिल्कुल अलग दिखती है।
लोड-बेयरिंग (load-bearing) विवरण सुरक्षित रहते हैं। यहीं generic tools टूटते हैं। 94.2% संख्या को छुआ नहीं गया। citation उसी दावे से जुड़ी रहती है, लेकिन उसे narrative रूप में बदला गया है (Chen et al., 2024 को Chen et al. (2024) में), बिना साल या लेखक को गिराए। "Classification accuracy" और "attention mechanism" को उसी तरह रखा गया है, क्योंकि इन्हें near-synonyms से बदलने पर विज्ञान (science) धीरे-धीरे बदल सकता था।
यहाँ दो संकेत एक साथ बेहतर होते हैं: passage आपके जैसा पढ़ता है, और statistical texture detectors जितना “ध्वनि-सा” (texture) कम ले जाता है, उतना रहता है। यही पूरा मुद्दा है। हमने आपके बिना हर संख्या और reference की निगरानी (babysitting) किए इस trade-off को संभव बनाने के लिए ProofreaderPro.ai बनाया, लेकिन यही लॉजिक हाथ से भी काम करता है। rhythm और voice बदलिए, evidence की रक्षा कीजिए, और कभी भी किसी कम स्कोर को citation या result की कीमत न बनने दें। ऐसे ड्राफ्ट का लक्ष्य रखें जिसे आप ज़ोर से समझाने में सहज हों।
अक्सर पूछे जाने वाले प्रश्न (Frequently asked questions)
प्रश्न: मैं AI-सहायता प्राप्त शोध-पत्र को humanize कैसे करूँ?
खंड-दर-खंड काम करें: अपने voice और emphasis के अनुसार re-write करें, जबकि संख्याएँ (numbers), terms और citations बिल्कुल वैसे ही रखें जैसे वे थे। उचित hedging बहाल कीजिए ताकि दावे आपके evidence से मेल खाएँ, फिर हर citation को अपनी reference list के खिलाफ सत्यापित करें। एक academic humanizer यह तेज़ करता है क्योंकि वह आपकी terminology को सुरक्षित रखता है, लेकिन एक manual review pass फिर भी आवश्यक है।
प्रश्न: क्या humanizing मेरे citations बदल देगी?
अक्सर एक generic humanizer बदल देता है, क्योंकि वह citations को सामान्य टेक्स्ट की तरह ट्रीट करके उन्हें reshuffle करने की कोशिश करता है। एक academic-grade टूल APA, IEEE और Chicago जैसी शैलियों (styles) को पहचानता है और उन्हें जगह पर बनाए रखता है, इसलिए आपकी attributions वहीं टिकती हैं। किसी भी री-राइट के बाद हमेशा अपने citations की पुष्टि करें, क्योंकि अच्छे टूल भी कभी-कभी slip कर सकते हैं।
प्रश्न: क्या शोध-पत्र को humanize करना नैतिक है?
हाँ, जब आप अपने स्वयं के ऐसे legitimately AI-assisted ड्राफ्ट को humanize कर रहे हों कि वह आपकी voice में पढ़े, और जब आप उस AI use का खुलासा (disclose) करें जो आपका जर्नल या विश्वविद्यालय मांगता है। यह सामान्य संपादन (normal editing) है। यह तभी misconduct बनता है जब आप इसे authorship को गलत तरीके से प्रस्तुत करने या ऐसी AI generation को छिपाने के लिए इस्तेमाल करें जिसे आपकी नीति अनुमति नहीं देती।
प्रश्न: किसी पेपर का कितना हिस्सा humanized होना चाहिए?
केवल वे हिस्से जिन्हें AI ने वास्तव में लिखने में आपकी मदद की। जिन sections को आपने खुद ड्राफ्ट किया है उन्हें अछूता (untouched) छोड़िए, क्योंकि clean human prose को rewriter से चलाने पर त्रुटियाँ आ सकती हैं और वह और अधिक कृत्रिम (artificial) भी लग सकता है। focus उस टूल पर रखें जहाँ मशीन की phrasing वास्तव में मौजूद है।
प्रश्न: शोध-पत्र के कौन-से sections में AI की वजह से सबसे अधिक flag होने की संभावना होती है?
सबसे अधिक वे sections flagged होते हैं जो फार्मूला-आधारित (formulaic) हैं: abstract, methods, और results के boilerplate हिस्से, जहाँ लेखन स्वाभाविक रूप से समान (uniform) होता है और burstiness कम रहती है। परिचय और discussion में अक्सर कम flags आते हैं, क्योंकि वहाँ आपके argument और voice का हिस्सा अधिक होता है। जब आप AI शोध-पत्र को humanize करते हैं, तो अपना प्रयास उस जगह करें जहाँ prose सबसे सपाट (flattest) है, और equations, data, और citations को बिना छेड़े रखें।
प्रश्न: क्या मुझे humanize करने के बाद AI use का खुलासा करना चाहिए?
हाँ। Humanizing से लेखन का “sound” बदलता है, लेकिन यह तथ्य नहीं बदलता कि आपने ड्राफ्ट तैयार करने में AI की मदद ली थी, इसलिए अधिकांश जर्नल और विश्वविद्यालय अब भी एक छोटा disclosure मांगते हैं। आप किस टूल का उपयोग कर रहे थे और किस उद्देश्य के लिए (drafting, editing, या translation) यह स्पष्ट करें, और अपने citations व results को ठीक उसी तरह रखें जैसे आपका डेटा उन्हें सपोर्ट करता है।
प्रश्न: क्या मैं पूरी थीसिस या डिसर्टेशन को humanize कर सकता हूँ?
हाँ, लेकिन एक ही pass में नहीं, अध्याय-दर-अध्याय (chapter by chapter) करें, और अलग-अलग महीनों के अंतर पर लिखे गए अध्यायों में अपनी voice को consistent रखें। citations को sections में सत्यापित करें, क्योंकि एक लंबे दस्तावेज़ में rewriter को disturb करने के लिए बहुत अधिक संदर्भ (references) होते हैं। केवल उन हिस्सों को humanize करें जिन्हें AI ने वास्तव में ड्राफ्ट करने में आपकी मदद की, और जिन्हें आपने खुद लिखा है उन अध्यायों को अकेला छोड़ दें।
प्रश्न: क्या अकादमिक लेखन के लिए कोई AI humanizer है?
हाँ। एक general humanizer synonyms बदलता है और कभी-कभी किसी defined term को बिगाड़ सकता है या किसी citation को इधर-उधर कर सकता है, जो अकादमिक लेखन में आखिरी चीज़ है जिसकी अनुमति मिल सकती है। एक academic-grade humanizer आपकी citations, statistics और terminology को सुरक्षित रखता है, जबकि वह papers, theses और dissertations में आपकी voice को परिष्कृत करता है। यही वह mode है जिसे हमने ProofreaderPro.ai के आसपास बनाया है, और इसे Turnitin, GPTZero, Copyleaks, ZeroGPT, और Originality.ai के खिलाफ टेस्ट किया गया।
AI-सहायतित मसौदों को निखारें, जबकि आपके संदर्भ, सांख्यिकी, और तकनीकी शब्द सुरक्षित रहें।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


