
इतालवी शोधकर्ताओं के लिए अंग्रेज़ी में लिखने हेतु AI ह्यूमनाइज़र
इतालवी शोधकर्ताओं के लिए AI ह्यूमनाइज़र। इतालवी-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन फ़्लैग कम करें, अर्थ और उद्धरण बनाए रखें, और ईमानदारी से AI उपयोग का खुलासा करें।

इटली दुनिया के शोध-उत्पादन में शीर्ष आठ से दस देशों में शामिल है, फिर भी लगभग उसका कोई भी कार्य इतालवी में अपने पाठकों तक नहीं पहुँचता। यहाँ के अकादमिक एक भाषा में ड्राफ्ट करते और सोचते हैं, लेकिन दूसरी भाषा में प्रकाशित करते हैं, क्योंकि इतालवी शोध-करियर इंडेक्स्ड अंग्रेज़ी-भाषा जर्नलों से होकर गुजरता है। VQR शोध-गुणवत्ता आकलन और प्रोफेसरशिप के लिए ASN राष्ट्रीय योग्यता दोनों ही Scopus और Web of Science में bibliometric thresholds पर निर्भर हैं, इसलिए सही जर्नल में अंग्रेज़ी पेपर “वैकल्पिक” नहीं है।
अब यह दबाव एक नई समस्या से टकराता है। इतालवी शोधकर्ताओं के लिए एक AI ह्यूमनाइज़र इसलिए मौजूद है क्योंकि सावधानीपूर्वक, सही second-language English वही तरह की गद्य-शैली है जिसे AI डिटेक्टर मशीन द्वारा लिखे गए टेक्स्ट के रूप में भाँप लेते हैं। आपके सहयोगी ने मेहनत की, हर शब्द लिखा, और फिर भी फ़्लैग लग गया।
यह गाइड छल करने के लिए नहीं, बल्कि निष्पक्षता के लिए है। लक्ष्य है कि आप अपने स्वयं के AI-सहायता प्राप्त ड्राफ्ट को “ह्यूमनाइज़” करें, अपना अर्थ और उद्धरण यथावत रखें, और फिर अपने संस्थान तथा जर्नल की अपेक्षाओं के अनुसार अपने AI उपयोग का खुलासा करें।
अंग्रेज़ी में प्रकाशित करने वाले इतालवी शोधकर्ताओं हेतु IA टेक्स्ट ह्यूमनाइज़र
हमारा IA टेक्स्ट ह्यूमनाइज़र इतालवी शोधकर्ताओं को अंग्रेज़ी में प्रकाशित करने में मदद करता है, बिना इसके कि सही ढंग से लिखी गई रचना को मशीन द्वारा जनरेट किया गया टेक्स्ट समझ लिया जाए। यह अर्थ, तकनीकी शब्दावली और उद्धरण सुरक्षित रखता है, और लय तथा शब्द-चयन में विविधता लाता है।
सरल शब्दों में: आप विज्ञान लिखते हैं, और टूल सांख्यिकीय “फिंगरप्रिंट” को स्मूद करता है, जो मानक non-native गद्य को कृत्रिम (synthetic) जैसा पढ़वाता है। आपके तर्क, आपके डेटा, या आपके संदर्भों में कुछ भी नहीं बदलता। जो बदलता है, वह वह समान, अनुमानित cadence है जिसे कुछ डिटेक्टर मशीन-सिग्नेचर की तरह देखते हैं।
क्या आप इतालवी में ड्राफ्ट करते हैं? ह्यूमनाइज़र उसे सीधे पहचानकर फिर से लिखता है
आप बिना पहले उसे अंग्रेज़ी में अनुवाद किए भी इतालवी ड्राफ्ट को ह्यूमनाइज़ कर सकते हैं। अपना टेक्स्ट पेस्ट करें, और ProofreaderPro भाषा को स्वचालित रूप से पहचानकर उसे एक इतालवी-अनुकूल मॉडल के माध्यम से रूट करता है, जो accents, terminology, और citations को जहाँ का तहाँ बनाए रखता है। एक umanizzatore di testo IA के रूप में यह आपकी इतालवी गद्य-शैली की लय में विविधता लाता है, जबकि हर निष्कर्ष और संदर्भ को सुरक्षित रखता है। स्वचालित पहचान साठ से अधिक भाषाओं तक पहुँचती है, इसलिए इतालवी को अंग्रेज़ी में “रीशेप” करने के बजाय इतालवी ही माना जाता है।
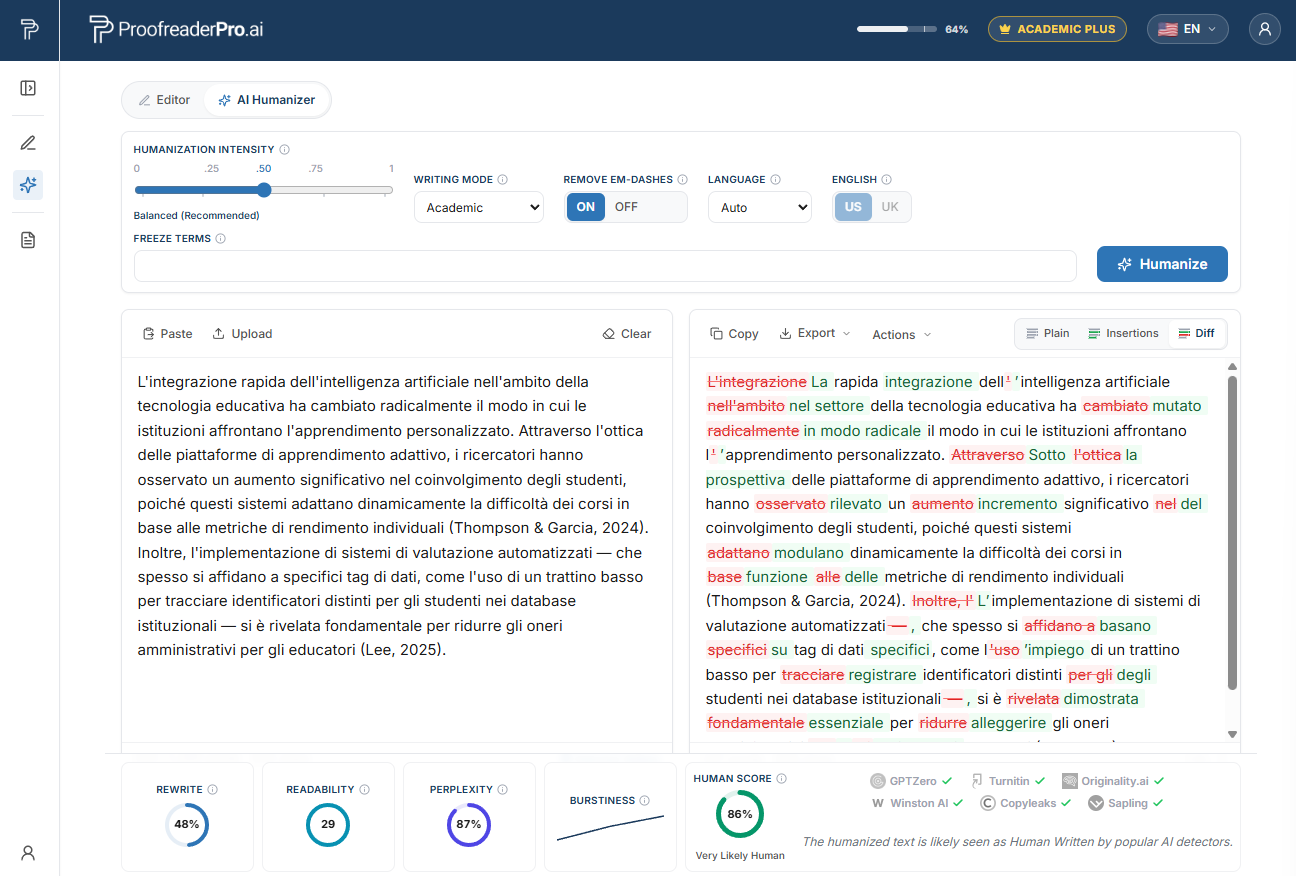
ProofreaderPro AI Humanizer द्वारा इतालवी शैक्षणिक टेक्स्ट का पुनर्लेखन। पहले और बाद का diff आपका अर्थ और उद्धरण बनाए रखता है, और डिटेक्टर चेक यह पुष्टि करते हैं कि पढ़ना स्वाभाविक, मानवीय है।
इतालवी शोधकर्ताओं को AI डिटेक्टरों द्वारा फ़्लैग क्यों किया जाता है
2023 में, Liang के नेतृत्व में एक Stanford टीम ने Cell Press जर्नल Patterns में एक स्पष्ट शीर्षक के साथ अध्ययन प्रकाशित किया: GPT detectors are biased against non-native English writers. उन्होंने मानव-लिखित TOEFL essays को सात व्यापक रूप से उपयोग किए जाने वाले डिटेक्टरों में चलाया।
यह परिणाम किसी भी ऐसे व्यक्ति के लिए चिंता का विषय होना चाहिए जो दूसरी भाषा में प्रकाशित कर रहा है। औसतन, non-native essays में लगभग 61% को AI के रूप में फ़्लैग किया गया, जबकि native writers के लिए यह लगभग 5% था। लगभग हर पाँच में से एक, यानी 19.8%, को हर डिटेक्टर ने सर्वसम्मति से फ़्लैग किया। इन सभी essays को इंसानों ने लिखा था।
इस प्रक्रिया को perplexity कहा जाता है। डिटेक्टर मापते हैं कि भाषा मॉडल के संदर्भ में हर शब्द-चयन कितना “अप्रत्याशित” (surprising) है। सावधानीपूर्वक second-language writer सामान्य शब्दों और मानक, अनुमानित phrasing की ओर झुकते हैं, जिससे low perplexity पैदा होती है, जो मशीन टेक्स्ट की तरह पढ़ती है। वे आदतें जो आपकी अंग्रेज़ी को स्पष्ट बनाती हैं, वही आदतें हैं जिनको ये टूल दंडित करने के लिए प्रशिक्षित किए गए हैं। हम इसे आगे why AI detectors flag non-native writing में और विस्तार से तोड़ते हैं।
false flags के पीछे इतालवी पहली-भाषा के पैटर्न
नीचे दिए गए किसी भी पैटर्न को “गलती” नहीं कहा जा सकता। ये वे सावधानीपूर्वक, पाठ्यपुस्तक-आधारित संरचनाएँ हैं जिनकी ओर एक इतालवी विद्वान पहुँचता है, और वही नियमितता (regularity) वह है जिसे डिटेक्टर low perplexity के रूप में पढ़ते हैं।
लंबे hypotactic वाक्य। इतालवी शैक्षणिक शैली में कई nested subordinate clauses वाले लंबे periods को प्राथमिकता मिलती है। अंग्रेज़ी में अनुवाद होने पर वे व्याकरणिक तो बने रहते हैं, लेकिन घने हो जाते हैं, और उनकी समान, अत्यधिक “योग्य” लय किसी मॉडल को अनुमानित लगने लगती है।
abstract nouns के साथ articles। nature, the science, या the society जैसे विषयों पर लिखना, जहाँ अंग्रेज़ी अक्सर article छोड़ देती है, इतालवी से एक प्रत्यक्ष और लगातार transfer है। यही निरंतरता वह संकेत है जिसे डिटेक्टर कम स्कोर के साथ पुरस्कृत करते हैं।
preposition transfer. Depend from for dipendere da, या on the basis of in place of based on, ये व्यवस्थित, नियम-आधारित चयन हैं। व्यवस्थित चयन, परिभाषा के अनुसार, low perplexity हैं।
Nominalization और Latinate diction। heavy noun phrases जैसे the realization of the analysis, और Latinate vocabulary के लिए स्थिर प्राथमिकता, ये मानक formal register हैं। Formal और standard वही है जिसे ये टूल फ़्लैग करते हैं।
Calqued connectors। Moreover, Furthermore, और In fact जैसे वाक्य-प्रारंभिक connectors का बार-बार उपयोग, इतालवी discourse markers से प्रतिरूपित (mirrored) होकर, एक नियमित, दोहराव वाली cadence जोड़ता है जो मशीन-सी स्मूदनेस की तरह पढ़ता है।
False friends। Attualmente को currently की बजाय actually की ओर ले जाना, या eventualmente को possibly की बजाय eventually की ओर, यह सावधानीपूर्वक लिखने वाला व्यक्ति सबसे मानक दिखने वाले शब्द की ओर जो सुधार करता है। सबसे मानक शब्द वह भी है जो सबसे कम “अप्रत्याशित” (least surprising) होता है।
इटली का AI-डिटेक्शन और Turnitin संदर्भ
इतालवी थीसिस और पांडुलिपियों की पाठ-समानता (textual similarity) के लिए नियमित रूप से जाँच की जाती है, अधिकांशतः Turnitin या iThenticate से, और ये टूल परिचित similarity score के साथ-साथ बढ़ती संख्या में AI संकेत भी सामने लाते हैं। similarity report डॉक्टोरल स्कूलों और editorial workflows में सामान्य प्रक्रिया है, और अपने आप में यह आपके integrity के बारे में कुछ नहीं कहता।
परिप्रेक्ष्य में रखने योग्य दो बातें हैं। पहली, AI indicator एक दावा है, अंतिम निर्णय (verdict) नहीं। Turnitin स्वयं 1 से 19% की सीमा में स्कोर दबा देता है और चेतावनी देता है कि उसका नंबर अकेले किसी integrity-केस का फैसला नहीं कर देना चाहिए। Vanderbilt, Michigan State, और UT Austin सहित कई विश्वविद्यालयों ने false positives और non-native writers के प्रति bias को कारण बताते हुए AI डिटेक्टर को पूरी तरह निष्क्रिय कर दिया है।
दूसरी, इटली में (बाक़ी जगहों की तरह) यात्रा की दिशा disclosure की ओर है। फंडर्स और जर्नल अब increasingly आपसे यह बताते/घोषित करने को कहते हैं कि आपने AI कहाँ और कैसे उपयोग किया। यह अपेक्षा आपकी सुरक्षा है: spotless detector score नहीं, बल्कि पूर्ण खुलासा वही है जो आपको नियमों के भीतर रखता है।
अपनी लेखन को गलत आरोप वाले फाल्स फ्लैग से सुरक्षित रखें
कुछ मिनटों में अपने AI-सहायता वाले मसौदे को मानवीय बनाएं, हर उद्धरण को बनाए रखें, फिर जानकारी दें। सावधानी से लिखने वाले गैर-देशी अकादमिक अंग्रेज़ी लेखकों के लिए बनाया गया।
Humanizer को निःशुल्क आज़माइएशीर्ष इतालवी विश्वविद्यालय और जहाँ AI जाँचें दिखती हैं
ऊपर वर्णित screening इटली के प्रमुख संस्थानों में होती है। इन विश्वविद्यालयों के डॉक्टोरल स्कूल और संपादकीय कार्यालय थीसिस तथा पांडुलिपियों को similarity checks के माध्यम से चलाते हैं, और अब बढ़ती संख्या में AI संकेतों का भार भी देखते हैं:
- Sapienza Università di Roma, in Rome
- Università di Bologna (Alma Mater Studiorum), in Bologna
- Politecnico di Milano and Università degli Studi di Milano (Statale), in Milan
- Università degli Studi di Padova, in Padua
- Università degli Studi di Napoli Federico II, in Naples
- Politecnico di Torino and Università degli Studi di Torino, in Turin
- Università di Pisa, Scuola Normale Superiore, and Scuola Superiore Sant'Anna, in Pisa
- Università degli Studi di Firenze, in Florence
- Università degli Studi di Trento, in Trento
- Università Cattolica del Sacro Cuore, in Milan
इनमें से हर जगह, कोई फ़्लैग आपकी ईमानदारी पर निष्कर्ष नहीं, बल्कि आपकी विधियों पर बातचीत की शुरुआत होता है। यह जानना कि ये जाँचें नियमित हैं, घबराने के बजाय तैयार होने का एक कारण है।
इतालवी शोधकर्ताओं हेतु AI ह्यूमनाइज़र कैसे काम करता है
यहाँ वर्कफ़्लो है, और क्रम मायने रखता है।
पहला, अपना तर्क ड्राफ्ट करें। यदि आपकी सोच सबसे तेज़ कहाँ होती है, वहाँ इतालवी में लिखें, फिर अनुवाद करें, या सीधे अंग्रेज़ी में ड्राफ्ट करें। दोनों तरीकों में, ideas और data आपके अपने हैं।
दूसरा, व्याकरण ठीक करें। false friends, prepositions, और article slips को पहले सुधारें ताकि भाषा आगे कुछ भी छुए उससे पहले साफ हो जाए। हमारे proofreading tools इसी के लिए बनाए गए हैं, और आप sibling workflow को AI proofreading for Italian academics में देख सकते हैं।
तीसरा, अपने ही गद्य को ह्यूमनाइज़ करें। अपने AI-सहायता प्राप्त ड्राफ्ट को AI text humanizer से चलाएँ। यह rhythm और word choice में विविधता लाता है और repetitive, low-perplexity cadence को हटाता है जो डिटेक्टरों को ट्रिगर करती है, जबकि आपका अर्थ, technical terminology, और citations सुरक्षित रखता है।
ह्यूमनाइज़र प्रमुख डिटेक्टरों के विरुद्ध परीक्षण किया जाता है, और यह AI टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में पुनर्लेखित करता है, ताकि Turnitin, Originality.ai, और GPTZero पर यह मानवीय पढ़े, जबकि अकादमिक टेक्स्ट में grammar accuracy उच्च रहे। परिणाम परीक्षण पर आधारित हैं, वादों पर नहीं। हम किसी भी चीज़ को बायपास करने का वादा नहीं करते, क्योंकि डिटेक्टर हर कुछ महीनों में फिर से प्रशिक्षित (retrain) होते हैं।
चौथा, खुलासा करें। अपने AI उपयोग को उसी प्रारूप में लिखें जैसा आपका संस्थान और लक्षित जर्नल माँगता है। यही अंतिम कदम वास्तविक कार्य के लिए निष्पक्ष संरक्षण और छिपाव (disguise) के बीच अंतर करता है।
यह पोस्ट हमारे multilingual AI humanizer hub में एक पड़ाव है, जो अन्य पहली भाषाओं के साथ लिखने वाले शोधकर्ताओं के लिए समान वर्कफ़्लो कवर करता है। यदि आपकी व्यापक ज़रूरत detector fairness नहीं, बल्कि पूर्ण भाषा संपादन (full language editing) है, तो हमारे global academic editing hub से शुरू करें।
स्थानीय फ़ंडिंग निकाय, जर्नल, और AI-डिस्क्लोज़र अपेक्षाएँ
इतालवी शोध-फंडिंग और आकलन कुछ चुनिंदा निकायों के माध्यम से संचालित होते हैं, और उनमें से प्रत्येक इस बात पर दाँव (stakes) बढ़ाता है कि आपका कार्य कहाँ प्रकाशित होता है।
MUR (Ministero dell'Università e della Ricerca) विश्वविद्यालयों और राष्ट्रीय ग्रांट्स को फंड देता है। PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) मुख्य राष्ट्रीय प्रतिस्पर्धी योजना है। CNR (Consiglio Nazionale delle Ricerche) देश का सबसे बड़ा सार्वजनिक शोध निकाय है। ANVUR VQR मूल्यांकन और ASN योग्यता, दोनों को संचालित करता है, और यह मानविकी (humanities) तथा सामाजिक विज्ञान (social sciences) में वास्तविक वज़न रखने वाली class-A जर्नल सूचियाँ बनाए रखता है।
प्लेसमेंट के संदर्भ में इसका अर्थ है Scopus और Web of Science में इंडेक्सिंग, तथा non-bibliometric क्षेत्रों में ANVUR की class-A स्थिति। इन जर्नलों की ओर जाने वाली पांडुलिपियों को Turnitin या iThenticate से स्क्रीन किया जाता है, और जर्नलों व फंडर्स की बढ़ती संख्या AI-use का एक स्पष्ट बयान माँगती है। उस बयान को पहले से तैयार करें, और यदि कभी कोई डिटेक्टर साफ-सुथरे काम को भी फ़्लैग करे, तो उस रिपोर्ट को “निर्णय” के बजाय चुनौती-योग्य (contestable) साक्ष्य की तरह देखें। सबमिशन से पहले AI text humanizer से एक अंतिम पास सावधानीपूर्वक लिखे गए non-native गद्य को अधिक न्यायसंगत पढ़ा जाना सुनिश्चित करता है, और आपका खुलासा पूरी प्रक्रिया को पारदर्शी बनाता है।
अक्सर पूछे जाने वाले प्रश्न
Q: क्या इतालवी शोधकर्ताओं हेतु AI ह्यूमनाइज़र का उपयोग धोखाधड़ी का रूप है?
नहीं, जब आप इसे अपने ही काम पर उपयोग करते हैं। आपने शोध लिखा; टूल केवल सावधानीपूर्वक लिखे गए non-native गद्य की लय और शब्द-चयन में विविधता लाता है ताकि उसे मशीन टेक्स्ट समझे जाने की संभावना कम हो जाए। इसे पारदर्शी बनाए रखने वाला नियम disclosure है: आप फिर भी अपने संस्थान और जर्नल को बताते हैं कि आपने AI कैसे उपयोग किया।
Q: क्या ह्यूमनाइज़र मेरे उद्धरण या तकनीकी शब्दों को बदलेगा?
नहीं। यह आपके संदर्भ (references), आपके डेटा (data), और आपके अनुशासन (discipline) की शब्दावली को सुरक्षित रखता है। यह low-perplexity वाली cadence को लक्ष्य बनाता है जिस पर डिटेक्टर प्रतिक्रिया देते हैं, न कि आपके तर्क के सार (substance) को।
Q: क्या आप सुनिश्चित कर सकते हैं कि मेरा पेपर Turnitin या GPTZero में पास हो जाएगा?
नहीं, और किसी भी ऐसे टूल से सावधान रहें जो ऐसा वादा करे। हमारे परीक्षण में ह्यूमनाइज़र AI टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में पुनर्लेखित करता है, जिससे AI संकेत (AI signal) घटता है और कठिन डिटेक्टरों के खिलाफ इसकी संभावनाएँ बेहतर होती हैं, लेकिन डिटेक्टर लगातार retrain होते हैं, इसलिए हम वादों की बजाय परीक्षण-आधारित परिणाम बताते हैं।
Q: मेरा सही अंग्रेज़ी फिर भी फ़्लैग क्यों हो रहा है?
क्योंकि डिटेक्टर यह स्कोर करते हैं कि आपके शब्द-चयन कितने अनुमानित (predictable) हैं। standard, textbook इतालवी-to-अंग्रेज़ी संरचनाएँ, article के उपयोग से लेकर Latinate diction तक, बहुत अधिक अनुमानित होती हैं, जो low perplexity की तरह पढ़ती है, और कुछ टूल इसे AI का संकेत मानते हैं। यह सावधानीपूर्वक second-language writing के खिलाफ दर्ज bias है, न कि आपके काम पर कोई निर्णय।
Q: यदि कोई समिति या जर्नल मेरे लेखन को फ़्लैग करे, तो मुझे क्या करना चाहिए?
शांत रहें और फ़्लैग को एक ऐसे दावे की तरह लें जिसका उत्तर देना है, न कि अंतिम निर्णय (verdict) की तरह। अपने ड्राफ्ट और नोट्स रखें, non-native writers के खिलाफ दर्ज bias की ओर संकेत करें, और अपने AI-use disclosure को साझा करें। एक डिटेक्टर स्कोर चुनौती-योग्य साक्ष्य (contestable evidence) है, कभी प्रमाण (proof) नहीं।
अपने सावधानी से लिखे गैर-देशी अंग्रेज़ी को अधिक निष्पक्ष पढ़ने का मौका दें। अर्थ और उद्धरण संरक्षित रखें, गलत AI फ्लैग कम करें, फिर आत्मविश्वास के साथ जानकारी दें।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


