
अंग्रेज़ी में लेखन करने वाले ईरानी शोधकर्ताओं के लिए AI ह्यूमनाइज़र
ईरानी शोधकर्ताओं के लिए AI ह्यूमनाइज़र। फ़ारसी-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन के झंडों (false flags) को कम करें, अर्थ और उद्धरण (citations) सुरक्षित रखें, और स्पष्ट रूप से ईमानदारी के साथ उपयोग की घोषणा करें।

SCImago सूचकांक के अनुसार, उत्पादन के लिहाज़ से ईरान विश्व में 17वें स्थान पर है। यह प्रति वर्ष 75,000 से अधिक शोध-पत्र प्रकाशित करता है। 1997 के बाद से, जब प्रतिवर्ष केवल लगभग 1,000 पेपर प्रकाशित होते थे, यह वृद्धि लगभग पचास गुना है। और फिर भी ईरानी वैज्ञानिक यह उपलब्धि प्रतिबंधों के बीच हासिल कर रहे हैं, जो उन्हें जर्नल्स तक पहुंच से वंचित करते हैं, प्रकाशनों के लिए भुगतान करना रोकते हैं, और दुनिया के अधिकांश शोध-संस्थानिक ढांचे (research infrastructure) से उन्हें अलग कर देते हैं। इनका बड़ा काम अंग्रेज़ी में लिखा, निखारा और जमा किया जाता है।
ईरानी शोधकर्ताओं के लिए एक AI ह्यूमनाइज़र मौजूद है, इस एक ठोस, वास्तविक कारण से: AI डिटेक्टर अक्सर सावधानीपूर्ण, सही, गैर-मातृभाषी (non-native) अंग्रेज़ी को मशीन-लिखित मान लेते हैं, जिससे वास्तविक लोगों के वास्तविक काम का श्रेय छिन जाता है। डिटेक्टर का फ्लैग किसी भी बात का प्रमाण नहीं है। यह एक प्रायिकता-आधारित (probability) स्कोर होता है, और फ़ारसी भाषियों के लिए ये स्कोर अक्सर ऊंचे जाते हैं।
आज हम में से अधिकांश कुछ न कुछ AI सहायता के साथ ड्राफ्ट बनाते हैं, कहीं एक रूपरेखा (outline), कहीं एक पैराग्राफ़ को सहज (smoothed) करना, और कहीं फ़ारसी से अनूदित एक वाक्य। यह सामान्य है, और जब आप इसे घोषित करते हैं, तो यह वैध (legitimate) है। समस्या यह है कि शुद्ध, मानक अकादमिक अंग्रेज़ी भी डिटेक्टर को उलझा सकती है, चाहे उस पर कभी किसी टूल का हाथ पड़ा हो या नहीं, और दूसरी भाषा में लिखने वालों को तो लगभग सभी से अधिक फ्लैग किए जाने की संभावना रहती है।
मानव-संगतकर्ता: AI ह्यूमनाइज़र ईरानी शोधकर्ताओं के लिए
AI ह्यूमनाइज़र ईरानी शोधकर्ताओं की मदद करता है कि वे अपनी अंग्रेज़ी की लिखावट को अधिक स्वाभाविक और प्रवाहपूर्ण बनाएं, अर्थ और उद्धरण (meaning and citations) बनाए रखें, और अपने लेख अंतरराष्ट्रीय जर्नल्स में प्रकाशित करें।
सरल शब्दों में: हमारा ह्यूमनाइज़र आपके अपने अंग्रेज़ी ड्राफ्ट की लय (rhythm) और शब्द-चयन (word choice) को ऐसे बदलता है कि फ़ारसी-प्रभावित, सावधानीपूर्ण गद्य को मशीन टेक्स्ट समझे जाने की संभावना कम हो जाए। यह आपका अर्थ (meaning), आपके तकनीकी शब्द (technical terms), और आपके उद्धरणों को उसी स्थान पर बनाए रखता है। आप इस टूल तक सीधे text humanizer के जरिए पहुंच सकते हैं, और यह हमारे Proofreader तथा फ़ारसी-से-अंग्रेज़ी अनुवादक (Persian-to-English translator) के समान ही प्लेटफ़ॉर्म पर मौजूद है।
यह AI उपयोग छिपाने की कोई चाल नहीं है। यह वास्तविक शोध के लिए निष्पक्षता (fairness) का कदम है, जिसके बाद स्पष्ट और पारदर्शी घोषणा (clear disclosure) होती है। हम उसी क्रम को लेकर लौटेंगे, क्योंकि यह महत्वपूर्ण है।
क्या आप फ़ारसी में लिखते हैं? इसका स्वतः पता चलता है और मूल रूप से मानव-संगत (humanized) हो जाता है
कई ईरानी शोधकर्ता अंग्रेज़ी में लिखने से पहले फ़ारसी में ड्राफ्ट तैयार करते हैं; मानव-संगतकर्ता (humanizer) इसे सीधे सपोर्ट करता है। फ़ारसी टेक्स्ट पेस्ट करें और ProofreaderPro स्वतः दाएँ-से-बाएँ (right-to-left) लिपि को पहचान लेगा, फिर इसे भाषा-समझदार (language-aware) मॉडल के माध्यम से संसाधित करेगा जो आपकी शब्दावली और उद्धरणों को बिल्कुल वैसा ही बनाए रखता है जैसा आपने लिखा है। انسانیساز هوش مصنوعی आपकी फ़ारसी ड्राफ्ट पर उतनी ही स्वाभाविकता से काम करता है जितना आपकी अंग्रेज़ी पर, इसलिए पहले किसी अनुवाद की जरूरत नहीं पड़ती। स्वचालित पहचान (auto-detection) साठ से अधिक भाषाओं को कवर करती है, और हर भाषा को उसी के रूप में फिर से लिखा जाता है।
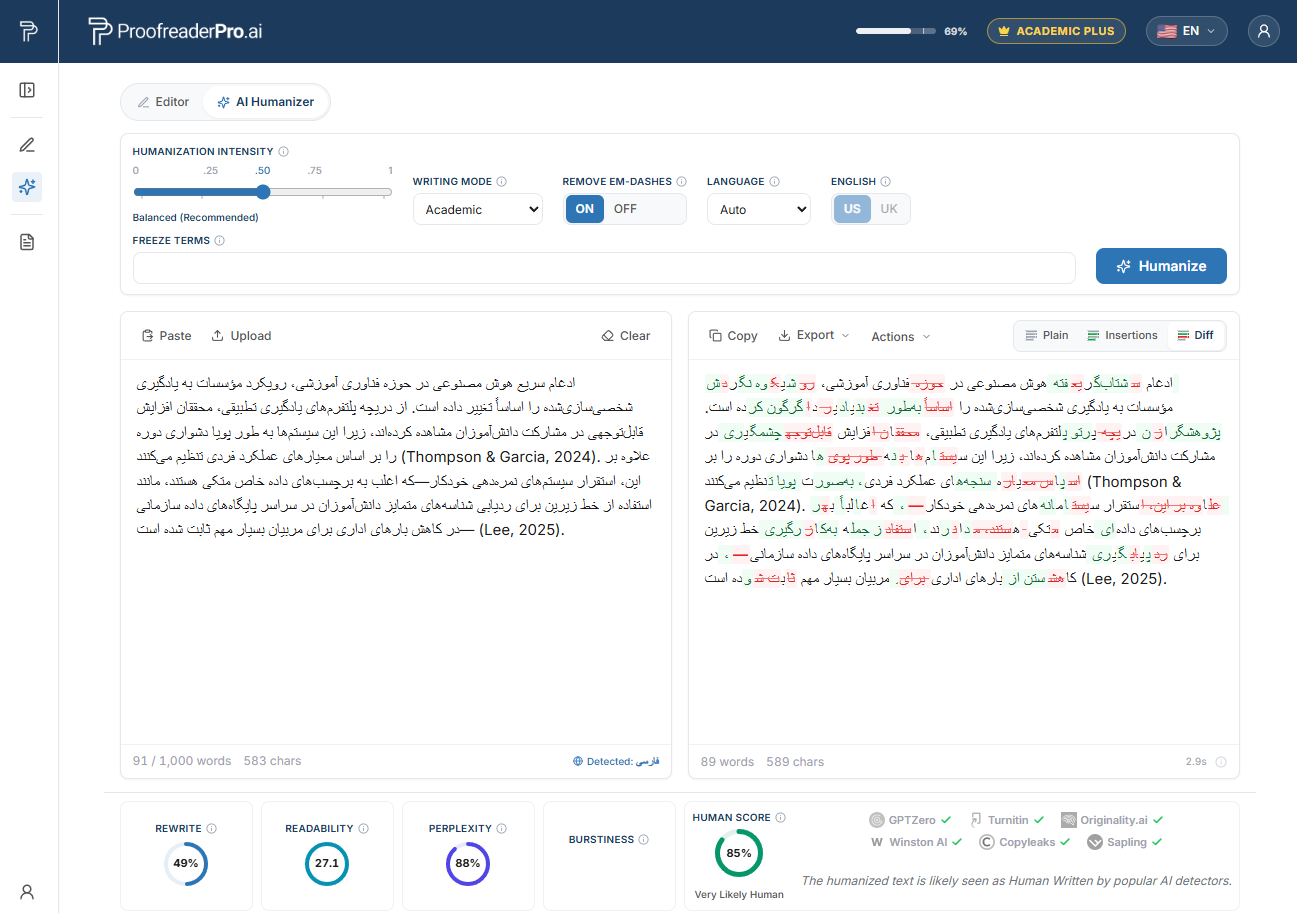
ProofreaderPro AI Humanizer फ़ारसी अकादमिक टेक्स्ट को फिर से लिखता है। पहले और बाद का diff आपके अर्थ और उद्धरणों को बनाए रखता है, और डिटेक्टर जाँचें पुष्टि करती हैं कि पढ़ना स्वाभाविक, मानवीय है।
ईरानी शोधकर्ताओं को AI डिटेक्टरों से फ्लैग क्यों किया जाता है
2023 में, Weixin Liang के नेतृत्व वाली एक Stanford टीम ने Cell Press जर्नल Patterns में "GPT detectors are biased against non-native English writers" शीर्षक से एक अध्ययन प्रकाशित किया। उन्होंने TOEFL निबंध (essays) लिए, जो सभी मनुष्यों द्वारा लिखे गए थे, और उन्हें सात व्यापक रूप से इस्तेमाल होने वाले AI डिटेक्टरों के माध्यम से चलाया।
औसतन, गैर-मातृभाषी लेखकों के लगभग 61% निबंध AI-generated के रूप में फ्लैग किए गए, जबकि मूल अंग्रेज़ी लेखकों के लिए यह लगभग 5% था। गैर-मातृभाषी निबंधों में से लगभग एक-पाँचवां, करीब 19.8%, को हर एक डिटेक्टर ने सर्वसम्मति से फ्लैग किया। और इन हर निबंध को एक व्यक्ति ने लिखा था।
इसका तंत्र (mechanism) "perplexity" कहलाता है। कई डिटेक्टर यह स्कोर करते हैं कि भाषा मॉडल के लिए किसी शब्द-चयन (word choice) के आने की "आश्चर्यजनकता" (surprising) कितनी है। जब आप स्पष्ट, मानक अकादमिक अंग्रेज़ी में लिखते हैं, सामान्य शब्दों (common words) और अनुमानित (predictable) वाक्य-रचना के साथ, तो आपके टेक्स्ट की perplexity कम होती है, और कम perplexity को मशीन टेक्स्ट की तरह पढ़ा जाता है। दूसरी भाषा में लिखने वाले अकादमिक गद्य को साफ़ और सही बनाने वाली आदतें ही वे हैं जिन्हें इन टूल्स को पहचानने के लिए प्रशिक्षित (trained) किया गया था। इस false-positive समस्या का अधिक विस्तृत स्पष्टीकरण देखने के लिए why AI detectors flag non-native writers देखें।
false flags के पीछे फ़ारसी की प्रथम-भाषा (first-language) पैटर्निंग
फ़ारसी संरचनात्मक रूप से अंग्रेज़ी से दूर है, और फ़ारसी वक्ता द्वारा गद्य को औपचारिक (formal) सुनाने के लिए की गई सावधानीपूर्ण सुधार अक्सर ठीक वही सपाट, मानक लय (flat, standard rhythm) पैदा कर देते हैं जिसे कोई डिटेक्टर कृत्रिम (synthetic) मानता है। ये त्रुटियाँ नहीं हैं। ये सही, सतर्क (cautious) निर्माण (constructions) हैं, और यही समस्या है।
लेख-शैली की अनुशासन-व्यवस्था (Article discipline). फ़ारसी में "the," "a," या "an" का कोई सीधा समकक्ष नहीं है; इसलिए जो ईरानी लेखक अंग्रेज़ी के articles पर मेहनत से अभ्यास करते हैं, वे उन्हें सबसे सुरक्षित और पाठ्यपुस्तक (textbook) शैली में रखना सीख जाते हैं। परिणाम यह पढ़ता है कि वह सही है और थोड़ा-सा यांत्रिक (slightly mechanical) भी, यही low perplexity का संकेत है।
पुनर्निर्मित शब्द-क्रम (Rebuilt word order). फ़ारसी Subject-Object-Verb क्रम का पालन करती है। अंग्रेज़ी में प्रकाशित करने के लिए आप प्रत्येक वाक्य को जानबूझकर Subject-Verb-Object में पुनर्निर्मित करते हैं, और यही जानबूझकर किया गया, यहाँ तक कि संरचनात्मक रूप से सुगम (structure smooth) बदलाव, वही "cadence" है जिसे डिटेक्टर जनरेटेड टेक्स्ट से जोड़ते हैं।
सुरक्षित संयोजन (Safe collocations). कई शोधकर्ता फ़ारसी में ड्राफ्ट बनाते हैं और अनुवाद करते हैं, फिर "do a research" जैसी phrasing को "conduct research" में सुधारते हैं। सुधार के बाद वाला रूप मानक और अनुमानित (standard and predictable) होता है, इसलिए यह perplexity को घटाता है, भले ही यह अंग्रेज़ी को बेहतर बनाता हो।
निगमनात्मक पुनर्व्यवस्था (Deductive reordering). फ़ारसी अकादमिक शैली अक्सर पहले संदर्भ (context) बनाती है और दावा (claim) देर से बताती है। जब आप किसी पैराग्राफ़ को पलटकर इंग्लिश के thesis-first पैटर्न में लाते हैं, तो आप उस स्पष्ट, आगे-से-भरा (front-loaded) ढांचे को पैदा करते हैं जिसे डिटेक्टर सूत्रबद्ध (formulaic) की तरह पढ़ते हैं।
काल (tense) और संगति (agreement) की निरंतरता। फ़ारसी में tense और verb agreement को चिह्नित करने का तरीका अलग है; इसलिए सावधानीपूर्ण लेखक अपने tenses को कड़ाई से नियंत्रित (police) करते हैं। Methods सेक्शन में समान और त्रुटिरहित tense का होना अच्छा लेखन है, और यह कम-variance वाला, मशीन जैसा (machine-looking) टेक्स्ट भी बन जाता है।
इन सबका मतलब यह नहीं कि आपकी अंग्रेज़ी खराब है। इसका मतलब यह है कि आपकी अंग्रेज़ी सावधानीपूर्ण है, और सावधानीपूर्ण गैर-मातृभाषी (careful non-native) गद्य को ये डिटेक्टर सबसे अधिक बार गलत आँकते हैं।
ईरान का AI-डिटेक्शन और Turnitin संदर्भ
ईरान से आने वाले थीसिस और जर्नल सबमिशन आम तौर पर similarity, और बढ़ती हुई दर के साथ AI संकेतकों (AI indicators), के लिए स्क्रीन किए जाते हैं; प्रायः यह Turnitin या iThenticate के जरिए होता है। ईरानी डॉक्टोरल छात्रों को स्नातक करने के लिए कम-से-कम एक ISI (Web of Science) प्रकाशन होना अनिवार्य है, और फैकल्टी प्रोमोशन Web of Science, Scopus, PubMed, या ISC डेटाबेस में इंडेक्स्ड आउटपुट पर निर्भर करता है; इसलिए लगभग हर गंभीर पांडुलिपि किसी न किसी चरण में एक screening pipeline से गुजरती है।
फ्लैग क्या है और क्या नहीं है, इसके बारे में स्पष्ट होना जरूरी है। ऊपर वर्णित bias के कारण कुछ संस्थानों ने AI डिटेक्टरों के उपयोग से पीछे हटने (step back) का निर्णय लिया है। उदाहरण के लिए, Vanderbilt ने 2023 में false positives और गैर-मातृभाषी लेखकों के प्रति अनुचितता के कारण Turnitin के AI डिटेक्टर को निष्क्रिय (disabled) कर दिया। जिन अन्य ने ऐसा किया उनमें Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, और Waterloo शामिल हैं। Turnitin 1 से 19% की रेंज में स्कोर को दबाता (suppress) है और चेतावनी देता है कि उसके स्कोर का उपयोग अकेले integrity संबंधी निर्णय लेने के लिए नहीं किया जाना चाहिए।
इसलिए डिटेक्टर का प्रतिशत (percentage) किसी निष्कर्ष (verdict) की तरह नहीं, बल्कि एक ऐसे दावे (claim) की तरह है जिसे चुनौती दी जा सकती है। कोई छात्र "sued Turnitin and won" नहीं करता; वास्तविक विवाद स्कूलों के साथ थे कि फ्लैग का उपयोग कैसे किया गया। वहीं, फंडर और जर्नल छिपाने (concealment) की दिशा में नहीं, बल्कि उल्टी दिशा में आगे बढ़ रहे हैं: वे बढ़ती संख्या में आपसे AI उपयोग को खुलकर घोषित (disclose) करने को कह रहे हैं। ये दोनों तथ्य मिलकर वही सीधा रास्ता तय करते हैं, जो सावधानीपूर्ण लेखन को false flag से बचाता है, और उस मदद को घोषित कराता है जो आपने वास्तव में ली थी।
अपने AI-सहायता प्राप्त मसौदे को मानवीय बनाइए, हर उद्धरण बनाए रखें
सावधानी से लिखी गई फारसी-प्रभावित अंग्रेजी की लय में विविधता लाइए ताकि उसे मशीन पाठ के रूप में गलत पढ़े जाने की संभावना कम हो। अर्थ, शब्दावली और संदर्भ अक्षुण्ण रहें, फिर आप अपने AI उपयोग का खुलासा करें।
Humanizer को निःशुल्क आज़माइएईरान के शीर्ष विश्वविद्यालय और जहाँ AI जाँच दिखती है
ईरान के सभी शोध विश्वविद्यालयों को डॉक्टोरल स्नातक और फैकल्टी उन्नति (faculty advancement) के लिए अंग्रेज़ी-भाषा में प्रकाशन (English-language publication) चाहिए होता है, और उनके ग्रेजुएट स्कूल व पुस्तकालय जमा करने से पहले थीसिस और पांडुलिपियों को similarity तथा AI संकेतकों के लिए स्क्रीन करते हैं। प्रमुख संस्थानों में शामिल हैं:
- University of Tehran (دانشگاه تهران), तेहरान, सबसे पुराना और सबसे उच्च-रैंक वाला; हर अनुशासन में मजबूत।
- Sharif University of Technology (دانشگاه صنعتی شریف), तेहरान, तकनीकी क्षेत्र का प्रमुख विश्वविद्यालय।
- Amirkabir University of Technology (دانشگاه صنعتی امیرکبیر), तेहरान, जिसे Tehran Polytechnic के नाम से भी जाना जाता है।
- Iran University of Science and Technology (دانشگاه علم و صنعت ایران), तेहरان।
- Tarbiat Modares University (دانشگاه تربیت مدرس), तेहरान, केवल ग्रेजुएट्स के लिए विश्वविद्यालय।
- Shahid Beheshti University (دانشگاه شهید بهشتی), तेहरान।
- Tehran University of Medical Sciences (دانشگاه علوم پزشکی تهران), तेहरान, शीर्ष स्तरीय चिकित्सा शोध संस्थान।
- Isfahan University of Technology (دانشگاه صنعتی اصفهان), इस्फ़हान।
- University of Isfahan (دانشگاه اصفهان), इस्फ़हान।
- Ferdowsi University of Mashhad (دانشگاه فردوسی مشهد), मशहद।
- Shiraz University (دانشگاه شیراز), शिराज़, ISC मुख्यालय का स्थान।
- University of Tabriz (دانشگاه تبریز), तबरीज़, सबसे पुराने विश्वविद्यालयों में से एक।
- K.N. Toosi University of Technology (دانشگاه صنعتی خواجه نصیرالدین طوسی), तेहरान।
- Islamic Azad University (دانشگاه آزاد اسلامی), पूरे देश में कैंपस, नामांकन के आधार पर सबसे बड़ा सिस्टम।
- Bu-Ali Sina University (دانشگاه بوعلی سینا), हमेदान।
इन सभी जगहों पर चेकपॉइंट एक जैसा है: आपकी अंग्रेज़ी पांडुलिपि similarity और AI स्क्रीन से मिलती है, और सावधानीपूर्ण गैर-मातृभाषी गद्य वही प्रकार का टेक्स्ट है जिसे वास्तव में जितना श्रेय मिलता है उससे अधिक ऊंचा स्कोर मिल जाता है।
ईरानी शोधकर्ताओं के लिए AI ह्यूमनाइज़र कैसे काम करता है
ईरानी शोधकर्ताओं के लिए AI ह्यूमनाइज़र वर्कफ़्लो का अंतिम चरण है, यह उसके लिए कोई शॉर्टकट नहीं है। हम जिस क्रम की सिफारिश करते हैं, वह इस प्रकार है।
यदि आप फ़ारसी में अधिक स्पष्टता से सोचते हैं, तो पहले फ़ारसी में ड्राफ्ट बनाइए और उसे अकादमिक अंग्रेज़ी में अनुवादित (translate) कीजिए। या फिर आप जिस भी AI सहायता का उपयोग करते हैं, उसके साथ अंग्रेज़ी में ड्राफ्ट बनाइए। दूसरा, व्याकरण (grammar) को प्रूफरीड करें ताकि articles का उपयोग, tense, agreement, और prepositions सही हों। तीसरा, अपने AI-सहायता वाले गद्य को मानव-संगत (humanize) करें, ताकि सावधानीपूर्ण, low-variance लेखन फिर से प्राकृतिक मानवीय लय (human rhythm) के साथ पढ़े, जबकि आपका अर्थ (meaning), शब्दावली (terminology), और उद्धरण (citations) बिल्कुल वैसे ही बने रहें जैसे वे पहले थे।
परिणामों पर हम वही रिपोर्ट करते हैं जो हमने मापा है, वह नहीं जो हम वादा करते हैं। प्रमुख डिटेक्टरों के विरुद्ध परीक्षण में, हमारा ह्यूमनाइज़र AI phrasing को एक सचमुच मानवीय आवाज़ की ओर पुनर्लेखित करता है, जिससे AI स्कोर घटता है और सख़्त डिटेक्टरों के खिलाफ पाठ के टिकने की संभावना बढ़ती है, साथ ही अकादमिक टेक्स्ट पर व्याकरण की शुद्धता उच्च रहती है। ये परीक्षण-आधारित परिणाम हैं, गारंटी नहीं; और डिटेक्टर हर कुछ महीनों में अपने मॉडल फिर से प्रशिक्षित (retrain) करते हैं, इसलिए कोई भी गंभीर टूल यह दावा नहीं कर सकता कि आपका काम "100% undetectable" होगा। हम यह नहीं कहते, और आपको ऐसे किसी भी दावे पर भरोसा नहीं करना चाहिए।
फिर घोषणा (disclose) करें। वह AI-use statement जोड़ें जिसकी आपके संस्थान और लक्षित जर्नल को आवश्यकता है। Humanizing false flag से सावधानीपूर्ण लेखन की रक्षा करता है; disclosure आपको integrity rules के भीतर रखता है। आपको दोनों चाहिए। अपने ड्राफ्ट को text humanizer के माध्यम से चलाइए, हमारे multilingual AI humanizer hub में पूरा क्लस्टर देखें, और यदि आप व्याकरण-लेयर पहले संभालना चाहते हैं तो academic editing for researchers in Iran से शुरुआत करें।
स्थानीय वित्त पोषण निकाय, जर्नल, और AI-घोषणा की अपेक्षाएँ
ईरान का शोध MSRT द्वारा समन्वित होता है, जो विज्ञान, अनुसंधान और प्रौद्योगिकी मंत्रालय (Ministry of Science, Research and Technology) है। यह 2,500 से अधिक विश्वविद्यालयों और संस्थानों की निगरानी करता है, और आंशिक रूप से INSF, अर्थात ईरानी राष्ट्रीय विज्ञान फाउंडेशन, द्वारा वित्त पोषित होता है। INSF 35,000 से अधिक फैकल्टी सदस्यों के साथ काम करता है और अंतरराष्ट्रीय परियोजनाओं के लिए लगभग $44,000 तक के अनुदान (grants) देता है। ISC, शिराज़ में मुख्यालय वाला Islamic Science Citation डेटाबेस, लगभग 1,800 जर्नल्स को इंडेक्स करता है और Web of Science तथा Scopus के साथ तीसरे उद्धरण (citation) डेटाबेस की तरह कार्य करता है।
ईरान में 398 Scopus-इंडेक्स्ड जर्नल भी हैं। अंग्रेज़ी में प्रकाशित करने वाले कुछ प्रमुख शीर्षक:
- Scientia Iranica, Sharif University of Technology, इंजीनियरिंग और विज्ञान
- Iranian Journal of Science and Technology, विभिन्न विज्ञान और इंजीनियरिंग श्रृंखलाओं (series) में
- Journal of the Iranian Chemical Society, Springer द्वारा प्रकाशित और SCIE में इंडेक्स्ड
- Iranian Polymer Journal, Springer द्वारा प्रकाशित
- Archives of Iranian Medicine, उच्च प्रभाव (high-impact) वाला चिकित्सा जर्नल
- Iranian Journal of Public Health, Tehran University of Medical Sciences
- Iranian Journal of Basic Medical Sciences, Mashhad University of Medical Sciences
- Journal of Research in Medical Sciences, Isfahan University of Medical Sciences
इन सभी माध्यमों (outlets) में, और उनके पीछे काम को सपोर्ट करने वाले फंडर के संदर्भ में, अपेक्षा चुप्पी की बजाय AI सहायता की खुली घोषणा की ओर शिफ्ट हो रही है। अपनी घोषणा (disclosure statement) उस प्रारूप में लिखिए जो हर जर्नल निर्दिष्ट करता है; और यदि कभी वास्तविक काम के बावजूद किसी सबमिशन को फ्लैग किया जाए, तो उस स्कोर को contestable मानिए। AI-disclosure statement और appealing a false AI-detection flag पर हमारे गाइड दोनों प्रक्रियाओं से आपको परिचित कराते हैं। text humanizer लेखन-स्तर (writing layer) संभालता है; disclosure और आवश्यकता पड़ने पर appeal बाकी को।
अक्सर पूछे जाने वाले प्रश्न (FAQs)
प्र: क्या ईरानी शोधकर्ताओं के लिए AI ह्यूमनाइज़र यह छिपाता है कि मैंने AI का उपयोग किया?
नहीं। यह आपके अपने AI-सहायता वाले ड्राफ्ट की लय (rhythm) को इस तरह बदलता है कि फ़ारसी-प्रभावित सावधानीपूर्ण अंग्रेज़ी को गलत तरीके से फ्लैग होने की संभावना कम हो, जबकि आपका अर्थ और उद्धरण (citations) यथावत बने रहें। इसे खुले AI-use disclosure के साथ जोड़े जाने के लिए बनाया गया है, किसी चीज़ को छिपाने के लिए नहीं। नकली या उधार लिया हुआ काम छिपाना इस टूल का उद्देश्य नहीं है।
प्र: क्या प्रतिबंधों के बावजूद ईरानी शोधकर्ता इस ह्यूमनाइज़र तक पहुंच सकते हैं?
हाँ। यह प्लेटफ़ॉर्म वेब-आधारित है और ईरान से भी उपलब्ध है, और शुरू करने के लिए इसे पारंपरिक अंतरराष्ट्रीय बैंकिंग पर निर्भर नहीं होना पड़ता। इसमें एक free tier है, ताकि आप किसी भी प्रतिबद्धता से पहले इसे एक वास्तविक पैराग्राफ़ पर आज़मा सकें।
प्र: क्या ह्यूमनाइज़र मेरे उद्धरणों या तकनीकी शब्दों को नुकसान पहुँचाएगा?
नहीं। यह मॉडल संदर्भों (references), परिभाषित शब्दावली (defined terminology), और हर वाक्य के अर्थ (meaning) को सुरक्षित रखने के लिए बनाया गया है। यह शब्द-चयन (word choice) और लय (cadence) में विविधता लाता है तथा दोहराव वाले पैटर्न हटाता है, लेकिन आपके तथ्यात्मक कंटेंट और आपके citation markers आपके लिए सत्यापन हेतु उसी स्थान पर बने रहते हैं।
प्र: Turnitin या GPTZero पर वास्तव में किस तरह के pass rates की उम्मीद कर सकता हूँ?
अपने स्वयं के परीक्षण में, प्रमुख डिटेक्टरों के विरुद्ध, ह्यूमनाइज़र AI टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में पुनर्लेखित करता है, जिससे AI सिग्नल घटता है और कठिन डिटेक्टरों के खिलाफ इसकी संभावनाएँ बेहतर होती हैं, साथ ही व्याकरण की शुद्धता उच्च रहती है। ये परीक्षण-आधारित परिणाम हैं, गारंटी नहीं, क्योंकि डिटेक्टर अपने मॉडल नियमित रूप से बदलते हैं। किसी भी ऐसे वादे को कि स्कोर बिल्कुल परफेक्ट और undetectable होगा, एक चेतावनी संकेत की तरह लें।
प्र: क्या यह फ़ारसी-भाषा और मिश्रित ड्राफ्ट को सपोर्ट करता है?
हाँ। ह्यूमनाइज़र साठ से अधिक भाषाओं को सपोर्ट करता है और गैर-अंग्रेज़ी टेक्स्ट को एक भाषा-समझदार मॉडल के माध्यम से रूट करता है जो sentence structure और अर्थ (meaning) की रक्षा करता है, इसलिए आप फ़ारसी में ड्राफ्ट बना सकते हैं, उसे अकादमिक अंग्रेज़ी में अनुवादित कर सकते हैं, और फिर उसी वर्कफ़्लो के भीतर परिणाम को मानव-संगत कर सकते हैं।
ईरानी शोधकर्ताओं के लिए: सावधानी से लिखी गई फारसी-प्रभावित गद्य को संतुलित कीजिए ताकि वह स्वाभाविक लगे, अपने उद्धरण और अर्थ बनाए रखें, फिर अपने AI उपयोग का आत्मविश्वास के साथ खुलासा करें।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


