
अंग्रेज़ी में लिख रहे कज़ाख शोधकर्ताओं के लिए AI Humanizer
कज़ाख शोधकर्ताओं के लिए AI humanizer। कज़ाख और रूसी-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन फ्लैग की आशंका कम करें, अर्थ और संदर्भ (citations) बनाए रखें, और ईमानदारी से उपयोग का खुलासा करें।

कज़ाखस्तान प्रति वर्ष लगभग 7,600 Scopus-सूचीबद्ध शोधपत्रों का उत्पादन करता है और शोध-उत्पादन के मामले में विश्व में लगभग 64वें स्थान पर है, यह संख्या तेजी से बढ़ रही है, क्योंकि अब करियर इसी पर निर्भर है। एक पीएचडी उम्मीदवार कम-से-कम एक ऐसा Scopus प्रकाशन (जिसका प्रभाव-कारक सकारात्मक हो) नहीं होने पर अपना शोध प्रबंध (dissertation) प्रस्तुत/बचाव नहीं कर सकता। एक एसोसिएट प्रोफेसर (dotsent) को दो, और एक पूर्ण प्रोफेसर को तीन ऐसे प्रकाशन चाहिए। इन लगभग सभी शोधपत्रों को अंग्रेज़ी में लिखना पड़ता है। कज़ाख शोधकर्ताओं के लिए AI humanizer का अस्तित्व एक ही संकुचित, वास्तविक कारण से है: कज़ाख या रूसी-भाषी द्वारा सावधानी से लिखी गई अंग्रेज़ी को अब स्वचालित डिटेक्टर तेजी से मशीन-टेक्स्ट मान लेते हैं, और यह गलत पढ़ना आपकी सबमिशन को नुकसान पहुँचा सकता है।
EF English Proficiency Index पर कज़ाखस्तान का स्कोर 427 है, और यह "Very Low Proficiency" श्रेणी में 103वें स्थान पर रैंक करता है। अधिकांश शोधकर्ताओं की शिक्षा मुख्य रूप से कज़ाख या रूसी में हुई थी और उन्होंने बाद में अंग्रेज़ी सीखी, अक्सर स्वयं-शिक्षण (self-study) के माध्यम से। अंग्रेज़ी के पेपर पढ़ना एक कौशल है। अंतरराष्ट्रीय समीक्षकों (international reviewers) की अपेक्षाओं को पूरा करने वाला प्रकाशन-योग्य (publication-ready) पांडुलिपि तैयार करना कहीं अधिक कठिन काम है, और देश के अनुसंधान-सहायता ढांचे ने publish-or-perish की अनिवार्यता के साथ तालमेल नहीं बिठाया है।
यहाँ जाल (trap) है। जब कोई कज़ाख वैज्ञानिक साफ़, मानक (standard), पाठ्यपुस्तक-स्तर की अंग्रेज़ी लिखता है, तो उसी गद्य की पूर्वानुमेयता (predictability) को AI डिटेक्टर "generated" के रूप में पढ़ लेते हैं। दूसरी भाषा में स्पष्ट लिखने की वे आदतें, जो लिखने को सहज और स्पष्ट बनाती हैं, डिटेक्टरों की वही प्रशिक्षण-युक्त आदतें (habits) हैं जिन्हें वे पकड़ने के लिए बने हैं। यह केवल कज़ाखस्तान की समस्या नहीं है, लेकिन यहाँ त्रिभाषिक (trilingual) वास्तविकता इसे और अधिक तीक्ष्ण बना देती है।
Қазақстандық зерттеушілерге арналған AI мәтінін адамдандыру
ProofreaderPro.ai मदद करता है: हमारा humanizer कज़ाख शोधकर्ताओं को अंतरराष्ट्रीय जर्नल में सावधानी से लिखी गई, स्वाभाविक अंग्रेज़ी प्रकाशित करने में मदद करता है, बिना इसके कि उन्हें AI होने के कारण गलत तरीके से फ़्लैग कर दिया जाए। यह आपके अपने AI-सहायता प्राप्त (AI-assisted) ड्राफ्ट पर काम करता है, आपके अर्थ और संदर्भ (citations) को पूरी तरह सुरक्षित रखता है, और मानव समीक्षक के लिए स्वाभाविक रूप से पढ़ा जाता है।
कज़ाखस्तान का शोध एक ही नहीं, बल्कि दो वैज्ञानिक भाषाओं पर चलता है। कज़ाख (Қазақ тілі) राज्य की भाषा है, और रूसी (русский язык) अधिकांश लैबों और पुराने फैकल्टी में विज्ञान की कार्य-भाषा बनी हुई है। कई शोधकर्ता अपनी तर्क-श्रृंखला (reasoning) रूसी या कज़ाख में ड्राफ्ट करते हैं, फिर अनुवाद (translate) करते हैं, और अंत में अंग्रेज़ी में उसे और निखारते हैं। हमारा humanizer इस पूरे पाइपलाइन के अंत में बैठता है, जब आपका अर्थ तय हो चुका होता है, ताकि वैध कार्य को गलत positive से बचाया जा सके।
कजाख या रूसी में ड्राफ्टिंग? मानवकृत करने वाला उपकरण प्रत्येक भाषा को पहचानता है
कज़ाखस्तानी शोधकर्ता अक्सर अंग्रेज़ी में लिखने से पहले कज़ाख या रूसी में काम करते हैं, और humanizer दोनों को सीधे समर्थन देता है। कज़ाख टेक्स्ट पेस्ट करें और ProofreaderPro सिरिलिक लिपि (Cyrillic script) को स्वचालित रूप से पहचानता है, फिर उसे भाषा-जानकारी (language-aware) मॉडल के माध्यम से रूट करता है जो आपकी शब्दावली (terminology) और citations को बिल्कुल वैसे ही रखता है जैसे वे लिखे गए हैं। AI мәтінін адамдандыру के जरिए आपका कज़ाख ड्राफ्ट पहले अनुवाद किए बिना ही उतनी सहजता से मानव-सदृश (humanized) हो जाता है जितनी आपका अंग्रेज़ी ड्राफ्ट होती है। और क्योंकि डिटेक्शन साठ से अधिक भाषाओं में फैलता है, एक रूसी ड्राफ्ट भी उतनी ही आसानी से पहचाना और humanized किया जाता है।
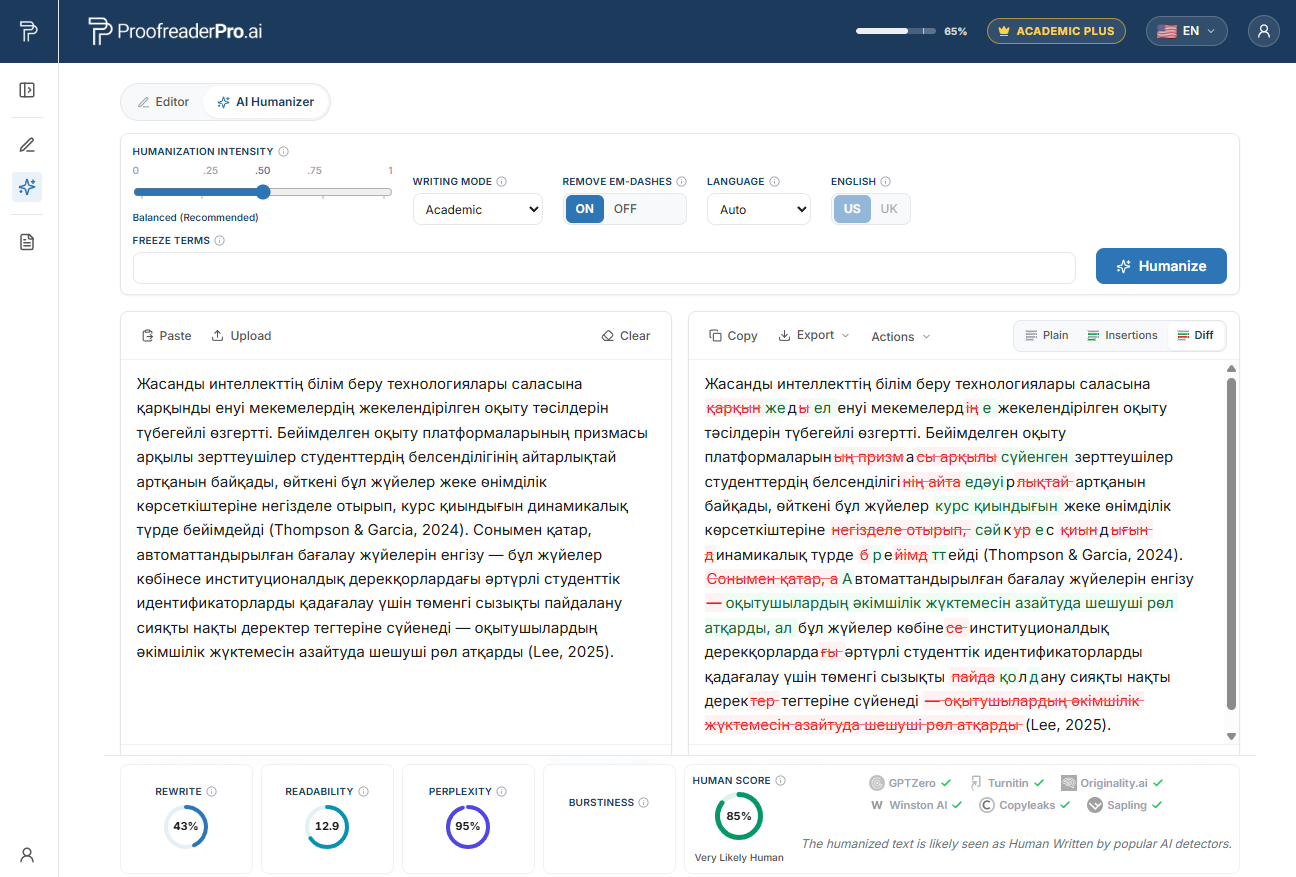
ProofreaderPro AI Humanizer कज़ाख अकादमिक टेक्स्ट को फिर से लिखता है। before और after का diff आपका अर्थ और citations सुरक्षित रखता है, और detector checks यह पुष्टि करते हैं कि पढ़ना स्वाभाविक और मानव-सदृश है।
क्यों कज़ाख शोधकर्ताओं को AI डिटेक्टर अधिक फ़्लैग करते हैं
सन् 2023 में, वीज़िन लियांग (Weixin Liang) के नेतृत्व वाली स्टैनफोर्ड टीम ने Cell Press जर्नल Patterns में "GPT detectors are biased against non-native English writers" शीर्षक से एक अध्ययन प्रकाशित किया। उन्होंने सात प्रचलित डिटेक्टरों के माध्यम से मानव-लिखित TOEFL निबंध (essays) चलाए। औसतन, गैर-मूल (non-native) लेखकों के लगभग 61% निबंधों को AI के रूप में फ़्लैग किया गया, जबकि मूल अंग्रेज़ी (native English) लेखकों के लिए यह लगभग 5% था। गैर-मूल लेखकों के लगभग हर पाँच में से एक निबंध (लगभग 19.8%) को हर डिटेक्टर ने सर्वसम्मति से फ़्लैग किया। हर निबंध मानव द्वारा लिखा गया था।
तंत्र (mechanism) perplexity है। कई डिटेक्टर यह स्कोर करते हैं कि अगला शब्द किसी भाषा मॉडल के लिए कितना "surprising" है। एक सावधान दूसरी-भाषा लेखक आम शब्द चुनता है और मानक, अनुमान-योग्य (predictable) वाक्य-विन्यास अपनाता है, जिससे perplexity कम रहती है और वह टेक्स्ट मशीन टेक्स्ट जैसा पढ़ा जाता है। एक कज़ाख शोधकर्ता, जो गलतियों से बचने के लिए औपचारिक अंग्रेज़ी में अभ्यास कर चुका है, वही बिल्कुल सहज (smooth), कम-परिवर्तन (low-variation) वाला गद्य लिखने लगता है जिसे डिटेक्टर लाल झंडे (red flag) की तरह मानते हैं। हम why AI detectors flag non-native writers में पूरे तंत्र की विस्तार से व्याख्या करते हैं।
false flags के पीछे कज़ाख और रूसी की पहली-भाषा (first-language) से जुड़े पैटर्न
यहाँ भाषाई स्थिति असामान्य है: अधिकांश शोधकर्ताओं के भीतर दो प्रकार-वैज्ञानिक (typologically distinct) भाषाओं का हस्तक्षेप (interference) एक साथ मौजूद रहता है। कज़ाख तुर्किक (Turkic) है, agglutinative है, और Subject-Object-Verb संरचना अपनाता है। रूसी स्लाविक (Slavic) है और उसमें समृद्ध case system मिलता है। न तो कज़ाख में लेख (articles) होते हैं, न रूसी में। नीचे का बिंदु यह नहीं है कि ये पैटर्न शर्मिंदा होने योग्य त्रुटियाँ (errors) हैं। बात यह है कि इन निर्माणों (constructions) के सुधारित, सावधान संस्करण मानक, कम-perplexity वाली अंग्रेज़ी बन जाते हैं, और वही है जिसे डिटेक्टर "generated" की तरह पढ़ता है।
Article discipline. न कज़ाख में "a," "an," या "the," है, न रूसी में। इसलिए कज़ाख लेख-व्यवस्था (article system) को लेखक एक अमूर्त नियम (abstract rule) की तरह सीखते हैं और फिर उसे अत्यंत निरंतरता (consistently) के साथ लागू करते हैं। "We conducted an experiment to measure the temperature of the solution" जैसा वाक्य पाठ्यपुस्तक-स्तर (textbook-correct) है, और यही पाठ्यपुस्तक-नियमितता (textbook regularity) कम perplexity के रूप में स्कोर करती है।
SOV word order, then over-correction. कज़ाख में क्रिया अंत में आती है ("Men kitapty oqydym," शाब्दिक रूप से "I book-the read"). जो लेखक जानते हैं कि अंग्रेज़ी में SVO होता है, वे सुरक्षा की दृष्टि से वाक्यों को साफ़, canonical क्रम में फिर से गढ़ते हैं। समान, अच्छी तरह निर्मित वाक्य-रचना (sentence architecture) डिटेक्टर के लिए पूर्वानुमेय (predictable) पढ़ी जाती है।
Copula restoration from Russian. रूसी वर्तमान काल में "to be" को छोड़ देता है ("Eta metod effektiven," "this method [is] effective"). कज़ाख लेखकों को हर जगह copula डालना सिखाया जाता है: "This method is effective for detecting outliers." यह सही है, और समान रूप से patterned है।
Prepositions learned as fixed pairs. रूसी उन cases का उपयोग करता है जहाँ अंग्रेज़ी preposition प्रयोग करती है; इसलिए लेखक "depends on," "consists of," "results in," और "participates in" जैसी बातों को set phrases की तरह याद करते हैं और उन्हें समान रूप से लागू करते हैं। लगातार बनने वाले collocations भी फिर कम-variation वाला टेक्स्ट ही होते हैं।
Unstacked noun phrases. कज़ाख suffixes के माध्यम से अर्थ को जोड़ता (stack) है। सावधान लेखक इसे सलीके से अंग्रेज़ी में खोलते हैं ("an analysis of the efficiency of the temperature control system"). परिणाम व्याकरणिक (grammatical), औपचारिक (formal) और सहज (smooth) होता है।
Tense regularity. चूँकि दोनों भाषाएँ अंग्रेज़ी के tense और aspect से साफ़-सुथरी मैपिंग नहीं बनातीं, इसलिए लेखक मानकीकरण (standardize) करते हैं: methods के लिए simple past, और चल रही प्रासंगिकता (ongoing relevance) के लिए present perfect। यह मानकीकरण आश्चर्य (surprise) घटाता है, और कम आश्चर्य वही है जिसके लिए डिटेक्टर दंड (penalize) देते हैं।
इनमें से कोई भी निर्माण गलत नहीं है। ये एक अनुशासित (disciplined) दूसरी-भाषा लेखक की पहचान हैं, और एक निष्पक्ष समीक्षा प्रक्रिया को कभी भी उस अनुशासन (discipline) को cheating के प्रमाण की तरह नहीं मानना चाहिए।
सावधानीपूर्वक लिखी गई अंग्रेजी को गलत AI-फ्लैग से सुरक्षित रखिए
अपने AI-सहायता प्राप्त ड्राफ्ट को मानवीय बनाइए, अपना अर्थ, उद्धरण, और तकनीकी शब्द सुरक्षित रखें, और अपने टूल के उपयोग का खुलासा वहीँ तरीके से कीजिए जैसा आपका जर्नल मांगता है। Scopus के लिए लिखने वाले Kazakh और Russian भाषी लेखकों के लिए।
Humanizer को निःशुल्क आज़माइएकज़ाखस्तान के AI-detection और Turnitin संदर्भ
कज़ाखस्तान से आने वाले थीसिस और जर्नल सबमिशन आम तौर पर similarity के लिए Turnitin या iThenticate से स्क्रीन किए जाते हैं, और AI indicators अब इन similarity स्कोरों के साथ-साथ चलने लगे हैं। कज़ाखस्तानी विश्वविद्यालय अंतरराष्ट्रीय प्रकाशन (international publishing) की ओर बहुत अधिक झुक चुके हैं, इसलिए जिस गति (push) के साथ स्क्रीनिंग टूल्स आयात होते हैं, वे अब defense और submission, दोनों के वर्कफ़्लो का बढ़ता हिस्सा बन रहे हैं।
यह स्पष्ट करना उपयोगी है कि ये स्कोर वास्तव में क्या कहते हैं। Turnitin स्वयं AI स्कोर को 1 से 19% की रेंज में दबा देता है (संख्या के बजाय asterisk दिखाता है) और चेतावनी देता है कि अखंडता (integrity) संबंधी निर्णय में केवल इसी स्कोर पर भरोसा नहीं किया जाना चाहिए। Vanderbilt ने 2023 में Turnitin के AI detector को बंद कर दिया था, false positives और non-native लेखकों के प्रति पूर्वाग्रह (bias) का हवाला देते हुए। इसी तरह Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, और Waterloo ने भी ऐसे कदम उठाए। एक डिटेक्टर का फ़्लैग करना एक ऐसा दावा (claim) है जिसे चुनौती दी जा सकती है; यह कोई अंतिम फैसला (verdict) नहीं है।
साथ ही, फंडर और जर्नल अब लेखकों से यह बताने की अपेक्षा बढ़ा रहे हैं कि उन्होंने AI टूल्स का उपयोग कैसे किया। ये दोनों तथ्य एक-दूसरे के विरोध में नहीं हैं। सीधा रास्ता यह है कि वास्तविक काम लिखें, उसे false flags से बचाएँ, और अपने टूल-उपयोग का खुलासा खुलकर करें।
शीर्ष कज़ाखस्तानी विश्वविद्यालय और जहाँ AI जाँचें दिखाई देती हैं
शोध-उत्पादन (research output) कुछ ही प्रमुख संस्थानों में केंद्रित है, अधिकांश अस्टाना, अल्माटी, और कुछ क्षेत्रीय केंद्रों में। इन प्रत्येक संस्थान में defense और submission के हिस्से के रूप में थीसिस और पांडुलिपि (manuscripts) की similarity तथा AI indicators के लिए स्क्रीनिंग होती है।
- Nazarbayev University (NU), अस्टाना, अंतरराष्ट्रीय साझेदारियों वाला प्रमुख अंग्रेज़ी-माध्यम विश्वविद्यालय
- Al-Farabi Kazakh National University (KazNU), अल्माटी, सबसे पुराना और सबसे बड़ा राष्ट्रीय विश्वविद्यालय तथा शीर्ष Scopus उत्पादक
- Satbayev University (Kazakh National Research and Technical University), अल्माटी, प्रमुख तकनीकी विश्वविद्यालय
- L.N. Gumilyov Eurasian National University (ENU), अस्टाना, प्राकृतिक विज्ञान और इंजीनियरिंग में मजबूत
- Kazakh-British Technical University (KBTU), अल्माटी, आंशिक रूप से अंग्रेज़ी-माध्यम, पेट्रोलियम और IT
- KIMEP University, अल्माटी, व्यवसाय, अर्थशास्त्र और कानून में अंग्रेज़ी-माध्यम
- Karaganda University (Ye.A. Buketov Karaganda University), करागांडा, रसायन, भौतिकी और शिक्षा
- South Kazakhstan University (M. Auezov South Kazakhstan University), शिमकेंट, रासायनिक इंजीनियरिंग और कृषि विज्ञान
- Turan University, अल्माटी, बढ़ते शोध-उत्पादन वाला निजी विश्वविद्यालय
- International Information Technology University (IITU), अल्माटी, कंप्यूटर विज्ञान और डिजिटल तकनीकें
Nazarbayev University के शोधकर्ताओं की अंग्रेज़ी आम तौर पर सबसे मजबूत होती है; फिर भी वहाँ भी एक सावधान पांडुलिपि (manuscript) AI फ्लैग में फँस सकती है। कज़ाख-माध्यम और रूसी-माध्यम संस्थानों में, जहाँ अंग्रेज़ी बाद में सीखी गई भाषा है, false-positive का जोखिम ठीक इसी कारण अधिक होता है कि लेखन इतना सुसंगत रूप से सही होता है।
कज़ाख शोधकर्ताओं के लिए AI humanizer कैसे काम करता है
वर्कफ़्लो स्पष्ट और सरल है। पहले अपना पेपर ड्राफ्ट करें, यदि आपकी तर्क-श्रृंखला वहीं बहती है तो रूसी या कज़ाख में, फिर उसे अंग्रेज़ी में अनुवाद करें। व्याकरण (grammar) ठीक करें ताकि अर्थ वही रहे जो आप वास्तव में कहना चाहते हैं। इसके बाद अपने AI-सहायता प्राप्त अंग्रेज़ी ड्राफ्ट को humanizer से चलाएँ ताकि सावधानी से लिखा गया, कम-variation वाला गद्य डिटेक्टर द्वारा गलत तरीके से पढ़े जाने की संभावना कम हो। आपके citations (APA, MLA, Chicago, IEEE, Vancouver), आपके संख्यात्मक आँकड़े (numbers), और आपकी तकनीकी शब्दावली सुरक्षित रहती है। बदलाव लय (rhythm) और शब्द-चयन (word choice) में होता है: humanizer cadence में विविधता लाता है, दोहराव वाले पैटर्न तोड़ता है, और भटके हुए em dashes जैसी संकेत-चिह्नों (tells) को हटाता है।
मुख्य डिटेक्टरों के विरुद्ध परीक्षण में, हमारा text humanizer AI टेक्स्ट को अधिक प्राकृतिक मानव-रूप में पुनर्लेखित करता है, जिससे AI सिग्नल घटता है और कड़े डिटेक्टरों के खिलाफ इसकी संभावना बेहतर होती है, साथ ही अकादमिक टेक्स्ट पर व्याकरणिक शुद्धता उच्च रहती है। ये परीक्षण परिणाम (test results) हैं, गारंटी नहीं। डिटेक्टर हर कुछ महीनों में फिर से प्रशिक्षित (retrain) होते हैं, इसलिए हम कभी कोई संख्या का वादा नहीं करते और कभी यह दावा नहीं करते कि आपका टेक्स्ट "100% undetectable" होगा। लक्ष्य धोखा नहीं, बल्कि वास्तविक कार्य के लिए निष्पक्षता (fairness) है।
फिर खुलासा करें। अपने संस्थान और लक्ष्य जर्नल जिस प्रारूप की मांग करते हैं, उसी में AI-use statement जोड़ें। अपने ड्राफ्ट को humanize करना और अपने टूल-उपयोग का खुलासा करना परस्पर विरोधी नहीं हैं, साथ मिलकर वे आपको अखंडता (integrity) के नियमों के दायरे में रखते हुए दूसरी भाषा में लिखे गए वास्तविक कार्य को false flag से बचाते हैं। यदि आपको भाषाओं के पार (across languages) सामान्य कार्य-तंत्र (general mechanics) देखना हो, तो multilingual AI humanizer hub देखें। यदि आपकी पांडुलिपि को humanize करने से पहले grammar और structure ठीक करना जरूरी है, तो वह academic editing for Kazakh researchers में शामिल है।
स्थानीय फंडिंग निकाय, जर्नल, और AI-खुलासे (AI-disclosure) की अपेक्षाएँ
Ministry of Science and Higher Education Scopus प्रकाशन (publication) की आवश्यकताओं को निर्धारित करती है और समय-समय पर उन्हें और सख़्त करती है, यही आवश्यकताएँ अकादमिक सीढ़ी (academic ladder) की हर मंज़िल के लिए गेट (gate) बनती हैं, और National Academy of Sciences of the Republic of Kazakhstan देश के बहु-विषयक (multidisciplinary) आउटपुट के बड़े हिस्से को आधार देती है। कई विश्वविद्यालय Scopus पेपरों के लिए नकद बोनस (cash bonuses) देते हैं; इससे हर सबमिशन का दाँव (stakes) और बढ़ जाता है और भाषा-आधारित (language-driven) डेस्क रिजेक्शन (desk rejection) की लागत खास तौर पर अधिक हो जाती है।
घरेलू जर्नल अंग्रेज़ी की ओर और अंतरराष्ट्रीय indexation की ओर बढ़ रहे हैं। प्रमुख शीर्षकों में Eurasian Journal of Mathematical and Computer Applications, Central Asian Journal of Medical Hypotheses and Ethics, Chemical Bulletin of Kazakh National University (Al-Farabi KazNU), Eurasian Physical Technical Journal, International Journal of Biology and Chemistry (Al-Farabi KazNU), और Reports of the National Academy of Sciences of the Republic of Kazakhstan शामिल हैं। आप इन पर लक्ष्य करें या किसी Q1 अंतरराष्ट्रीय जर्नल पर, अंग्रेज़ी की गुणवत्ता (English quality) साझा गेट है, और अब इनमें से अधिक जर्नल किसी भी AI सहायता के लिए स्पष्ट नोट (explicit note) की अपेक्षा करने लगे हैं।
हमारी सलाह स्थिर रहती है: अपने ड्राफ्ट को text humanizer से humanize करें, अपने citations को ठीक उसी तरह (exact) रखें, और एक स्पष्ट disclosure statement लिखें। यही वह वर्ज़न (version) है जो एक reviewer, एक supervisor, और आपकी अपनी अंतरात्मा (conscience), तीनों के सामने टिकता है।
अक्सर पूछे जाने वाले प्रश्न
Q: कज़ाख शोधकर्ताओं के लिए AI humanizer का उपयोग क्या cheating माना जाता है?
नहीं, जब आप इसे जिम्मेदारी से उपयोग करते हैं। आप अपने AI-सहायता प्राप्त ड्राफ्ट को स्वयं humanize करते हैं, अपने अर्थ और citations को सुरक्षित रखते हैं, और अपने AI उपयोग का खुलासा उसी प्रारूप में करते हैं जैसा आपका संस्थान और जर्नल मांगते हैं। यह भाषा-सहायता (language support) है जो वास्तविक कार्य की रक्षा करती है, न कि किसी गढ़े (fabricated) कंटेंट को छिपाने का तरीका या किसी और के लेखन को अपना बताकर पास करने का साधन।
Q: क्या humanizer सुनिश्चित करेगा कि मेरा पेपर Turnitin या GPTZero में पास हो जाए?
नहीं। प्रमुख डिटेक्टरों के विरुद्ध परीक्षण में, यह AI टेक्स्ट को अधिक प्राकृतिक मानव-रूप में पुनर्लेखित करता है, जिससे AI सिग्नल घटता है और कड़े डिटेक्टरों के खिलाफ इसकी संभावना बेहतर होती है, साथ ही अकादमिक टेक्स्ट पर व्याकरणिक शुद्धता (grammar accuracy) भी उच्च रहती है। ये परीक्षण परिणाम हैं, वादे (promises) नहीं। डिटेक्टर अक्सर फिर से प्रशिक्षित होते हैं (retrain), इसलिए कोई भी विश्वसनीय टूल किसी स्कोर की गारंटी नहीं दे सकता या यह दावा नहीं कर सकता कि आपका टेक्स्ट 100% undetectable होगा।
Q: क्या यह कज़ाख और रूसी-प्रभावित अंग्रेज़ी पर काम करता है?
हाँ। humanizer साठ से अधिक भाषाओं (more than 60 languages) को समर्थन देता है और गैर-अंग्रेज़ी-प्रभावित गद्य को भाषा-जानकारी वाले मॉडल के माध्यम से रूट करता है जो वाक्य-रचना (sentence structure) और अर्थ (meaning) को संरक्षित रखता है। कज़ाख और रूसी दोनों बोलने वाले (bilingual) वक्ताओं के लिए यह वह सहज, कम-perplexity rhythm बदलता है जिसे डिटेक्टर अक्सर गलत पढ़ते हैं, और साथ ही आपका शैक्षणिक (scholarly) टोन तथा तकनीकी शब्द सुरक्षित रखता है।
Q: सावधान कज़ाख लेखकों को अधिक sloppy लोगों की तुलना में अधिक क्यों फ़्लैग किया जाता है?
क्योंकि डिटेक्टर गुणवत्ता (quality) नहीं, बल्कि पूर्वानुमेयता (predictability) को स्कोर करते हैं। एक स्टैनफोर्ड अध्ययन में पाया गया कि मानव-लिखित गैर-मूल निबंधों में लगभग 61% को AI के रूप में फ़्लैग किया गया, जबकि मूल लेखकों (native writers) के लिए यह लगभग 5% था। एक मजबूत कज़ाख शोधकर्ता द्वारा निर्मित अनुशासित, मानक, article-correct अंग्रेज़ी वही कम-perplexity टेक्स्ट है जिसे डिटेक्टर मशीन-जनरेटेड मानते हैं।
Q: अगर मेरे manuscript को humanize और disclose करने के बाद भी फ़्लैग किया गया हो, तो मुझे क्या करना चाहिए?
फ्लैग को अंतिम फैसला (verdict) नहीं, बल्कि चुनौती (claim to contest) की तरह लें। Turnitin खुद कहता है कि उसका स्कोर अखंडता संबंधी निर्णय में अकेले उपयोग नहीं किया जाना चाहिए, और कई विश्वविद्यालयों ने false positives की वजह से AI detection को निष्क्रिय (disabled) कर दिया है। अपने ड्राफ्ट और नोट्स रखें, अपना disclosure statement साझा करें, और अपने वर्कफ़्लो को reviewer या समिति (committee) के सामने समझाएँ।
Kazakh और Russian भाषी लेखकों के लिए भाषा-सचेत Humanizer, जो उन लय-आधारित डिटेक्टरों को भ्रमित करता है जिन्हें वे गलत पढ़ लेते हैं। अर्थ और संदर्भ सुरक्षित रखें, फिर आत्मविश्वास के साथ अपने AI उपयोग का खुलासा करें।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


