
ইংরেজিতে লেখালেখি করা ইরানি গবেষকদের জন্য AI Humanizer
ইরানি গবেষকদের জন্য AI humanizer। ফার্সি-প্রভাবিত ইংরেজিতে ভুলভাবে AI শনাক্তকরণের (AI-detection) ফ্ল্যাগ কমান, অর্থ ও উদ্ধৃতি (citations) অক্ষুণ্ণ রাখুন, এবং তা সৎভাবে প্রকাশ করুন।

সিএমجیমও (SCImago) সূচক অনুযায়ী, উৎপাদিত প্রকাশনার দিক থেকে ইরান বিশ্বে ১৭তম স্থানে রয়েছে। তারা বছরে ৭৫,০০০-এরও বেশি প্রবন্ধ প্রকাশ করে। ১৯৯৭ সালের তুলনায় এটি পঞ্চাশ গুণ বৃদ্ধি, যখন প্রতি বছর প্রায় মাত্র ১,০০০টি প্রবন্ধ প্রকাশিত হতো। তবু অবাক করার বিষয় হলো, নিষেধাজ্ঞার মধ্যেও ইরানি বিজ্ঞানীরা এটা অর্জন করেছেন, যেসব নিষেধাজ্ঞা তাদের জার্নালে প্রবেশাধিকার থেকে বঞ্চিত করে, প্রকাশনার জন্য অর্থ প্রদান বাধাগ্রস্ত করে, এবং বিশ্বের গবেষণা অবকাঠামোর অনেক অংশ থেকে তাদের বিচ্ছিন্ন করে। এসব কাজের বড় অংশই ইংরেজিতে লেখা, পরিমার্জিত ও জমা দেওয়া হয়।
ইরানি গবেষকদের জন্য একটি AI humanizer আছে, এই একটাই বাস্তব কারণের জন্য: AI ডিটেক্টররা ভুলভাবে ভেবে বসে যে যত্নশীল, সঠিক, নন-নেটিভ ইংরেজি আসলে মেশিন-লেখা। ফলে সত্যিকারের মানুষ তাদের সত্যিকারের কাজের জন্য যে ক্রেডিট পাওয়ার কথা, তা হারায়। একটি ডিটেক্টর ফ্ল্যাগ কোনো কিছুর প্রমাণ নয়। এটি কেবল একটি সম্ভাব্যতা স্কোর (probability score), এবং ফার্সি বক্তাদের ক্ষেত্রে ওই স্কোর সাধারণত বেশি থাকে।
আজকাল আমাদের বেশিরভাগই কিছুটা হলেও AI সহায়তা নিয়ে খসড়া করি, একদিকে একটি আউটলাইন, অন্যদিকে কিছুটা মসৃণ অনুচ্ছেদ, অথবা ফার্সি থেকে অনুবাদ করা একটি বাক্য। এটা স্বাভাবিক, এবং আপনি তা প্রকাশ করলে বৈধও। সমস্যাটা হলো, সাধারণ ও মানসম্মত একাডেমিক ইংরেজি, টুল কখনও ব্যবহার করা হোক বা না হোক, একটি ডিটেক্টরকে ট্রিগার করতে পারে, আর দ্বিতীয় ভাষার লেখকদের ক্ষেত্রে প্রায় সবার চেয়ে বেশি ফ্ল্যাগ হওয়ার ঝুঁকি থাকে।
انسانیساز هوش مصنوعی برای پژوهشگران ایرانی
انسانیساز هوش مصنوعی به پژوهشگران ایرانی کمک میکند تا نوشتههای انگلیسی خود را طبیعیتر و روانتر کنند، معنا و ارجاعات را حفظ کنند، و مقالات خود را در مجلات بینالمللی منتشر کنند.
সহজ কথায়: আমাদের humanizer আপনার নিজস্ব ইংরেজি খসড়া নিয়ে তার ছন্দ (rhythm) এবং শব্দচয়ন (word choice) এমনভাবে বদলে দেয় যাতে ফার্সি-প্রভাবিত যত্নশীল গদ্য মেশিন টেক্সট হিসেবে ভুলভাবে পড়ে যাওয়ার সম্ভাবনা কমে। এটি আপনার অর্থ (meaning), আপনার টেকনিক্যাল টার্মস (technical terms), এবং আপনার citations ঠিক জায়গাতেই রাখে। আপনি text humanizer এর মাধ্যমে সরাসরি টুলটিতে যেতে পারেন, এবং এটি আমাদের প্রুফরিডার (proofreader) ও পার্সিয়ান-টু-ইংলিশ অনুবাদকসহ একই প্ল্যাটফর্মের মধ্যে রয়েছে।
এটি AI ব্যবহার লুকানোর কোনো কৌশল নয়। এটি বাস্তব গবেষণার ক্ষেত্রে একটি ন্যায্যতার পদক্ষেপ, তারপর স্পষ্টভাবে প্রকাশ (disclosure)। আমরা এই ক্রম নিয়েও আবার বলব, কারণ তা গুরুত্বপূর্ণ।
ফারসিতে লিখছেন? এটি স্বয়ংক্রিয়ভাবে শনাক্ত হয় এবং স্থানীয়ভাবেই মানবিক করা হয়
অনেক ইরানি গবেষক ইংরেজিতে লেখার আগে ফার্সিতে খসড়া তৈরি করেন, এবং humanizer সেটিকে সরাসরি সমর্থন করে। ফার্সি টেক্সট পেস্ট করুন, ProofreaderPro স্বয়ংক্রিয়ভাবে ডান-থেকে-বাম (right-to-left) স্ক্রিপ্ট শনাক্ত করে, তারপর এটিকে এমন একটি ভাষা-সচেতন (language-aware) মডেলের মাধ্যমে প্রক্রিয়াজাত করে যা আপনার টার্মিনোলজি (terminology) ও citations ঠিক যেমন লেখা ছিল তেমনই বজায় রাখে। انسانیساز هوش مصنوعی আপনার ফার্সি খসড়ার ওপর ঠিক ইংরেজির মতো স্বাভাবিকভাবে কাজ করে, তাই প্রথমে আলাদা করে কিছু অনুবাদ করার দরকার হয় না। অটো-ডিটেকশন ৬০টিরও বেশি ভাষা কভার করে, প্রতিটিই এমনভাবে পুনর্লিখিত হয় যেন সেটাই তার ভাষা, নিজের ভেতরেই।
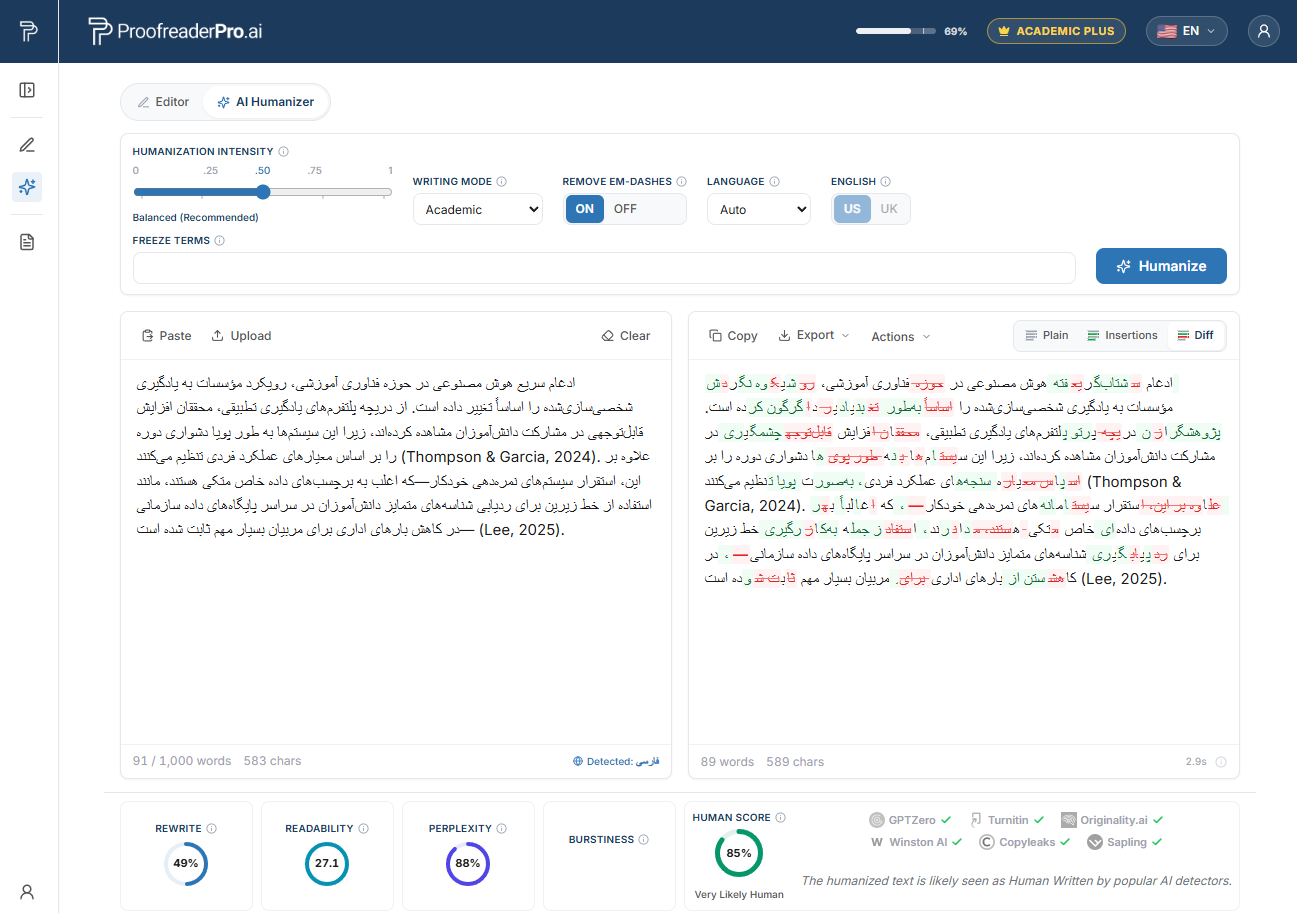
ProofreaderPro AI Humanizer যেভাবে ফার্সি একাডেমিক টেক্সটকে মানবিক করে। before-and-after diff আপনার অর্থ ও citations ধরে রাখে, এবং detector checks নিশ্চিত করে যে পাঠটি স্বাভাবিক, মানুষের মতো পড়া।
Why Iranian researchers get flagged by AI detectors
২০২৩ সালে, উইজন লিয়াং (Weixin Liang) নেতৃত্বাধীন একটি স্ট্যানফোর্ড টিম Cell Press জার্নাল Patterns-এ "GPT detectors are biased against non-native English writers" শিরোনামে একটি গবেষণা প্রকাশ করে। তারা TOEFL-এর প্রবন্ধ (essays) নেয়, সবগুলোই মানুষের লেখা, তারপর সেগুলোকে সাতটি বহুল ব্যবহৃত AI ডিটেক্টরের মধ্য দিয়ে চালায়।
গড়ে, নন-নেটিভ লেখকদের প্রায় ৬১% প্রবন্ধ AI-জেনারেটেড হিসেবে ফ্ল্যাগ করা হয়েছিল; যেখানে নেটিভ ইংরেজি লেখকদের জন্য তা ছিল প্রায় ৫%। নন-নেটিভদের প্রতিটি পঞ্চম প্রবন্ধেরও কাছাকাছি, প্রায় ১৯.৮%, প্রতিটি একক ডিটেক্টর দ্বারা সর্বসম্মতভাবে ফ্ল্যাগ হয়। এই প্রতিটি প্রবন্ধই একজন মানুষের লেখা ছিল।
এটার প্রক্রিয়াটি (mechanism) perplexity নামে পরিচিত। অনেক ডিটেক্টর মাপে কোন শব্দচয়ন কতটা অপ্রত্যাশিত (surprising) একটি ভাষা মডেলের কাছে। আপনি যখন পরিষ্কার, মানসম্মত একাডেমিক ইংরেজিতে লেখেন, কমন শব্দ এবং পূর্বানুমেয় বাক্যগঠন ব্যবহার করে, তখন আপনার টেক্সটে perplexity কম থাকে, এবং কম perplexity মেশিন টেক্সটের মতো শোনায়। দ্বিতীয় ভাষার একাডেমিক গদ্যকে পরিচ্ছন্ন ও সঠিক করে তোলার যেসব অভ্যাস আছে, ঠিক সেগুলোই এই টুলগুলো মেশিন হিসেবে চিহ্নিত করতে প্রশিক্ষিত হয়েছে। এই false-positive সমস্যার আরও পূর্ণ ব্যাখ্যার জন্য দেখুন: why AI detectors flag non-native writers।
The Persian first-language patterns behind false flags
ফার্সি গঠনগতভাবে ইংরেজি থেকে বেশ দূরে, এবং একজন ফার্সি বক্তা যখন আনুষ্ঠানিক শোনাতে যত্ন নিয়ে সংশোধন করেন, তখন তিনি অনিচ্ছাকৃতভাবে ঠিক সেই সমতল, স্ট্যান্ডার্ড ছন্দই তৈরি করতে পারেন যা একটি ডিটেক্টর synthetic হিসেবে পড়ে। এগুলো কোনো ভুল নয়। এগুলো সঠিক, সতর্ক নির্মাণ (constructions), এবং সমস্যাটাই এখানেই।
Article discipline. ফার্সিতে "the," "a," বা "an," এর সরাসরি সমতুল্য নেই, তাই ইরানি লেখকরা ইংরেজির আর্টিকেল নিয়ে কঠোর অনুশীলন করে এগুলোকে সবচেয়ে নিরাপদ, সবচেয়ে textbook-ভিত্তিকভাবে বসাতে অভ্যস্ত হন। ফলাফল পড়ে সঠিক এবং সামান্য যান্ত্রিকভাবে (mechanical), আর কম perplexity ঠিক এইটাই বোঝায়।
Rebuilt word order. ফার্সি Subject-Object-Verb (SOV) ক্রম অনুসরণ করে। ইংরেজিতে প্রকাশ করতে হলে আপনি প্রতিটি বাক্যকে সচেতনভাবে Subject-Verb-Object (SVO) ক্রমে আবার সাজান, এবং এই ইচ্ছাকৃত, এমনকি কাঠামোগতভাবে, ফ্লোটি (structure) ঠিক সেই মসৃণ cadence-ই, যেটাকে ডিটেক্টররা উৎপন্ন (generated) টেক্সটের সাথে যুক্ত করে।
Safe collocations. অনেক গবেষক ফার্সিতে খসড়া করেন, তারপর অনুবাদ করে phrases ঠিক করেন। উদাহরণ হিসেবে, "do a research"–কে তারা "conduct research" এ বদলে দেন। সংশোধিত সংস্করণটি স্ট্যান্ডার্ড ও পূর্বানুমেয়, তাই এটি ইংরেজি উন্নত করার পাশাপাশি perplexity-ও কমিয়ে দেয়।
Deductive reordering. ফার্সি একাডেমিক শৈলীতে প্রায়ই আগে প্রেক্ষাপট তৈরি করে পরে দাবিটি (claim) বলা হয়। আপনি যখন একটি অনুচ্ছেদ উল্টে ইংরেজির thesis-first প্যাটার্নে আনেন, তখন একটি পরিপাটি, সামনের দিকে বসানো কাঠামো তৈরি হয়, যা ডিটেক্টরের চোখে ফর্মুলামতো (formulaic) পড়ে।
Consistent tense and agreement. ফার্সি tense এবং verb agreement আলাদা পদ্ধতিতে চিহ্নিত করে, তাই যত্নশীল লেখকরা tense নিয়ে খুব কড়া নজরদারি করেন। Methods সেকশনের জুড়ে সমসাময়িক (uniform), ভুলহীন tense ভালো লেখা, এছাড়াও এটি কম-variance, মেশিনের মতো দেখায় এমন টেক্সট।
এর কোনোটাই মানে না যে আপনার ইংরেজি খারাপ। বরং মানে, আপনার ইংরেজি যত্নশীল (careful), এবং যত্নশীল নন-নেটিভ গদ্যই এই ডিটেক্টরগুলো প্রায়ই ভুলভাবে বিচার করে।
Iran's AI-detection and Turnitin context
ইরান থেকে থিসিস ও জার্নাল সাবমিশনগুলো নিয়মিতভাবে similarity-এর জন্য এবং ক্রমেই AI-indicators-এর জন্য স্ক্রিন করা হয়, বেশিরভাগ ক্ষেত্রে Turnitin বা iThenticate-এর মাধ্যমে। ইরানি ডক্টরাল শিক্ষার্থীদের স্নাতক হতে অন্তত একটি ISI (Web of Science) প্রকাশনা থাকতে হয়, আর অনুষদে পদোন্নতির ভিত্তি হলো Web of Science, Scopus, PubMed, বা ISC ডাটাবেসে indexed আউটপুট। ফলে প্রায় প্রতিটি গুরুত্বপূর্ণ পান্ডুলিপি কোনো না কোনো সময়ে একটি screening pipeline-এর মধ্য দিয়ে যায়।
ফ্ল্যাগ কী এবং কী নয়, এ বিষয়ে পরিষ্কার থাকা জরুরি। উপরের bias-এর কারণে কিছু প্রতিষ্ঠান AI ডিটেক্টর ব্যবহারে পিছিয়ে এসেছে। উদাহরণ হিসেবে, Vanderbilt ২০২৩ সালে false positives এবং নন-নেটিভ লেখকদের প্রতি অন্যায্যতার কারণে Turnitin-এর AI detector নিষ্ক্রিয় করে। যারা একই কাজ করেছে তাদের মধ্যে রয়েছে Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, এবং Waterloo। Turnitin ১ থেকে ১৯% রেঞ্জে স্কোর দমন করে এবং সতর্ক করে যে তার স্কোর একা কোনো integrity সিদ্ধান্ত নিতে ব্যবহার করা উচিত নয়।
তাই ডিটেক্টরের শতাংশ (detector percentage) হলো এমন একটি দাবিকে চ্যালেঞ্জ করার বিষয়, এটা কোনো চূড়ান্ত রায় (verdict) নয়। কোনো ছাত্র "Turnitin-এ মামলা করে জিতে গেছে", এমন ঘটনা নয়; আসল বিরোধ ছিল স্কুলগুলোর সাথে যে কীভাবে একটি ফ্ল্যাগ ব্যবহার করা হয়েছে তা নিয়ে। একই সময়ে, অর্থদাতা ও জার্নালগুলো গোপন করার দিক থেকে উল্টো দিকে এগোচ্ছে: তারা ক্রমেই আপনাকে AI ব্যবহারের বিষয়টি খোলাখুলি প্রকাশ করতে বলছে। এই দুইটি বাস্তবতা একসাথে একটি সরল পথ নির্ধারণ করে, ফলস ফ্ল্যাগ থেকে যত্নশীল লেখালেখিকে সুরক্ষা দেয়, এবং আপনি যে সহায়তা ব্যবহার করেছেন সেটি সৎভাবে জানানোর সুযোগ করে দেয়।
আপনার নিজস্ব AI-সাহায্যপ্রাপ্ত খসড়াটিকে মানবসুলভ করুন, প্রতিটি উদ্ধৃতি অক্ষুণ্ণ রাখুন
সাবধানে লেখা ফার্সি-প্রভাবিত ইংরেজির ছন্দ পরিবর্তন করুন, যাতে তা মেশিন-লেখা হিসেবে ভুল পড়ার সম্ভাবনা কমে। অর্থ, পরিভাষা, এবং রেফারেন্স অক্ষুণ্ণ থাকবে, তারপর আপনি আপনার AI ব্যবহারের কথা প্রকাশ করবেন।
Humanizer ফ্রি করে দেখুনTop Iran universities and where AI checks appear
ইরানের সব গবেষণা বিশ্ববিদ্যালয়ই ডক্টরাল স্নাতক এবং অনুষদ উন্নয়নের জন্য ইংরেজি ভাষায় প্রকাশনা আবশ্যক করে, এবং তাদের গ্র্যাজুয়েট স্কুল ও লাইব্রেরিগুলো সাবমিশনের আগে similarity ও AI indicators-এর জন্য থিসিস ও পান্ডুলিপি স্ক্রিন করে। প্রধান প্রতিষ্ঠানগুলোর মধ্যে রয়েছে:
- University of Tehran (دانشگاه تهران), Tehran, সবচেয়ে পুরোনো ও সর্বোচ্চ র্যাঙ্কড; সব ডিসিপ্লিনেই শক্তিশালী।
- Sharif University of Technology (دانشگاه صنعتی شریف), Tehran, প্রধান প্রযুক্তিগত বিশ্ববিদ্যালয়।
- Amirkabir University of Technology (دانشگاه صنعتی امیرکبیر), Tehran, এছাড়াও Tehran Polytechnic নামে পরিচিত।
- Iran University of Science and Technology (دانشگاه علم و صنعت ایران), Tehran।
- Tarbiat Modares University (دانشگاه تربیت مدرس), Tehran, একটি গ্র্যাজুয়েট-অনলি বিশ্ববিদ্যালয়।
- Shahid Beheshti University (دانشگاه شهید بهشتی), Tehran।
- Tehran University of Medical Sciences (دانشگاه علوم پزشکی تهران), Tehran, শীর্ষ চিকিৎসা গবেষণা প্রতিষ্ঠান।
- Isfahan University of Technology (دانشگاه صنعتی اصفهان), Isfahan।
- University of Isfahan (دانشگاه اصفهان), Isfahan।
- Ferdowsi University of Mashhad (دانشگاه فردوسی مشهد), Mashhad।
- Shiraz University (دانشگاه شیراز), Shiraz, ISC সদর দপ্তরের ঠিকানা।
- University of Tabriz (دانشگاه تبریز), Tabriz, সবচেয়ে পুরোনো বিশ্ববিদ্যালয়গুলোর একটি।
- K.N. Toosi University of Technology (دانشگاه صنعتی خواجه نصیرالدین طوسی), Tehran।
- Islamic Azad University (دانشگاه آزاد اسلامی), সারা দেশে ক্যাম্পাস, নথিভুক্তির দিক থেকে সবচেয়ে বড় সিস্টেম।
- Bu-Ali Sina University (دانشگاه بوعلی سینا), Hamedan।
এই প্রতিটি ক্ষেত্রেই চেকপয়েন্ট একই: আপনার ইংরেজি পান্ডুলিপি similarity এবং AI স্ক্রিনের মধ্যে পড়ে, আর যত্নশীল নন-নেটিভ গদ্যই ঠিক সেই ধরনের টেক্সট, যেটি প্রাপ্যতার তুলনায় বেশি স্কোর পেয়ে যায়।
ইরানি গবেষকদের জন্য AI Humanizer কীভাবে কাজ করে
ইরানি গবেষকদের জন্য AI humanizer হলো একটি ওয়ার্কফ্লোর শেষ ধাপ, এটি কোনো শর্টকাট নয়। আমরা যে ক্রমটি সুপারিশ করি তা নিচে দেওয়া হলো।
আপনি যদি ফার্সিতে আরও স্পষ্টভাবে ভাবতে পারেন, তাহলে আগে ফার্সিতে খসড়া তৈরি করুন এবং সেটিকে একাডেমিক ইংরেজিতে অনুবাদ করুন। অথবা আপনার ব্যবহৃত যেকোনো AI সহায়তা নিয়ে ইংরেজিতে খসড়া করুন। তারপর ব্যাকরণ প্রুফরিড করুন, যাতে article ব্যবহার, tense, agreement এবং preposition ঠিক থাকে। তৃতীয় ধাপে, আপনার নিজের AI-সাহায্যপ্রাপ্ত গদ্যকে humanize করুন যাতে যত্নশীল, কম-variance লেখা আবার স্বাভাবিক মানুষের মতো ছন্দে পড়ে, এবং একই সাথে আপনার অর্থ, আপনার টার্মিনোলজি, এবং আপনার citations ঠিক যেমন ছিল তেমনই থাকে।
ফলাফলের ক্ষেত্রে আমরা যা পরিমাপ করেছি তা জানাই, যা প্রতিশ্রুতি দিই তা নয়। প্রধান ডিটেক্টরগুলোর বিরুদ্ধে পরীক্ষা করে দেখা গেছে, আমাদের humanizer AI-র বাক্যগঠনকে এমনভাবে বদলে দেয় যাতে একটি সত্যিকার মানুষের মতো কণ্ঠস্বর (voice) উঠে আসে, ফলে AI স্কোর কমে এবং কঠোর ডিটেক্টরগুলোর বিপক্ষে টেক্সটের সম্ভাবনা বাড়ে, এদিকে একাডেমিক টেক্সটে ব্যাকরণের নির্ভুলতা উচ্চই থাকে। এগুলো পরীক্ষা থেকে পাওয়া ফল, নিশ্চয়তা নয়। কারণ ডিটেক্টরগুলো প্রতি কয়েক মাস পরপর তাদের মডেল রিট্রেন করে, তাই কোনো গুরুতর টুলই এমন দাবি করতে পারে না যে আপনার কাজ "100% undetectable"। আমরা তা করি না, এবং যেকোনো ব্যক্তি যদি তা দাবি করে, আপনার তাদের ওপর আস্থা করা উচিত নয়।
তারপর প্রকাশ করুন। আপনার প্রতিষ্ঠান ও লক্ষ্য জার্নাল যে AI-use statement চায় সেটি যুক্ত করুন। Humanizing একটি false flag থেকে যত্নশীল লেখালেখিকে রক্ষা করে; disclosure আপনাকে integrity নিয়মের ভেতরেই রাখে। আপনার দুটোই দরকার। আপনার খসড়াটি text humanizer এর মাধ্যমে চালান, আমাদের multilingual AI humanizer hub -এ পুরো ক্লাস্টারটি দেখুন, এবং আপনি যদি আগে ব্যাকরণ লেয়ারটা হ্যান্ডেল করতে চান, তাহলে শুরু করুন academic editing for researchers in Iran দিয়ে।
Local funding bodies, journals, and AI-disclosure expectations
ইরানের গবেষণা MSRT দ্বারা সমন্বিত, Ministry of Science, Research and Technology, যা ২,৫০০-এরও বেশি বিশ্ববিদ্যালয় ও প্রতিষ্ঠানকে তত্ত্বাবধান করে, এবং আংশিকভাবে INSF-এর মাধ্যমে অর্থায়িত হয়, Iranian National Science Foundation। এই প্রতিষ্ঠানটি ৩৫,০০০-এরও বেশি অনুষদ সদস্যের সাথে কাজ করে এবং আন্তর্জাতিক প্রকল্পগুলোর জন্য প্রায় $44,000 পর্যন্ত গ্রান্ট দেয়। ISC, অর্থাৎ Shiraz-এ সদর দপ্তর থাকা Islamic Science Citation ডাটাবেস, প্রায় ১,৮০০টি জার্নাল ইনডেক্স করে এবং Web of Science ও Scopus-এর পাশাপাশি এটি একটি তৃতীয় citation ডাটাবেস হিসেবে কাজ করে।
ইরানে আরো ৩৯৮টি Scopus-ইনডেক্সড জার্নাল রয়েছে। ইংরেজিতে প্রকাশ করে, এমন উল্লেখযোগ্য শিরোনামগুলো হলো:
- Scientia Iranica, Sharif University of Technology, engineering and science
- Iranian Journal of Science and Technology, বিভিন্ন science ও engineering সিরিজ জুড়ে
- Journal of the Iranian Chemical Society, Springer-এ প্রকাশিত এবং SCIE-indexed
- Iranian Polymer Journal, Springer-এ প্রকাশিত
- Archives of Iranian Medicine, উচ্চ ইমপ্যাক্টের চিকিৎসা জার্নাল
- Iranian Journal of Public Health, Tehran University of Medical Sciences
- Iranian Journal of Basic Medical Sciences, Mashhad University of Medical Sciences
- Journal of Research in Medical Sciences, Isfahan University of Medical Sciences
এই সব আউটলেট জুড়ে, এবং এগুলোর পেছনের কাজকে সমর্থনকারী অর্থদাতাদের ক্ষেত্রেও প্রত্যাশা বদলাচ্ছে, নীরবতার বদলে AI সহায়তার উন্মুক্ত প্রকাশের দিকে। আপনার disclosure statement প্রতিটি জার্নাল যে ফরম্যাট নির্দিষ্ট করে সেই ফরম্যাটে লিখুন, এবং কোনো সাবমিশন প্রকৃত কাজ থাকা সত্ত্বেও যদি কখনও ফ্ল্যাগ হয়, তাহলে স্কোরটিকে contestable ধরে নিন। AI-disclosure statement এবং appealing a false AI-detection flag বিষয়ে আমাদের গাইড, দুটিই দেখিয়ে দেয় কীভাবে এগোতে হয়। text humanizer লেখালেখির স্তরটি হ্যান্ডেল করে; disclosure এবং প্রয়োজনে একটি appeal বাকি অংশ সামলায়।
Frequently asked questions
প্রশ্ন: ইরানি গবেষকদের জন্য AI humanizer কি আমি AI ব্যবহার করেছি, তা লুকিয়ে রাখে?
না। এটি আপনার নিজের AI-সাহায্যপ্রাপ্ত খসড়ার ছন্দ (rhythm) পুনর্লিখন করে যাতে ফার্সি-প্রভাবিত যত্নশীল ইংরেজি ভুলভাবে ফ্ল্যাগ হওয়ার সম্ভাবনা কমে, আর আপনার অর্থ (meaning) ও citations অক্ষুণ্ণ থাকে। এটি এমন একটি উন্মুক্ত AI-use disclosure-এর সাথে জোড়া লাগানোর জন্যই তৈরি, কোনো কিছু লুকানোর জন্য নয়। বানানো (fabricated) বা ধার করা কাজ (borrowed work) লুকানো, এই টুলের উদ্দেশ্য নয়।
প্রশ্ন: নিষেধাজ্ঞা সত্ত্বেও কি ইরানি গবেষকেরা humanizer-এ প্রবেশ করতে পারেন?
হ্যাঁ। প্ল্যাটফর্মটি ওয়েব-ভিত্তিক এবং ইরান থেকেও অ্যাক্সেসযোগ্য, আর শুরু করতে প্রচলিত আন্তর্জাতিক ব্যাংকিং-এর ওপর এটি নির্ভর করে না। আপনি যেকোনো কিছু কমিট করার আগে একটি বাস্তব অনুচ্ছেদে পরীক্ষা করার জন্য একটি ফ্রি টিয়ার রয়েছে।
প্রশ্ন: humanizer কি আমার citations বা টেকনিক্যাল টার্মসের ক্ষতি করবে?
না। প্রতিটি রেফারেন্স, সংজ্ঞায়িত টার্মিনোলজি, এবং প্রতিটি বাক্যের অর্থ সংরক্ষণ করার জন্য মডেলটি তৈরি। এটি শব্দচয়ন ও cadence বদলায় এবং পুনরাবৃত্ত প্যাটার্ন সরায়, তবে আপনার ফ্যাকচুয়াল কনটেন্ট এবং citation markers আপনার যাচাইয়ের জন্য ঠিক জায়গাতেই থাকে।
প্রশ্ন: Turnitin বা GPTZero-এ আমি বাস্তবে কোন pass rate আশা করতে পারি?
আমাদের নিজস্ব পরীক্ষায়, প্রধান ডিটেক্টরগুলোর বিরুদ্ধে, humanizer AI টেক্সটকে আরও স্বাভাবিক মানুষের মতো রূপে পুনর্লিখন করে, ফলে AI সিগন্যাল কমে এবং কঠিন ডিটেক্টরগুলোর বিপক্ষে সম্ভাবনা বাড়ে, এদিকে ব্যাকরণের নির্ভুলতা উচ্চই থাকে। এগুলো পরীক্ষিত ফল, নিশ্চয়তা নয়, কারণ ডিটেক্টরগুলো তাদের মডেল নিয়মিত আপডেট করে। "পারফেক্ট" এবং "অদৃশ্য" (undetectable) স্কোরের কোনো প্রতিশ্রুতি দেখলে সেটিকে সতর্কবার্তা হিসেবে ধরুন।
প্রশ্ন: এটি কি ফার্সি ভাষার এবং মিশ্র খসড়াকে সমর্থন করে?
হ্যাঁ। humanizer ৬০টিরও বেশি ভাষা সমর্থন করে এবং নন-ইংলিশ টেক্সটকে একটি ভাষা-সচেতন মডেলের মাধ্যমে রাউট করে যা sentence structure ও meaning রক্ষা করে। তাই আপনি ফার্সিতে খসড়া তৈরি করতে পারেন, একাডেমিক ইংরেজিতে অনুবাদ করতে পারেন, এবং একটিমাত্র ওয়ার্কফ্লোরের মধ্যেই ফলাফলটি humanize করতে পারেন।
ইরানিয়ান গবেষকদের জন্য: ফার্সি-প্রভাবিত সাবধানে লেখা গদ্যকে পুনঃসমন্বয় করুন যাতে তা স্বাভাবিকভাবে পড়ে, আপনার উদ্ধৃতি ও অর্থ বজায় রাখুন, তারপর আত্মবিশ্বাসের সঙ্গে আপনার AI ব্যবহারের কথা প্রকাশ করুন।

Moe একজন NLP ইঞ্জিনিয়ার একজন PhD সহ প্রাকৃতিক ভাষা প্রক্রিয়াকরণে। তার গবেষণা কম্পিউটেশনাল ভাষাতত্ত্ব, পাঠ্য বিশ্লেষণ এবং মেশিন লার্নিংকে কভার করে এবং এটি সরাসরি ProofreaderPro-এর পিছনে সম্পাদনা এবং মানবীকরণ মডেলগুলিতে যোগ করে। তিনি প্রক্রিয়াটির অংশ সম্পর্কে লিখেছেন যা বেশিরভাগ লোকেরা কখনই দেখে না: কীভাবে একটি ভাষা মডেল একটি বাক্য পড়ে, স্কোর করে এবং কী পরিবর্তন করতে হবে তা সিদ্ধান্ত নেয়।


