OpenAI Watermark, SynthID și Claude: comparație între watermark-uri pentru text
OpenAI aplică watermark textului, există un verificator public pentru watermark OpenAI și în ce fel diferă SynthID și watermark-ul Claude, comparat pentru autori academici.
OpenAI, Google și Anthropic au construit cu toții aceeași tehnologie: un watermark statistic pentru text generat de AI. OpenAI a ținut versiunea sa în așteptare ani la rând și a început să o lanseze, ca textGrain, în octombrie 2026. Google a inclus SynthID în Gemini și a publicat metoda. Anthropic a făcut watermark-ul lui Claude obligatoriu pentru fiecare utilizator în august 2026. Dacă scrii cu asistență AI, în orice formă, toate cele trei decizii îți influențează acum modul în care documentele tale sunt evaluate.
Watermark-urile au trecut de la un subiect de cercetare la știri mainstream pe 11 august 2026, când Anthropic a anunțat că fiecare model nou de Claude își marchează ieșirea textului. Am acoperit acel anunț în detaliu în ghidul nostru Marca de apă Claude a Anthropic, explicată (2026). Acest ghid acoperă imaginea completă: ce este un watermark pentru text, cum fiecare dintre cele trei mari laboratoare l-a implementat sau l-a reținut și ce demonstrează fiecare sistem despre o lucrare.
Ce este un watermark pentru text cu AI?
Un watermark pentru text cu AI este un tipar statistic ascuns în alegerile de cuvinte ale textului generat, plasat în momentul generării, astfel încât un detector care are cheia corectă să poată verifica ulterior că textul provine de la un anumit sistem AI. Nu este o etichetă vizibilă, nu este un caracter ascuns și nu este metadata atașată unui fișier. Marcajul trăiește în cuvintele însele.
Această distincție contează, deoarece termenul „watermark” este folosit în mod lejer pentru trei lucruri diferite:
| Ce este | Unde există | Rezistă la copy-paste? | |
|---|---|---|---|
| Watermark statistic | O părtinire în care modelul alege anumite cuvinte | Textul în sine | Da |
| Metadate fișier (C2PA) | O etichetă semnată privind proveniența | Containerul fișierului | Nu, copierea în format text simplu îl elimină |
| Caractere cu lățime zero | Unicode invizibil inserat în text | Între caracterele vizibile | Nu, eliminat în mod banal |
Eşantionarea prin watermark statistic este singura dintre cele trei care supraviețuiește copierii, lipirii, tastării din nou într-un document nou și conversiei de format. De aceea cele trei laboratoare mari au convergent asupra ei pentru text și de ce „eliminatoarele de watermark” care elimină caracterele invizibile nu fac nimic împotriva ei. Pagina noastră eliminator de watermark Claude documentează acest mod de eșec cu surse.
Cum funcționează, de fapt, watermarkingul statistic?
La fiecare etapă de redactare a unei propoziții, un model de limbaj alege între mai multe cuvinte aproape echivalente, iar un watermark încarcă în liniște zarurile. Rețeta de bază a fost publicată de Kirchenbauer și colegii săi de la University of Maryland în ianuarie 2023, în Un watermark pentru modele mari de limbaj (ICML 2023). Funcționează așa:
- Înainte ca fiecare cuvânt să fie ales, o cheie secretă derivată din cuvintele anterioare împarte vocabularul într-un set preferat și un set neutru.
- Modelul își ajustează alegerea pentru a o duce spre setul preferat. „Suggest” în loc de „indicate”. „Across” în loc de „among”. Fiecare alegere individuală pare complet naturală.
- Un detector care deține cheia numără cât de des ajunge textul în seturile preferate. Scrisul uman atinge rata așteptată din întâmplare. Textul cu watermark o depășește mult și un test statistic semnalează discrepanța.
Niciun cuvânt nu este dovada a ceva. Semnalul apare doar de-a lungul zecilor sau sutelor de alegeri, motiv pentru care pasajele mai lungi sunt mai ușor de testat decât cele scurte și de ce detecția este întotdeauna probabilistică, nu o ștampilă da sau nu.
Sistemul de producție al Google DeepMind, publicat în Nature în octombrie 2024 ca Watermark scalabil pentru identificarea ieșirilor generate de modele mari de limbaj, a rafinat acest lucru cu o tehnică numită tournament sampling, care păstrează calitatea textului suficient de bine încât să poată rula în tăcere într-un produs destinat consumatorilor, la scară, în mod extensiv. Lucrarea contează și dincolo de Google: este baza publicată pe care Anthropic o indică pentru implementarea lui Claude.
Principala slăbiciune a fost publicată înainte ca majoritatea implementărilor să aibă loc. În martie 2023, Krishna și colegii au arătat în Parafrazarea evită detectoarele pentru text generat de AI (NeurIPS 2023) că regenerarea formulării unui pasaj prăbușește detecția între metode, inclusiv watermarkingul. Semnalul trăiește în secvența exactă de tokeni și nicăieri altundeva, așa că orice rescrie secvența, inclusiv un editor uman, rescrie și dovada în altă parte. Fiecare furnizor care livrează astăzi un watermark menționează această limitare în propria documentație.
OpenAI: compania care l-a inventat și l-a livrat ultima
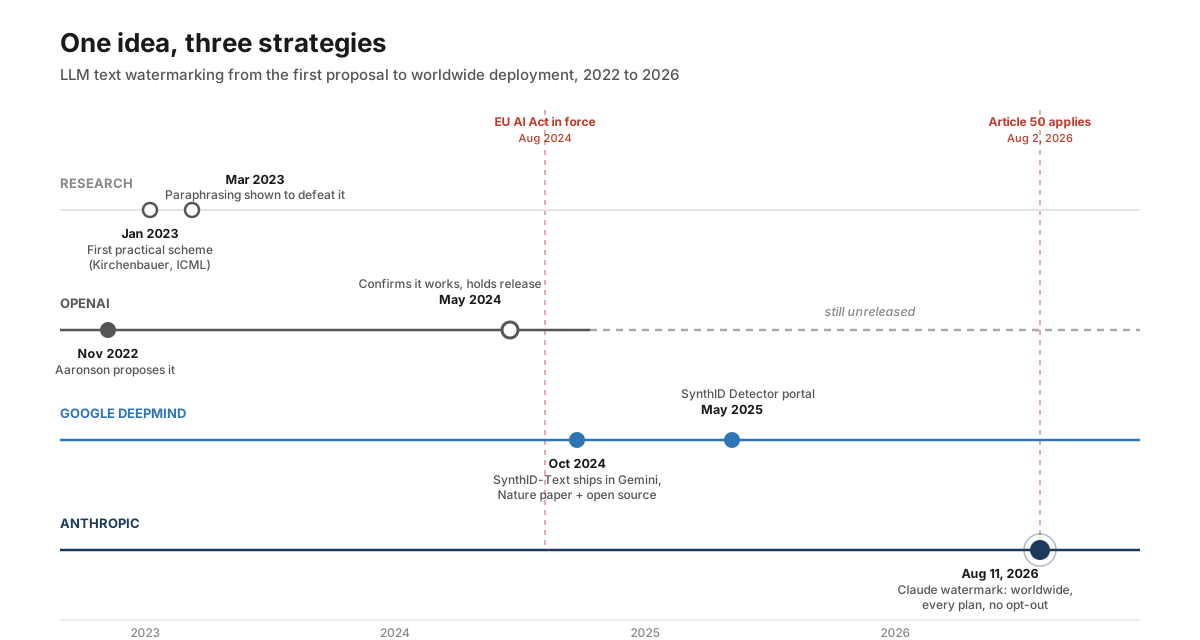
OpenAI avea un watermark funcțional pentru text de ani de zile și a ales să nu îl publice până în octombrie 2026. Scott Aaronson, care lucra atunci la siguranță la OpenAI, a descris prima dată ideea public în cadrul unei prelegeri din noiembrie 2022. Metoda înclină alegerile modelului dintre cuvinte aproape echivalente cu o funcție criptografică secretă, astfel încât chiar textul arată de unde a provenit. Acea prelegere este mai veche decât orice sistem implementat.
În mai 2024, OpenAI a descris stadiul proiectului în actualizarea privind proveniența, Înțelegerea sursei a ceea ce vedem și auzim online. Compania a spus că metoda sa de watermarking pentru text este precisă și eficientă pentru modificări minore, dar că a amânat lansarea în timp ce cântărea compromisurile. Două dintre riscurile pe care le-a numit OpenAI contează direct pentru autorii academici:
- Ocolire ușoară. Parafrazarea sau traducerea textului elimină semnul, exact așa cum a prezis cercetarea din 2023. Un watermark care prinde mai ales oamenii care nu știu că există este un instrument slab de aplicare a regulilor.
- Impact disproporționat asupra vorbitorilor non-nativi de engleză. OpenAI a declarat că watermarking-ul poate stigmatiza utilizarea legitimă a AI ca instrument de sprijin pentru scriere pentru persoanele care scriu într-o a doua limbă. Piesa noastră despre de ce detectoarele de AI semnalează scriitorii non-nativi tratează aceeași problemă din perspectiva detectorului.
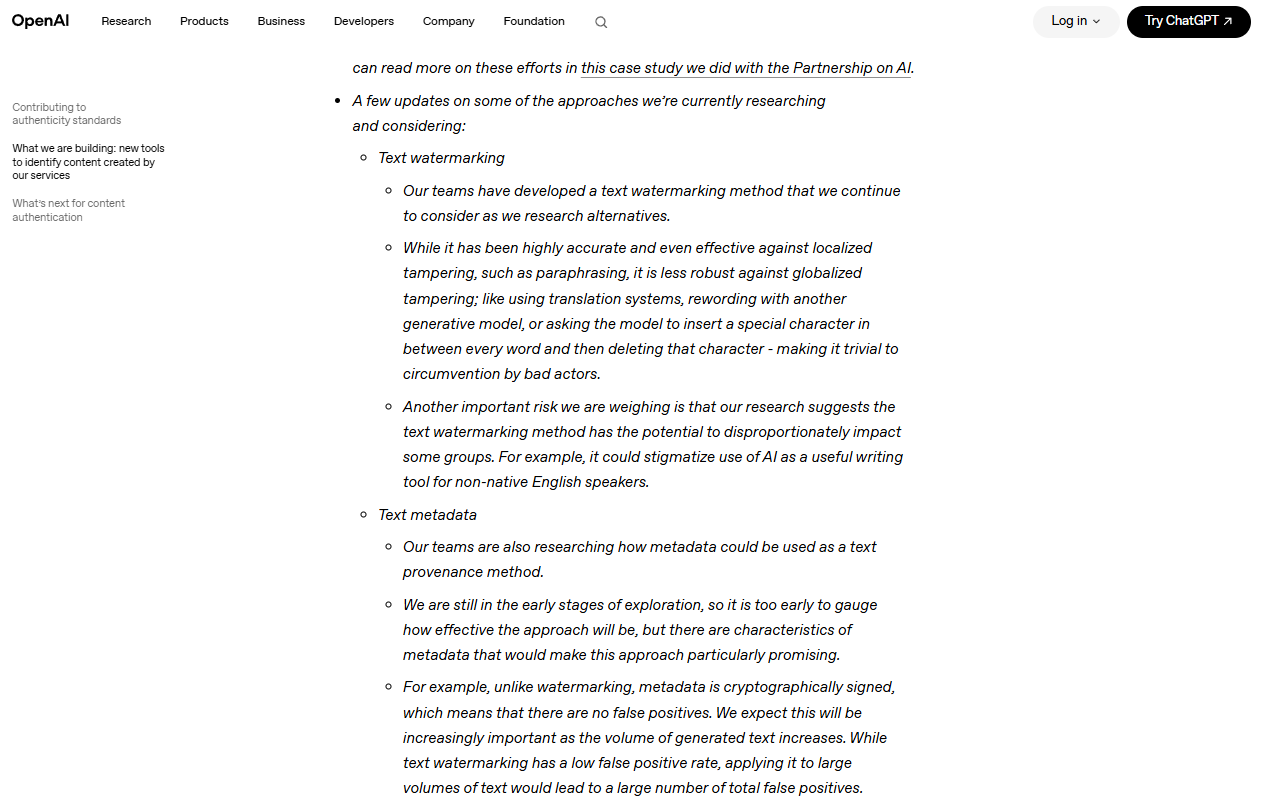
Actualizarea privind proveniența OpenAI din 2024: metoda funcționează, iar compania enumeră motivele pentru care a ținut-o pe loc la momentul respectiv.
Pentru imagini și audio, OpenAI a ales o altă rută: metadata de proveniență C2PA în ieșirile DALL-E și Sora, adică o etichetă la nivel de fișier, nu un semn în conținut. Pentru text, ieșirile ChatGPT nu aveau watermark până în octombrie 2026. Compania care a propus tehnologia a fost ultima dintre cele trei care a implementat-o.
OpenAI watermark-ează textul acum?
Da, OpenAI a început să aplice watermarking pentru o parte din text pe 5 octombrie 2026, ca răspuns la Actul UE privind AI. Anunțul său anunț introduce un watermark pentru text numit textGrain, care adaugă un semnal statistic invizibil în alegerile de cuvinte ale modelului. Lansarea are trei componente, iar watermark-ul nu este o setare implicită globală:
- Clienții API din orice locație pot activa ieșirea cu watermark pentru anumite modele. Rămâne dezactivat în mod implicit.
- În săptămânile următoare, ieșirea eligibilă generată de ChatGPT și de Codex în Uniunea Europeană primește watermark-ul, pentru toate planurile.
- Cercetătorii aprobați și organizațiile experte pot solicita acces la detectorul de watermark pentru text.
OpenAI spune că textGrain se potrivește sau depășește celelalte metode pe care le-a testat, inclusiv SynthID pentru text de la Google. De asemenea, a publicat unde detectarea slăbește. La o rată de false-positive de 1%, detectorul a identificat watermark-ul în aproximativ 80% din pasajele de 200 de tokeni și în aproximativ 95% din pasajele de 400 de tokeni pe conținut din psihologie. Detectarea a fost mult mai scăzută pentru matematică, unde există mai puțină libertate în alegerea cuvintelor.
Editarea slăbește semnalul rapid. În pasaje de 400 de tokeni, înlocuirea a 10% dintre cuvinte cu sinonime a redus detectarea de la aproximativ 92% la 66%, iar înlocuirea a 25% a redus-o la 17%.
OpenAI a verificat și dacă watermark-ul schimbă calitatea răspunsurilor pe Astra, cel mai nou model al său, și spune că nu a observat nicio diferență semnificativă. Iată patru dintre benchmarkurile pe care le-a publicat:
| Benchmark | Fără watermark (Astra) | Cu watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 puncte | 49.76 puncte |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Pentru studenți, contează data. Textul generat de ChatGPT înainte de lansare sau în afara UE fără setarea pentru API nu are watermark OpenAI. Ghidul nostru despre Turnitin Clarity explicat acoperă modul în care școlile își stabilesc, între timp, propriile politici de utilizare a AI.
Există un verificator public de watermark OpenAI?
Încă nu există un verificator public OpenAI pentru watermark-uri de text. instrumentul de verificare oferit de OpenAI, gratuit, verifică fișierele imagine și audio pentru C2PA Content Credentials și pentru un watermark SynthID. OpenAI integrează SynthID în imaginile și fișierele audio acceptate. OpenAI precizează că instrumentul nu acceptă text.
Pentru text, OpenAI oferă acces la detectoare caz cu caz, către cercetători aprobați și organizații de specialitate, prin formularul Content Provenance API. Spune că nu face detectorul de text public la lansare din cauza riscului de watermark-uri ratate și de false pozitive. Detectorul raportează dacă găsește un watermark OpenAI și nu identifică utilizatorul și nici nu afișează prompturile acestuia.
| Ce vrei să verifici | Instrument | Cine îl poate folosi |
|---|---|---|
| Un fișier imagine sau audio OpenAI | Instrumentul de verificare OpenAI | Oricine, gratuit |
| Ieșire text OpenAI (textGrain) | Detector de watermark pentru text OpenAI | Cercetători aprobați și organizații de specialitate, prin cerere |
| Ieșire text Claude | Detectorul de watermark Claude | Organizații eligibile, prin cerere (vezi ghidul nostru pentru watermark-ul Claude) |
OpenAI este, de asemenea, clar cu privire la ce nu poate spune un rezultat. Un watermark detectat nu măsoară cât de mult a contribuit o persoană și nu identifică cine a scris sau a folosit textul. Nici absența unui watermark nu demonstrează autorat uman, deoarece textul poate fi prea scurt, editat, tradus sau provenit de la un model neacceptat.
Google: primul care a lansat, apoi a dat rețeta mai departe
Google DeepMind a lansat primul, a publicat integral și apoi a deschis metoda. Sistemul său, SynthID, a început ca un watermark de imagine în 2023 și s-a extins la text în 2024. Până când a apărut lucrarea Nature în octombrie 2024, SynthID-Text rula deja în producție în Gemini, ceea ce l-a făcut primul watermark statistic de text implementat la scară de masă, pentru consumatori.
SynthID acoperă text, imagini, audio și video și este în producție în ieșirea Gemini pentru text din octombrie 2024.
Apoi, Google a publicat implementarea ca open source pe Hugging Face, permițând oricărui dezvoltator să aplice aceeași schemă de watermarking propriilor modele. În mai 2025, a anunțat SynthID Detector, un portal de verificare în care conținutul poate fi analizat pentru marcaje SynthID în text, imagini, audio și video.
Există o limitare importantă de domeniu: SynthID marchează și detectează doar conținut din modelele proprii ale Google. Nu spune nimic despre ieșirea ChatGPT sau Claude, iar o scanare SynthID curată nu înseamnă că textul a fost scris de un om. Înseamnă doar că modelele Google nu l-au scris, ceea ce este o afirmație mult mai îngustă.
Anthropic: ultimul care a mișcat, cu cea mai strictă politică
Anthropic a implementat cel mai târziu, cu cea mai largă acoperire obligatorie. Fiecare model Claude lansat la data de 2 august 2026 sau după această dată înglobează un watermark statistic în ieșirea sa de text, la nivel mondial, pe fiecare plan, fără opțiune de renunțare. Compania descrie mecanismul în prezentarea sa, Cum funcționează watermark-ul de text al lui Claude, iar aria de aplicare a politicii în articolul din centrul de ajutor, Cum marchează Claude conținutul generat de AI: Claude API, claude.ai, Claude Code, Claude Cowork și Claude Tag sunt incluse. Modelele lansate înainte de termen sunt într-o perioadă de tranziție, iar Anthropic spune că adaugă suport pentru marcaje și pentru acestea. Împreună cu marcajul statistic, fișierele generate de Claude includ și metadate C2PA, un al doilea sistem, separat, pe care copierea simplă în text îl elimină.
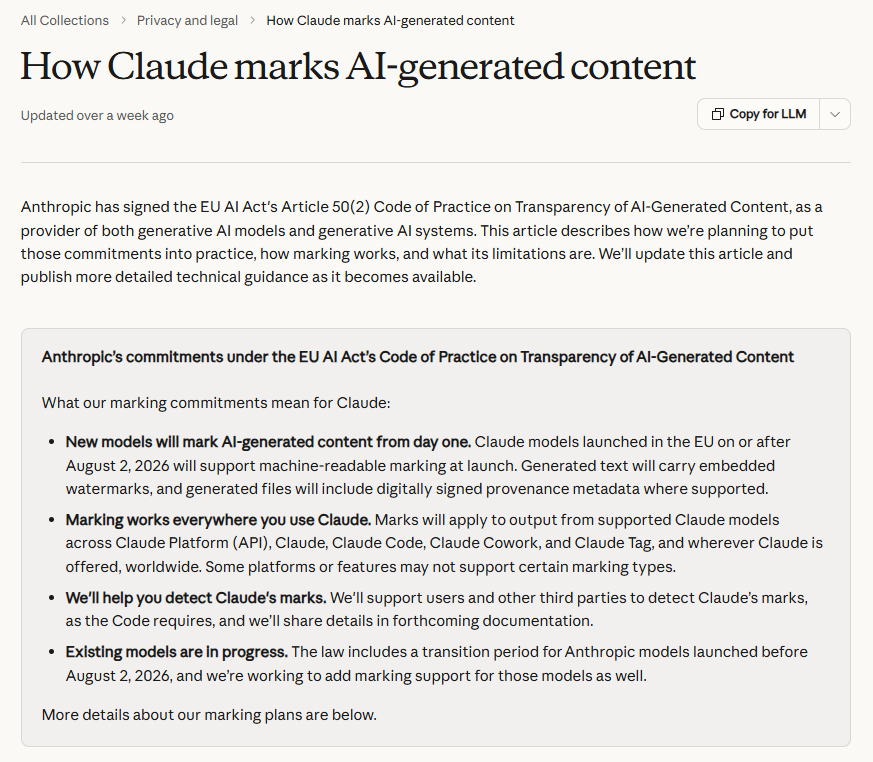
Politica, în cuvintele Anthropic: fiecare model nou, fiecare platformă, la nivel mondial, cu modelele mai vechi adăugate ulterior.
Documentația Anthropic precizează limitele direct. Detectarea este probabilistică. Marcajul nu poate distinge un document scris de Claude de un document scris de un om și editat ușor de Claude. O rescriere completă îl elimină. Am parcurs toate acestea, inclusiv ce dovedește, în mod real, o detectare pozitivă și ce să faci dacă propriul tău text este marcat, în ghidul dedicat pentru watermark Claude.
Momentul urmează reglementarea. Anthropic a semnat Codul de practică pentru transparența conținutului generat de AI, Articolul 50(2), sub EU AI Act, care cere furnizorilor de sisteme de AI generativ să se asigure că ieșirile sunt "marcate într-un format citibil de mașină și detectabile ca fiind generate artificial". Aceste obligații de transparență au devenit aplicabile pe 2 august 2026: data limită exactă din politica de modele a Anthropic, cu nouă zile înainte de anunțul public. Anthropic a ales să respecte la nivel global, în loc să mențină un comportament separat pentru traficul din UE. Google era deja conform, prin proiect. Textul fără marcaj al OpenAI este întrebarea-cheie pentru conformitatea din 2027.
Cele trei abordări, alăturate
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Watermark text implementat? | Da (textGrain, lansare în UE din 5 octombrie 2026) | Da (Gemini, din octombrie 2024) | Da (modelele Claude, din 2 august 2026) |
| Tehnică | textGrain, un semnal statistic în alegerile de cuvinte | SynthID-Text, eșantionare tip turneu | Marcaj prin eșantionare statistică, similar SynthID |
| Acoperire | Text eligibil ChatGPT și Codex în UE; opt-in prin API la nivel mondial | Modelele Google doar | Toate noile modele Claude; modelele mai vechi în tranziție |
| Renunțare (opt-out) | Dezactivat implicit în API | Nu | Nu |
| Detector public | Nu | Portalul SynthID Detector (2025) | Plănuit, dar încă nepublicat |
| Schema publicată? | Doar prelegeri cu idei generale | Articol Nature + open source | Explicație, bazată pe lucrări publicate |
| Metadate fișier (C2PA) | Da, imagini și audio | Da, pe mai multe tipuri de media | Da, pe fișiere generate |
| Limitări declarate | Ocolire, stigmat ESL | Domeniu limitat la propriile modele | Probabilistic, editările estompează atribuirea autorului |
Modelul dintre coloane: OpenAI tratează watermarking-ul textului ca pe o problemă de politică încă nerezolvată, Google îl tratează ca pe o infrastructură de standardizat, iar Anthropic îl tratează ca pe o obligație de conformitate de implementat pe deplin.
Ce înseamnă asta pentru cercetători și pentru cei care scriu academic
Consecințele practice depind de ce instrumente ating textul tău. Dacă îl redactezi cu ChatGPT, textul tău nu are watermark astăzi. Dacă îl redactezi cu Gemini, acesta poartă un marcaj SynthID pe care îl poate citi doar detectorul Google. Dacă îl redactezi sau îl editezi cu un model Claude din prezent, acesta poartă marcajul Anthropic, iar nu există o setare care să îl oprească.
Trei lucruri pe care scriitorii academici ar trebui să le știe:
Un watermark identifică un instrument, nu un autor. Fiecare furnizor menționează acest lucru în propria documentație și merită repetat deoarece politicile instituționale nu fac întotdeauna diferența. Textul poate fi marcat deoarece o AI l-a redactat, deoarece o AI i-a făcut copy-edit pentru două propoziții, sau deoarece un paragraf marcat a fost citat. Dacă instituția ta efectuează verificări pentru watermark-uri, ceea ce dovedește verificarea este că un anumit model a atins textul la un moment dat, nu mai mult. Ghidul nostru despre contestarea unui fals semnal de detecție AI explică cum să susții acest argument atunci când contează.
Watermark-urile și detectoarele AI sunt tehnologii diferite, cu moduri diferite de eșec. Detectoarele precum Turnitin sau GPTZero estimează pe baza stilului statistic, cu problemele de acuratețe pe care le-am documentat. Detectarea watermark-ului este un test bazat pe cheie, cu o rată foarte mică de rezultate fals pozitive pentru text uman nemarcat. Asimetria se inversează pentru rezultate fals negative: o verificare a watermark-ului pierde orice text AI de la un model care nu marchează, ceea ce astăzi include toate de la ChatGPT.
Dezvăluirea rămâne cea mai solidă poziție. Watermark-urile fac utilizarea silențioasă a AI mai riscantă și utilizarea de AI cu dezvăluire mai sigură, deoarece un workflow dezvăluit nu are nimic de temut de la un marcaj pozitiv. Majoritatea revistelor și universităților au acum politici explicite privind utilizarea AI; politica noastră de utilizare AI explică unde trasăm aceste limite între propriile noastre instrumente și este un șablon rezonabil pentru ceea ce arată utilizarea transparentă.
Ce elimină un watermark al textului și ce nu
Rescrierea îl elimină; reformatatrea nu. Copierea, lipirea, schimbarea fonturilor, conversia între formate de fișiere și eliminarea caracterelor invizibile lasă watermark-ul statistic complet intact, deoarece marcajul este în alegerea cuvintelor. Ce îl elimină este orice lucru care regenerează formularea: o editare profundă realizată de om, o traducere sau o parafrază autentică, așa cum s-a stabilit în lucrările de robustete NeurIPS 2023, înainte ca oricare dintre aceste sisteme să fie lansate.
Aici contează ambele direcții. Faptul că un marcaj dispare nu înseamnă că textul este al tău, iar faptul că un marcaj rămâne nu înseamnă că textul nu este al tău. Un draft rescris de AI rămâne un document asistat de AI, iar regulile de declarare ale instituției tale se aplică și acestuia. Acest humanizer AI de text rescrie drafturile asistate de AI într-un registru academic natural, iar deoarece în timpul acestui proces se regenerează secvența de simboluri, marcajele statistice nu supraviețuiesc. Pentru textul de Claude, în mod specific, eliminatorul gratuit de watermark Claude reexprimă fiecare propoziție cu formulări proaspete, păstrând neschimbate faptele, numerele și citările. Ceea ce nicio unealtă nu poate modifica este ceea ce îi datorezi cititorului: transparența despre cum a fost creat documentul.
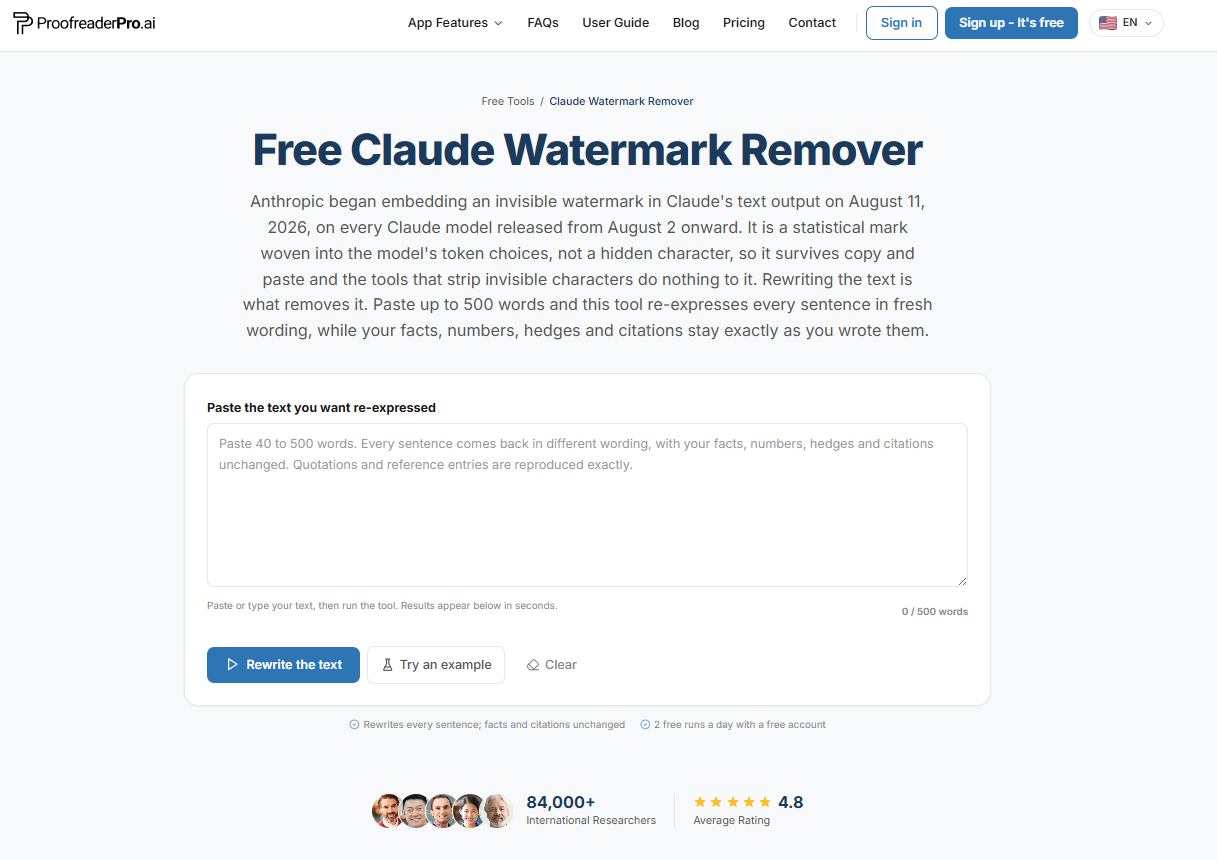
Rescrierea este singura operațiune care elimină un marcaj statistic și exact aceea face acest instrument, propoziție cu propoziție.
Unde urmează să ajungă
Urmărește trei lucruri până în 2027. În primul rând, dacă OpenAI duce textGrain dincolo de UE: a început acolo deoarece aplicarea în UE a articolului 50 impune marcaje pe textul generat, lizibile de mașină. În al doilea rând, dacă detectoarele converg. Dacă fiecare laborator major aplică watermarkuri cu o schemă publicată, universitățile pot verifica cheile, nu pot ghici după stilul de scriere, ceea ce ar îmbunătăți detectarea predispusă la rezultate fals-pozitive. În al treilea rând, dacă marcajele devin compatibile. Astăzi, trei laboratoare folosesc trei marcaje diferite, iar nicio verificare unică nu le acoperă pe toate. C2PA umple acest gol pentru fișiere, iar pentru textul brut încă nu există o soluție similară.
ChatGPT își watermark-ează textul?
Da, parțial, începând cu 5 octombrie 2026. OpenAI a început să adauge watermarkul textGrain textului ChatGPT și Codex eligibil din Uniunea Europeană, iar clienții API din orice parte pot să îl activeze. Watermarkul este un semnal statistic în alegerile de cuvinte, fără caractere ascunse. OpenAI aplică C2PA la metadatele de proveniență pentru fișierele media DALL-E și Sora, însă aceasta este o schemă separată, la nivel de fișier.
Gemini de la Google își watermark-ează textul?
Da. Ieșirea Gemini a purtat watermarkul SynthID-Text al Google DeepMind încă din octombrie 2024. Este un marcaj statistic în alegerile de cuvinte, invizibil pentru cititori și verificabil prin SynthID Detector-ul Google. Se aplică doar modelelor proprii ale Google, deci un rezultat negativ SynthID nu spune nimic despre textul provenit de la alte sisteme AI.
Claude își watermark-ează textul?
Da. Fiecare model Claude lansat la sau după 2 august 2026 încorporează un watermark statistic în ieșirea sa textuală, pe fiecare platformă și plan, fără opțiune de dezactivare, iar fișierele generate de Claude poartă suplimentar metadate C2PA. Modelele lansate înainte de acea dată nu marchează încă ieșirea lor; Anthropic spune că adaugă suport pentru marcaje în perioada de tranziție. Detaliile complete sunt în explicatorul nostru despre watermarkul Claude.
Pot universitățile să detecteze watermarkuri AI?
Doar cu cooperarea furnizorului, deoarece detectarea necesită cheia acestuia. Google oferă un portal public pentru detectarea conținutului SynthID. Anthropic spune că suportul pentru detectare pentru utilizatori și terți este planificat, dar încă nu a lansat un detector public. Niciun suite mainstream de verificare a plagiatului nu poate verifica în prezent watermarkurile statistice de la vreun laborator, deci „detectarea AI” la nivel instituțional înseamnă, astăzi, în continuare, ghicit bazat pe stil, nu verificare prin watermark.
Watermarking-ul AI este cerut prin lege?
În UE, da, în practică. Articolul 50(2) din Actul UE privind AI obligă furnizorii de AI generativă să se asigure că ieșirile sunt marcate într-un format lizibil de mașini și pot fi detectate ca fiind generate artificial, cu obligații de transparență aplicabile începând cu 2 august 2026. Anthropic a semnat Codul de practică aferent și a ales conformarea la nivel mondial. Modul în care autoritățile tratează watermark-ul text nepublicat al OpenAI este întrebarea de urmărit în 2027.
Rezistă watermark-urile AI la traducere?
Nu. Un watermark statistic trăiește în exact secvența de cuvinte pe care modelul a ales-o, iar traducerea înlocuiește fiecare cuvânt. Același lucru este valabil și pentru parafrazarea profundă și editarea umană masivă. Această limitare este documentată în literatura supusă evaluării inter pares și recunoscută de fiecare furnizor care livrează un watermark.
Există un verificator public pentru watermark-ul OpenAI la text?
Nu, instrumentul public de verificare al OpenAI verifică doar fișiere imagine și audio, pentru metadata C2PA și watermark-urile SynthID. OpenAI spune că nu suportă text. Detectorul pentru watermark-ul de text este disponibil doar pentru cercetători aprobați și organizații experte, de la caz la caz.
Ce este textGrain?
textGrain este watermark-ul de text al OpenAI, anunțat la 5 octombrie 2026. Adaugă un semnal statistic invizibil alegerilor de cuvinte ale modelului, astfel încât marca face parte din cuvinte, fără caractere ascunse sau metadata de fișiere. OpenAI afirmă că a egalat sau depășit celelalte metode testate, inclusiv SynthID pentru text, și că editarea îl slăbește.
Pot cercetătorii să solicite acces la detectorul watermark-ului de text al OpenAI?
Da, cercetătorii aprobați și organizațiile experte pot aplica prin formularul OpenAI pentru Content Provenance API. OpenAI acordă acces de la caz la caz, în cadrul UE, conform Codului de practică. Spune că va reevalua accesul mai larg pe măsură ce tehnologia și dovezile se dezvoltă.
Surse
- Anthropic, Cum funcționează watermark-ul de text al lui Claude, august 2026
- Anthropic Help Center, Cum marchează Claude conținut generat de AI, 2026
- OpenAI, Înțelegerea sursei a ceea ce vedem și auzim online, mai 2024
- Google DeepMind, SynthID
- Dathathri și colab., Watermarking scalabil pentru identificarea ieșirilor generate de modelele lingvistice mari, Nature, octombrie 2024
- Google, Anunțul detectorului SynthID, mai 2025
- Hugging Face, Introducerea SynthID Text, octombrie 2024
- Kirchenbauer și colab., Un watermark pentru modelele lingvistice mari, ICML 2023
- Krishna și colab., Parafrazarea ocolește detectoarele pentru text generat de AI, NeurIPS 2023
- Scott Aaronson, Prelegerea mea despre siguranța AI pentru UT Effective Altruism, noiembrie 2022
- Uniunea Europeană, AI Act, articolul 50
- C2PA, Coalition pentru verificarea provenienței și autenticității conținutului
Dana este creatoare de conținut la ProofreaderPro, unde conduce zilnic blogul și operațiunile de scriere. Ea scrie articolele despre modul în care funcționează platforma de editare online și se ocupă de mesajele clienților în fiecare zi, cu un scor de satisfacție de cinci stele pentru asta.