
Humanizer AI dla włoskich badaczy piszących po angielsku
Humanizer AI dla włoskich badaczy. Ogranicz liczne fałszywe alarmy wykrywania sztucznej inteligencji w angielskim kształtowanym przez język włoski, zachowując sens i cytowania; działaj uczciwie i ujawniaj użycie zgodnie z zasadami.

Włochy należą do światowej czołówki – do ośmiu–dziesięciu krajów – pod względem liczby publikacji naukowych, a jednak prawie żadna z tych prac nie dociera do czytelników w języku włoskim. Tamtejsi akademicy myślą i tworzą w jednym języku, a publikują w innym, ponieważ włoska kariera badawcza przebiega przez indeksowane czasopisma naukowe w języku angielskim. Ocena jakości badań w ramach VQR oraz krajowe kwalifikacje ASN na potrzeby uzyskania profesury opierają się na progach bibliometrycznych w Scopus i Web of Science, więc artykuł po angielsku we właściwym czasopiśmie nie jest opcjonalny.
Teraz ta presja zderza się z nowszym problemem. Humanizer AI dla włoskich badaczy istnieje dlatego, że staranne, poprawne angielskie zdania w drugim języku to dokładnie ten typ prozy, który wykrywacze AI mylą z pisaniem maszynowym. Twój kolega wykonał pracę, napisał każde słowo, a mimo to otrzymał flagę.
Ten poradnik dotyczy sprawiedliwości, nie ukrywania. Celem jest zhumanizowanie własnego, wspomaganego AI szkicu – przy zachowaniu sensu i cytowań – a następnie ujawnienie użycia AI tak, jak wymaga tego twoja instytucja i czasopismo.
Włoski umanizzatore di testo IA dla ricercatori italiani che pubblicano in inglese
Nasz umanizzatore di testo IA pomaga włoskim badaczom publikować po angielsku bez tego, by poprawnie brzmiące teksty były mylone z treściami wygenerowanymi przez maszynę. Zachowuje znaczenie, terminologię techniczną i cytowania oraz różnicuje rytm i dobór słów.
W prostych słowach: to ty piszesz naukę, a narzędzie wygładza „statystyczny odcisk palca”, przez który standardowa proza osoby niebędącej rodzimym użytkownikiem języka angielskiego bywa odczytywana jako syntetyczna. Nic w twoim rozumowaniu, danych ani referencjach się nie zmienia. Zmienia się natomiast równa, przewidywalna kadencja, którą część wykrywaczy traktuje jak maszynowy podpis.
Piszesz po włosku? Umanizzatore wykrywa to i przepisuje bezpośrednio
Możesz zhumanizować włoski szkic bez wcześniejszego tłumaczenia go na angielski. Wklej swój tekst, a ProofreaderPro automatycznie wykryje język, po czym przekieruje go do modelu świadomego realiów języka włoskiego, który zachowuje akcenty, terminologię i cytowania „na miejscu”. Jako umanizzatore di testo IA różnicuje rytm twojej włoskiej prozy, jednocześnie zachowując każde ustalenie i każdą referencję. Automatyczne wykrywanie obejmuje ponad sześćdziesiąt języków, więc język włoski jest traktowany jako włoski, a nie przekształcany w angielski.
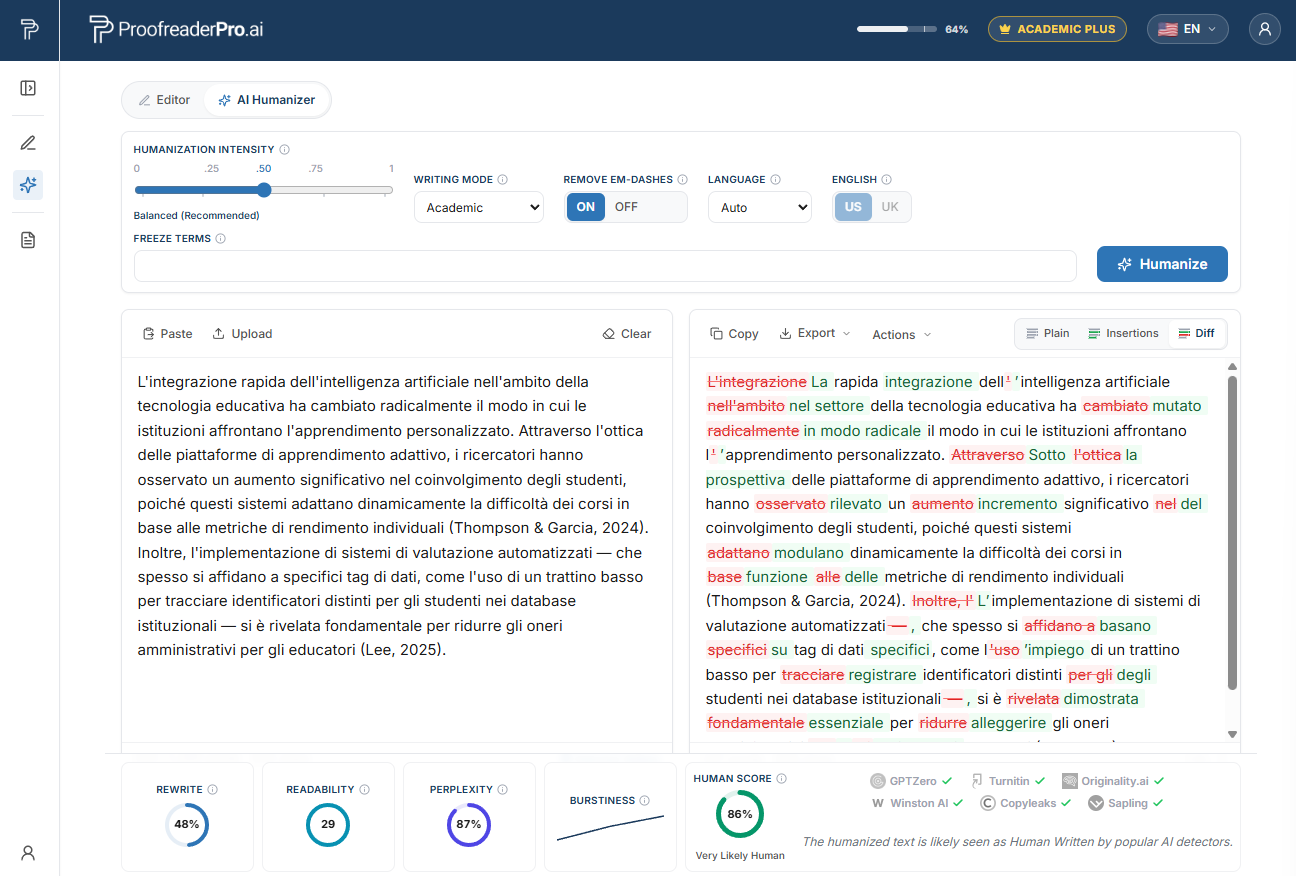
ProofreaderPro AI Humanizer przerabia włoski tekst akademicki. Zmiana „przed–po” zachowuje sens i cytowania, a testy wykrywacza potwierdzają naturalny, ludzki odbiór.
Dlaczego włoscy badacze dostają flagi od wykrywaczy AI
W 2023 roku zespół ze Stanford, kierowany przez Lianga i współpracowników, opublikował badanie w czasopiśmie Cell Press „Patterns” o bezpośrednim tytule: GPT detectors are biased against non-native English writers. Przepuścili oni napisane przez ludzi eseje TOEFL przez siedem powszechnie używanych wykrywaczy.
Wynik powinien niepokoić każdego, kto publikuje w drugim języku. Średnio około 61% esejów napisanych przez osoby niebędące rodzimymi użytkownikami języka angielskiego zostało oznaczonych jako AI, w porównaniu do około 5% w przypadku autorów rodzimych. Prawie jedna piąta, czyli ok. 19,8%, była oznaczona jednomyślnie przez każdy wykrywacz. Każdy z tych esejów był napisany przez człowieka.
Mechanizm nazywa się „perplexity”. Wykrywacze mierzą, jak zaskakujący dla modelu językowego jest każdy wybór słowa. Uważni autorzy, piszący w drugim języku, sięgają po częste słowa i standardowe, przewidywalne sformułowania, co daje niską perplexity – a ta jest odbierana jako tekst maszynowy. Nawyk, który sprawia, że twój angielski jest klarowny, jest tym samym nawykiem, za który te narzędzia zostały wytrenowane „karać”. Rozbijamy to dalej w dlaczego wykrywacze AI oznaczają tekst pisany przez osoby niebędące native speakerami.
Wzorce typowe dla włoskiego jako języka pierwszego stojące za fałszywymi flagami
Żaden z poniższych wzorców nie jest błędem. To staranne, podręcznikowe konstrukcje, po które sięga włoski uczony – a ta sama regularność sprawia, że wykrywacz odczytuje je jako niską perplexity.
Długie zdania hipotaktyczne. Włoski styl akademicki preferuje długie okresy z wieloma zagnieżdżonymi zdaniami podrzędnymi. Przeniesione na angielski pozostają poprawne gramatycznie, ale stają się gęstsze, a równa, nadmiernie „dopieszczona” rytmika wygląda przewidywalnie dla modelu.
Artykuły z rzeczownikami abstrakcyjnymi. Pisanie natury, nauki lub społeczeństwa – gdy w angielskim zazwyczaj pomija się rodzajnik – to bezpośredni i konsekwentny transfer z włoskiego. Ta konsekwencja jest dokładnie sygnałem, za który wykrywacze „premiują” niską punktację.
Transfer przyimków. Depend from z dipendere da lub on the basis of zamiast based on – to systematyczne wybory rządzone regułami. Systematyczne wybory są z definicji niską perplexity.
Nominalizacja i łaciński (Latinate) dobór słów. Ciężkie frazy rzeczownikowe typu the realization of the analysis oraz stała preferencja dla słownictwa o rodowodzie łacińskim to standardowy formalny rejestr. Formalny i standardowy jest dokładnie tym, co te narzędzia oznaczają.
Kalkowane łączniki. Częste łączniki na początku zdania, takie jak Moreover, Furthermore oraz In fact – przenoszone z włoskich znaczników dyskursu – dodają regularną, powtarzalną kadencję, która brzmi jak „wygładzone” przez maszynę.
Fałszywi przyjaciele. Attualmente przesuwane w stronę actually zamiast currently lub eventualmente przesuwane w stronę eventually zamiast possibly – to korekty, których dokonuje uważny autor, dążąc do najbardziej „standardowo wyglądającego” słowa. To najbardziej standardowe słowo jest też najmniej zaskakujące.
Kontekst wykrywania AI we Włoszech i Turnitin
Włoskie prace doktorskie i manuskrypty są rutynowo sprawdzane pod kątem podobieństwa tekstu, najczęściej z użyciem Turnitin lub iThenticate, a narzędzia te coraz częściej ujawniają wskaźniki AI obok znanego wyniku podobieństwa. Raport podobieństwa jest normalną praktyką na uczelniach doktoranckich i w procesach redakcyjnych, a samo to nie mówi nic o twojej uczciwości.
Warto utrzymać w perspektywie dwie kwestie. Po pierwsze, wskaźnik AI jest twierdzeniem, nie wyrokiem. Sam Turnitin tłumi wyniki z zakresu 1 do 19% i ostrzega, że jego liczba nie powinna samodzielnie przesądzać o sprawie dotyczącej integralności. Kilka uczelni, w tym Vanderbilt, Michigan State i UT Austin, wyłączyło wykrywacz AI całkowicie, powołując się na fałszywe pozytywy i uprzedzenia wobec autorów niebędących native speakerami.
Po drugie, we Włoszech – podobnie jak gdzie indziej – kierunek zmian idzie w stronę ujawniania użycia AI. Instytucje finansujące i czasopisma coraz częściej proszą, aby wskazać, gdzie i w jaki sposób korzystałeś z AI. Oczekiwanie to jest twoją ochroną: pełne ujawnienie, a nie „bez skazy” wynik wykrywacza, jest tym, co utrzymuje cię w ramach zasad.
Chroń swój własny tekst przed fałszywym alarmem
Uhumanizuj swój szkic wspomagany przez AI w kilka minut, zachowaj każdą cytację, a potem ujawnij. Stworzony dla uważnego akademickiego angielskiego, jako języka obcego.
Wypróbuj darmowy HumanizerNajważniejsze włoskie uczelnie i miejsca, w których pojawiają się kontrole AI
Opisane wcześniej sprawdzania mają miejsce w wiodących instytucjach we Włoszech. Szkoły doktoranckie i biura redakcyjne na tych uczelniach uruchamiają prace doktorskie i manuskrypty przez testy podobieństwa, a coraz częściej biorą także pod uwagę wskaźniki AI:
- Sapienza Università di Roma, w Rzymie
- Università di Bologna (Alma Mater Studiorum), w Bolonii
- Politecnico di Milano i Università degli Studi di Milano (Statale), w Mediolanie
- Università degli Studi di Padova, w Padwie
- Università degli Studi di Napoli Federico II, w Neapolu
- Politecnico di Torino i Università degli Studi di Torino, w Turynie
- Università di Pisa, Scuola Normale Superiore, i Scuola Superiore Sant'Anna, w Pizie
- Università degli Studi di Firenze, we Florencji
- Università degli Studi di Trento, w Trydencie
- Università Cattolica del Sacro Cuore, w Mediolanie
W każdej z tych instytucji flaga jest początkiem rozmowy o twoich metodach, a nie wnioskiem o twojej uczciwości. To, że kontrole są rutynowe, jest powodem do przygotowania, a nie do paniki.
Jak działa AI humanizer dla włoskich badaczy
Oto proces i kolejność ma znaczenie.
Po pierwsze, przygotuj swój argument. Pisząc po włosku, tam gdzie twoje myślenie jest najbardziej precyzyjne, możesz później przetłumaczyć tekst albo przygotować wersję bezpośrednio po angielsku. W każdym przypadku pomysły i dane są twoje.
Po drugie, uporządkuj gramatykę. Skoryguj fałszywych przyjaciół, przyimki i błędy z rodzajnikami, aby język był czysty, zanim cokolwiek innego dotknie tekstu. Nasze narzędzia do proofreading są zbudowane dokładnie do tego i możesz zobaczyć „siostrzany” proces w AI proofreading for Italian academics.
Po trzecie, zhumanizuj własną prozę. Przepuść swój szkic wspomagany AI przez AI text humanizer. Różnicuje rytm i dobór słów oraz usuwa powtarzalną, niską perplexity kadencję, która potyka wykrywacze, zachowując jednocześnie twoje znaczenie, terminologię techniczną i cytowania.
Humanizer jest testowany względem głównych wykrywaczy, a potem przekształca tekst wygenerowany przez AI w bardziej naturalną, „ludzką” formę, która wygląda na ludzką w Turnitin, Originality.ai i GPTZero, jednocześnie utrzymując wysoką dokładność gramatyczną w tekstach akademickich. Wyniki pochodzą z testów, nie z obietnic. Nie obiecujemy obejścia czegokolwiek – wykrywacze przeuczają się co kilka miesięcy.
Po czwarte, ujawnij użycie. Określ, w jakiej formie korzystałeś z AI, w formacie wymaganym przez twoją instytucję i docelowe czasopismo. Ten ostatni krok oddziela uczciwą ochronę realnej pracy od udawania.
Ten wpis jest jednym przystankiem w naszym multilingual AI humanizer hub, który obejmuje ten sam proces dla badaczy piszących z innych języków pierwszych. Jeśli twoja szersza potrzeba dotyczy pełnej edycji językowej, a nie wyłącznie „sprawiedliwości” wobec wykrywaczy, zacznij od naszego global academic editing hub.
Lokalne instytucje finansujące, czasopisma i oczekiwania dotyczące ujawniania użycia AI
Włoskie finansowanie badań i ich ocena odbywają się za pośrednictwem kilku instytucji, a każda z nich podnosi stawkę w tym, gdzie publikujesz swoje prace.
MUR (Ministero dell'Università e della Ricerca) finansuje uczelnie i krajowe granty. PRIN (Progetti di Ricerca di Rilevante Interesse Nazionale) to główny konkurencyjny krajowy program. CNR (Consiglio Nazionale delle Ricerche) jest największą publiczną jednostką prowadzącą badania. ANVUR prowadzi zarówno ocenę VQR, jak i kwalifikacje ASN, a także utrzymuje listy czasopism klasy A, które realnie ważą w naukach humanistycznych i społecznych.
W praktyce oznacza to indeksowanie w Scopus i Web of Science oraz status ANVUR klasy A w dziedzinach niebędących czysto bibliometrycznymi. Manuskrypty kierowane do tych czasopism są sprawdzane za pomocą Turnitin lub iThenticate, a rosnąca liczba czasopism i instytucji finansujących prosi o wyraźne oświadczenie dotyczące użycia AI. Przygotuj to oświadczenie wcześniej, a jeśli kiedykolwiek wykrywacz oznaczy „czystą” pracę, potraktuj raport jako dowód podlegający dyskusji, a nie jako rozstrzygnięcie. Ostatni przegląd w AI text humanizer przed złożeniem pozwala dać uważnej prozie niebędącej rodzimą użytkowniczką bardziej sprawiedliwy odczyt, a twoje ujawnienie utrzymuje cały proces w przejrzystości.
Najczęściej zadawane pytania
P: Czy korzystanie z humanizera AI dla włoskich badaczy to forma oszustwa?
Nie, nie wtedy, gdy używasz go do własnych prac. To ty napisałeś badania; narzędzie jedynie różnicuje rytm i dobór słów w uważnej prozie osoby niebędącej native speakerem, dzięki czemu jest mniej prawdopodobne, że zostanie błędnie odczytana jako tekst maszynowy. Zasada, która utrzymuje to w transparentności, to ujawnienie: nadal informujesz swoją instytucję i czasopismo, jak korzystałeś z AI.
P: Czy humanizer zmieni moje cytowania lub terminy techniczne?
Nie. Zachowuje twoje referencje, dane oraz terminologię charakterystyczną dla twojej dyscypliny. Ukierunkowuje się na niską perplexity kadencję, na którą reagują wykrywacze, a nie na istotę twojego argumentu.
P: Czy możecie zagwarantować, że moja praca przejdzie Turnitin lub GPTZero?
Nie i uważaj na każde narzędzie, które składa takie obietnice. W naszych testach humanizer przepisuje tekst wygenerowany przez AI w bardziej naturalną, „ludzką” formę, co obniża sygnał AI i poprawia szanse w starciu z trudnymi wykrywaczami, ale wykrywacze przeuczają się stale, dlatego przedstawiamy wyniki testów, a nie gwarancje.
P: Dlaczego mój poprawny angielski w ogóle dostaje flagę?
Ponieważ wykrywacze punktują, jak przewidywalne są twoje wybory słów. Standardowe, podręcznikowe konstrukcje włoski→angielski – od użycia rodzajników po łaciński dobór słownictwa – są wysoce przewidywalne, co przekłada się na niską perplexity, a część narzędzi interpretuje to jako oznakę AI. To udokumentowane uprzedzenie wobec uważnego pisania w drugim języku, a nie ocena twojej pracy.
P: Co powinienem zrobić, jeśli komisja lub czasopismo oznaczy moje pismo?
Zachowaj spokój i potraktuj flagę jako twierdzenie do odpowiedzi, a nie jako wyrok. Zgromadź swoje szkice i notatki, wskaż udokumentowane uprzedzenie wobec autorów niebędących native speakerami i udostępnij oświadczenie o swoim użyciu AI. Wynik wykrywacza to dowód podlegający dyskusji, nigdy dowód niepodważalny.
Daj swojemu uważnemu angielskiemu jako językowi obcemu sprawiedliwszy odczyt. Zachowaj znaczenie i cytowania, ogranicz fałszywe alarmy AI, a następnie ujawnij to z pewnością.

Moe jest inżynierem NLP z PhD w przetwarzaniu języka naturalnego. Jego badania obejmują lingwistykę obliczeniową, analizę tekstu i uczenie maszynowe, a następnie zostały wykorzystane bezpośrednio w modelach edycji i humanizacji stojących za ProofreaderPro. Pisze o części procesu, której większość ludzi nigdy nie widzi: o tym, jak model językowy czyta zdanie, ocenia je i decyduje, co zmienić.


