
यूक्रेनी शोधकर्ताओं के लिए अंग्रेज़ी में लिखने हेतु AI ह्यूमनाइज़र
यूक्रेनी शोधकर्ताओं के लिए AI ह्यूमनाइज़र। यूक्रेनी और रूसी-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन फ़्लैग्स कम करें, अर्थ और उद्धरण (citations) बनाए रखें, और ईमानदारी से स्पष्ट करें।

यूक्रेन ऐसी परिस्थितियों में भी गंभीर विज्ञान का उत्पादन करता रहता है जिनसे अधिकांश शोध प्रणालियाँ ठप हो जाएँ। भौतिक विज्ञानी, गणितज्ञ, सामग्री वैज्ञानिक, और इंजीनियर लगातार सबमिट करते रहते हैं, और राष्ट्रीय नीति सभी को Web of Science और Scopus में इंडेक्स्ड जर्नल्स की ओर धकेलती रहती है। व्यवहार में इसका मतलब एक ही बात है: आप अंग्रेज़ी में लिखते हैं, चाहे अंग्रेज़ी आपकी वह भाषा न हो जिसमें आप सोचते हों।
ठीक इसी जाल के लिए यूक्रेनी शोधकर्ताओं हेतु एक AI ह्यूमनाइज़र मौजूद है। एक सावधान विद्वान साफ़, मानक (standard) अंग्रेज़ी लिखता है, ड्राफ्ट को AI चेकर से गुज़ारता है, और देखता है कि वह मशीन-लिखित होने के फ़्लैग के साथ लौटता है। कुछ भी नकली नहीं किया गया। गद्य बस इतना अधिक “सही” (correct) था। यह टूल आपका अर्थ, शब्दावली, और उद्धरण अक्षुण्ण रखता है, जबकि सावधानीपूर्ण गैर-देशी (non-native) लेखन को वैसा बना देता है जैसा वास्तव में किसी व्यक्ति ने लिखा हो। लाइफ़ साइंस के शोधकर्ता और चिकित्सक भी इसी दीवार से टकराते हैं।
अधिकांश यूक्रेनी शोधकर्ता द्विभाषी होते हैं, वे यूक्रेनी और रूसी के बीच आते-जाते हैं, और दोनों भाषाएँ अंग्रेज़ी गद्य पर एक जैसी तरह के “निशान” (fingerprints) छोड़ती हैं। ये निशान त्रुटियाँ नहीं हैं। ये उस लेखक की पहचान हैं जिसने स्लाविक (Slavic) व्याकरण के माध्यम से अंग्रेज़ी सीखी, और विडंबना यह है कि जितनी “स्वच्छ” आप इस अंग्रेज़ी को बनाते हैं, उतनी ही संभावना होती है कि कोई डिटेक्टर उसे गलत अर्थ में मशीन-लिखित पढ़ ले।
Гуманізація AI-тексту для українських дослідників
हमारी AI-टेक्स्ट की гуманізація (hуманізація) यूक्रेनी वैज्ञानिकों को अंग्रेज़ी में आत्मविश्वास के साथ प्रकाशित करने में मदद करती है, साथ ही सामग्री और संदर्भ (citations) भी सुरक्षित रहते हैं। Whether your first language is Ukrainian or Russian, the goal is the same: ऐसा गद्य जो आपके तर्क (argument) को ठीक वैसा ही बनाए रखे जैसा आप चाहते थे, लेकिन अब वह किसी ऐसे डिटेक्टर के लिए और बाधा न बने जो मुख्यतः मूल (native) अंग्रेज़ी पर प्रशिक्षित है।
हमने अपना ह्यूमनाइज़र ऐसे शोधकर्ताओं के लिए बनाया है जो वास्तविक काम करते हैं और बस चाहते हैं कि उसे “निष्पक्ष” ढंग से पढ़ा जाए। आप विज्ञान का ड्राफ्ट तैयार करते हैं। टूल लय (rhythm) और शब्द-चयन (word choice) में बदलाव करता है, उस कैडेंस को स्मूद करता है जिसमें मशीनें और भारी-एडिटेड दूसरी भाषा का टेक्स्ट अक्सर फिसल जाता है, और आपको ऐसा लेखन देता है जो अभी भी ठीक वही कहता है जो आपने कहा, केवल ऐसी आवाज़ (voice) में जो पढ़ने पर मानव-सी (human) लगती है।
क्या आप यूक्रेनी में लिख रहे हैं? इसका स्वतः पता लगाया जाता है और यह मूल रूप से ह्यूमनाइज़ किया जाता है
कई यूक्रेनी शोधकर्ता अंग्रेज़ी में लिखने से पहले यूक्रेनी में ड्राफ्ट तैयार करते हैं, और ह्यूमनाइज़र उसे सीधे संभालता है। यूक्रेनी टेक्स्ट पेस्ट करें और ProofreaderPro सिरिलिक (Cyrillic) लिपि को पहचानकर उसे रूसी से अलग बताता है, फिर इसे भाषा-सचेत (language-aware) मॉडल से प्रोसेस करता है जो आपकी शब्दावली और citations को बिल्कुल उसी तरह बनाए रखता है जैसा आपने लिखा है। Through гуманізація AI-тексту आपके यूक्रेनी ड्राफ्ट को भी आपकी अंग्रेज़ी की तरह ही मानव-आधारित (humanized) किया जाता है, बिना पहले किसी अनुवाद के। यही डिटेक्शन पचास से अधिक (sixty) भाषाओं तक फैला है, जहाँ हर टेक्स्ट को अपनी ही आवाज़ (voice) में फिर से लिखा जाता है।
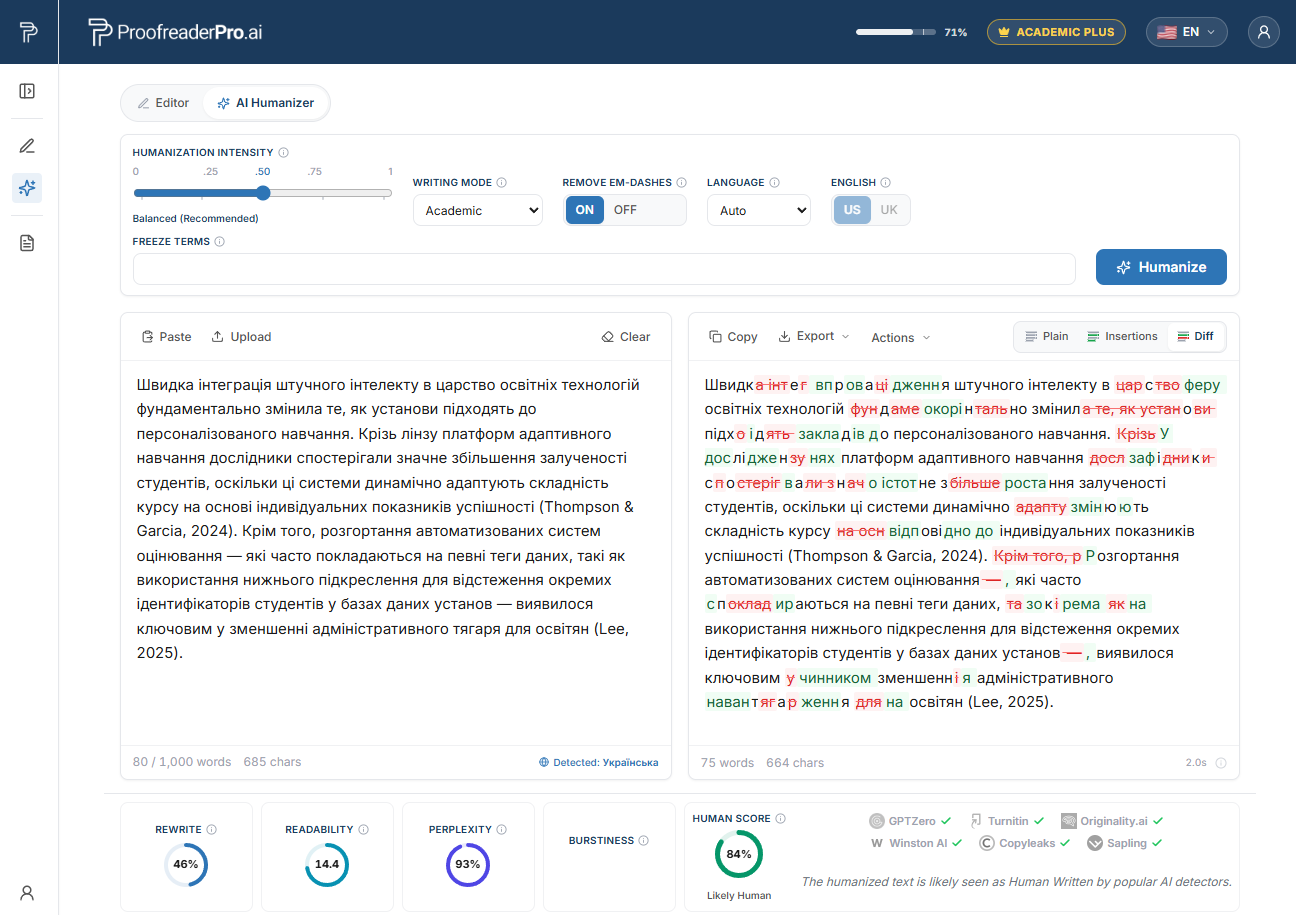
The ProofreaderPro AI Humanizer rewriting Ukrainian academic text. The before and after diff keeps your meaning and citations, and the detector checks confirm a natural, human read.
Why Ukrainian researchers get flagged by AI detectors
सबसे स्पष्ट प्रमाण 2023 की स्टैनफोर्ड (Stanford) स्टडी से मिलता है, जिसका नेतृत्व Weixin Liang और उनके सहकर्मियों ने किया और जो Cell Press जर्नल Patterns में प्रकाशित हुआ। टीम ने मानव-लिखित TOEFL निबंधों (essays) को सात व्यापक रूप से उपयोग किए जाने वाले AI डिटेक्टरों से चलाया। औसतन, गैर-देशी (non-native) निबंधों का लगभग 61% AI-generated के रूप में फ़्लैग हुआ, जबकि मूल अंग्रेज़ी लिखने वालों के लिए यह लगभग 5% था। लगभग हर पाँच में से एक गैर-देशी निबंध, यानी 19.8%, हर डिटेक्टर द्वारा सर्वसम्मति से (unanimously) फ़्लैग हुआ। हर एक निबंध एक व्यक्ति द्वारा लिखा गया था।
यह क्यों होता है? कई डिटेक्टर कुछ ऐसा स्कोर करते हैं जिसे perplexity कहा जाता है, जो यह मापता है कि अगला शब्द (next word) भाषा मॉडल के लिए कितना “आश्चर्यजनक” (surprising) है। जब आप दूसरी भाषा में सावधानी से लिखते हैं, तो आप सामान्य शब्दों और सुरक्षित, अनुमानित (predictable) phrasing का सहारा लेते हैं। इससे low perplexity पैदा होती है, और low perplexity को डिटेक्टर ठीक उसी रूप में पढ़ते हैं जैसे मशीन-लिखित को पढ़ा जाता है। वे आदतें जो यूक्रेनी-अंग्रेज़ी को स्पष्ट और सही बनाती हैं, वही आदतें हैं जिन्हें ये सिस्टम संदेह की नज़र से देखने के लिए प्रशिक्षित किए गए हैं।
इसलिए, फ़्लैग आपके ईमानदारी पर कोई “निर्णय” (verdict) नहीं है। यह इस बात का सांख्यिकीय (statistical) परिणाम है कि टूल कैसे काम करता है, और हम why AI detectors flag non-native writing में इस तंत्र (mechanism) को अधिक विस्तार से समझाते हैं। यह जानना आपको लाल स्कोर (red score) को कैसे लेना चाहिए, इसे किसी सज़ा योग्य दोष की स्वीकारोक्ति की तरह नहीं, बल्कि एक ऐसे दावे की तरह जो चुनौती (contest) दिया जा सकता है, इस दृष्टि को बदल देता है।
गलत संकेतों के पीछे यूक्रेनी और रूसी प्रथम-भाषा के पैटर्न
स्लाविक (Slavic) व्याकरण अंग्रेज़ी से कुछ संरचनात्मक (structural) तरीकों में अलग है, और हर अंतर आपकी अंग्रेज़ी को उस सपाट, पूर्वानुमेय रजिस्टर (flat, predictable register) की ओर थोड़ा-सा धकेलता है जिसे डिटेक्टर दंडित करते हैं। इनमें से कोई भी गलती (mistake) नहीं है। ये सावधानीपूर्ण (careful) संरचनाएँ हैं, और उनकी बहुत अधिक “मानकता” (standardness) ही समस्या है।
No articles. न तो यूक्रेनी के पास “the” या “a” है और न ही रूसी के पास, इसलिए अंग्रेज़ी के articles हट (dropped), जोड़े (added), या पुनः आवंटित (reassigned) हो जाते हैं ("result was significant", "we studied the influence of the temperature"). जब संपादक इन्हें ठीक करता है, तो सुधारी गई वाक्य-रचनाएँ स्मूद और जेनेरिक (generic) लगने लगती हैं, जो low perplexity के रूप में पढ़ी जाती हैं।
Aspect instead of tense. स्लाविक व्याकरण tense प्रणाली के बजाय perfective और imperfective aspect पर आधारित है, इसलिए perfect और simple past के बीच का चुनाव असंगत (inconsistent) रूप से निकल सकता है। इसे ठीक करने पर अक्सर छोटे, किताब-जैसे (textbook-plain) वाक्य बनते हैं।
Flexible word order. यूक्रेनी और रूसी में case endings अर्थ (meaning) वहन करते हैं, जिससे word order स्वतंत्र रूप से बदल सकता है। जब इसे अंग्रेज़ी में स्थानांतरित किया जाता है, तो information structure थोड़ा अजीब बैठती है, और सबसे सुरक्षित सुधार सबसे conventional ordering होती है, जो सबसे अधिक मशीन-सी भी होती है।
Countable and uncountable nouns. "informations", "researches", "an equipment", और "evidences" जैसे रूप स्रोत भाषाओं (source languages) से स्वाभाविक रूप से आते हैं। सुधारे जाने पर वे standard mass-noun phrasings में घुल जाते हैं जो प्रशिक्षण (training) के लाखों उदाहरणों में दिखता है।
Preposition transfer and the missing auxiliary. भाषाओं के बीच prepositions का मैप अलग होता है, और अंग्रेज़ी सहायक क्रिया (auxiliary) "do/does" का सीधा समकक्ष (direct equivalent) नहीं है, इसलिए संपादन के दौरान दोनों का मानकीकरण (standardized) हो जाता है, फिर से सबसे सरल रूप (plainest form) की ओर।
Transliteration. सिरिलिक से लाए गए नाम (names) और तकनीकी शब्द (technical terms) अपनी पारंपरिक अंग्रेज़ी वर्तनी (conventional English spellings) के अनुरूप नियमित (regularized) हो जाते हैं, यह भी uniformity की ओर एक छोटा कदम है। इन सबको मिलाकर आपको मिलता है साफ़, सही, low-variance गद्य: ठीक वही प्रोफ़ाइल जिसे डिटेक्टर कृत्रिम (artificial) मानकर स्कोर करते हैं।
Ukraine's AI-detection and Turnitin context
यूक्रेनी उच्च शिक्षा में similarity screening एक नियमित प्रक्रिया है, और उसके ऊपर AI screening भी आ रही है। कई विश्वविद्यालय Unicheck चलाते हैं, जो वास्तव में यूक्रेन में बनाया गया सिस्टम है और अब Turnitin का हिस्सा है, जबकि अन्य StrikePlagiarism का उपयोग करते हैं। यदि आप कोई थीसिस या मैनुस्क्रिप्ट सबमिट करते हैं, तो मानकर चलें कि यह इन्हीं में से किसी एक प्रक्रिया से गुज़रेगा, इससे पहले कि कोई मानव इसे बारीकी से पढ़े।
शिक्षा और विज्ञान मंत्रालय (MES) और अलग-अलग संस्थानों ने अकादमिक-निष्ठा (academic-integrity) तथा AI संबंधी मार्गदर्शन (guidance) जारी किया है, और समग्र दिशा prohibition की बजाय disclosure की ओर है। फंडर्स और जर्नल्स अब तेजी से आपसे यह पूछते हैं कि पेपर तैयार करने में आपने AI कब और कैसे इस्तेमाल किया।
यह माहौल संभाला जा सकता है यदि आप इसे ईमानदारी से अपनाएँ। ह्यूमनाइज़ करने का उद्देश्य कभी भी AI उपयोग को छिपाना या Unicheck को धोखा देना नहीं है। उद्देश्य यह है कि टूलिंग में मौजूद fairness gap वास्तविक काम को दंडित न करे, और फिर अपने AI उपयोग को ठीक उसी तरह सार्वजनिक (disclose) करें जैसा आपका विश्वविद्यालय और लक्षित (target) जर्नल अपेक्षा करता है।
अपने यूक्रेनी शोध को निष्पक्ष अंग्रेज़ी में प्रकाशित कीजिए
अपना AI-सहायता प्राप्त ड्राफ्ट मानवीय बनाइए, अपना अर्थ और उद्धरण बनाए रखें, और आत्मविश्वास के साथ अपना AI उपयोग प्रकट कीजिए।
Humanizer को निःशुल्क आज़माइएTop Ukrainian universities and where AI checks appear
नीचे दिए गए संस्थान थीसिस और मैनुस्क्रिप्ट्स को similarity के लिए स्क्रीन करते हैं और बढ़ती संख्या में AI संकेतकों को भी महत्व देते हैं। यदि आप इनमें से किसी एक में काम करते हैं या पढ़ते हैं, तो similarity और AI check एक परिक्षिप्त (normal) प्रक्रिया का हिस्सा होता है, जिससे गुजरने के बाद ही थीसिस डिफेंड होती है या कोई पेपर सबमिट होता है।
- Київський національний університет імені Тараса Шевченка (Taras Shevchenko National University of Kyiv), Kyiv
- Національний технічний університет України «Київський політехнічний інститут імені Ігоря Сікорського» (Igor Sikorsky Kyiv Polytechnic Institute, KPI), Kyiv
- Харківський національний університет імені В. Н. Каразіна (V. N. Karazin Kharkiv National University), Kharkiv
- Львівський національний університет імені Івана Франка (Ivan Franko National University of Lviv), Lviv
- Національний університет «Львівська політехніка» (Lviv Polytechnic National University), Lviv
- Сумський державний університет (Sumy State University), Sumy
- Національний університет «Києво-Могилянська академія» (National University of Kyiv-Mohyla Academy), Kyiv
- Дніпровський національний університет імені Олеся Гончара (Oles Honchar Dnipro National University), Dnipro
इन विश्वविद्यालयों में वर्कफ़्लो समान है: आपका ड्राफ्ट किसी समिति से पहले एक automated check से मिलता है। यह समझना कि यह चेक वास्तव में क्या मापता है, यही आपको घबराने की बजाय, किसी फ़्लैग का शांतिपूर्वक उत्तर देने की क्षमता देता है।
यूक्रेनी शोधकर्ताओं के लिए AI ह्यूमनाइज़र कैसे काम करता है
ईमानदार (honest) वर्कफ़्लो के चार चरण हैं, और disclosure उसका हिस्सा है, कोई बाद की सोची (afterthought) नहीं।
पहला, अपने विज्ञान का ड्राफ्ट बनाइए। कई यूक्रेनी शोधकर्ता पहले यूक्रेनी या रूसी में तर्क (argument) को सोचते हैं, फिर अनुवाद करते हैं, और यह पूरी तरह ठीक है। पढ़ने के तरीके की चिंता करने से पहले reasoning को सही कर लें।
दूसरा, व्याकरण (grammar) को प्रूफ़रीड करें ताकि अंग्रेज़ी सही हो और आपकी शब्दावली सुसंगत (consistent) रहे। साफ़ व्याकरण (clean grammar) और स्वाभाविक (natural) आवाज़ (voice) दो अलग चीज़ें हैं, और आपको दोनों चाहिए।
तीसरा, अपनी AI-सहायता (AI-assisted) लिखित सामग्री को text humanizer से गुज़ारें। यह वाक्य-लय (sentence rhythm) और शब्द-चयन में बदलाव करता है, उन repetitive कैडेंस को हटाता है जो मशीनों और heavily-edited दूसरी-भाषा टेक्स्ट में आम होती है, और बिखरे हुए em dashes भी साफ़ कर देता है—साथ ही आपके अर्थ, आपकी तकनीकी शब्दावली, और हर citation को सुरक्षित रखते हुए। क्योंकि हमारा ह्यूमनाइज़र 60 से अधिक भाषाओं (more than 60 languages) को सपोर्ट करता है, इसलिए non-English टेक्स्ट एक भाषा-सचेत मॉडल के माध्यम से रूट होता है जो वाक्य-रचना और meaning को अक्षुण्ण रखता है, न कि उन्हें बिगाड़ (mangle) देता है।
परिणाम से आप क्या अपेक्षा कर सकते हैं? हमारे अपने परीक्षणों में, humanizing से यह काफी हद तक कम होता है कि सावधानीपूर्ण, मानक (standard) गैर-देशी अंग्रेज़ी को प्रमुख डिटेक्टर कितनी बार गलत तरीके से पढ़ते हैं, जिसमें Turnitin, Originality.ai, और GPTZero शामिल हैं, जबकि आपका शैक्षणिक अर्थ (academic meaning) वैसे ही बना रहता है। हम इसे अपने परीक्षणों में जो हमने देखा है, उसी रूप में वर्णित करते हैं, वादा (promise) के रूप में नहीं। डिटेक्टर हर कुछ महीनों में फिर से प्रशिक्षित होते हैं, और कोई भी ईमानदार टूल 100% undetectable होने का दावा नहीं कर सकता। जो कोई भी इसके उलट गारंटी देता है, वह आपको ऐसी निश्चितता बेच रहा है जो मौजूद नहीं है।
चौथा, disclosure करें। AI-use statement को उसी प्रारूप में जोड़ें जो आपका संस्थान और जर्नल माँगते हैं, ताकि आपका काम स्पष्ट रूप से integrity नियमों के भीतर रहे। यह पूरा उद्देश्य है: आप पक्षपाती (biased) टूल से वास्तविक शोध को बचा रहे हैं, किसी भी चीज़ को छिपा नहीं रहे। यूक्रेन हमारे multilingual AI humanizer hub का एक पड़ाव (one stop) है, और यदि आपके पेपर को पूरी भाषा-संपादन (full language editing) की भी जरूरत है, तो हमारा global academic editing hub इस प्रक्रिया के उस पहलू को भी समझाता है।
Local funding bodies, journals, and AI-disclosure expectations
यूक्रेनी शोध कुछ केंद्रीय संस्थानों के माध्यम से फंडिंग और आयोजन (organized) पाता है। National Research Foundation of Ukraine (NRFU, Національний фонд досліджень України) प्रतिस्पर्धी अनुदान (competitive grants) चलाता है। National Academy of Sciences of Ukraine (NAS, НАН України) राष्ट्रीय संस्थानों की निगरानी (oversees) करती है। शिक्षा और विज्ञान मंत्रालय (MES) शोध और प्रकाशन नीति निर्धारित करता है, जिसमें इंडेक्स्ड आउटपुट की ओर बढ़ावा भी शामिल है।
यह बढ़ावा ठोस (concrete) है। राष्ट्रीय नीति Web of Science और Scopus-इंडेक्स्ड जर्नल्स में प्रकाशन को पुरस्कृत करती है, जिससे अंग्रेज़ी में लिखने का दबाव हर साल ऊँचा बना रहता है। जब आप इन जर्नल्स को लक्षित (target) करते हैं, तो similarity screening को सामान्य प्रक्रिया मानकर चलें, और यह भी अपेक्षा करें कि submission के दौरान इनमें से बढ़ती संख्या आपसे AI-use disclosure माँगेगी।
उस अपेक्षा को सीधे पूरा करें। बताइए कि आपने क्या उपयोग किया, रिकॉर्ड को साफ़ रखें, और hуманized ड्राफ्ट को अपनी वास्तविक दलील (argument) को एक स्वाभाविक आवाज़ में आगे बढ़ाने दें। यदि आपको कभी कोई फ़्लैग ऐसा मिले जिसे आप गलत मानते हैं, तो उसे एक ऐसे दावे की तरह लें जिसका उत्तर आप साक्ष्य (evidence) के साथ दे सकते हैं, और अगली submission से पहले, rejection के बाद नहीं, फिर से text humanizer की तरफ बढ़ें।
Frequently asked questions
Q: Is using an AI humanizer for Ukrainian researchers considered cheating?
नहीं, जब आप इसे ईमानदारी से उपयोग करते हैं। आप अपने AI-सहायता (AI-assisted) ड्राफ्ट को मानव-समान बनाने (humanizing) के लिए इसका इस्तेमाल करते हैं, ताकि सावधानीपूर्ण गैर-देशी लेखन को पक्षपाती डिटेक्टर से बचाया जा सके, न कि परिणाम (results) को गढ़ने या लेखन-सत्ता (authorship) छिपाने के लिए। आप अपना अर्थ और citations बनाए रखते हैं, और फिर अपने AI उपयोग को उसी प्रारूप में disclose करते हैं जो आपका विश्वविद्यालय और जर्नल माँगते हैं।
Q: Will the humanizer change my technical terms or citations?
नहीं। यह टूल अकादमिक meaning, तकनीकी शब्दावली, और आपके द्वारा लिखे गए हर संदर्भ (reference) को ठीक उसी तरह संरक्षित (preserve) करने के लिए बनाया गया है। यह आपके कंटेंट के आसपास rhythm और word choice में बदलाव करता है, इसलिए आपकी methods, आपके terms, और आपके citation numbers अक्षुण्ण (intact) रहते हैं।
Q: Does the гуманізація AI-тексту process work for Russian-speaking Ukrainian researchers too?
हाँ। यूक्रेनी और रूसी में कई व्याकरणिक विशेषताएँ साझा हैं जो अंग्रेज़ी गद्य पर वही fingerprints छोड़ती हैं, जैसे absent articles और aspect-आधारित verbs। ह्यूमनाइज़र non-English और non-native टेक्स्ट को भाषा-सचेत मॉडल के माध्यम से रूट करता है, इसलिए यह इस बात से मदद करता है कि आपकी दोनों में से कौन-सी भाषा आपकी अपेक्षाकृत अधिक मजबूत भाषा है।
Q: Can any tool guarantee my paper will pass an AI detector?
नहीं, और आपको उन सभी बातों पर भरोसा करने में संदेह रखना चाहिए जो ऐसे दावे करती हैं। डिटेक्टर लगातार फिर से प्रशिक्षित (retrain) होते हैं, और कोई भी ईमानदार टूल 100% undetectable होने का वादा नहीं कर सकता। जो हम कह सकते हैं वह यह है कि हमारे परीक्षणों में, humanizing से यह काफी हद तक कम होता है कि सावधानीपूर्ण गैर-देशी अंग्रेज़ी को गलत तरीके से पढ़ा जाए, जो कि एक guarantee की तुलना में बिल्कुल अलग और कहीं अधिक ईमानदार दावा है।
Q: What should I do if my thesis gets flagged by Unicheck or Turnitin at my university?
स्कोर को किसी फैसले (verdict) की तरह नहीं, बल्कि चुनौती (contest) देने योग्य दावे की तरह मानें। अपनी drafts और नोट्स को अपने प्रक्रिया (process) के साक्ष्य के रूप में रखें, अपने लेखन को humanize करें ताकि वह स्वाभाविक लगे, और अपने AI उपयोग को अपने संस्थान की नीति के अनुसार disclose करें। डिटेक्टर फ़्लैग बातचीत (conversation) की शुरुआत है, अंत नहीं।
एक भाषा-सचेत humanizer, जो आपके अर्थ, शब्दावली और उद्धरणों को बनाए रखते हुए, सावधानीपूर्ण गैर-मातृभाषी गद्य को मानवीय की तरह पढ़ने में मदद करता है।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


