
अंग्रेज़ी में लिख रहे हंगेरियाई शोधकर्ताओं के लिए AI ह्यूमनाइज़र
हंगेरियाई शोधकर्ताओं के लिए AI ह्यूमनाइज़र। हंगेरियाई-प्रभावित अंग्रेज़ी में गलत AI-डिटेक्शन फ्लैग कम करें, अर्थ और संदर्भ (साइटेशन) को बनाए रखें, और ईमानदारी से खुलासा करें।

हंगेरियाई विज्ञान अपने पैमाने से ऊपर का प्रदर्शन करता है। दस मिलियन से कम आबादी वाले इस देश ने गणितज्ञों, भौतिक वैज्ञानिकों, रसायनज्ञों और जीवन-विज्ञानियों की एक उल्लेखनीय परंपरा को जन्म दिया है, और यह परंपरा आज भी उसके विश्वविद्यालयों के आउटपुट में झलकती है। लेकिन काम अंग्रेज़ी में लिखा जाता है। बुडापेस्ट या ज़ेगेद के लगभग हर शोधकर्ता पहले हंगेरियाई में ड्राफ्ट बनाता है और अपने तर्क को भी उसी भाषा में गढ़ता है, फिर उसे दूसरी ऐसी भाषा में ले जाता है जिसकी व्याकरणिक संरचना उससे लगभग पूरी तरह अलग है। यही अनुवाद-गत अंतर वह जगह है जहाँ हंगेरियाई शोधकर्ताओं के लिए AI ह्यूमनाइज़र अपनी उपयोगिता साबित करता है, क्योंकि अब सावधानीपूर्वक तैयार हंगेरियाई–इंग्लिश को मशीन-टेक्स्ट समझकर गलत पढ़ा जा रहा है।
यहाँ असहज करने वाला तथ्य है। जितनी आपकी अंग्रेज़ी अधिक साफ़-सुथरी और मानक (स्टैंडर्ड) होगी, उतनी ही संभावना है कि AI डिटेक्टर उसे फ्लैग कर दे। एक ऐसा मॉडल जो टेक्स्ट को इस आधार पर स्कोर करता है कि प्रत्येक शब्द “कितना आश्चर्यजनक” है, आपकी अनुशासित, अनुमानित (प्रेडिक्टेबल) भाषा-शैली को मशीन-लेखन का संकेत मान लेता है। कठिन दूसरी भाषा में स्पष्ट लिखने का आपका “इनाम” एक गलत आरोप बन जाता है।
हमने अपना ह्यूमनाइज़र इसी विशिष्ट समस्या के लिए बनाया है: असली शोधकर्ताओं के असली काम को सुरक्षित रखने के लिए, किसी की शॉर्टकट छिपाने के लिए नहीं। यह गाइड बताती है कि यह हंगरी के विद्वानों के लिए एक ईमानदार प्रकाशन-प्रक्रिया में कैसे फिट बैठता है।
हंगेरियाई शोधकर्ताओं के लिए AI-टेक्स्ट ह्यूमनाइज़ेशन
AI-टेक्स्ट ह्यूमनाइज़ेशन का अर्थ यह है कि अपनी ही कृत्रिम बुद्धिमत्ता (AI) से सहायता प्राप्त लिखावट को अधिक मानवीय लय (rhythm) दिया जाए, जबकि अर्थ, विशिष्ट (डोमेन) शब्दावली (terminology) और संदर्भ (साइटेशन) अपरिवर्तित रहें। हमारा टूल उन हंगेरियाई अकादमिक लोगों के लिए बनाया गया है जो अपने ही भाषा में ड्राफ्ट करते हैं और फिर उसे अंग्रेज़ी में प्रकाशित करते हैं।
लक्ष्य किसी भी चीज़ को छुपाना नहीं है। लक्ष्य यह है कि हंगेरियाई विद्वान द्वारा लिखी गई सावधानीपूर्ण, मानक अंग्रेज़ी की एक वाक्य-रचना को केवल इसलिए संदेह की तरह न देखा जाए क्योंकि वह सावधानीपूर्ण और मानक है। यही “फॉल्स-फ्लैग” text humanizer कम करने के लिए डिज़ाइन किया गया है।
क्या आप हंगेरियाई में ड्राफ्ट बनाते हैं? ह्यूमनाइज़र उसे पहचानता भी है और सीधे फिर से लिखता भी है
आप हंगेरियाई ड्राफ्ट को पहले अंग्रेज़ी में अनुवाद किए बिना भी ह्यूमनाइज़ कर सकते हैं। अपना टेक्स्ट पेस्ट करें और ProofreaderPro भाषा को स्वचालित रूप से पहचान लेता है, फिर उसे हंगेरियाई-समझ वाले (Hungarian-aware) मॉडल के माध्यम से रूट करता है, जो आपके लेखन में प्रयुक्त लंबे स्वर (long vowels), आग्लूटिनेटेड (agglutinated) रूपों और साइटेशन का सम्मान करता है। AI-szöveg humanizálása के माध्यम से यह आपके हंगेरियाई गद्य (prose) की लय को बदलता है, जबकि हर शब्द और संदर्भ अक्षुण्ण रहता है। स्वचालित पहचान साठ से अधिक भाषाओं तक पहुँचती है, इसलिए हंगेरियाई को अंग्रेज़ी में “रीशेप” करने के बजाय हंगेरियाई के रूप में ही माना जाता है।
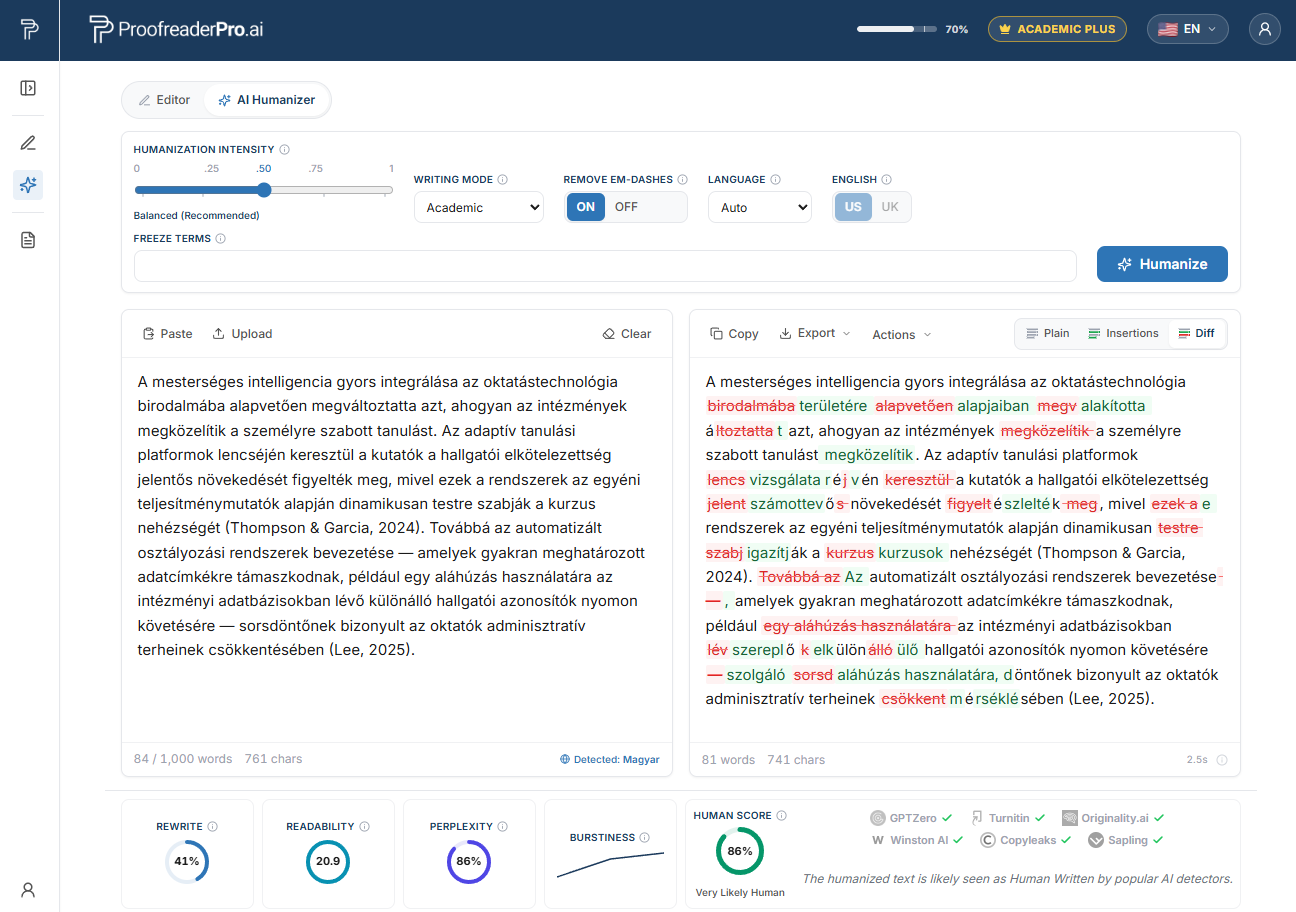
हंगेरियाई अकादमिक टेक्स्ट को फिर से लिखता हुआ ProofreaderPro AI Humanizer। पहले और बाद का diff आपका अर्थ और साइटेशन बनाए रखता है, और डिटेक्टर जाँच यह पुष्टि करती हैं कि पढ़ना प्राकृतिक, मानवीय है।
हंगेरियाई शोधकर्ताओं को AI डिटेक्टर क्यों फ्लैग करते हैं
2023 में Weixin Liang के नेतृत्व में एक Stanford शोध समूह ने मानव-लिखित निबंधों पर सात व्यापक रूप से इस्तेमाल होने वाले GPT-डिटेक्टरों का परीक्षण किया। ये निबंध TOEFL परीक्षा से आए थे, इसलिए उनमें से हर एक के पीछे एक मानव लेखक था, और उनमें से लेखक गैर-स्थानीय (non-native) अंग्रेज़ी लेखक थे। औसतन, लगभग 61% निबंधों को AI-जनरेटेड के रूप में फ्लैग किया गया। मूल (native) अंग्रेज़ी बोलने वालों द्वारा लिखे निबंधों में यह आँकड़ा लगभग 5% था। गैर-स्थानीय निबंधों में से लगभग हर पाँच में से एक (लगभग 19.8%) को हर एक डिटेक्टर द्वारा सर्वसम्मति से फ्लैग किया गया।
इसे फिर से पढ़िए। केवल इसलिए कि अंग्रेज़ी लेखक की दूसरी भाषा थी, मानव लेखन को दस गुना से भी अधिक बार, और बहुत अधिक बार, फ्लैग किया गया।
इस प्रक्रिया को perplexity कहा जाता है। कई डिटेक्टर इस बात का अनुमान लगाते हैं कि शब्द-चयन (word choices) किसी भाषा मॉडल के लिए कितने “अनुमानित” हैं। जब आप दूसरी भाषा में लिखते हैं, तो आप सुरक्षित, आम और सही निर्माण (construction) अपनाते हैं, क्योंकि वही सावधान लेखक करते हैं। सुरक्षित और आम का मतलब low perplexity होता है, और low perplexity वही विशिष्ट “फिंगरप्रिंट” है जिसे ये टूल मशीन टेक्स्ट के रूप में पढ़ने के लिए प्रशिक्षित किए गए हैं। हम why AI detectors flag non-native writers में इस पूरी प्रक्रिया का खुलासा करते हैं, लेकिन संक्षिप्त रूप में बात कड़वी है: वे आदतें जो आपके गद्य को स्पष्ट बनाती हैं, वही आदतें उसे फ्लैग भी करा देती हैं।
फॉल्स-फ्लैग के पीछे हंगेरियाई की पहली भाषा (हंगेरियाई-आधारित) की संरचनात्मक आदतें
हंगेरियाई एक यूरालिक (Uralic) भाषा है, जो इसके चारों ओर की इंडो-यूरोपीय भाषाओं से असंबद्ध है, और इसकी तर्क-प्रणाली वास्तव में अंग्रेज़ी से अलग है। यह अंतर हंगेरियाई–इंग्लिश लेखन में स्पष्ट “निशान” (fingerprints) छोड़ता है। इनमें से कोई भी निशान बुद्धिमत्ता (intelligence) की त्रुटियाँ नहीं हैं। ये एक बहुत अलग व्याकरण के साए (shadow) हैं, और जब उन्हें साफ़-सुथरी अंग्रेज़ी में “स्मूद” किया जाता है, तो वे डिटेक्टर को सपाट (flat) और अनुमानित (predictable) पढ़ाई देने लगते हैं।
एक सर्वनाम he और she के लिए। हंगेरियाई में तीसरे पुरुष का एक ही सर्वनाम है और व्याकरणिक लिंग (grammatical gender) नहीं होता, इसलिए अंग्रेज़ी में “he” और “she” का अदला-बदली हो जाती है। जो लेखक इसे सुधारते हैं, वे अक्सर सबसे सुरक्षित विकल्प का अधिक-उपयोग करने लगते हैं या “the author” और “the participant” के आसपास वाक्यों को फिर से गढ़ते हैं, जिससे बहुत समान (even), कम-परिवर्तन (low-variation) वाला गद्य बनता है।
लेख (articles) का अलग वितरण। हंगेरियाई में लेखों (a, az, egy) का उपयोग होता है, लेकिन उन्हें अंग्रेज़ी से अलग तर्क के साथ रखा जाता है। definite और indefinite articles या तो हट जाते हैं या जोड़ दिए जाते हैं, और सावधानीपूर्ण सुधार आम तौर पर हर बार सबसे मानक, पाठ्यपुस्तक-संगत लेख (textbook article) होता है। मानक वही है जो मशीन-सा (machine-like) स्कोर करता है।
आग्लूटिनेशन (agglutination) और भारी नामकरण (heavy nominalisation)। हंगेरियाई मूल (stem) पर प्रत्यय (suffixes) की परतें लगाकर अर्थ बनाता है। जब यह आदत अंग्रेज़ी में स्थानांतरित होती है, तो यह सघन संज्ञात्मक पदबंधों (dense noun phrases) और लंबे नामवाचक (nominalised) अनुक्रमों ("the implementation of the optimisation of...") के रूप में बदल जाती है, जो व्याकरणिक रूप से बिल्कुल सही तो होते हैं, पर लय के स्तर पर बेहद एकरस (monotonous) लगते हैं। डिटेक्टर एकरसता (monotony) को पसंद करते हैं।
विषय-प्रमुख शब्द-क्रम (topic-prominent word order)। हंगेरियाई वाक्य के विषय (topic) और फोकस को अग्रभूमि में रखता है, इसलिए जोर (emphasis) वहाँ पड़ता है जहाँ अंग्रेज़ी पाठक अपेक्षा नहीं करता। जब कोई लेखक इसे साधारण subject-verb-object अंग्रेज़ी में सामान्यीकृत करता है, तो परिणाम सही, व्यवस्थित और अनुमानित निकलता है।
भविष्य-काल का अलग संकेत और पहलू-प्रणाली (aspect system) का अलग ढंग। हंगेरियाई भविष्य को अलग तरह से चिह्नित करता है और पहलू को (aspect) अपने तरीके से संभालता है; इसलिए अंग्रेज़ी काल-चयन (tense choices) असंगत होकर सामने आते हैं, और फिर उन्हें सबसे तटस्थ, सामान्य काल की ओर सुधार दिया जाता है। सबसे सुरक्षित काल फिर वही होता है जिसकी perplexity सबसे कम रहती है।
पूर्वसर्गों (prepositions) की बजाय पोस्टपोज़िशन (postpositions)। हंगेरियाई अपने संबंधसूचक (relational) संकेतों को संज्ञा (noun) के बाद रखता है, जिससे अंग्रेज़ी में preposition slips हो सकते हैं। इन slips को ठीक करने का मतलब हर बार मानक preposition तक पहुँचना है, और मानक वही है जिसे डिटेक्टर “जनरेटेड” के रूप में पढ़ते हैं।
अपनी सावधानीपूर्वक तैयार Hungarian-English को गलत संकेतों से सुरक्षित रखें
अपना AI-सहायता प्राप्त ड्राफ्ट मानवीय बनाइए, हर उद्धरण, शब्द और निष्कर्ष को अक्षुण्ण रखें, फिर आत्मविश्वास के साथ अपने टूल्स का उपयोग प्रकट कीजिए।
Humanizer को निःशुल्क आज़माइएहंगरी में AI-डिटेक्शन और Turnitin का संदर्भ
हंगेरियाई संस्थानों की थीसिस और जर्नल सबमिशन को पाठ-समानता (text similarity) के लिए नियमित रूप से जाँचा जाता है, अधिकतर Turnitin या तुलनीय किसी सिस्टम से, और AI-संकेतों (AI indicators) को अब इसी जाँच प्रक्रिया में तेजी से जोड़ा जा रहा है। यह अब डॉक्टोरल डिफेंस और पांडुलिपि (manuscript) समीक्षा का सामान्य हिस्सा बन गया है; यह कोई असाधारण कदम नहीं है।
इन टूल की सीमाओं को दृष्टि में रखना उपयोगी है। विदेश के कई प्रमुख विश्वविद्यालय, जैसे Vanderbilt, ने फॉल्स पॉजिटिव्स और गैर-स्थानीय लेखकों के विरुद्ध संभावित पूर्वाग्रह के कारण Turnitin के AI-writing detector को बंद कर दिया है, और Turnitin स्वयं अपने सबसे कम स्कोरों को दबाता भी है तथा चेतावनी देता है कि केवल उसी संख्या के आधार पर किसी integrity (नैतिक/शैक्षणिक ईमानदारी) संबंधी मामले का निर्णय कभी नहीं होना चाहिए। डिटेक्टर स्कोर एक ऐसा दावा है जिसे आप चुनौती दे सकते हैं, न कि अंतिम फैसला (verdict)।
हंगेरियाई संस्थानों ने जनरेटिव AI पर अपना मार्गदर्शन जारी किया है, और फंडर तथा जर्नल अब तेजी से उम्मीद करते हैं कि लेखक बताएँ कि इन टूल्स का उपयोग कैसे किया गया। ईमानदार जवाब कुछ छुपाना नहीं है। उद्देश्य है ज़िम्मेदारी से लिखना और संपादित करना, और फिर उन टूल्स की घोषणा करना जिन पर आपका काम निर्भर था।
शीर्ष हंगेरियाई विश्वविद्यालय और जहाँ AI जाँच दिखाई देती है
समानता (similarity) और AI-संकेतों के लिए जाँच हंगरी की उच्च-शिक्षा प्रणाली में व्यापक रूप से दिखती है, डॉक्टोरल स्कूलों से लेकर जर्नल संपादकीय कार्यालयों तक। देश के शोध-केंद्रित (research-intensive) संस्थानों में से निम्नलिखित कुछ प्रमुख हैं, और उनकी थीसिस व पांडुलिपियाँ इन जाँचों से गुजरती हैं:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE), बुडापेस्ट
- Semmelweis Egyetem (Semmelweis University), बुडापेस्ट, एक प्रमुख मेडिकल स्कूल
- Szegedi Tudományegyetem (University of Szeged), ज़ेगेद
- Debreceni Egyetem (University of Debrecen), डेब्रेसेन
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME), बुडापेस्ट
- Budapesti Corvinus Egyetem (Corvinus University of Budapest), बुडापेस्ट
- Pécsi Tudományegyetem (University of Pécs), पेक्स
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University), बुडापेस्ट
- Óbudai Egyetem (Óbuda University), बुडापेस्ट
चाहे आपका काम ELTE में डिफेंड की जाने वाली डिसर्टेशन हो या Semmelweis से आने वाली एक क्लिनिकल पांडुलिपि, एक ही गतिशीलता लागू होती है: मानक, सावधानीपूर्ण हंगेरियाई–इंग्लिश वह लेखन है जिसे perplexity-आधारित फ्लैग के रूप में ट्रिगर होने की सबसे अधिक संभावना रहती है।
हंगेरियाई शोधकर्ताओं के लिए AI ह्यूमनाइज़र कैसे काम करता है
हम जिस प्रक्रिया की सलाह देते हैं, वह सरल है, और उससे भी महत्वपूर्ण बात यह कि ईमानदार है। इसके तीन चरण हैं।
पहला चरण: ड्राफ्ट बनाना। अपना पेपर उस तरीके से लिखिए जो आपकी सोच को सबसे तेज़ी से पन्ने पर लाए। हंगेरियाई शोधकर्ताओं के लिए इसका मतलब अक्सर हंगेरियाई में ड्राफ्ट तैयार करना और अनुवाद करना, या AI सहायता के साथ सीधे अंग्रेज़ी में लिखना होता है। दोनों में से कोई भी ठीक है।
दूसरा चरण: वास्तविक सामग्री (substance) की प्रूफरीडिंग। व्याकरण, शब्दावली (terminology) और तर्क (argument) को ठीक करें ताकि विज्ञान सही रहे। यदि स्वयं भाषा को सावधानीपूर्ण “पास” चाहिए, तो हमारे global academic editing hub में इस हिस्से की कवरेज शामिल है।
तीसरा चरण: अपने ही ड्राफ्ट को ह्यूमनाइज़ करना। यहीं text humanizer काम आता है। यह वाक्य की लंबाई (sentence length) और लय (rhythm) को बदलता है, उस एकरस cadence को तोड़ता है जो आग्लूटिनेटिव हंगेरियाई–इंग्लिश से अक्सर निकलती है, और उन “stray” em dashes तथा दोहरावदार संरचनाओं को हटाता है जिन्हें दोनों—AI टूल्स और दूसरी भाषा की आदतें—पीछे छोड़ देती हैं। महत्वपूर्ण बात यह है कि यह आपका अर्थ, आपकी तकनीकी शब्दावली, और हर साइटेशन को सुरक्षित (preserve) रखता है। गैर-अंग्रेज़ी स्रोत टेक्स्ट एक भाषा-समझ वाले मॉडल से होकर गुजरता है, और यह टूल साठ से अधिक भाषाओं का समर्थन करता है।
यह क्या हासिल कराता है? हमारे अपने परीक्षण में, सावधानीपूर्ण गैर-स्थानीय ड्राफ्ट को ह्यूमनाइज़ करने से यह काफी हद तक घटा कि प्रमुख डिटेक्टर उसे कितनी बार मशीन-लिखित मान लेते हैं, और साथ ही अकादमिक अर्थ अपरिवर्तित रहता है। हम इसे “हमारे परीक्षण में जो देखा गया” की तरह वर्णित करते हैं, किसी वादे (promise) की तरह नहीं। कोई भी ईमानदार टूल यहाँ परिणाम की गारंटी नहीं दे सकता, क्योंकि डिटेक्टर हर कुछ महीनों में फिर से ट्रेन होते हैं, और कोई भी सेवा जो खुद को 100% undetectable बताती है, वह आपको वह चीज़ बेच रही होती है जिसे वह दे नहीं सकती।
फिर अंतिम चरण: खुलासा (disclose)। अपने विश्वविद्यालय और लक्षित जर्नल द्वारा मांगे गए फ़ॉर्मेट में AI-उपयोग का विवरण जोड़ें। अपने AI-सहायता प्राप्त लेखन को ह्यूमनाइज़ करना और फिर उसकी घोषणा करना कोई चाल नहीं है। यह सुनिश्चित करना है कि आपका सावधानीपूर्ण काम दूसरी भाषा में स्पष्ट लिखे जाने के “अपराध” के लिए फ्लैग होने के बजाय उसकी योग्यता (merits) पर आँका जाए। देशों के पार भाषा-परिदृश्य (language picture) के लिए देखें हमारा multilingual AI humanizer hub।
स्थानीय फंडिंग निकाय, जर्नल, और AI-डिस्क्लोज़र की अपेक्षाएँ
हंगरी में प्रतिस्पर्धी अनुसंधान का वित्तपोषण मुख्यतः NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office) के माध्यम से होता है; राष्ट्रीय अकादमी के रूप में MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) और सार्वजनिक अनुसंधान संस्थानों का संचालन HUN-REN (the Hungarian Research Network) करता है। ये सभी प्रकाशित, इंडेक्स्ड (indexed) आउटपुट को पुरस्कृत करते हैं, जिससे शोधकर्ताओं पर अंग्रेज़ी में प्रकाशन का स्थायी दबाव बना रहता है।
यह आउटपुट Web of Science और Scopus-इंडेक्स्ड जर्नल्स में मापा जाता है, और इसे MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography), राष्ट्रीय प्रकाशन डेटाबेस में पंजीकृत किया जाता है। मूल्यांकन-परंपरा (evaluation culture) अंतरराष्ट्रीय, अंग्रेज़ी-भाषा में प्रकाशन को पुरस्कृत करती है, और ठीक यही वह दबाव है जो हंगेरियाई विद्वानों को उस साफ़-सुथरी, मानक गद्य (prose) की ओर धकेलता है जिसे डिटेक्टर अक्सर perplexity-आधारित गलत पढ़ाई में फँसा देते हैं।
AI-उपयोग का खुलासा ग्रांट रिपोर्टिंग और जर्नल सबमिशन, दोनों में अधिक आम होने की उम्मीद है। इसे नियमित (routine) मानिए। आप किन टूल्स का उपयोग कर रहे हैं और कैसे, यह स्पष्ट रूप से बताइए, अपने डेटा और साइटेशन को ईमानदार रखें, और आप अनुचित फ्लैग्स के खिलाफ अपने लेखन का बचाव करते हुए भी नियमों के भीतर सहजता से बने रहेंगे।
अक्सर पूछे जाने वाले प्रश्न
प्रश्न: क्या हंगेरियाई शोधकर्ताओं के लिए AI ह्यूमनाइज़र मेरे साइटेशन या तकनीकी शब्दों को बदलता है?
नहीं। ह्यूमनाइज़र इस तरह बनाया गया है कि आपका अर्थ, आपकी विशिष्ट अनुशासन-आधारित शब्दावली (discipline-specific terminology), और हर संदर्भ (reference) बिल्कुल उसी तरह बना रहे जैसा आपने लिखा है। यह लय (rhythm) और वाक्य-प्रस्तुति (phrasing) बदलता है, आपके विज्ञान (science) या आपके स्रोतों (sources) को नहीं।
प्रश्न: क्या कोई भी टूल यह गारंटी दे सकता है कि मेरा पेपर हर AI डिटेक्टर को पास कर देगा?
नहीं, और आपको ऐसे किसी भी व्यक्ति/सेवा पर भरोसा नहीं करना चाहिए जो ऐसा दावा करे। डिटेक्टर नियमित रूप से फिर से प्रशिक्षित (retrained) होते हैं, इसलिए कोई भी ईमानदार सेवा 100% undetectable होने का वादा नहीं कर सकती। हम जो कह सकते हैं वह यह है कि हमारे परीक्षण में, सावधानीपूर्ण गैर-स्थानीय गद्य को ह्यूमनाइज़ करने से यह काफी हद तक घटा कि उसे मशीन-लिखित मानकर कितनी बार गलत पढ़ा गया।
प्रश्न: क्या अपने ही ड्राफ्ट को ह्यूमनाइज़ करना धोखाधड़ी (cheating) का एक रूप है?
यह धोखाधड़ी नहीं है, बशर्ते आप अपने ही AI-सहायता प्राप्त लेखन पर काम कर रहे हों, अपने निष्कर्षों (findings) को ईमानदारी से बनाए रख रहे हों, और अपने संस्थान एवं जर्नल की अपेक्षा अनुसार अपने टूल उपयोग का खुलासा कर रहे हों। लक्ष्य वास्तविक काम के लिए निष्पक्षता (fairness) है, छुपाव (disguise) नहीं।
प्रश्न: मेरा स्पष्ट अंग्रेज़ी फ्लैग क्यों हो जाता है, जबकि कमजोर लेखन नहीं?
क्योंकि कई डिटेक्टर predictability स्कोर करते हैं। सावधानीपूर्ण दूसरी भाषा के लेखक सुरक्षित, मानक और सही निर्माण (constructions) चुनते हैं, जिससे low-perplexity टेक्स्ट बनता है, और low perplexity वही सटीक पैटर्न है जिसे ये टूल मशीन-लेखन से जोड़ते हैं। आपकी स्पष्टता (clarity) आपके खिलाफ काम करती है।
प्रश्न: मैं पहले हंगेरियाई में लिखता/लिखती हूँ। क्या टूल उसे संभालता है?
हाँ। गैर-अंग्रेज़ी टेक्स्ट एक भाषा-समझ वाले मॉडल से होकर गुजरता है जो साठ से अधिक भाषाओं में वाक्य-रचना (sentence structure) और अर्थ (meaning) को संरक्षित रखता है, ताकि आप हंगेरियाई में ड्राफ्ट कर सकें, अनुवाद कर सकें, और फिर अंग्रेज़ी संस्करण को बिना अपने तर्क को खोए ह्यूमनाइज़ कर सकें।
अपने सावधानीपूर्वक तैयार, AI-सहायता प्राप्त Hungarian-English ड्राफ्ट को प्राकृतिक शैक्षणिक गद्य में बदलिए, हर उद्धरण और निष्कर्ष को बनाए रखते हुए, फिर आत्मविश्वास के साथ अपना AI उपयोग प्रकट कीजिए।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


