OpenAI واٹرمارک، SynthID اور Claude: متنی واٹرمارکس کا تقابل
کیا OpenAI اپنے متن پر واٹرمارک لگاتا ہے، کیا عوام کے لیے کوئی OpenAI واٹرمارک چیکر موجود ہے، اور SynthID اور Claude کے واٹرمارکس میں کیا فرق ہے، تعلیمی لکھنے والوں کے لیے تقابلی طور پر؟
OpenAI، Google اور Anthropic نے سب نے ایک ہی ٹیکنالوجی بنائی ہے: AI سے تیار کردہ متن کے لیے ایک شماریاتی واٹرمارک۔ OpenAI نے اپنے ورژن کو برسوں تک روک کر رکھا اور اسے اکتوبر 2026 میں متن کے نام سے textGrain کے طور پر بتدریج جاری کرنا شروع کیا۔ Google نے SynthID کو Gemini کے اندر شامل کر کے طریقہ شائع کیا۔ Anthropic نے اگست 2026 میں Claude کے واٹرمارک کو ہر صارف کے لیے لازمی کر دیا۔ اگر آپ کسی بھی صورت میں AI کی مدد سے لکھتے ہیں تو اب یہ تینوں فیصلے آپ کے دستاویزات کے پرکھے جانے کے انداز کو متاثر کرتے ہیں۔
واٹرمارکنگ 11 اگست 2026 کو تحقیقی موضوع سے مین اسٹریم خبروں میں داخل ہوئی، جب Anthropic نے اعلان کیا کہ ہر نیا Claude ماڈل اپنے متن کے آؤٹ پٹ پر واٹرمارک لگاتا ہے۔ ہم نے اپنے Anthropic کا Claude واٹرمارک، تفصیل سے (2026) میں اس اعلان کو تفصیل سے کور کیا۔ یہ گائیڈ پورا منظرنامہ بیان کرتی ہے: ایک متن کا واٹرمارک کیا ہوتا ہے، تین بڑے اداروں میں سے ہر ایک نے اسے کیسے لاگو کیا یا کیوں روکے رکھا، اور ہر نظام ایک تحریر کے بارے میں کیا ثابت کرتا ہے۔
AI متن کا واٹرمارک کیا ہے؟
AI متن کا واٹرمارک پیدا کیے گئے متن کے لفظوں کے انتخاب میں چھپا ہوا ایک شماریاتی پیٹرن ہوتا ہے۔ اسے جینریشن کے وقت ہی نصب کیا جاتا ہے تاکہ بعد میں درست کلید رکھنے والا ڈیٹیکٹر یہ تصدیق کر سکے کہ وہ متن کسی مخصوص AI نظام سے آیا ہے۔ یہ نظر آنے والا لیبل نہیں ہوتا، کوئی چھپا ہوا حروف نہیں ہوتا، اور یہ کسی فائل سے منسلک میٹا ڈیٹا بھی نہیں ہوتا۔ یہ نشان خود الفاظ کے اندر زندہ رہتا ہے۔
یہ فرق اہم ہے، کیونکہ "واٹرمارک" کی اصطلاح تین مختلف چیزوں کے لیے ڈھیلے انداز میں استعمال ہوتی ہے:
| یہ کیا ہے | یہ کہاں رہتا ہے | کیا کاپی پیسٹ میں بھی محفوظ رہتا ہے؟ | |
|---|---|---|---|
| شماریاتی واٹرمارک | یہ ایک تعصب ہے جس میں ماڈل وہ الفاظ چنتا ہے | خود متن | ہاں |
| فائل میٹا ڈیٹا (C2PA) | ایک دستخط شدہ provenance لیبل | فائل کنٹینر | نہیں، سادہ متن کی نقل لینے سے یہ ختم ہو جاتا ہے |
| صفر-چوڑائی والے حروف | متن میں پوشیدہ یونیکوڈ داخل کر دیا جاتا ہے | واضح حروف کے درمیان | نہیں، آسانی سے ہٹا دیا جاتا ہے |
تین میں سے صرف شماریاتی واٹرمارکنگ ہی کاپی، پیسٹ، دوبارہ ٹائپ اور نئے دستاویز میں فارمیٹ کنورژن کے بعد بھی برقرار رہتی ہے۔ اسی لیے تینوں بڑی لیبز نے متن کے لیے اسی پر اتفاق کیا، اور اسی لیے ایسی "واٹرمارک ہٹانے والی" ٹولز جو پوشیدہ حروف ہٹاتی ہیں اس کے خلاف کچھ نہیں کرتیں۔ ہمارا Claude واٹرمارک ریموور والا صفحہ ذرائع کے ساتھ اس ناکامی کے طریقے کو دستاویز کرتا ہے۔
شماریاتی واٹرمارکنگ حقیقت میں کیسے کام کرتی ہے؟
جملہ لکھنے کے ہر مرحلے پر ایک زبان ماڈل کئی قریب ترین متبادل الفاظ میں سے انتخاب کرتا ہے، اور ایک واٹرمارک خاموشی سے ان ڈائس کو لوڈ کر دیتا ہے۔ بنیادی نسخہ جنوری 2023 میں یونیورسٹی آف میری لینڈ کے Kirchenbauer اور ان کے ساتھیوں نے شائع کیا تھا، A Watermark for Large Language Models (ICML 2023) میں۔ یہ یوں کام کرتا ہے:
- ہر لفظ کے منتخب ہونے سے پہلے، پچھلے الفاظ سے اخذ کردہ ایک خفیہ کلید ذخیرہ الفاظ کو ایک ترجیحی سیٹ اور ایک غیر جانبدار سیٹ میں تقسیم کر دیتی ہے۔
- ماڈل اپنی پسند کو ترجیحی سیٹ کی طرف ہلکا سا جھکاتا ہے۔ "Suggest" کے مقابلے میں "indicate"۔ "Across" کے مقابلے میں "among"۔ ہر انفرادی انتخاب بالکل فطری لگتا ہے۔
- ایک ایسا ڈیٹیکٹر جو کلید رکھتا ہے گنتی کرتا ہے کہ متن کتنی بار ترجیحی سیٹس میں جا کر ٹھہرتا ہے۔ انسانی لکھائی اتفاق سے متوقع شرح پر پہنچتی ہے۔ واٹرمارک شدہ متن اس سے کہیں زیادہ شرح پر جا پہنچتا ہے، اور ایک شماریاتی ٹیسٹ اس فرق کو نشان زد کر دیتا ہے۔
کوئی ایک لفظ خود میں کسی بھی چیز کا ثبوت نہیں۔ سگنل درجنوں یا سینکڑوں انتخابوں کے ساتھ ہی سامنے آتا ہے، اسی لیے لمبے پیراگراف مختصر جملوں کی نسبت زیادہ آسانی سے ٹیسٹ ہو جاتے ہیں، اور اسی لیے ڈیٹیکشن ہمیشہ احتمال پر مبنی ہوتی ہے، ہاں یا نہیں کے سٹیمپ کی طرح نہیں۔
Google DeepMind کا پروڈکشن سسٹم، جسے اکتوبر 2024 میں Nature میں Scalable watermarking for identifying large language model outputs کے نام سے شائع کیا گیا، اسے tournament sampling نامی تکنیک کے ساتھ بہتر بنایا۔ یہ متن کے معیار کو اتنا بہتر رکھتا ہے کہ اسے بڑے پیمانے پر کسی صارف مصنوعات کے اندر خاموشی سے چلایا جا سکے۔ یہ تحقیق Google سے بھی آگے اہم ہے: یہ وہ شائع شدہ بنیاد ہے جس کی طرف Anthropic Claude کے نفاذ کے لیے اشارہ کرتا ہے۔
اہم کمزوری زیادہ تر ڈپلائمنٹس سے پہلے ہی شائع ہو چکی تھی۔ مارچ 2023 میں، Krishna اور ان کے ساتھیوں نے دکھایا کہ AI-generated text کے detection کو پیرا فریزنگ ناکام بناتی ہے (NeurIPS 2023) کہ ذریعے کسی پیراگراف کی دوبارہ لفظ بندی کرنے سے تمام طریقوں میں، واٹرمارکنگ سمیت، ڈیٹیکشن ٹوٹ جاتا ہے۔ سگنل اسی عین ٹوکن تسلسل میں رہتا ہے، کہیں اور نہیں۔ اس لیے جو کچھ بھی اس تسلسل کو دوبارہ لکھ دے، چاہے وہ انسانی ایڈیٹر ہی کیوں نہ ہو، ثبوت کو بھی ساتھ میں دوبارہ لکھ دیتا ہے۔ آج جو بھی وینڈرز واٹرمارک بھیجتے ہیں، وہ اپنی اپنی دستاویزات میں اس حد بندی کو واضح طور پر بیان کرتے ہیں۔
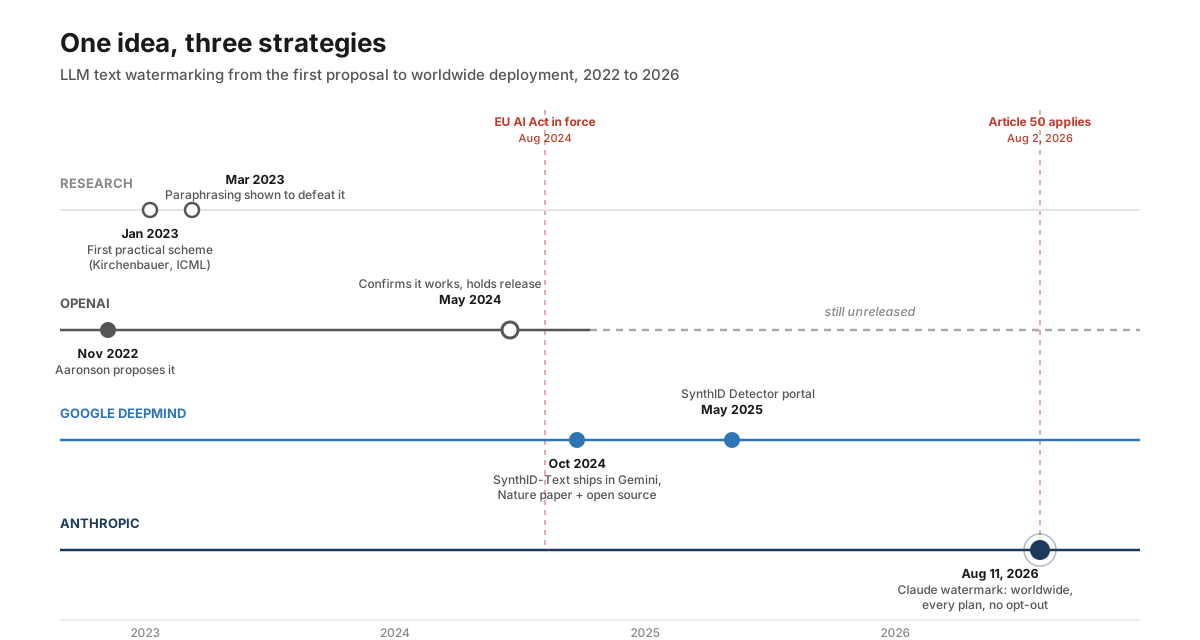
OpenAI: وہ کمپنی جس نے اسے ایجاد کیا اور سب سے آخر میں ریلیز کیا
OpenAI کے پاس کئی برسوں سے ٹیکسٹ واٹرمارک کام کر رہا تھا اور اسے اکتوبر 2026 تک ریلیز نہ کرنے کا انتخاب کیا۔ Scott Aaronson، اُس وقت OpenAI میں سیفٹی پر کام کر رہے تھے، نے سب سے پہلے اس خیال کو عوامی طور پر ایک November 2022 lecture میں بیان کیا۔ یہ طریقہ ایک خفیہ کرپٹوگرافک فنکشن کے ساتھ قریب ترین متبادل الفاظ کے درمیان ماڈل کی پسند کو بائیاس کرتا ہے، اس لیے خود متن ظاہر کرتا ہے کہ وہ کہاں سے آیا۔ یہ لیکچر ہر اُس سسٹم سے پرانا ہے جو آج تعینات ہو چکا ہے۔
مئی 2024 میں، OpenAI نے اپنی provenance اپ ڈیٹ میں منصوبے کی موجودہ صورتحال بیان کی، آن لائن جو کچھ ہم دیکھتے اور سنتے ہیں اس کے ماخذ کو سمجھنا۔ کمپنی نے کہا کہ اس کا ٹیکسٹ watermarking طریقہ چھوٹے ترمیموں پر درست اور مؤثر ہے، لیکن وہ فریقین کے درمیان توازن کے پہلو دیکھنے کے بعد ہی ریلیز روک کر رکھے ہوئے تھا۔ جن دو خطرات کو OpenAI نے نامزد کیا، وہ براہ راست تعلیمی لکھنے والوں کے لیے اہم ہیں:
- آسان circumvention۔ متن کو paraphrase کرنا یا ترجمہ کرنا اس نشان کو ختم کر دیتا ہے، بالکل ویسا ہی جیسا کہ 2023 کی تحقیق نے پیش گوئی کی تھی۔ وہ watermark جو زیادہ تر اُن لوگوں کو پکڑتا ہے جو یہ نہیں جانتے کہ وہ موجود ہے، نفاذ کے لیے کمزور آلہ ہے۔
- غیر مادری انگریزی بولنے والوں پر غیر متناسب اثر۔ OpenAI نے بتایا کہ watermarking AI کے کسی حقیقی استعمال کو، بطور تحریری معاون، جو دوسرے درجے کی زبان میں لکھنے والے افراد کے لیے ہو، stigmatize کر سکتی ہے۔ ہمارے مضمون میں کیوں AI detectors غیر مادری لکھنے والوں کو نشان زد کرتے ہیں اسی مسئلے کو detector کے زاویے سے بھی دیکھا گیا ہے۔
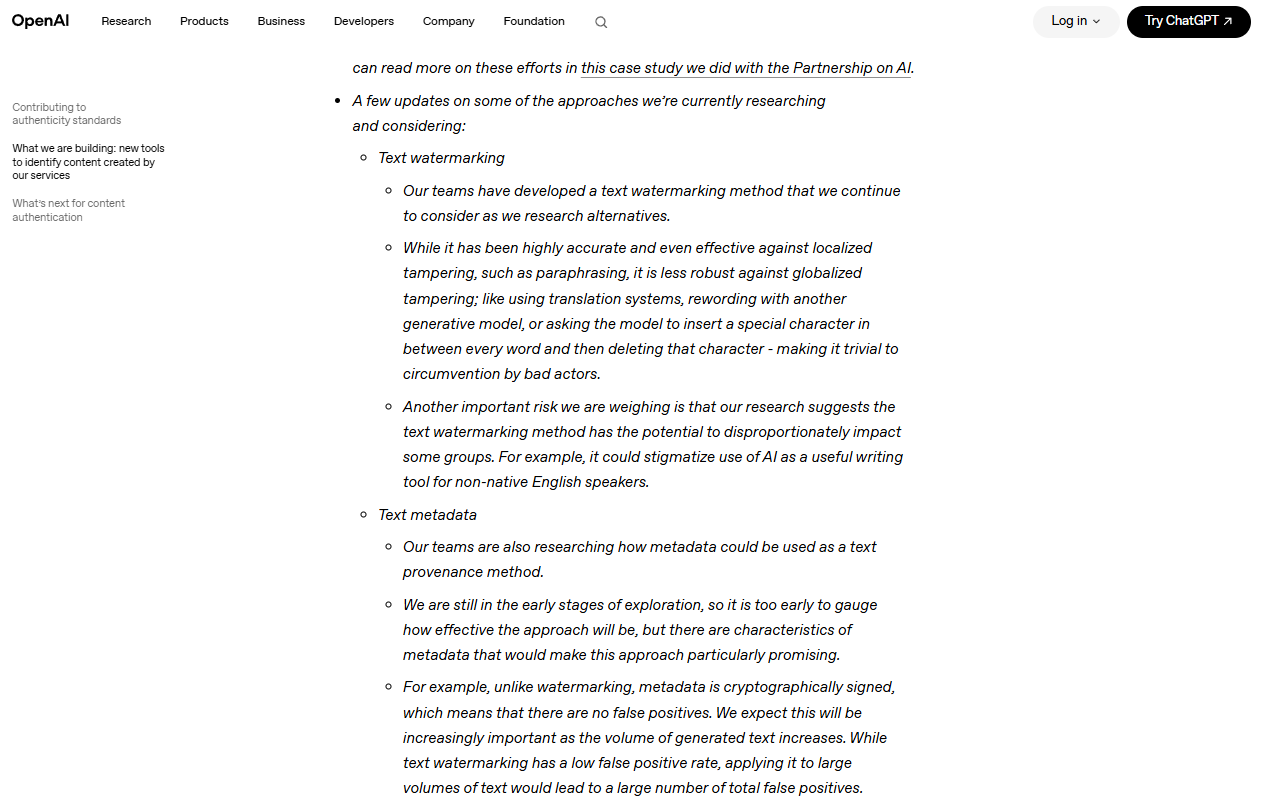
OpenAI کی 2024 provenance اپ ڈیٹ: طریقہ کار کام کرتا ہے، اور کمپنی نے اس وقت اسے روک کر رکھنے کی وجوہات درج کی ہیں۔
تصویروں اور آڈیو کے لیے، OpenAI نے مختلف راستہ اختیار کیا: DALL-E اور Sora آؤٹ پٹس میں C2PA provenance میٹا ڈیٹا، جو مواد کے اندر کوئی نشان نہیں بلکہ فائل لیول لیبل ہے۔ متن کے لیے، ChatGPT کے آؤٹ پٹ میں اکتوبر 2026 تک کوئی watermark نہیں تھا۔ جس کمپنی نے یہ ٹیکنالوجی تجویز کی تھی، وہ تینوں میں سب سے آخر میں اسے تعینات کرنے والی تھی۔
کیا OpenAI اب ٹیکسٹ کو watermark کرتا ہے؟
جی ہاں، OpenAI نے 5 اکتوبر 2026 سے کچھ متن پر watermarkنگ شروع کی، EU AI Act کے جواب میں۔ اس کی اعلان میں textGrain نام کا ایک ٹیکسٹ watermark متعارف کرایا گیا ہے، جو ماڈل کے الفاظ کے انتخاب میں ایک پوشیدہ شماریاتی سگنل شامل کرتا ہے۔ اس رول آؤٹ کے تین حصے ہیں، اور watermark ڈیفالٹ طور پر سب پر فعال نہیں ہے:
- کسی بھی جگہ کے API صارف منتخب ماڈلز کے لیے watermarked آؤٹ پٹ آن کر سکتے ہیں۔ یہ ڈیفالٹ طور پر بند رہتا ہے۔
- اگلے چند ہفتوں میں، یورپی یونین میں اہل ChatGPT اور Codex کے ٹیکسٹ آؤٹ پٹ پر ہر پلان میں یہ watermark لگ جائے گا۔
- منظور شدہ محققین اور ماہر تنظیمیں ٹیکسٹ watermark detector تک رسائی کے لیے درخواست دے سکتی ہیں۔
OpenAI کے مطابق textGrain نے جانچے گئے دیگر طریقوں کو یا تو برابر کیا یا انہیں پیچھے چھوڑ دیا، جن میں متن کے لیے Google's SynthID بھی شامل ہے۔ اس نے یہ بھی شائع کیا کہ detection کہاں کمزور پڑتی ہے۔ 1% false-positive ریٹ پر، detector نے نفسیات کے مواد میں تقریباً 200 ٹوکن کے پیراگراف میں 80% اور تقریباً 400 ٹوکن کے پیراگراف میں 95% میں watermark کی نشاندہی کی۔ ریاضی کے لیے detection بہت کم تھی، جہاں الفاظ کے انتخاب کی آزادی کم ہوتی ہے۔
ترمیم سگنل کو تیزی سے کمزور کر دیتی ہے۔ 400 ٹوکن کے پیراگراف میں، 10% الفاظ کو مترادفات سے بدلنے پر detection تقریباً 92% سے گھٹ کر 66% ہو گئی، اور 25% بدلنے پر یہ 17% رہ گئی۔
OpenAI نے یہ بھی چیک کیا کہ یہ watermark Astra، اس کے تازہ ترین ماڈل، پر جواب کے معیار کو تو نہیں بدل دیتا، اور کہتا ہے کہ اسے کوئی بامعنی فرق نظر نہیں آیا۔ یہ چار benchmarks ہیں جو اس نے شائع کیے:
| Benchmark | Without watermark (Astra) | With watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 پوائنٹس | 49.76 پوائنٹس |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
طلبہ کے لیے تاریخ اہم ہے۔ rollout سے پہلے لکھا گیا ChatGPT متن، یا API سیٹنگ کے بغیر EU سے باہر، OpenAI watermark نہیں رکھتا۔ ہمارے Turnitin Clarity کی وضاحت متعلق گائیڈ میں بتایا گیا ہے کہ اسکول اس دوران اپنی AI استعمال کی پالیسیز کیسے بنا رہے ہیں۔
کیا کوئی عوامی OpenAI watermark checker موجود ہے؟
ابھی تک متن کے لیے OpenAI کا کوئی عوامی واٹرمارک چیکر موجود نہیں۔ OpenAI کا مفت تصدیقی ٹول امیج اور آڈیو فائلوں کو C2PA Content Credentials اور SynthID واٹرمارک کے لیے چیک کرتا ہے، جسے OpenAI سپورٹڈ امیجز اور آڈیو میں ایمبیڈ کرتا ہے۔ OpenAI کے مطابق یہ ٹول متن کو سپورٹ نہیں کرتا۔
متن کے لیے، OpenAI کیس بہ کیس منظور شدہ محققین اور ماہر تنظیموں کو ڈیٹیکٹر تک رسائی دیتا ہے، اپنے Content Provenance API فارم کے ذریعے۔ اس کا کہنا ہے کہ وہ لانچ کے وقت ٹیکسٹ ڈیٹیکٹر کو عوامی نہیں بنا رہا کیونکہ واٹرمارکس رہ جانے اور false positives کے خطرے کی وجہ سے۔ ڈیٹیکٹر یہ بتاتا ہے کہ آیا اسے OpenAI واٹرمارک ملتا ہے یا نہیں، اور یہ صارف کی شناخت نہیں کرتا اور نہ ہی ان کے prompts دکھاتا ہے۔
| آپ کیا چیک کرنا چاہتے ہیں | ٹول | یہ کون استعمال کر سکتا ہے |
|---|---|---|
| OpenAI کی کوئی امیج یا آڈیو فائل | OpenAI کا verification tool | کوئی بھی، مفت |
| OpenAI کا ٹیکسٹ آؤٹ پٹ (textGrain) | OpenAI کا ٹیکسٹ واٹرمارک ڈیٹیکٹر | منظور شدہ محققین اور ماہر تنظیمیں، درخواست کے ذریعے |
| Claude کا ٹیکسٹ آؤٹ پٹ | Claude Watermark Detector | مستحق تنظیمیں، درخواست کے ذریعے (ہمارا Anthropic کا Claude واٹرمارک، تفصیل سے (2026) دیکھیں) |
OpenAI یہ بھی واضح کرتا ہے کہ کوئی نتیجہ آپ کو کیا نہیں بتا سکتا۔ ایک ڈیٹیکٹ ہونے والا واٹرمارک یہ نہیں ناپتا کہ کسی شخص نے کتنا حصہ ڈالا، اور یہ یہ بھی شناخت نہیں کرتا کہ کس نے متن لکھا یا استعمال کیا۔ واٹرمارک کا نہ ملنا انسانی مصنفیت ثابت بھی نہیں کرتا کیونکہ متن بہت مختصر ہو سکتا ہے، ایڈٹ یا ترجمہ کیا گیا ہو، یا کسی غیر سپورٹڈ ماڈل سے آیا ہو۔
Google: پہلے لانچ کرنے والا، پھر نسخہ عام کر دیا
Google DeepMind سب سے پہلے سامنے آیا، پورے طریقے کو شائع کیا، پھر اسے کھلے طور پر شیئر کر دیا۔ اس کا سسٹم، SynthID، ابتدا میں 2023 میں امیج واٹرمارک کے طور پر شروع ہوا اور 2024 میں متن تک پھیل گیا۔ جب اکتوبر 2024 میں Nature کا پیپر آیا، SynthID-Text پہلے ہی پروڈکشن میں Gemini کے اندر چل رہا تھا، جس کی وجہ سے یہ صارف سطح پر پیمانے پر تعینات ہونے والا پہلا شماریاتی ٹیکسٹ واٹرمارک بنا۔
SynthID متن، تصاویر، آڈیو اور ویڈیو کا احاطہ کرتا ہے، اور اکتوبر 2024 سے Gemini کے ٹیکسٹ آؤٹ پٹ میں موجود ہے۔
اس کے بعد Google نے اس کے نفاذ کو اوپن سورس آن Hugging Face کے طور پر شائع کیا، جس سے کوئی بھی ڈویلپر اپنی اپنی ماڈلز پر وہی واٹرمارکنگ اسکیم لاگو کر سکتا ہے۔ مئی 2025 میں اس نے SynthID Detector کا اعلان کیا، جو ایک verification پورٹل ہے جہاں متن، امیجز، آڈیو اور ویڈیو میں SynthID کے نشانات کے لیے مواد چیک کیا جا سکتا ہے۔
ایک اہم دائرہ محدودیت یہ ہے کہ SynthID صرف گوگل کے اپنے ماڈلز سے تیار کردہ مواد کو نشان لگاتا ہے اور صرف انہیں detect کرتا ہے۔ یہ ChatGPT یا Claude کے آؤٹ پٹ کے بارے میں کچھ نہیں کہتا، اور ایک صاف ستھرا SynthID اسکین اس بات کا مطلب نہیں کہ متن انسان نے لکھا ہے۔ اس کا مطلب یہ ہے کہ گوگل کے ماڈلز نے اسے نہیں لکھا، جو کہ ایک بہت زیادہ محدود دعویٰ ہے۔
Anthropic: سب سے آخر میں حرکت، سب سے سخت پالیسی
Anthropic نے سب سے آخر میں تعینات کیا، اور سب سے وسیع لازمی کوریج کے ساتھ۔ 2 اگست 2026 کے بعد لانچ ہونے والا ہر Claude ماڈل اپنے ٹیکسٹ آؤٹ پٹ میں شماریاتی واٹرمارک ایمبیڈ کرتا ہے، دنیا بھر میں، ہر پلان پر، بغیر کسی opt-out کے۔ کمپنی اپنے explainer میں اس میکانزم کو بیان کرتی ہے، Claude کے ٹیکسٹ واٹرمارک کیسے کام کرتے ہیں، اور پالیسی کے دائرے کو اپنی help-center تحریر میں واضح کرتی ہے، Claude AI سے تیار کردہ مواد کو کیسے نشان زد کرتا ہے۔ اس کے تحت Claude API، claude.ai، Claude Code، Claude Cowork، اور Claude Tag سب کور ہوتے ہیں۔ کٹ آف سے پہلے لانچ ہونے والے ماڈلز ایک عبوری مدت میں ہیں، اور Anthropic کا کہنا ہے کہ وہ ان میں بھی مارکنگ سپورٹ شامل کر رہا ہے۔ شماریاتی نشان کے ساتھ ساتھ، Claude-generated فائلوں میں C2PA میٹاڈیٹا بھی ہوتا ہے، جو ایک دوسرا، الگ سسٹم ہے جسے سادہ ٹیکسٹ کاپی کر کے اتار دیا جاتا ہے۔
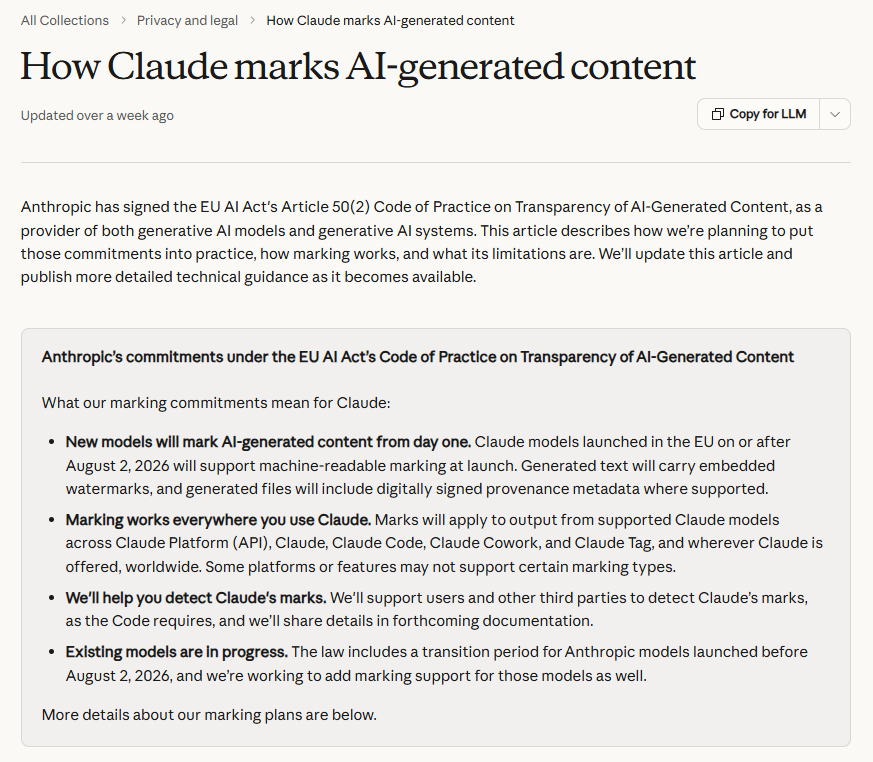
Anthropic کی اپنی زبان میں پالیسی: ہر نیا ماڈل، ہر پلیٹ فارم، دنیا بھر میں، اور پرانے ماڈلز شامل کیے جا رہے ہیں۔
Anthropic کی دستاویزات حدود کو صاف طور پر بیان کرتی ہیں۔ ڈٹیکشن احتمالی (probabilistic) ہے۔ یہ مارک کسی ایسے دستاویز میں فرق نہیں کر سکتا جو Claude نے لکھی ہو اور کسی ایسی دستاویز میں جو انسان نے لکھی ہو اور Claude نے معمولی ترمیم کر دی ہو۔ مکمل ری رائٹ اسے ختم کر دیتا ہے۔ ہم نے یہ سب واضح کیا، بشمول یہ کہ مثبت ڈٹیکشن واقعی کیا ثابت کرتا ہے، اور اگر آپ کی اپنی تحریر پر مارک لگ جائے تو کیا کرنا چاہیے، متعلقہ Claude واٹرمارک گائیڈ.
یہ ٹائمنگ ضابطے کے مطابق ہے۔ Anthropic نے EU AI Act کے تحت AI سے تیار کردہ مواد کی شفافیت کے متعلق Article 50(2) Code of Practice پر دستخط کیے ہیں، جس کے مطابق جنریٹیو AI سسٹمز فراہم کرنے والوں کو یہ یقینی بنانا ہوتا ہے کہ آؤٹ پٹس کو "مشین ریڈ ایبل فارمیٹ میں مارک کیا جائے اور اسے مصنوعی طور پر تیار کیے گئے کے طور پر پہچانا جا سکے۔" یہ شفافیت کی ذمہ داریاں 2 اگست 2026 سے نافذ ہو گئیں: یہ Anthropic کی ماڈل پالیسی میں عین کٹ آف تاریخ ہے، جو عوامی اعلان سے نو دن پہلے ہے۔ Anthropic نے EU ٹریفک کے لیے الگ رویہ برقرار رکھنے کے بجائے عالمی سطح پر تعمیل کرنے کا فیصلہ کیا۔ Google پہلے ہی ڈیزائن کے ذریعے تعمیل کرنے والا تھا۔ OpenAI کی بغیر مارک کے ٹیکسٹ آؤٹ پٹ والی صورت 2027 میں کھلا تعمیل والا سوال ہے۔
تین طریقے، ایک ساتھ
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| کیا ٹیکسٹ واٹرمارک تعینات ہے؟ | ہاں (textGrain، 5 اکتوبر 2026 سے EU رول آؤٹ) | ہاں (Gemini، اکتوبر 2024 سے) | ہاں (Claude ماڈلز، 2 اگست 2026 سے) |
| طریقہ کار | textGrain، الفاظ کے انتخاب میں ایک شماریاتی سگنل | SynthID-Text ٹورنامنٹ سیمپلنگ | شماریاتی سیمپلنگ مارک، SynthID طرز کا |
| کوریج | EU میں اہل ChatGPT اور Codex متن؛ API کے ذریعے دنیا بھر میں آپٹ اِن | صرف Google کے ماڈلز | تمام نئے Claude ماڈلز؛ پرانے ماڈلز منتقلی میں |
| آؤٹ آپٹ | API میں بطور ڈیفالٹ بند | نہیں | نہیں |
| عوامی ڈٹیکٹر | نہیں | SynthID Detector پورٹل (2025) | مقررہ طور پر، ابھی تک ریلیز نہیں ہوا |
| کیا اسکیم شائع ہوئی؟ | صرف تصوراتی لیکچرز | Nature پیپر + اوپن سورس | تشریح، شائع شدہ کام پر مبنی |
| فائل میٹاڈیٹا (C2PA) | جی ہاں، تصاویر اور آڈیو | جی ہاں، مختلف میڈیا میں | جی ہاں، تیار شدہ فائلوں پر |
| واضح کردہ حدود | بچ نکلنے کی کوشش، ESL کی بدنامی | حدود صرف اپنے ماڈلز تک | احتمالی نوعیت، ترمیم سے مصنفیت دھندلا جاتی ہے |
کالموں میں پیٹرن یہ ہے: OpenAI متن کی واٹرمارکنگ کو ایک غیر حل شدہ پالیسی مسئلہ سمجھتا ہے، Google اسے معیاری بنانے کے لیے بنیادی ڈھانچہ کہتا ہے، اور Anthropic اسے مکمل طور پر نافذ کرنے کی ایک تعمیل کی ذمہ داری سمجھتا ہے۔
اس کا مطلب محققین اور تعلیمی لکھنے والوں کے لیے
عملی نتائج اس بات پر منحصر ہیں کہ کون سے ٹولز آپ کے متن کو چھوتے ہیں۔ اگر آپ ChatGPT کے ساتھ ڈرافٹ کرتے ہیں تو آج آپ کے متن پر کوئی واٹرمارک نہیں ہوتا۔ اگر آپ Gemini کے ساتھ ڈرافٹ کرتے ہیں تو اس پر SynthID کی ایک نشانی ہوتی ہے جسے صرف Google کا ڈیٹیکٹر پڑھ سکتا ہے۔ اگر آپ موجودہ Claude ماڈل کے ساتھ ڈرافٹ یا ترمیم کرتے ہیں تو اس پر Anthropic کی نشانی ہوتی ہے، اور اسے بند کرنے کی کوئی ترتیِب موجود نہیں۔
تین چیزیں جو ہر تعلیمی لکھنے والے کو جاننی چاہئیں:
واٹرمارک کسی ٹول کی نشاندہی کرتا ہے، کسی مصنف کی نہیں۔ ہر وینڈر اپنی دستاویزات میں یہ بات واضح کرتا ہے، اور اسے دہرانا قابل قدر ہے کیونکہ ادارہ جاتی پالیسیاں ہمیشہ اس فرق کو سامنے نہیں رکھتیں۔ متن پر نشان لگ سکتا ہے کیونکہ کسی AI نے اسے ڈرافٹ کیا، کیونکہ کسی AI نے اس کے دو جملوں کی کاپی ایڈیٹنگ کی، یا کیونکہ کسی نشان زدہ پیراگراف کو نقل کر کے اقتباس بنایا گیا۔ اگر آپ کا ادارہ واٹرمارک چیک چلاتا ہے تو اس چیک سے یہ ثابت ہوتا ہے کہ کسی مخصوص ماڈل نے کسی وقت متن کو چھوا، اس سے بڑھ کر کچھ نہیں۔ ہمارا رہنما غلط AI ڈیٹیکشن فلیگ کے خلاف اپیل بتاتا ہے کہ جب ضرورت ہو تو یہ دلیل کیسے دی جائے۔
واٹرمارکس اور AI ڈیٹیکٹر مختلف ٹیکنالوجیاں ہیں، مختلف ناکامی کے طریقوں کے ساتھ۔ Turnitin یا GPTZero جیسے ڈیٹیکٹر شماریاتی انداز سے اندازہ لگاتے ہیں، ان درستگی کے مسائل کے ساتھ جو ہم دستاویزی طور پر بیان کر چکے ہیں۔ واٹرمارک ڈیٹیکشن ایک کلیدی بنیاد پر پرکھ ہے جس میں غیر نشان زدہ انسانی متن پر غلط مثبت کی شرح بہت کم ہوتی ہے۔ منفی کی طرف غلطی (false negatives) کا عدم توازن الٹا ہے: واٹرمارک چیک ایسے کسی بھی AI متن کو چھوٹ دیتا ہے جو ایسے غیر واٹرمارکنگ ماڈل سے آیا ہو، اور آج یہ سب ChatGPT کے لیے شامل ہے۔
اعلان دینا آپ کی سب سے مضبوط پوزیشن ہے۔ واٹرمارکنگ کے ساتھ خاموش AI استعمال کا خطرہ بڑھ جاتا ہے اور اعلان شدہ AI استعمال زیادہ محفوظ ہو جاتا ہے، کیونکہ اعلان شدہ ورک فلو کو مثبت نشان سے کوئی خوف نہیں۔ زیادہ تر جرائد اور یونیورسٹیز کے پاس اب AI استعمال کی واضح پالیسیاں ہیں؛ ہمارا AI use پالیسی بتاتا ہے کہ ہم اپنی اپنی ٹولز کے درمیان یہ حدود کیسے کھینچتے ہیں، اور یہ اس بات کے لیے ایک مناسب نمونہ ہے کہ شفاف استعمال کیسا ہونا چاہیے۔
کیا متن سے واٹرمارک ہٹا دیتا ہے، اور کیا نہیں
ری رائٹنگ اسے ہٹا دیتی ہے، مگر ریفارمیٹنگ نہیں۔ کاپی کرنا، پیسٹ کرنا، فونٹس بدلنا، فائل فارمیٹس کے درمیان تبدیل کرنا، اور غیر مرئی حروف کو ہٹانا سب کچھ واٹرمارک کو مکمل طور پر برقرار رکھتے ہیں، کیونکہ یہ نشان لفظوں کے انتخاب میں ہوتا ہے۔ اسے ہٹانے والی چیز وہ ہے جو لکھائی کو دوبارہ تخلیق کرے: گہری انسانی ترمیم، ترجمہ، یا واقعی پیرا فرے۔ جیسا کہ NeurIPS 2023 کی مضبوطی والی تحقیق نے ثابت کیا، یہ نتائج انہی سسٹمز کے مارکیٹ میں آنے سے پہلے قائم تھے۔
یہاں دونوں سمتیں اہم ہیں۔ نشان کا غائب ہونا متن کو آپ کا نہیں بناتا، اور نشان کا برقرار رہنا متن کو آپ کا نہ ہونے کی دلیل نہیں۔ ایک دوبارہ لکھا گیا AI مسودہ اب بھی ایک AI کی مدد سے تیار کردہ دستاویز ہے جس پر آپ کے ادارے کی انکشاف کی شرائط لاگو ہوتی ہیں۔ ہماری AI text humanizer AI کی مدد سے تیار کردہ مسودوں کو ایک قدرتی علمی انداز میں دوبارہ لکھتی ہے، اور چونکہ یہ عمل ٹوکن ترتیب کو نئے سرے سے بناتا ہے، اس لیے شماریاتی نشانات اس کے ذریعے برقرار نہیں رہتے۔ خاص طور پر Claude کے متن کے لیے، claude واٹرمارک ہٹانے والا ہر جملے کو تازہ الفاظ میں دوبارہ بیان کرتا ہے جبکہ حقائق، اعداد و شمار اور حوالہ جات وہی کے وہی رکھتا ہے۔ کوئی بھی ٹول اس بات کو نہیں بدل سکتا کہ آپ اپنے قاری پر کیا فرض کرتے ہیں: یہ شفافیت کہ دستاویز کیسے تیار کی گئی۔
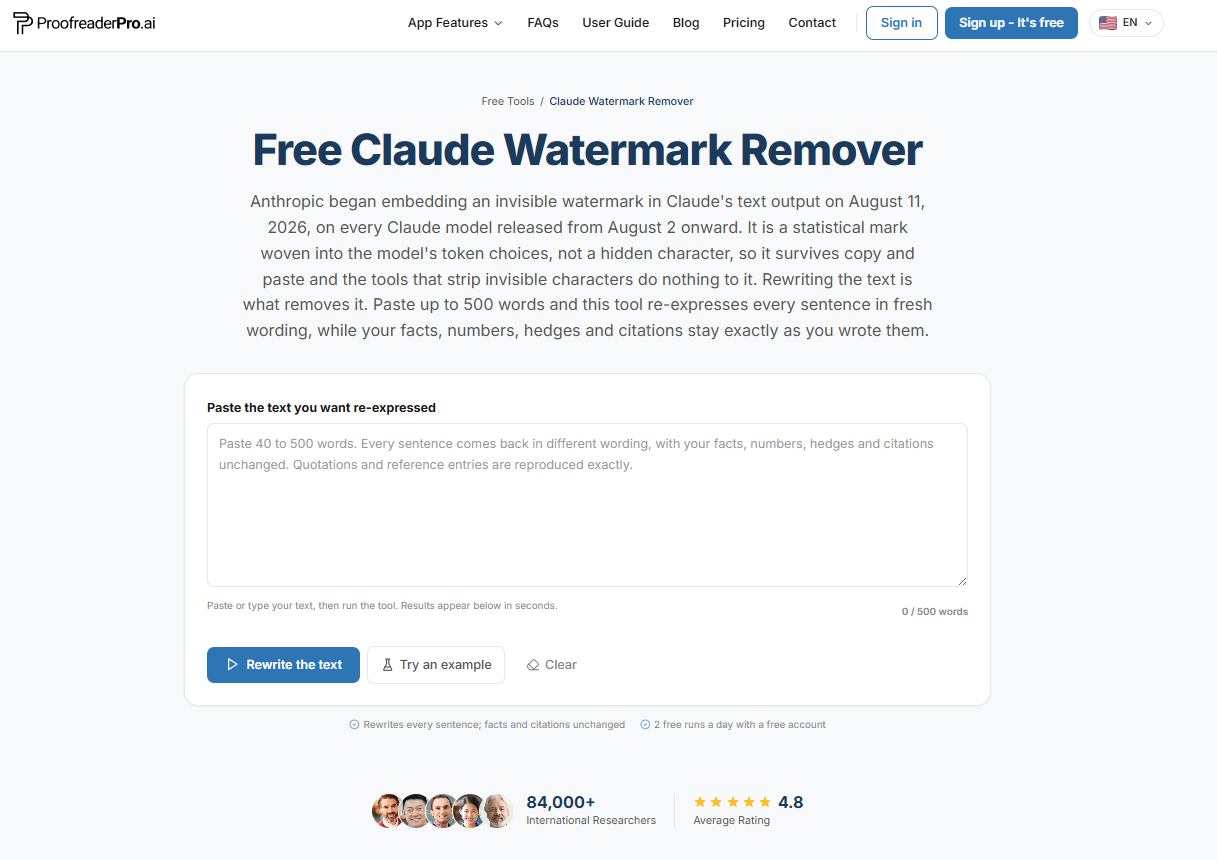
دوبارہ لکھنا وہ واحد کارروائی ہے جو شماریاتی نشان ہٹاتی ہے، اور یہی اس ٹول کا کام ہے، جملہ بہ جملہ۔
اگلا مرحلہ کہاں ہے
2027 تک تین چیزیں دیکھیں۔ پہلی یہ کہ OpenAI متنGrain کو EU سے آگے لے جاتا ہے یا نہیں۔ شروعات وہیں سے ہوئی تھی کیونکہ EU میں آرٹیکل 50 کی پابندی کیلئے AI متن پر مشین سے پڑھنے کے قابل نشانات ضروری ہیں۔ دوسری یہ کہ detectors کی کارکردگی آپس میں ہم آہنگ ہوتی ہے یا نہیں۔ اگر ہر بڑے لیب ایک شائع شدہ نظام کے ساتھ واٹرمارک کرے، تو یونیورسٹیاں تحریر کے انداز سے اندازہ لگانے کے بجائے keys چیک کر سکیں گی، جو آج کی 2026 میں AI ڈٹیکٹرز کتنے درست ہیں؟ آزمودہ درستگی اور غلط مثبت نتائج پر بہتری ہوگی۔ تیسری یہ کہ نشانات باہم مطابقت پذیر بنیں یا نہیں۔ آج تین لیبیں تین مختلف نشانات استعمال کرتی ہیں، اور کوئی ایک چیک انہیں سب کور نہیں کرتا۔ C2PA فائلوں کیلئے اس خلا کو پُر کرتا ہے؛ ابھی تک خام متن کیلئے کوئی ایسا حل موجود نہیں۔
کیا ChatGPT اپنے متن پر واٹرمارک لگاتا ہے؟
ہاں، جزوی طور پر، 5 اکتوبر 2026 سے۔ OpenAI نے EU میں اہل ChatGPT اور Codex متن پر اپنے textGrain واٹرمارک کو شامل کرنا شروع کیا، اور API کے صارفین دنیا میں کہیں سے بھی اسے آن کر سکتے ہیں۔ یہ واٹرمارک لفظوں کے انتخاب میں ایک شماریاتی سگنل ہے، اس میں کوئی پوشیدہ حروف نہیں۔ OpenAI DALL-E اور Sora میڈیا فائلوں پر C2PA پروونینس میٹاڈیٹا بھی لاگو کرتا ہے، جو ایک الگ، فائل سطحی نظام ہے۔
کیا Google Gemini اپنے متن پر واٹرمارک لگاتا ہے؟
ہاں۔ Gemini کی آؤٹ پٹ میں اکتوبر 2024 سے Google DeepMind کا SynthID-Text واٹرمارک شامل ہے۔ یہ لفظوں کے انتخاب میں ایک شماریاتی نشان ہے، قاری کو نظر نہیں آتا، اور Google کے SynthID Detector کے ذریعے جانچا جا سکتا ہے۔ یہ صرف Google کے اپنے ماڈلز پر لاگو ہوتا ہے، اس لیے SynthID کا منفی نتیجہ دوسرے AI سسٹمز کے متن کے بارے میں کچھ نہیں کہتا۔
کیا Claude اپنے متن پر واٹرمارک لگاتا ہے؟
ہاں۔ 2 اگست 2026 کو یا اس کے بعد لانچ ہونے والا ہر Claude ماڈل اپنی متن کی آؤٹ پٹ میں ایک شماریاتی واٹرمارک شامل کرتا ہے، ہر پلیٹ فارم اور ہر پلان پر، بغیر کسی آپٹ آؤٹ کے، اور Claude-generated فائلیں اس کے علاوہ C2PA میٹاڈیٹا بھی رکھتی ہیں۔ اس تاریخ سے پہلے لانچ ہونے والے ماڈلز ابھی تک اپنی آؤٹ پٹ کو نشان زد نہیں کرتے؛ Anthropic کے مطابق وہ منتقلی کے دورانیے میں ان کیلئے marking support شامل کر رہا ہے۔ مکمل تفصیلات ہمارے Claude watermark explainer میں ہیں۔
کیا یونیورسٹیاں AI واٹرمارکس کا پتہ لگا سکتی ہیں؟
صرف وینڈر کی تعاون سے، کیونکہ detection کیلئے وینڈر کی key درکار ہوتی ہے۔ Google SynthID مواد کیلئے ایک عوامی detector پورٹل فراہم کرتا ہے۔ Anthropic کا کہنا ہے کہ صارفین اور تیسرے فریق کیلئے detection کی سہولت منصوبہ بند ہے لیکن ابھی تک کوئی عوامی detector جاری نہیں کیا۔ اس وقت کسی بھی معروف plagiarism suite کے ذریعے کسی بھی لیب کے شماریاتی واٹرمارکس کی باضابطہ توثیق ممکن نہیں، اس لیے آج کی ادارہ جاتی "AI detection" بھی حقیقت میں انداز پر مبنی اندازہ لگانا ہے، واٹرمارک کی تصدیق نہیں۔
کیا AI واٹرمارکنگ قانون کے مطابق لازمی ہے؟
یورپی یونین میں ہاں، عملی طور پر بھی۔ EU AI Act کی شق 50(2) جنریٹو AI کے فراہم کنندگان سے تقاضا کرتی ہے کہ وہ آؤٹ پٹس کو مشین کے قابل پڑھنے والے انداز میں نشان زد کریں اور انہیں مصنوعی طور پر تیار کردہ ہونے کے طور پر پہچانا جا سکے، جبکہ شفافیت کی ذمہ داریاں 2 اگست 2026 سے لاگو ہوں گی۔ Anthropic نے متعلقہ Code of Practice پر دستخط کیے اور عالمی سطح پر تعمیل کا انتخاب کیا۔ سوال یہ ہے کہ 2027 میں ریگولیٹرز OpenAI کے غیر اجراء شدہ ٹیکسٹ واٹرمارک کے ساتھ کیا سلوک کرتے ہیں۔
کیا AI واٹرمارکس ترجمے کے بعد بھی زندہ رہتے ہیں؟
نہیں۔ ایک شماریاتی واٹرمارک اسی لفظی ترتیب میں موجود ہوتا ہے جو ماڈل منتخب کرتا ہے، اور ترجمہ ہر لفظ کو بدل دیتا ہے۔ یہی بات گہرے پیرای فریز اور بھاری انسانی ایڈٹنگ پر بھی لاگو ہوتی ہے۔ یہ حد peer-reviewed لٹریچر میں دستاویزی طور پر بیان کی گئی ہے اور ہر اس وینڈر کی طرف سے تسلیم کی جاتی ہے جو واٹرمارک پیش کرتا ہے۔
کیا متن کے لیے OpenAI کا کوئی پبلک واٹرمارک چیکر ہے؟
نہیں۔ OpenAI کا پبلک ویریفیکیشن ٹول صرف تصویری اور آڈیو فائلوں کی جانچ کرتا ہے، یعنی C2PA میٹاڈیٹا اور SynthID واٹرمارکس۔ OpenAI کا کہنا ہے کہ وہ ٹیکسٹ کو سپورٹ نہیں کرتا۔ اس کے ٹیکسٹ واٹرمارک ڈیٹیکٹر تک رسائی صرف منظور شدہ محققین اور ماہر تنظیموں کو کیس بہ کیس دی جاتی ہے۔
textGrain کیا ہے؟
textGrain OpenAI کا ٹیکسٹ واٹرمارک ہے، جو 5 اکتوبر 2026 کو اعلان کیا گیا۔ یہ ماڈل کی لفظوں کے انتخاب میں ایک پوشیدہ شماریاتی سگنل شامل کرتا ہے، اس لیے یہ نشان الفاظ کا حصہ ہوتا ہے، نہ کوئی چھپا ہوا حرف ہوتا ہے اور نہ فائل میٹاڈیٹا میں کچھ۔ OpenAI کا کہنا ہے کہ اس کے ٹیسٹ کیے گئے دیگر طریقوں سے اس کا نتیجہ برابر یا بہتر تھا، جن میں ٹیکسٹ کے لیے SynthID بھی شامل ہے، اور کہ ایڈٹنگ اسے کمزور کرتی ہے۔
کیا محققین OpenAI کے ٹیکسٹ واٹرمارک ڈیٹیکٹر تک رسائی کے لیے درخواست دے سکتے ہیں؟
ہاں۔ منظور شدہ محققین اور ماہر تنظیمیں OpenAI کے Content Provenance API فارم کے ذریعے درخواست دے سکتی ہیں۔ OpenAI EU Code of Practice کے تحت کیس بہ کیس رسائی دیتا ہے۔ اس کا کہنا ہے کہ جیسے جیسے ٹیکنالوجی اور شواہد آگے بڑھیں گے، وہ وسیع تر رسائی پر دوبارہ غور کرے گا۔
ماخذ
- Anthropic, Claude کے ٹیکسٹ واٹرمارک کا طریقہ, اگست 2026
- Anthropic Help Center, Claude AI سے تیار کردہ مواد پر کیسے نشان لگاتا ہے, 2026
- OpenAI, آن لائن ہم جو دیکھتے اور سنتے ہیں اس کے ماخذ کو سمجھنا, مئی 2024
- Google DeepMind, SynthID
- Dathathri et al., بڑے لینگویج ماڈلز کے آؤٹ پٹس کی شناخت کے لیے Scalable واٹرمارکنگ, Nature, اکتوبر 2024
- Google, SynthID Detector کے اعلان, مئی 2025
- Hugging Face, SynthID Text کا تعارف, اکتوبر 2024
- Kirchenbauer et al., بڑے لینگویج ماڈلز کے لیے ایک واٹرمارک, ICML 2023
- Krishna et al., Paraphrasing، AI سے تیار کردہ متن کے ڈیٹیکٹرز سے بچ نکلتی ہے, NeurIPS 2023
- Scott Aaronson, UT Effective Altruism کے لیے میری AI سیفٹی لیکچر, نومبر 2022
- یورپی یونین, AI Act، آرٹیکل 50
- C2PA، Coalition for Content Provenance and Authenticity
ڈانا ProofreaderPro میں مواد کی تخلیق کار ہے، جہاں وہ روزانہ بلاگ اور تحریری کارروائیاں چلاتی ہے۔ وہ آرٹیکل لکھتی ہیں کہ آن لائن ایڈیٹنگ پلیٹ فارم کیسے کام کرتا ہے، اور وہ ہر روز کسٹمر کے پیغامات کو ہینڈل کرتی ہے، اس کے لیے فائیو اسٹار اطمینان کے اسکور کے ساتھ۔