انگریزی میں لکھنے والے یوکرائنی محققین کے لیے AI Humanizer
یوکرائنی محققین کے لیے AI humanizer۔ یوکرائنی اور روسی سے متاثر انگریزی میں غلط AI-ڈٹیکشن فلیگز کی شرح کم کریں، معنی اور حوالہ جات برقرار رکھیں، اور ایمانداری سے استعمال ظاہر کریں۔
یوکرین ایسی صورتِ حال میں بھی سنجیدہ سائنس پیدا کر رہا ہے جس میں زیادہ تر تحقیقاتی نظام ٹھپ ہو جائیں۔ فزیکس دان، ریاضی دان، میٹریلز سائنس دان اور انجینئرز مسلسل اپنے مقالے جمع کراتے رہتے ہیں، اور قومی پالیسی بھی سب کو ایسے جرائد کی طرف دھکیلتی رہتی ہے جو Web of Science اور Scopus میں انڈیکسڈ ہوں۔ عملی طور پر اس کا مطلب ایک ہی بات ہے: آپ انگریزی میں لکھتے ہیں، چاہے انگریزی وہ زبان نہ ہو جس میں آپ سوچتے ہوں۔
بالکل اسی جال سے نمٹنے کے لیے یوکرائنی محققین کے لیے ایک AI humanizer موجود ہے۔ ایک محتاط محقق معیاری، صاف انگریزی میں اپنا ڈرافٹ تیار کرتا ہے، اسے AI checker سے گزار کر دیکھتا ہے کہ واپس آ کر اسے مشین سے لکھا ہوا قرار دے دیا گیا ہے۔ کوئی چیز جعلی نہیں کی گئی۔ مسئلہ صرف یہ ہے کہ نثر بہت زیادہ درست اور بے عیب تھی۔ یہ ٹول آپ کے معنی، اصطلاحات اور حوالہ جات کو برقرار رکھتے ہوئے ایسی غیر مادری تحریر کو وہی انداز دیتا ہے جیسے کسی شخص نے واقعی خود لکھا ہو۔ لائف سائنسز اور کلینیشنز بھی اسی دیوار سے ٹکراتے ہیں۔
زیادہ تر یوکرائنی محقق دو زبانوں میں لکھتے ہیں، یوکرائنی اور روسی کے درمیان مسلسل آگے پیچھے، اور دونوں زبانیں انگریزی نثر پر ایک جیسے ہی قسم کے اثرات (fingerprints) چھوڑتی ہیں۔ یہ fingerprints غلطیاں نہیں ہیں۔ یہ اس لکھنے والے کے نشانات ہیں جس نے انگریزی سلاوکی گرامر کے ذریعے سیکھی ہے، اور دلچسپ بات یہ ہے کہ آپ جتنی زیادہ انگریزی کو صاف کرتے ہیں، اتنا ہی امکان بڑھ جاتا ہے کہ کوئی detector اسے غلط پڑھ لے۔
Гуманізація AI-тексту для українських дослідників
ہماری AI متن کی humanization یوکرائنی سائنس دانوں کو اعتماد کے ساتھ انگریزی میں شائع ہونے میں مدد دیتی ہے، جبکہ معنی اور حوالہ جات محفوظ رہتے ہیں۔ Whether your first language is Ukrainian or Russian, the goal is the same: ایسی نثر جو آپ کی دلیل کو بالکل ویسا ہی رکھے جیسے آپ نے سوچا تھا، مگر اب ایسی نہیں رہے کہ وہ بنیادی طور پر native English پر تربیت یافتہ detector کو زیادہ دیر تک بے بس کر دے۔
ہم نے اپنا humanizer ایسے محققین کے لیے بنایا ہے جو حقیقی کام کرتے ہیں اور محض چاہتے ہیں کہ ان کی تحریر منصفانہ انداز سے پڑھی جائے۔ آپ سائنس ڈرافٹ کرتے ہیں۔ ٹول جملوں کے rhythm اور لفظوں کے انتخاب میں فرق لاتا ہے، ان cadence کو ہموار کرتا ہے جس میں مشینیں پھنس جاتی ہیں، اور آپ کو ایسی تحریر واپس دیتا ہے جو اب بھی بالکل وہی کہتی ہے جو آپ نے کہا تھا، بس ایسی آواز میں جو حقیقی انسان جیسی لگتی ہے۔
یوکرینی زبان میں لکھنا؟ یہ خودکار طور پر شناخت ہو جاتا ہے اور مقامی طور پر انسان نما بنا دیا جاتا ہے
بہت سے یوکرائنی محققین انگریزی میں لکھنے سے پہلے یوکرائنی میں ڈرافٹ تیار کرتے ہیں، اور یہ humanizer اسے براہِ راست سنبھالتا ہے۔ یوکرائنی متن پیسٹ کریں اور ProofreaderPro سیریلک اسکرپٹ کو پہچان کر اسے روسی سے الگ بتاتا ہے، پھر اسے زبان سے آگاہ ماڈل کے ذریعے پروسیس کرتا ہے جو آپ کی اصطلاحات اور حوالہ جات کو بالکل ویسا ہی رکھتا ہے جیسا آپ نے لکھے۔ Through гуманізація AI-тексту آپ کا یوکرائنی ڈرافٹ اتنی ہی آسانی سے humanize ہو جاتا ہے جتنی آپ کی انگریزی، پہلے کچھ ترجمہ کیے بغیر۔ اسی detection کا دائرہ ساٹھ سے زائد زبانوں تک پھیلا ہوا ہے، اور ہر زبان اپنی اپنی آواز میں دوبارہ لکھی جاتی ہے۔
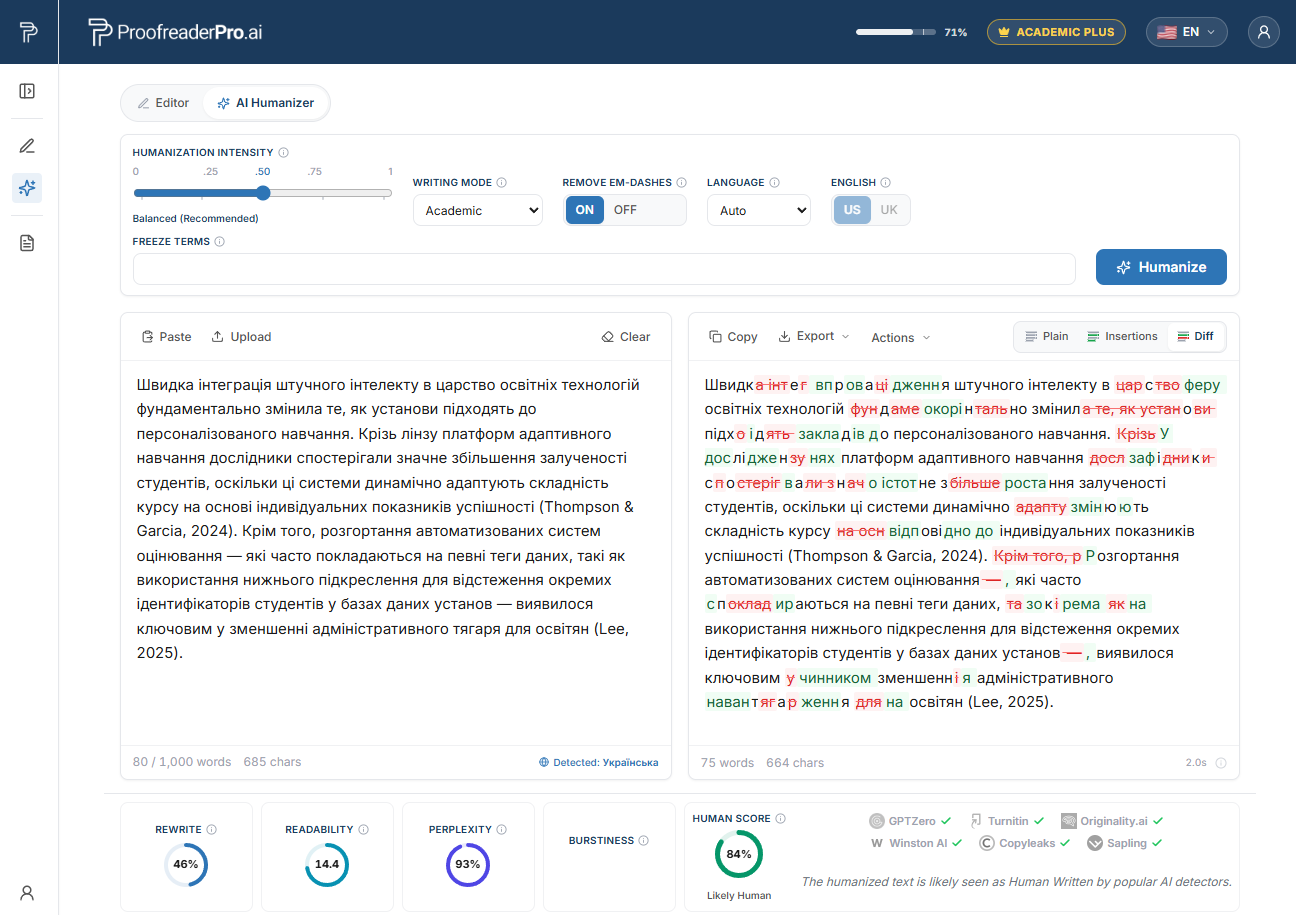
ProofreaderPro AI Humanizer کے ذریعے یوکرائنی علمی متن کو دوبارہ لکھا جا رہا ہے۔ before اور after diff آپ کے معنی اور حوالہ جات کو برقرار رکھتی ہے، اور detector checks اس بات کی تصدیق کرتی ہیں کہ پڑھنا فطری اور انسان جیسا ہے۔
یوکرینی محققین AI ڈیٹیکٹرز سے فلیگ کیوں ہوتے ہیں
سب سے واضح ثبوت ایک 2023 کی اسٹینفورڈ اسٹڈی سے ملتا ہے جسے Weixin Liang اور ان کے ساتھیوں نے lead کیا، اور جو Cell Press جرنل Patterns میں شائع ہوئی۔ ٹیم نے انسانی لکھی ہوئی TOEFL essays کو سات عام طور پر استعمال ہونے والے AI detectors سے گزارا۔ اوسطاً، غیر مادری (non-native) essays کا تقریباً 61% AI-generated ہونے کے طور پر flagged ہوا، جبکہ native English لکھنے والوں کے لیے یہ شرح تقریباً 5% تھی۔ ہر پانچویں کے قریب غیر مادری essays، یعنی تقریباً 19.8%، کو تمام detectors نے بیک وقت (unanimously) AI کے طور پر flagged کیا۔ ہر ایک essay ایک انسان نے لکھی تھی۔
یہ کیوں ہوتا ہے؟ بہت سے detectors کسی ایسی چیز کو اسکور کرتے ہیں جسے perplexity کہا جاتا ہے، یہ پیمائش کرتا ہے کہ لینگویج ماڈل کے لیے اگلا لفظ کتنا “چونکانے والا” (surprising) ہے۔ جب آپ دوسری زبان میں غور سے لکھتے ہیں تو آپ عام الفاظ اور محفوظ، متوقع اندازِ بیان کا سہارا لیتے ہیں۔ نتیجتاً perplexity کم ہوتی ہے، اور perplexity کم ہونا بالکل وہی چیز ہے جسے detector مشین سے لکھی ہوئی تحریر سمجھ کر پڑھتا ہے۔ وہ عادات جو یوکرائنی-انگریزی کو واضح اور درست بناتی ہیں، یہی عادات ہیں جنہیں یہ نظام تربیت کے دوران شک کی نظر سے دیکھنا سیکھ چکے ہیں۔
لہٰذا یہ فلیگ آپ کی ایمانداری پر کوئی فیصلہ نہیں ہے۔ یہ اس بات کا شماریاتی نتیجہ ہے کہ ٹول کیسے کام کرتا ہے، اور ہم اس میکانزم کو مزید تفصیل سے why AI detectors flag non-native writing میں سمجھاتے ہیں۔ جب آپ یہ جان لیتے ہیں تو سرخ اسکور کو دیکھنے کا انداز بدل جاتا ہے: اسے کسی اقرار کے طور پر نہیں، بلکہ ایک دعوے (claim) کے طور پر سمجھیں جسے آپ شواہد کے ذریعے چیلنج کر سکتے ہیں۔
جھوٹے اشاروں کے پیچھے یوکرینی اور روسی پہلی زبان کے طرز عمل
سلاوکی گرامر انگریزی سے چند بنیادی ساختی (structural) پہلوؤں میں مختلف ہے، اور ان میں سے ہر ایک آپ کی انگریزی کو اُس flat، predictable register کی طرف دھکیلتی ہے جسے detectors سزا دیتے ہیں۔ ان میں سے کوئی بھی غلطی نہیں ہے۔ یہ محتاط اور درست constructions ہیں، اور اسی کی وجہ سے ان کی “معیاری پن” مسئلہ بن جاتی ہے۔
No articles. نہ یوکرائنی میں اور نہ روسی میں "the" یا "a" ہوتا ہے، اس لیے انگریزی کے articles غائب، اضافہ کیے جاتے ہیں یا دوبارہ assign کیے جاتے ہیں ("result was significant", "we studied the influence of the temperature"). جب ایڈیٹر انہیں درست کر دیتا ہے تو وہ جملے ہموار اور عام (generic) لگنے لگتے ہیں، جس کے نتیجے میں perplexity کم نظر آتی ہے۔
Aspect instead of tense. سلاوکی گرامر انگریزی کے tense نظام کے بجائے perfective اور imperfective aspect پر قائم ہے، اس لیے perfect اور simple past کے درمیان انتخاب غیر مستقل نکل آتا ہے۔ اسے درست کرنے سے عموماً ایسے مختصر جملے بنتے ہیں جو بالکل متنِ درسی (textbook-plain) انداز میں ہوتے ہیں۔
Flexible word order. کیس کے اختتام (case endings) یوکرائنی اور روسی میں معنی رکھتے ہیں، جس کی وجہ سے word order آزادانہ طور پر move کر سکتا ہے۔ جب یہ نمونہ انگریزی میں منتقل ہوتا ہے تو information structure تھوڑا غیر معمولی انداز میں بیٹھتی ہے، اور سب سے محفوظ درستگی وہی ہوتی ہے جو سب سے زیادہ conventional بھی ہے، اور وہی سب سے زیادہ مشین جیسی بھی لگتی ہے۔
Countable and uncountable nouns. "informations", "researches", "an equipment", اور "evidences" جیسی صورتیں ماخذ زبانوں سے قدرتی طور پر آتی ہیں۔ درست کرنے کے بعد یہ معیاری mass-noun phrasing میں سمٹ جاتی ہیں، وہی phrasing جو لاکھوں تربیتی مثالوں (training examples) میں دکھتی ہے۔
Preposition transfer and the missing auxiliary. زبانوں کے درمیان prepositions کا نقشہ مختلف ہوتا ہے، اور انگریزی کے auxiliary "do/does" کا کوئی براہِ راست ہم معنی نہیں، اس لیے editing کے دوران دونوں چیزیں standardize ہو جاتی ہیں، اور پھر وہی سادہ ترین شکل اختیار کرتی ہیں۔
Transliteration. سیریلک سے منتقل ہونے والے نام اور تکنیکی اصطلاحات (technical terms) اپنے روایتی انگریزی ہجے میں باقاعدہ ہو جاتے ہیں، یہ بھی یکسانیت کی طرف ایک چھوٹا قدم ہے۔ یہ سب ملا کر نتیجہ یہ نکلتا ہے: ایک صاف، درست اور کم-variance نثر، بالکل وہ پروفائل جسے کوئی detector مصنوعی سمجھ کر اسکور کرتا ہے۔
اپنی یوکرینی تحقیق کو منصفانہ انگلش میں شائع کریں
اپنے AI سے معاون کردہ مسودے کو انسان جیسے انداز میں بنائیں، اپنا مفہوم اور حوالہ جات برقرار رکھیں، پھر اعتماد کے ساتھ اپنی AI کا استعمال ظاہر کریں
Humanizer فری آزمائیںیوکرین میں AI ڈیٹیکشن اور Turnitin کا منظرنامہ
یوکرائنی اعلیٰ تعلیم میں similarity screening معمول کی بات ہے، اور اب اس کے اوپر AI screening بھی آ رہی ہے۔ بہت سی جامعات Unicheck چلاتی ہیں، جو حقیقت میں یوکرین میں بنایا گیا تھا اور اب Turnitin کا حصہ ہے، جبکہ کچھ StrikePlagiarism استعمال کرتی ہیں۔ اگر آپ thesis یا manuscript جمع کراتے ہیں تو یہ مان کر چلیں کہ یہ کسی نہ کسی ایسے سسٹم سے ضرور گزرے گا، اس سے پہلے کہ انسان اسے قریب سے پڑھنا شروع کرے۔
تعلیمی وزارت (MES) اور مختلف اداروں نے academic-integrity اور AI کے بارے میں رہنمائی جاری کی ہے، اور مجموعی سمت پابندی کے بجائے disclosure کی طرف ہے۔ مالی معاون ادارے اور جرائد اب بڑھتے ہوئے انداز میں آپ سے پوچھتے ہیں کہ paper تیار کرنے میں آپ نے کب اور کیسے AI استعمال کیا۔
یہ ماحول قابلِ انتظام ہے اگر آپ اسے ایمانداری سے اپروچ کریں۔ humanizing کا مقصد کبھی بھی AI استعمال کو چھپانا یا Unicheck کو دھوکا دینا نہیں۔ مقصد یہ ہے کہ ٹولنگ میں موجود عدمِ توازن (fairness gap) حقیقی کام کو سزا نہ دینے لگے، اور پھر آپ اپنے AI استعمال کو بالکل اسی طرح ظاہر کریں جیسا آپ کی یونیورسٹی اور ہدف جرنل تقاضا کرتے ہیں۔
یوکرین کی سرفہرست جامعات اور AI جانچ کہاں ہوتی ہے
نیچے دیے گئے ادارے theses اور manuscripts کو similarity کے لیے اسکرین کرتے ہیں اور اب بڑھتے ہوئے طور پر AI indicators کو بھی وزن دیتے ہیں۔ اگر آپ ان میں سے کسی میں کام کرتے ہیں یا پڑھتے ہیں تو similarity اور AI check دفاعی thesis یا جمع شدہ paper تک پہنچنے کے عام راستے کا حصہ ہوتا ہے۔
- کیٔیف کا قومی یونیورسٹی تارس شوچینکو (Taras Shevchenko National University of Kyiv)، Kyiv
- یوکرین کی قومی تکنیکی یونیورسٹی «کیٔیف پولی ٹیکنک انسٹی ٹیوٹ اِہوری سِکورسکی» (Igor Sikorsky Kyiv Polytechnic Institute, KPI)، Kyiv
- V. N. کارازین خارکیف قومی یونیورسٹی (V. N. Karazin Kharkiv National University)، Kharkiv
- ایوان فرینکو کیٔیف کی قومی یونیورسٹی (Ivan Franko National University of Lviv)، Lviv
- قومی یونیورسٹی «لویوِسک پولی ٹیکنک» (Lviv Polytechnic National University)، Lviv
- سُمی اسٹیٹ یونیورسٹی (Sumy State University)، Sumy
- قومی یونیورسٹی «کیٔیف-موہائلا اکیڈمی» (National University of Kyiv-Mohyla Academy)، Kyiv
- اولِیس ہونچار دنیپرو قومی یونیورسٹی (Oles Honchar Dnipro National University)، Dnipro
ان تمام جامعات میں workflow کچھ ایسا ہی ہوتا ہے: آپ کا ڈرافٹ کمیٹی کے سامنے جانے سے پہلے ایک automated check سے گزرتا ہے۔ یہ سمجھنا کہ یہ check واقعی کیا ناپتی ہے، آپ کو panic کرنے کے بجائے پرسکون انداز سے کسی فلیگ کا جواب دینے کے قابل بناتا ہے۔
یوکرینی محققین کے لیے AI ہیومنائزر کیسے کام کرتا ہے
ایمان دارانہ workflow کے چار مراحل ہیں، اور disclosure اسی کا حصہ ہے، یہ بعد میں سوچا جانے والا نکتہ نہیں۔
سب سے پہلے، اپنی سائنس ڈرافٹ کریں۔ بہت سے یوکرائنی محققین پہلے دلیل کو یوکرائنی یا روسی میں سمجھتے ہیں، پھر اسے translate کرتے ہیں، اور یہ بالکل درست بات ہے۔ پڑھنے کے طریقے (read) کی فکر کرنے سے پہلے reasoning درست کر لیں۔
دوسرا، grammar کو proofread کریں تاکہ انگریزی صحیح ہو اور آپ کی اصطلاحات (terminology) ہم آہنگ (consistent) رہیں۔ صاف grammar اور قدرتی آواز (natural voice) دو الگ چیزیں ہیں، اور آپ دونوں چاہتے ہیں۔
تیسرا، اپنی AI-assisted نثر کو text humanizer کے ذریعے خود چلائیں۔ یہ جملوں کے rhythm اور لفظوں کے انتخاب میں فرق پیدا کرتا ہے، وہ repetitive cadence ختم کرتا ہے جو مشینیں اور heavily-edited دوسری زبان کی تحریر ایک جیسی شیئر کرتی ہیں، اور ایسے ہی em dashes بھی ہٹا دیتا ہے—اور یہ سب کچھ کرتے ہوئے آپ کے معنی، آپ کی تکنیکی vocabulary، اور ہر citation کو محفوظ رکھتا ہے۔ چونکہ ہمارا humanizer 60 سے زائد زبانوں کو سپورٹ کرتا ہے، اس لیے non-English متن ایک زبان سے آگاہ ماڈل کے ذریعے راستہ پاتا ہے جو جملے کی ساخت (sentence structure) اور معنی کو intact رکھتا ہے، انہیں بگاڑنے کے بجائے۔
نتیجے سے کیا توقع کی جا سکتی ہے؟ اپنی جانچ میں ہم نے دیکھا کہ humanizing اس بات کی شرح نمایاں طور پر کم کر دیتی ہے کہ محتاط، معیاری non-native English کو بڑے detectors غلط پڑھتے ہیں، جن میں Turnitin، Originality.ai اور GPTZero بھی شامل ہیں، اور آپ کے تعلیمی معنی وہیں کے وہیں رہتے ہیں۔ ہم اسے وہی کہتے ہیں جو ہمیں testing میں نظر آیا، کسی وعدے کی طرح نہیں۔ detectors ہر چند ماہ بعد دوبارہ تربیت لیتے ہیں، اور کوئی بھی ایماندار ٹول دعویٰ نہیں کر سکتا کہ وہ 100% undetectable ہے۔ جو کوئی اس کے برعکس ضمانت دیتا ہے، وہ آپ کو ایسی certainty بیچ رہا ہوتا ہے جو موجود نہیں۔
چوتھا، disclosure کریں۔ اپنی institution اور جرنل کے مطلوبہ فارمیٹ میں AI-use statement شامل کریں، تاکہ آپ کا کام clearly integrity rules کے اندر رہے۔ یہی اصل نکتہ ہے: آپ biased ٹول سے حقیقی تحقیق کو بچا رہے ہیں، کسی چیز کو چھپا نہیں رہے۔ یوکرین ہماری multilingual AI humanizer hub پر ایک stop ہے، اور اگر آپ کے paper کو مکمل لینگویج editing بھی درکار ہے تو ہماری global academic editing hub اس عمل کے اسی حصے کو واضح کرتی ہے۔
مقامی فنڈنگ ادارے، جرائد اور AI افشا کی توقعات
یوکرائنی تحقیق چند مرکزی اداروں کے ذریعے فنڈ اور منظم کی جاتی ہے۔ National Research Foundation of Ukraine (NRFU, Національний фонд досліджень України) مسابقتی گرانٹس چلاتی ہے۔ National Academy of Sciences of Ukraine (NAS, НАН України) قومی اداروں (national institutes) کی نگرانی کرتی ہے۔ Ministry of Education and Science (MES) تحقیق اور اشاعت کی پالیسی طے کرتی ہے، جس میں انڈیکسڈ آؤٹ پٹ کی طرف دھکا بھی شامل ہے۔
یہ دھکا حقیقی (concrete) ہے۔ قومی پالیسی Web of Science اور Scopus میں انڈیکسڈ جرائد میں اشاعت کو انعام دیتی ہے، جس کی وجہ سے انگریزی میں لکھنے کا دباؤ سال بہ سال برقرار رہتا ہے۔ جب آپ ان جرائد کو ہدف بناتے ہیں تو similarity screening کو بطور معمول (matter of course) سمجھیں، اور جمع کروانے کے وقت ان میں سے بڑھتی ہوئی تعداد کی جانب سے AI-use disclosure مانگنے کی توقع کریں۔
اس توقع کو براہِ راست پورا کریں۔ آپ نے کیا استعمال کیا واضح لکھیں، ریکارڈ صاف رکھیں، اور humanized ڈرافٹ کو اپنی دلیل کو قدرتی آواز میں آگے لے جانے دیں۔ اگر کبھی آپ کو کوئی فلیگ ملے جسے آپ غلط سمجھتے ہوں تو اسے ایسا دعویٰ سمجھیں جس کا جواب آپ شواہد سے دے سکتے ہیں، اور اگلی جمع آوری سے پہلے، rejection کے بعد نہیں، دوبارہ text humanizer کی طرف رجوع کریں۔
اکثر پوچھے جانے والے سوالات
سوال: کیا یوکرینی محققین کے لیے AI ہیومنائزر کا استعمال نقل سمجھا جاتا ہے؟
نہیں، جب آپ اسے ایمانداری سے استعمال کرتے ہیں۔ آپ اپنے ہی AI-assisted ڈرافٹ کو “humanize” کر رہے ہیں تاکہ محتاط non-native تحریر ایک biased detector سے محفوظ رہ سکے، نہ کہ نتائج کو گھڑ کر یا authorship چھپا کر۔ آپ اپنے معنی اور حوالہ جات برقرار رکھتے ہیں، اور پھر اپنی یونیورسٹی اور جرنل کی مانگ کے مطابق اپنے AI استعمال کو disclose کرتے ہیں۔
سوال: کیا ہیومنائزر میری تکنیکی اصطلاحات یا حوالوں کو بدل دے گا؟
نہیں۔ یہ ٹول آپ نے جس طرح لکھا ہے، اسی طرح academic meaning، technical terminology، اور ہر حوالہ/ریفرنس (every reference) کو محفوظ رکھنے کے لیے بنایا گیا ہے۔ یہ آپ کے مواد کے گرد rhythm اور لفظوں کے انتخاب میں فرق کرتا ہے، اس لیے آپ کے طریقۂ کار (methods)، آپ کی اصطلاحات، اور آپ کے citation نمبرز اپنی جگہ برقرار رہتے ہیں۔
سوال: کیا гуманізація AI-тексту کا عمل روسی بولنے والے یوکرینی محققین کے لیے بھی کام کرتا ہے؟
جی ہاں۔ یوکرائنی اور روسی میں کئی گرامر خصوصیات مشترک ہیں جو انگریزی نثر پر ایک جیسے fingerprints چھوڑتی ہیں، مثلاً articles کا نہ ہونا اور aspect-based verbs۔ humanizer non-English اور non-native متن کو ایک زبان سے آگاہ ماڈل کے ذریعے راستہ دیتا ہے، اس لیے یہ اس بات سے قطع نظر مدد کرتا ہے کہ آپ کی مضبوط زبان دونوں میں سے کون سی ہے۔
سوال: کیا کوئی ٹول ضمانت دے سکتا ہے کہ میرا مقالہ AI ڈیٹیکٹر سے پاس ہو جائے گا؟
نہیں، اور آپ کو ایسے کسی بھی دعوے کرنے والے پر اعتماد نہیں کرنا چاہیے جو ضمانت دیتا ہو۔ detectors مسلسل دوبارہ تربیت لیتے رہتے ہیں، اور کوئی بھی ایماندار ٹول یہ وعدہ نہیں کر سکتا کہ وہ 100% undetectable ہو گا۔ ہم جو بات کہہ سکتے ہیں وہ یہ ہے کہ، اپنی testing میں، humanizing نمایاں طور پر اس شرح کو کم کر دیتی ہے کہ محتاط non-native English کو غلط پڑھا جائے، یہ ایک مختلف اور زیادہ ایماندار دعویٰ ہے، کسی ضمانت کے بجائے۔
سوال: اگر میری یونیورسٹی میں Unicheck یا Turnitin میرے تھیسس کو فلیگ کر دے تو کیا کرنا چاہیے؟
اس اسکور کو “فیصلہ” نہیں بلکہ “ایک دعویٰ جسے چیلنج کیا جا سکتا ہے” سمجھیں۔ اپنے ڈرافٹس اور نوٹس کو اپنے process کے شواہد کے طور پر محفوظ رکھیں، اپنی تحریر کو خود humanize کریں تاکہ وہ فطری لگے، اور اپنی institution کی پالیسی کے مطابق اپنے AI استعمال کو disclose کریں۔ detector کا فلیگ بات چیت کے آغاز کی علامت ہے، اختتام کی نہیں۔
ایک زبان سے آگاہ ہیومنائزر جو آپ کے مفہوم، اصطلاحات اور حوالہ جات کو برقرار رکھتا ہے، اور محتاط غیر مقامی نثر کو انسان جیسا پڑھنے میں مدد دیتا ہے
Moe قدرتی زبان کی پروسیسنگ میں PhD کے ساتھ ایک NLP انجینئر ہے۔ اس کی تحقیق میں کمپیوٹیشنل لسانیات، متن کا تجزیہ، اور مشین لرننگ شامل ہے، اور اس نے ProofreaderPro کے پیچھے ایڈیٹنگ اور ہیومنائزیشن ماڈلز کو براہ راست شامل کیا۔ وہ اس عمل کے اس حصے کے بارے میں لکھتا ہے جسے زیادہ تر لوگ کبھی نہیں دیکھتے: زبان کا ماڈل کس طرح ایک جملہ پڑھتا ہے، اسکور کرتا ہے، اور فیصلہ کرتا ہے کہ کیا تبدیل کرنا ہے۔