انگریزی میں لکھنے والے ہنگریائی محققین کے لیے AI ہیومنائزر
ہنگریائی محققین کے لیے AI ہیومنائزر۔ ہنگری سے متاثر انگریزی میں غلط AI-ڈیٹیکشن کے جھوٹے الارم کم کریں، معنی اور حوالہ جات برقرار رکھیں، اور دیانت داری سے واضح کریں۔
ہنگری کی سائنس نے ہمیشہ اپنے وسائل سے زیادہ کارکردگی دکھائی ہے۔ دس ملین سے کم آبادی والا یہ ملک ریاضی دانوں، ماہرینِ طبیعیات، کیمیا دانوں اور حیات سائنس دانوں کی ایک شاندار صف تیار کر چکا ہے، اور یہ روایت آج بھی اس کے جامعات کے آؤٹ پٹ میں نظر آتی ہے۔ کام انگریزی میں لکھا جاتا ہے، البتہ۔ بخارسٹ یا سیگِدے کے تقریباً ہر محقق پہلے ہنگری زبان میں ڈرافٹ بناتا ہے اور سوچتا ہے، پھر دلیل کو دوسری ایسی زبان میں منتقل کرتا ہے جس کی گرامر تقریباً اس سے بالکل مختلف ہے۔ یہی ترجماتی خلا وہ جگہ ہے جہاں ہنگریائی محققین کے لیے AI ہیومنائزر اپنی جگہ بناتا ہے، کیونکہ اب احتیاط سے لکھی گئی ہنگری-انگریزی کو مشین ٹیکسٹ سمجھ کر غلط پڑھا جا رہا ہے۔
یہاں ایک غیر آرام دہ حقیقت ہے۔ آپ کی انگریزی جتنی صاف اور معیاری ہوگی، اتنا ہی زیادہ امکان ہے کہ کوئی AI ڈٹیکٹر اسے نشان زد کرے۔ ایسا ماڈل جو متن کو ہر لفظ کی “surprising” ہونے کی بنیاد پر اسکور کرتا ہے، آپ کی باقاعدہ، متوقع (predictable) زبان کو مشین مصنف ہونے کا اشارہ سمجھ بیٹھتا ہے۔ مشکل دوسری زبان میں واضح طور پر لکھنے کا فائدہ یہیں الٹا پڑتا ہے، ایک غلط الزام۔
ہم نے اپنا ہیومنائزر اسی مخصوص مسئلے کے لیے بنایا ہے: حقیقی محققین کا حقیقی کام چھپانے کے لیے نہیں، کسی کی شارٹ کٹس کو چھپانے کے لیے بھی نہیں۔ یہ گائیڈ بتاتی ہے کہ ہنگری کے اسکالرز کے لیے اسے ایک دیانت دار اشاعتی ورک فلو میں کیسے فِٹ کیا جاتا ہے۔
AI-szöveg humanizálása magyar kutatóknak
AI-szöveg humanizálása کا مطلب یہ ہے کہ اپنی، مصنوعی ذہانت سے مدد یافتہ تحریر کو ایسے زیادہ انسانی لہجے/لَے میں ڈھالا جائے کہ اس کی تال (rhythm) انسانوں جیسی ہو جائے، جبکہ معنی، ساہتی اصطلاحات (szakkifejezések) اور حوالہ جات بدلے بغیر برقرار رہیں۔ Our tool is built for Hungarian academics who draft in their own language and then publish in English.
مقصد کسی چیز کو چھپانا نہیں ہے۔ مقصد یہ ہے کہ ہنگری کے کسی اسکالر کی لکھی ہوئی ایک محتاط، معیاری انگریزی جملہ محض اس لیے مشکوک نہ ٹھہرایا جائے کہ وہ محتاط اور معیاری ہے۔ یہی وہ “false flag” ہے جسے کم کرنے کے لیے ہماری text humanizer ڈیزائن کی گئی ہے۔
ہنگیرین میں مسودہ تیار کر رہے ہیں؟ ہیومنائزر اسے براہ راست شناخت کر کے دوبارہ لکھ دیتا ہے
آپ ہنگریائی ڈرافٹ کو پہلے انگریزی میں ترجمہ کیے بغیر ہی ہیومنائزر کر سکتے ہیں۔ اپنا متن پیسٹ کریں اور ProofreaderPro زبان کو خودکار طور پر شناخت کر لیتا ہے، پھر اسے ایسے ہنگری-آگاہ ماڈل سے گزار دیتا ہے جو آپ کی تحریر میں طویل سروں (long vowels)، جوڑ دار/الحاقی صورتوں (agglutinated forms) اور حوالہ جات کا احترام کرتا ہے۔ زبان کے اندر [AI-szöveg humanizálása] کے ذریعے یہ آپ کے ہنگریائی نثر کی تال (rhythm) میں تبدیلی لاتا ہے جبکہ ہر اصطلاح اور حوالہ بدستور برقرار رہتا ہے۔ خودکار شناخت ساٹھ سے زیادہ زبانوں میں کام کر سکتی ہے، اس لیے ہنگری کو ہنگری ہی کے طور پر ٹریٹ کیا جاتا ہے، نہ کہ انگریزی میں ڈھال کر۔
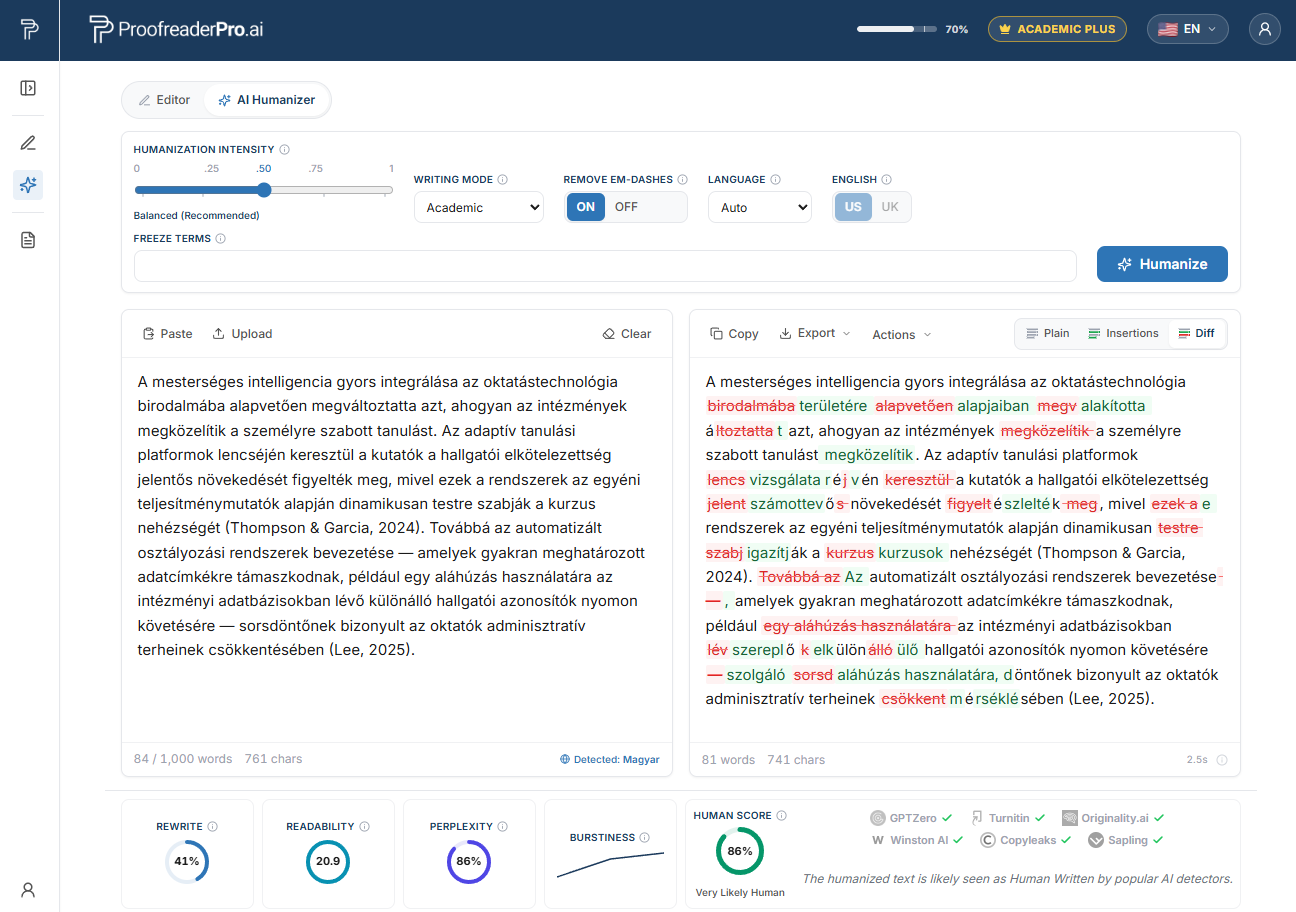
ہنگریائی علمی متن کو دوبارہ لکھتے ہوئے ProofreaderPro AI Humanizer۔ “before and after” کا فرق آپ کے معنی اور حوالہ جات برقرار رکھتا ہے، اور ڈٹیکٹر چیک تصدیق کرتے ہیں کہ پڑھنا فطری اور انسانی ہے۔
ہنگیرین محققین AI ڈیٹیکٹرز سے فلیگ کیوں ہوتے ہیں
2023 میں، وِیکسِن لیانگ (Weixin Liang) کی قیادت میں ایک اسٹینفورڈ ریسرچ گروپ نے انسانی لکھے گئے مضامین پر سات بڑے پیمانے پر استعمال ہونے والے GPT ڈٹیکٹرز آزمائے۔ یہ مضامین TOEFL امتحان سے آئے تھے، لہٰذا ان میں سے ہر ایک کا انسانی مصنف موجود تھا جو ایک غیر اصیل (non-native) انگریزی لکھنے والا تھا۔ اوسطاً تقریباً 61% مضامین کو AI-generated ہونے کے طور پر نشان زد کیا گیا۔ اصیل انگریزی لکھنے والوں کے مضامین میں یہ شرح تقریباً 5% تھی۔ غیر اصیل مضامین میں سے تقریباً ہر پانچویں میں، یعنی تقریباً 19.8%، ہر ایک واحد ڈٹیکٹر نے بیک وقت (unanimously) انہیں نشان زد کیا۔
اس کو ایک بار پھر پڑھیں۔ انسانی تحریر کو اتنی زیادہ، دس گنا سے بھی زیادہ، مرتبہ AI سمجھ کر نشان زد کیا گیا، محض اس وجہ سے کہ انگریزی مصنف کی دوسری زبان تھی۔
اس عمل (mechanism) کو perplexity کہا جاتا ہے۔ بہت سے ڈٹیکٹر یہ اندازہ لگاتے ہیں کہ آپ کے لفظ منتخب کرنے کا انداز کسی لینگویج ماڈل کے لیے کتنا “predictable” ہے۔ جب آپ دوسری زبان میں لکھتے ہیں تو آپ وہی محفوظ، عام اور درست تعمیر (construction) اختیار کرتے ہیں، کیونکہ محتاط لکھنے والے یہی کرتے ہیں۔ محفوظ اور عام ہونے کا مطلب کم perplexity ہے، اور کم perplexity بالکل وہی “fingerprint” ہے جسے یہ ٹولز مشین ٹیکسٹ کے طور پر پڑھنے کے لیے تربیت دیے گئے تھے۔ ہم اس پورے میکانزم کو why AI detectors flag non-native writers میں کھول کر بیان کرتے ہیں، مگر مختصر مگر سخت بات یہ ہے: آپ کی وہ عادتیں جو آپ کی نثر کو واضح بناتی ہیں، وہی عادتیں اسے نشان زد کرنے کا باعث بھی بنتی ہیں۔
غلط فلیگ کے پیچھے ہنگیرین مادری زبان کے پیٹرن
ہنگری ایک یورالک (Uralic) زبان ہے، جو اس کے آس پاس موجود انڈو-یورپی زبانوں سے غیر متعلق ہے، اور اس کی منطق واقعی طور پر انگریزی سے مختلف ہے۔ یہی فرق ہنگری-انگریزی تحریر میں “fingerprints” چھوڑ دیتا ہے۔ ان میں سے کوئی بھی غلطیِ ذہانت نہیں ہے۔ یہ ایک بالکل مختلف گرامر کا سایہ (shadow) ہے، اور جب اسے صاف، معیاری انگریزی میں “smooth” کر دیا جاتا ہے تو یہ ڈٹیکٹر کو بے جان اور متوقع (flat and predictable) پڑھائی دیتی ہے۔
ایک ضمیر برائے he اور she۔ ہنگری کے پاس تیسرے شخص کے لیے ایک ہی صنفی (gender) ضمیر ہے اور گرامر میں gender نہیں ہوتا، اس لیے انگریزی میں “he” اور “she” آپس میں بدل جاتے ہیں۔ لکھنے والے جو اس کی تصحیح کرتے ہیں وہ اکثر سب سے محفوظ آپشن کا زیادہ استعمال کر دیتے ہیں یا جملوں کو “the author” اور “the participant” کے گرد دوبارہ بنانے لگتے ہیں، جس سے بہت یکساں (even)، کم-تغیر (low-variation) نثر پیدا ہوتی ہے۔
Articles مختلف منطق کے ساتھ تقسیم ہوتے ہیں۔ ہنگری واقعی میں بھی articles استعمال کرتا ہے (a, az, egy)، مگر انہیں انگریزی کے مقابلے میں مختلف منطق کے ساتھ رکھتا ہے۔ definite اور indefinite articles کبھی چھوڑ دیے جاتے ہیں یا بڑھا دیے جاتے ہیں، اور محتاط (careful) درستگی عموماً ہر بار سب سے معیاری، درسی کتاب (textbook) والا article بن جاتی ہے۔ “Standard” ہی وہ چیز ہے جو مشین جیسا اسکور دیتی ہے۔
Agglutination اور بھاری nominalisation۔ ہنگری معنی کو ایک stem پر suffixes لگا کر ترتیب دیتا ہے۔ جب یہی عادت انگریزی میں منتقل ہوتی ہے تو یہ گھنے noun phrases اور طویل nominalised chains ("the implementation of the optimisation of...") کی شکل اختیار کر لیتی ہے، جو گرامر کے لحاظ سے بالکل درست اور تال کے لحاظ سے یکساں (monotonous) ہوتی ہے۔ ڈٹیکٹرز یکسانیت (monotony) کو پسند نہیں کرتے، انہیں وہ خاص طور پر آسانی سے پکڑ لیتے ہیں۔
Topic-prominent word order۔ ہنگری کسی جملے کے topic اور focus کو سامنے لاتا ہے، اس لیے زور (emphasis) اس جگہ نہیں گرتا جہاں ایک انگریزی قاری توقع کرے۔ جب لکھنے والا اسے plain subject-verb-object انگریزی میں معمول (normalise) کرتا ہے تو نتیجہ درست، منظم (orderly) اور متوقع بن جاتا ہے۔
مستقبل کے لیے marker کا فقدان اور aspect کا مختلف نظام۔ ہنگری مستقبل کو مختلف انداز میں نشان زد کرتا ہے اور aspect کو اپنے طریقے سے سنبھالتا ہے، اس لیے انگریزی میں tense کے انتخاب غیر مستقل (inconsistent) نکلتے ہیں، پھر انہیں زیادہ غیر جانبدار، عام (neutral, common) tense کی طرف درست کر دیا جاتا ہے۔ سب سے محفوظ tense پھر وہی بنتا ہے جس کی perplexity سب سے کم ہو۔
Prepositions کے بجائے postpositions۔ ہنگری اپنے relational markers کو اسم (noun) کے بعد رکھتا ہے، جس سے انگریزی میں preposition slips پیدا ہوتے ہیں۔ انہیں درست کرنے کے لیے ہر بار معیاری preposition کی طرف لوٹنا پڑتا ہے، اور “standard” ہی وہ چیز ہے جسے ڈٹیکٹر generated سمجھتے ہیں۔
اپنی محتاط ہنگیرین-انگلش کو غلط فلیگز سے محفوظ رکھیں
اپنے AI سے معاون کردہ مسودے کو انسان جیسے انداز میں بنائیں، ہر حوالہ، اصطلاح، اور نتیجہ مکمل طور پر برقرار رکھیں، پھر اعتماد کے ساتھ اپنے ٹولز ظاہر کریں
Humanizer فری آزمائیںہنگری میں AI ڈیٹیکشن اور Turnitin کا منظرنامہ
ہنگریائی اداروں سے آنے والی theses اور جرنل سبمِشنز کو متن کی مماثلت (text similarity) کے لیے معمول کے مطابق اسکرین کیا جاتا ہے، اکثر Turnitin یا اس نوعیت کے کسی دوسرے نظام کے ذریعے، اور AI indicators اب تیزی سے اسی اسکریننگ میں ضم کیے جا رہے ہیں۔ یہ اب ڈاکٹریٹ دفاع (doctoral defence) اور مخطوطہ (manuscript) کی جانچ کا ایک معمول کا حصہ بن چکا ہے، کوئی غیر معمولی قدم نہیں۔
ان ٹولز کی حدود کو سامنے رکھنا فائدہ مند ہے۔ بیرونِ ملک کئی بڑی یونیورسٹیز، جن میں Vanderbilt بھی شامل ہے، نے false positives اور غیر اصیل لکھنے والوں کے خلاف تعصب کی وجہ سے Turnitin کے AI-writing detector کو بند کر دیا ہے، اور خود Turnitin بھی اپنے سب سے کم اسکورز کو دبا دیتا ہے اور متنبہ کرتا ہے کہ اس کی تعداد کبھی کسی integrity کیس کو خود اپنی بنیاد پر فیصلہ نہ کر دے۔ ڈٹیکٹر اسکور ایک ایسی دعویٰ (claim) ہے جسے آپ چیلنج کرنے کے مجاز ہیں، فیصلہ (verdict) نہیں۔
ہنگریائی اداروں نے generative AI کے بارے میں اپنی اپنی رہنمائی جاری کی ہے، اور فنڈرز اور جرنلز اب بڑھتی ہوئی توقع کے ساتھ مصنفین سے یہ بھی مانگ رہے ہیں کہ وہ بتائیں کہ ان ٹولز کو کیسے استعمال کیا گیا۔ دیانت دار جواب یہ نہیں کہ کچھ چھپایا جائے۔ دیانت دار جواب یہ ہے کہ ذمہ داری سے لکھیں اور ایڈٹ کریں، پھر ان ٹولز کا اعلان کریں جن پر آپ انحصار کرتے رہے۔
ہنگری کی سرفہرست جامعات اور AI جانچ کہاں ہوتی ہے
مماثلت اور AI indicators کے لیے اسکریننگ پورے ہنگریائی اعلیٰ تعلیمی نظام میں نظر آتی ہے، ڈاکٹریل اسکولوں سے لے کر جرنل کی ایڈیٹوریل دفاتر تک۔ درج ذیل ادارے ملک کے اُن نمایاں ترین ریسرچ-انٹینس (research-intensive) اداروں میں سے ہیں، اور ان کی theses اور manuscripts ان چیکز سے گزرتی ہیں:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE)، بخارسٹ
- Semmelweis Egyetem (Semmelweis University)، بخارسٹ، ایک بڑا میڈیکل اسکول
- Szegedi Tudományegyetem (University of Szeged)، سیگِدے
- Debreceni Egyetem (University of Debrecen)، ڈیبربیَن (Debrecen)
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME)، بخارسٹ
- Budapesti Corvinus Egyetem (Corvinus University of Budapest)، بخارسٹ
- Pécsi Tudományegyetem (University of Pécs)، پِیکس (Pécs)
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University)، بخارسٹ
- Óbudai Egyetem (Óbuda University)، بخارسٹ
چاہے آپ کا کام ELTE میں defend ہونے والی dissertation ہو یا Semmelweis سے آنے والا کوئی کلینیکل مخطوطہ، اسی نوعیت کی حرکیّت (dynamic) لاگو ہوتی ہے: معیاری، محتاط ہنگری-انگریزی وہ تحریر ہے جس کے سب سے زیادہ امکانات ہیں کہ وہ perplexity پر مبنی کسی “flag” پر پھنس جائے۔
ہنگیرین محققین کے لیے AI ہیومنائزر کیسے کام کرتا ہے
ہم جس ورک فلو کی سفارش کرتے ہیں وہ سادہ ہے اور سب سے اہم بات یہ کہ دیانت دار ہے۔ اس کے تین مراحل ہیں۔
پہلا مرحلہ: ڈرافٹ بنائیں۔ اپنا پیپر ویسے لکھیں جس سے آپ کی سوچ سب سے تیزی سے صفحہ پر آ جائے۔ بہت سے ہنگریائی محققین کے لیے اس کا مطلب ہنگری میں ڈرافٹنگ اور ترجمہ ہے، یا AI کی مدد سے براہِ راست انگریزی میں لکھنا۔ دونوں درست ہیں۔
دوسرا مرحلہ: مواد (substance) کی پروف ریڈنگ کریں۔ گرامر، اصطلاحات (terminology) اور دلیل (argument) کو درست کریں تاکہ سائنس درست رہے۔ اگر خود زبان کو بھی محتاط گزر (careful pass) کی ضرورت ہو تو ہماری global academic editing hub اس پہلو کا احاطہ کرتی ہے۔
تیسرا مرحلہ: اپنے ڈرافٹ کو خود ہیومنائزر کریں۔ یہی وہ مرحلہ ہے جہاں text humanizer کام میں آتا ہے۔ یہ جملوں کی لمبائی اور تال (rhythm) میں تبدیلی لاتا ہے، اس یکسان مزاج (monotone cadence) کو توڑتا ہے جو agglutinative ہنگری-انگریزی عموماً پیدا کرتی ہے، اور وہ اجنبی em dashes اور دہرائے جانے والے ساختی پیٹرنز ہٹاتا ہے جو دونوں طرف سے—AI ٹولز اور دوسری زبان کی عادتوں—کی صورت میں پیچھے رہ جاتے ہیں۔ سب سے اہم بات: یہ آپ کا معنی، آپ کی تکنیکی الفاظ/لغت (technical vocabulary) اور ہر citation محفوظ رکھتا ہے۔ غیر انگریزی ماخذ متن (Non-English source text) زبان-آگاہ ماڈل کے ذریعے جاتا ہے، اور یہ ٹول ساٹھ سے زیادہ زبانوں کو سپورٹ کرتا ہے۔
اس سے کیا حاصل ہوتا ہے؟ ہمارے اپنے ٹیسٹنگ میں، ایک محتاط غیر اصیل (non-native) ڈرافٹ کو ہیومنائز کرنے سے یہ نمایاں طور پر کم ہو جاتا ہے کہ بڑے ڈٹیکٹرز اسے کتنی بار مشین سے لکھی ہوئی تحریر سمجھ لیتے ہیں، اور ساتھ ہی تعلیمی معنی (academic meaning) بھی برقرار رہتا ہے۔ ہم اسے اپنے مشاہدات (testing) کے طور پر بیان کرتے ہیں، بطور وعدہ نہیں۔ یہاں کوئی بھی دیانت دار ٹول نتیجے کی ضمانت نہیں دے سکتا، کیونکہ ڈٹیکٹر ہر چند ماہ بعد دوبارہ تربیت (retrain) لیتے ہیں، اور جو سروس خود کو “100% undetectable” کہے وہ آپ کو وہ چیز بیچ رہی ہوتی ہے جسے وہ پہنچا ہی نہیں سکتی۔
پھر آخری قدم: واضح کریں (disclose)۔ AI کے استعمال کا ایک بیان (AI-use statement) اس فارمیٹ میں شامل کریں جس کی آپ کی یونیورسٹی اور مطلوبہ جرنل کو ضرورت ہو۔ اپنی ہی AI-مدد یافتہ تحریر کو ہیومنائز کر کے پھر اس کا اعلان کرنا کوئی دھوکا نہیں ہے۔ یہ اس بات کو یقینی بنانا ہے کہ آپ کی محتاط محنت کو دوسری زبان میں واضح ہونے کے “جرم” کی وجہ سے جھوٹے جھنڈے (flags) لگنے کے بجائے اس کے اصل معیار پر جانچا جائے۔ ممالک کے درمیان وسیع تر زبان کی تصویر کے لیے ہماری multilingual AI humanizer hub دیکھیں۔
مقامی فنڈنگ ادارے، جرائد اور AI افشا کی توقعات
ہنگری میں مقابلہ جاتی ریسرچ زیادہ تر NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office) کے ذریعے فنڈ کی جاتی ہے، جبکہ MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) بطور قومی اکیڈمی اور HUN-REN (the Hungarian Research Network) بطور عوامی ریسرچ اداروں کا نیٹ ورک کام کرتی ہے۔ یہ سب شائع شدہ، انڈیکسڈ آؤٹ پٹ کو اہمیت دیتے ہیں، جس کی وجہ سے محققین پر انگریزی میں شائع کرنے کا مسلسل دباؤ رہتا ہے۔
یہ آؤٹ پٹ Web of Science اور Scopus میں انڈیکسڈ جرنلز کے ذریعے ناپا جاتا ہے اور MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography) میں رجسٹر کیا جاتا ہے، یہ قومی اشاعتی ڈیٹابیس ہے۔ تشخیصی ثقافت بین الاقوامی اور انگریزی زبان میں اشاعت کو انعام دیتی ہے، اور یہی وہ دباؤ ہے جو ہنگریائی اسکالرز کو صاف، معیاری نثر کی طرف دھکیلتا ہے، وہی نثر جسے ڈٹیکٹر غلطی سے AI سے لکھی ہوئی سمجھ لیتے ہیں۔
امید رکھیں کہ AI-use disclosure گرانٹس کی رپورٹنگ اور جرنل سبمِشن، دونوں میں، زیادہ عام ہوتا جائے گا۔ اسے معمول (routine) سمجھیں۔ صاف لفظوں میں بتائیں کہ آپ نے کون سے ٹولز استعمال کیے اور کیسے، اپنا ڈیٹا اور حوالہ جات دیانت دار رکھیں، اور آپ غیر منصفانہ “flags” کے خلاف اپنے کام کا دفاع کرتے ہوئے بھی آرام سے قواعد کے اندر رہیں گے۔
اکثر پوچھے جانے والے سوالات
سوال: کیا ہنگیرین محققین کے لیے AI ہیومنائزر میرے حوالوں یا تکنیکی اصطلاحات کو بدلتا ہے؟
نہیں۔ ہیومنائزر اس لیے بنایا گیا ہے کہ آپ کا معنی، آپ کی discipline-specific اصطلاحات (terminology) اور ہر حوالہ (reference) بالکل ویسے ہی محفوظ رہے جیسے آپ نے لکھا تھا۔ یہ تال (rhythm) اور جملہ بندی (phrasing) میں تبدیلی کرتا ہے، نہ کہ آپ کی سائنس یا آپ کے ذرائع میں۔
سوال: کیا کوئی ٹول ضمانت دے سکتا ہے کہ میرا مقالہ ہر AI ڈیٹیکٹر سے پاس ہو جائے گا؟
نہیں، اور آپ کو ایسے ہر دعوے کرنے والے سے شک کرنا چاہیے۔ ڈٹیکٹرز کو باقاعدگی سے دوبارہ تربیت (retrain) دی جاتی ہے، اس لیے کوئی بھی دیانت دار سروس یہ وعدہ نہیں کر سکتی کہ وہ 100% undetectable ہوگا۔ ہم یہ کہہ سکتے ہیں کہ، ہماری ٹیسٹنگ میں، محتاط غیر اصیل نثر کو ہیومنائز کرنے سے اس کے غلط طور پر مشین سے لکھی ہوئی سمجھ لیے جانے کے امکانات نمایاں طور پر کم ہو جاتے ہیں۔
سوال: کیا اپنے ہی مسودے کو ہیومنائز کرنا نقل کی ایک شکل ہے؟
یہ دھوکہ نہیں ہے، بشرطیکہ آپ اپنی AI-مدد یافتہ تحریر پر خود کام کر رہے ہوں، اپنی دریافت (findings) کو دیانت دار رکھ رہے ہوں، اور اپنے ٹول کے استعمال کو اپنی ادارے اور جرنل کے مطابق واضح (disclose) کر رہے ہوں۔ مقصد اصلی کام کے لیے انصاف ہے، کوئی بھی چیز چھپانا نہیں۔
سوال: کمزور تحریر فلیگ نہیں ہوتی تو میری واضح انگریزی فلیگ کیوں ہوتی ہے؟
کیونکہ بہت سے ڈٹیکٹر predictability کو اسکور کرتے ہیں۔ محتاط دوسری زبان کے لکھنے والے محفوظ، معیاری اور درست تعمیرات (constructions) کا رخ کرتے ہیں، جس کے نتیجے میں کم perplexity والا متن بنتا ہے، اور کم perplexity بالکل وہی پیٹرن ہے جسے یہ ٹولز مشین لکھائی سے جوڑتے ہیں۔ آپ کی وضاحت آپ کے خلاف جاتی ہے۔
سوال: اگر مسودہ پہلے ہنگیرین میں لکھا جائے تو کیا یہ ٹول اسے سنبھال سکتا ہے؟
جی ہاں۔ غیر انگریزی متن کو زبان-آگاہ ماڈل سے گزارا جاتا ہے جو ساٹھ سے زیادہ زبانوں میں جملے کی ساخت (sentence structure) اور معنی (meaning) کو محفوظ رکھتا ہے، لہٰذا آپ ہنگری میں ڈرافٹ بنا سکتے ہیں، پھر ترجمہ کر سکتے ہیں، اور اس کے بعد انگریزی ورژن کو ہیومنائز کر سکتے ہیں، بغیر اس کے کہ آپ کی دلیل (argument) کمزور پڑے۔
اپنے محتاط، AI سے معاون کردہ ہنگیرین-انگلش مسودے کو قدرتی تعلیمی نثر میں تبدیل کریں، ہر حوالہ اور نتیجہ برقرار رکھتے ہوئے، پھر اعتماد کے ساتھ اپنی AI کا استعمال ظاہر کریں
Moe قدرتی زبان کی پروسیسنگ میں PhD کے ساتھ ایک NLP انجینئر ہے۔ اس کی تحقیق میں کمپیوٹیشنل لسانیات، متن کا تجزیہ، اور مشین لرننگ شامل ہے، اور اس نے ProofreaderPro کے پیچھے ایڈیٹنگ اور ہیومنائزیشن ماڈلز کو براہ راست شامل کیا۔ وہ اس عمل کے اس حصے کے بارے میں لکھتا ہے جسے زیادہ تر لوگ کبھی نہیں دیکھتے: زبان کا ماڈل کس طرح ایک جملہ پڑھتا ہے، اسکور کرتا ہے، اور فیصلہ کرتا ہے کہ کیا تبدیل کرنا ہے۔