
AI humanizer dla czeskich badaczy piszących po angielsku
AI humanizer dla czeskich badaczy. Ograniczaj fałszywe alarmy wykrywania AI w angielskim inspirowanym językiem czeskim, zachowaj znaczenie i cytowania, a także uczciwie ujawniaj użycie.

Czechia mierzy się z wyzwaniami ponad miarę. To mały kraj z dużą bazą badawczą, który ma realną pozycję międzynarodową w fizyce, chemii, nauce o materiałach oraz naukach o życiu, w dużej mierze zakorzenioną w działalności Czeskiej Akademii Nauk. Prawie wszystkie te prace trafiają na świat w języku angielskim, mimo że większość z nich jest najpierw rozważana i tworzona w języku czeskim.
Ta luka, między językiem, w którym myślisz, a językiem, w którym publikujesz, dokładnie tam zaczynają się problemy. AI humanizer dla czeskich badaczy istnieje z przyziemnego powodu: starannie i poprawnie napisany po angielsku tekst czeskiego naukowca jest obecnie błędnie odczytywany jako treść maszynowa przez automatyczne detektory, a pojedynczy fałszywy alarm w czystej pracy może kosztować cię złożenie wniosku, ocenę albo reputację budowaną latami.
To niewygodna część. Nawyki, które sprawiają, że czesko-angielski jest na tyle klarowny, by go publikować, standardowe sformułowania, powszechnie używane słownictwo, przewidywalne konstrukcje zdań, są jednocześnie tym, co detektor AI został wytrenowany, by uznawać za podejrzane.
Humanizace AI textu pro české výzkumníky publikující v angličtině
Nasza humanizace AI textu pomáhá českým výzkumníkům publikovat v angličtině, aniž by jejich pečlivě napsaná práce byla nespravedlivě označena detektory jako strojově psaná. Cílem je zachovat význam, odbornou terminologii i citace.
W prostych słowach: nasze narzędzie działa na angielskim, który masz już napisany lub wstępnie przygotowany przy pomocy AI, zachowuje nienaruszoną twoją argumentację i referencje, a następnie przekształca rytm wypowiedzi tak, aby detektor rzadziej błędnie ocenił tekst. Zostało stworzone do realnych badań, a nie do maskowania pracy, której nie wykonałeś. Możesz przetestować je na our humanizer fragmentem własnego tekstu, zanim zaufasz mu z pełnym manuskryptem.
Piszesz po czesku? Jest automatycznie wykrywane i ułatwiane do naturalnego brzmienia bezpośrednio
Czescy badacze często przygotowują wstępne wersje w swoim języku ojczystym, zanim przejdą na angielski, a humanizer jest na to przygotowany. Wklej tekst po czesku, a ProofreaderPro sam wykryje język, po czym przetworzy go przez model uwzględniający język czeski, zachowa háček i inne znaki diakrytyczne, twoją terminologię oraz cytowania dokładnie na swoich miejscach. Dzięki humanizace AI textu twoja czeska wersja zostaje zhumanizowana równie łatwo jak angielska, bez tłumaczenia najpierw na inny język. To samo wykrywanie obejmuje ponad sześćdziesiąt języków, każdy tekst jest przepisywany w swoim własnym stylu.
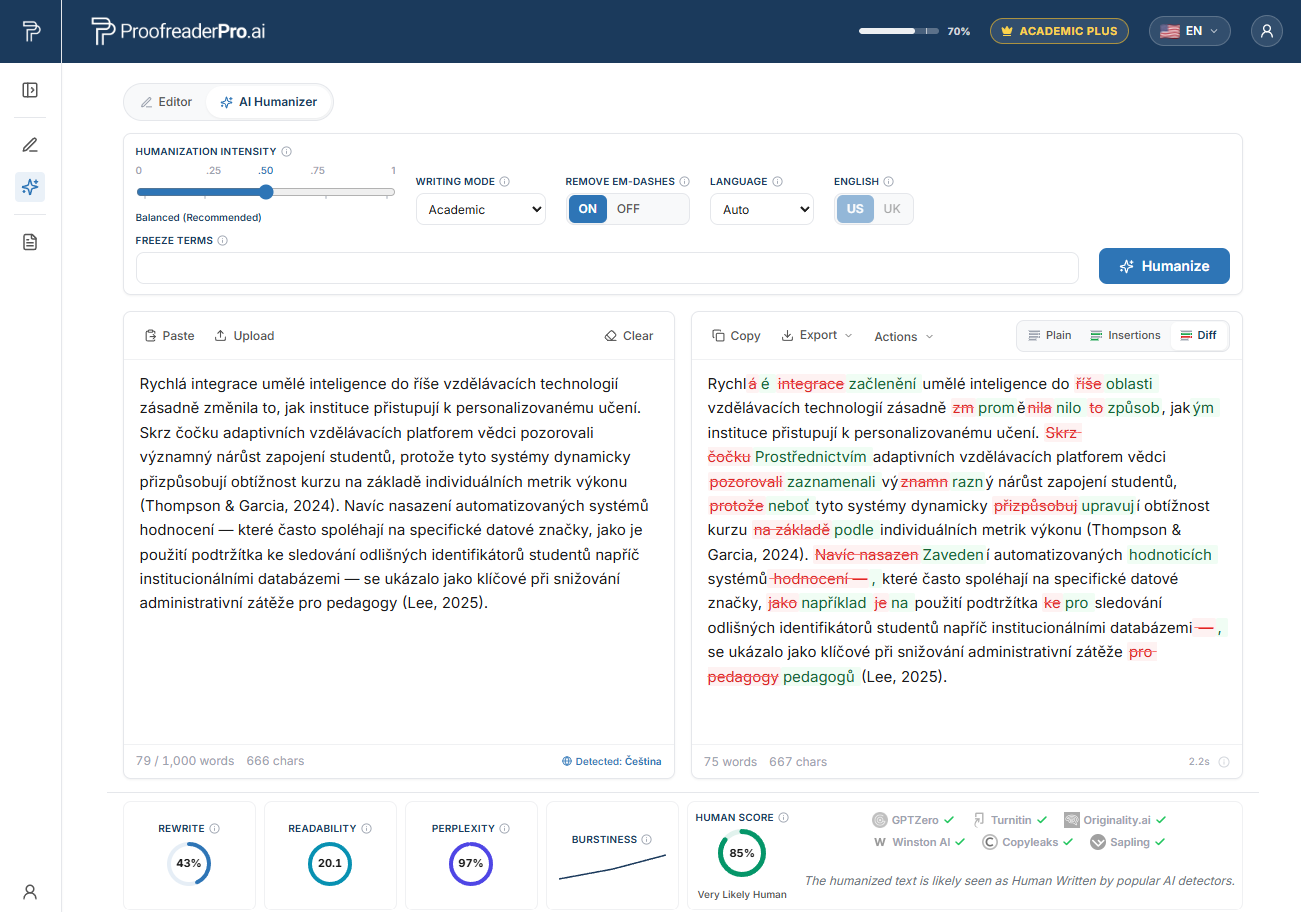
The ProofreaderPro AI Humanizer rewriting Czech academic text. The before and after diff keeps your meaning and citations, and the detector checks confirm a natural, human read.
Dlaczego czescy badacze są flagowani przez detektory AI
W 2023 roku zespół na Stanford, kierowany przez Weixina Lianga, opublikował w czasopiśmie Cell Press „Patterns” badanie zatytułowane wprost: "GPT detectors are biased against non-native English writers." Naukowcy wzięli eseje TOEFL napisane w całości przez ludzi i uruchomili na nich siedem powszechnie używanych detektorów AI.
Wynik powinien niepokoić każdego, kto pisze angielski jako drugi język. Średnio około 61% esejów osób niebędących rodzimymi użytkownikami języka angielskiego zostało oznaczonych jako wygenerowane przez AI, w porównaniu do około 5% esejów autorów rodzimych. Prawie co piąty esej niebędącego rodzimym użytkownikiem, czyli ok. 19,8%, został oznaczony jednomyślnie przez każdy z detektorów. Żaden z tych tekstów nie został napisany przez maszynę.
Mechanizm nazywa się „perplexity”. Wiele detektorów ocenia, jak zaskakujący jest każdy wybór słowa w modelu językowym. Pewny siebie rodzimy autor podejmuje ryzyko, używa idiomów i zmienia rytm wypowiedzi w sposób, który model odbiera jako nieprzewidywalny, a to czyta się jako „ludzkie”. Staranny czeski badacz robi odwrotnie: wybiera bezpieczne słowa, standardową konstrukcję i schemat zdania wytrenowany na każdym kursie angielskiego. Ta ostrożność generuje niską perplexity, a właśnie niska perplexity jest odczytywana przez detektor jako tekst maszynowy. Pełny mechanizm wyjaśniamy w why AI detectors flag non-native writers.
Czeskie wzorce języka ojczystego stojące za fałszywymi alarmami
Czeski i angielski zbudowane są na różnych zasadach gramatycznych, a miejsca, w których się różnią, zostawiają ślady w twoim angielskim. Żadna z tych rzeczy nie jest błędem myślenia. To przewidywalne, standardowe ślady „czeskiego umysłu” piszącego starannie po angielsku, i właśnie ich regularność sprawia, że detektor ocenia je jako niską perplexity.
Artykuły, które pojawiają się i znikają. Czeski nie ma „the” ani „a”. Artykuły w angielskim bywają pomijane, dodawane albo zamieniane, więc piszesz „result was significant” lub „we performed the analysis of the data”. Gdy redaktor to uporządkuje, otaczające zdania często stają się jeszcze bardziej „podręcznikowo” standardowe, co zwiększa ryzyko flagi, a nie je obniża.
Aspekt stojący w miejscu czasu. W czeskiej gramatyce kluczowe są aspekt dokonany i niedokonany, a nie angielski system czasów. Strona perfektywna vs prosty czas przeszły wychodzą niespójnie, a poprawiona wersja zwykle „trzaska” w kierunku najbardziej konwencjonalnego wyboru czasu, jakiego oczekuje model.
Utrzymanie szyku, które niesie akcent. Czeski opiera się na końcówkach przypadków, by przekazać znaczenie, oraz na szyku wyrazów dla nacisku, dlatego struktura informacji w angielskim może przenosić się niezgrabnie. Wygładzenie do standardowego układu subject-verb-object sprawia, że zdanie traci dokładnie tę nieprzewidywalność, którą detektor czyta jako „ludzkie”.
Nieliczbowe rzeczowniki policzalne przechodzące w liczbę mnogą. "Informations", "researches", "an advice", "evidences". Te formy są logiczne po czesku i powszechne w czesko-angielskich wersjach roboczych, a gdy zostaną skorygowane sformułowania, lądujesz w rejestrze, na który detektory zostały wytrenowane.
Przyimki i brakujące czasowniki posiłkowe. Przyimki przenoszą się wprost z czeskiego, a czasownik posiłkowy „do” lub „does” znika w pytaniach i przeczeniach. Po korekcie konstrukcje stają się czyste i ogólne, a to jest dokładnie profil czytany jako niska perplexity.
Kontekst AI-detekcji w Czechach i Turnitin
Prace dyplomowe i zgłoszenia do czasopism w Czechach są rutynowo sprawdzane zarówno pod kątem podobieństwa, jak i treści generowanej przez AI. Wiele czeskich uczelni korzysta ze wspólnej infrastruktury krajowej, systemów Theses.cz i Odevzdej.cz koordynowanych przez Masarykova univerzita, a Turnitin jest szeroko stosowany również obok nich.
Instytucje czeskie wydały własne wskazówki dotyczące generatywnej AI, a kierunek zmian jest jasny: sponsorzy i redakcje coraz częściej oczekują, że ujawnisz, jak używałeś AI. Taki klimat ma sens. Problemem nie jest ujawnianie, jest ono łatwe i uczciwe. Problem pojawia się wtedy, gdy wynik detektora traktuje się jak wyrok, podczas gdy w rzeczywistości to zgadywanie statystyczne, które najczęściej pudłuje dokładnie na starannej, nie-rodzimej prozie czeskich badaczy, do produkowania której zostali szkoleni.
Pomaga pamiętać, że nawet dostawcy detektorów stosują „zabezpieczenia”. Turnitin ukrywa własne oceny w dolnym zakresie i ostrzega, że liczby nie należy używać samodzielnie do decyzji o integralności. Kilka uczelni, w tym Vanderbilt, posunęło się dalej i całkowicie wyłączyło swój detektor AI, powołując się na fałszywe trafienia i uprzedzenia wobec autorów niebędących rodzimymi użytkownikami języka. Flaga jest roszczeniem do sporu, a nie przyznaniem się.
Chroń swoje czeskie pisanie po angielsku przed fałszywymi flagami AI
Wklej akapit własnej prozy badawczej i zobacz, jak humanizer zachowuje Twoje znaczenie i cytowania, jednocześnie zmniejszając ryzyko, że detektor odczyta staranny, nienatywny angielski błędnie jako maszynowy.
Wypróbuj darmowy HumanizerNajważniejsze czeskie uczelnie i gdzie pojawiają się kontrole AI
Jeśli studiujesz, prowadzisz zajęcia lub składasz dokumenty w Czechach, twoja praca przejdzie przez jedną z tych instytucji, a wszystkie z nich sprawdzają prace dyplomowe i manuskrypty pod kątem podobieństwa oraz coraz częściej ważą wskaźniki AI.
- Univerzita Karlova (Charles University), Praga
- České vysoké učení technické v Praze (ČVUT, Czech Technical University), Praga
- Masarykova univerzita (Masaryk University), Brno
- Univerzita Palackého v Olomouci (Palacký University), Ołomuniec
- Vysoké učení technické v Brně (VUT, Brno University of Technology), Brno
- Vysoká škola chemicko-technologická v Praze (VŠCHT, University of Chemistry and Technology), Praga
- Vysoká škola báňská, Technická univerzita Ostrava (VŠB-TUO), Ostrawa
- Mendelova univerzita v Brně (Mendel University), Brno
- Jihočeská univerzita v Českých Budějovicích (University of South Bohemia), Czeskie Budziejowice
- Univerzita Pardubice, Pardubice
Stawki różnią się w zależności od dokumentu. Odrzucony manuskrypt czasopisma kosztuje cię miesiące. Praca oznaczona flagą na Univerzita Karlova lub Masarykova univerzita może uruchomić przesłuchanie, na którym to twoja integralność, nie gramatyka, trafia na próbę. To niewłaściwa rozmowa, by prowadzić ją nad fałszywym trafieniem.
Jak działa AI humanizer dla czeskich badaczy
Uczciwy proces jest prosty, a ujawnienie, jest w jego centrum, a nie na marginesie.
Zacznij tam, gdzie masz najmocniejsze strony. Jeśli tak myślisz najlepiej, twórz wstępną wersję po czesku, a potem tłumacz, albo przygotuj od razu po angielsku z pomocą AI. Najpierw dopracuj naukę. Następnie skoryguj gramatykę tak, by znaczenie było precyzyjne. Dopiero potem uruchamiasz AI humanizer dla czeskich badaczy, przekształca on rytm i dobór słów tak, aby twoja staranna, standardowa wersja po angielsku była mniej podatna na błędną interpretację przez detektor, przy jednoczesnym zachowaniu nienaruszonego znaczenia, terminologii i cytowań w dokładnie takiej postaci, w jakiej je zapisałeś.
Czego możesz się spodziewać? W naszych własnych testach humanizer znacząco zmniejsza częstotliwość, z jaką staranna, nie-rodzimą wersję angielskiego mylą z treścią wygenerowaną przez czołowe detektory, w tym Turnitin, Originality.ai i GPTZero, bez naruszania twojej argumentacji. Opisujemy to jako to, co zaobserwowaliśmy w testach, a nie jako obietnicę. Detektory przestawiają się co kilka miesięcy, więc żadne uczciwe narzędzie nie może obiecać, że będzie w 100% niewykrywalne. Każdy, kto to gwarantuje, sprzedaje ci coś.
Znaczenie ma też tekst nieanglojęzyczny. Ponieważ humanizer obsługuje ponad 60 języków i kieruje treści nieangielskie przez model uwzględniający język, możesz pracować nad czeskimi wersjami roboczymi lub mieszanymi notatkami bez ryzyka spłaszczenia struktury twoich zdań. Ten moduł działa w ramach naszego multilingual AI humanizer hub i naturalnie współgra z praktyczną edycją w naszym global academic editing hub, gdy manuskrypt potrzebuje również ludzkiego spojrzenia.
Na koniec przychodzi krok, który utrzymuje całość w zgodzie z zasadami: ujawnij swoje użycie AI w formacie, którego wymaga twoja instytucja i docelowe czasopismo. Zhumanizowanie własnej wersji chroni klarowne pisanie przed niesprawiedliwą flagą. Ujawnienie twojej metody utrzymuje cię w ramach zasad. Robisz obie rzeczy, więc nie masz nic do ukrycia.
Lokalne instytucje finansujące, czasopisma i oczekiwania dotyczące ujawniania AI
Czeskie finansowanie badań realizuje się głównie przez trzy podmioty, a każdy z nich coraz częściej oczekuje przejrzystości w zakresie użycia AI. GAČR (Grantová agentura České republiky, the Czech Science Foundation) finansuje badania podstawowe. TAČR (Technologická agentura České republiky, the Technology Agency) finansuje badania stosowane. AV ČR (Akademie věd České republiky, the Czech Academy of Sciences) prowadzi krajowe instytuty, z których pochodzi duża część dorobku kraju.
Po stronie publikacji presja idzie w jednym kierunku. Oceny krajowe i budżety instytucjonalne premiują wyniki w czasopismach indeksowanych w Web of Science i Scopus, a rezultaty są raportowane do krajowego rejestru informacji o R&D; RIV. To premiuje publikacje po angielsku, co z powrotem wplątuje cię w problem fałszywych alarmów, od którego zaczyna się ten artykuł.
Pamiętaj, co już mówią liczby o tej barierze. Autorzy niebędący rodzimymi użytkownikami języka angielskiego mierzą się ze współczynnikami odrzutów około 2,5 razy wyższymi niż autorzy rodzimi, poświęcają mniej więcej o 51% więcej czasu na pisanie swoich prac i o około 91% więcej czasu na ich czytanie oraz otrzymują około 12,5 razy więcej próśb o rewizje powiązanych z jakością języka. Mniej niż 7% czasopism w ogóle akceptuje zgłoszenia nieanglojęzyczne. System prosi czeskich badaczy, by konkurowali po angielsku, a następnie karze staranną angielszczyznę, którą ta rywalizacja wytwarza. Zhumanizowanie własnej wersji, zachowanie cytowań i ujawnienie metody to uczciwa odpowiedź na niesprawiedliwe ustawienie, a nie sposób obejścia go. Używaj the humanizer jako jednego z narzędzi w tym uczciwym procesie.
Najczęściej zadawane pytania
P: Czy korzystanie z AI humanizera dla czeskich badaczy to oszustwo?
Nie, nie wtedy, gdy używasz go uczciwie. Przekształcasz rytm własnej wersji przygotowanej z pomocą AI, zachowując znaczenie i cytowania, a następnie ujawniasz użycie AI w sposób, jakiego wymaga twoja instytucja i czasopismo. To edycja językowa plus przejrzystość, a nie wprowadzanie w błąd. Problem pojawia się dopiero wtedy, gdy próbujesz przedstawić jako własną pracę coś, czego nie wykonałeś, albo ukryć użycie, które kazano ci zadeklarować.
P: Czy humanizer zmieni moje terminy techniczne albo cytowania?
Nie. Narzędzie zostało zbudowane tak, by zachować akademickie znaczenie, specjalistyczną terminologię oraz znaczniki referencji, jednocześnie zmieniając rytm zdań i dobór słów. Twoja chemia pozostaje chemią, a cytowania, na swoim miejscu. Mimo wszystko powinieneś skorygować finalną wersję, ponieważ nadal pozostajesz autorem odpowiedzialnym za każde słowo.
P: Czy możesz zagwarantować, że moja praca przejdzie Turnitin lub GPTZero?
Nie i nie powinieneś ufać nikomu, kto obiecuje to komuś innemu. Detektory stale się przeprogramowują, więc żadne uczciwe narzędzie nie może obiecać 100% niewykrywalności. To, co możemy powiedzieć, jest takie: w naszych testach zhumanizowanie starannej, nie-rodzinie napisanej angielszczyzny znacząco zmniejsza częstotliwość, z jaką czołowe detektory mylą ją jako treść wygenerowaną przez AI, przy zachowaniu nienaruszonego znaczenia.
P: Dlaczego moje poprawne czesko-angielskie brzmienie jest flagowane na samym początku?
Ponieważ staranne pisanie w drugim języku zwykle ma niską perplexity. Wybierasz bezpieczne słowa i standardowe konstrukcje, a detektory odbierają tę przewidywalność jako wytwór maszyn. Badanie Stanford wykazało, że eseje napisane przez autorów niebędących rodzimymi użytkownikami były oznaczane jako AI znacznie częściej niż te napisane przez autorów rodzimych, co pokazuje, że uprzedzenie leży w samym detektorze, a nie w twoim piśmie.
P: Czy muszę nadal informować moją uczelnię lub czasopismo, że użyłem AI?
Tak, zawsze wtedy, gdy tego wymagają, a coraz częściej tego wymagają. Zhumanizowanie wersji roboczej dotyczy uczciwości, a nie ukrywania, więc ujawnienie jest kluczowe, a nie „furtką”. Wyraźnie opisz, jak użyłeś AI podczas pisania i edycji, a pozostaniesz po właściwej stronie zarówno zasad integralności, jak i własnego sumienia.
Zredukuj fałszywe flagi AI w przypadku starannego czeskiego angielskiego, zachowując znaczenie, terminologię i cytowania, a następnie ujawnij swoje użycie AI z pewnością.

Moe jest inżynierem NLP z PhD w przetwarzaniu języka naturalnego. Jego badania obejmują lingwistykę obliczeniową, analizę tekstu i uczenie maszynowe, a następnie zostały wykorzystane bezpośrednio w modelach edycji i humanizacji stojących za ProofreaderPro. Pisze o części procesu, której większość ludzi nigdy nie widzi: o tym, jak model językowy czyta zdanie, ocenia je i decyduje, co zmienić.


