
अंग्रेज़ी में लिखने वाले भारतीय शोधकर्ताओं के लिए एआई ह्यूमनाइज़र
भारतीय शोधकर्ताओं के लिए एआई ह्यूमनाइज़र। हिंदी के प्रभाव से बनी अंग्रेज़ी पर गलत एआई-डिटेक्शन फ़्लैग कम करें, अर्थ और उद्धरण बनाए रखें, और ईमानदारी से खुलासा करें।

भारत एक वर्ष में 278,000 से अधिक Scopus-सूचीकृत शोधपत्र प्रकाशित करता है, जिससे वह दुनिया का तीसरा सबसे बड़ा शोध राष्ट्र बनता है, केवल चीन और संयुक्त राज्य अमेरिका के पीछे। 2015 और 2022 के बीच पीएचडी नामांकन में 81% की वृद्धि हुई, और UGC के 2025 ड्राफ्ट नियमों ने संकाय भर्ती और पदोन्नति के लिए प्रकाशन को प्रोत्साहित करने से बढ़ाकर विधिवत रूप से अनिवार्य कर दिया। पहले से अधिक भारतीय शोधकर्ता अंतरराष्ट्रीय जर्नल्स के लिए लिख रहे हैं।
इनमें से कई अब एआई सहायता के साथ मसौदा तैयार करते हैं और सबमिशन से पहले परिणाम को एआई चेक के जरिए चलाते हैं। यहीं पर भारतीय शोधकर्ताओं के लिए एआई ह्यूमनाइज़र अपनी जगह बनाता है, क्योंकि उस चेक में एक विशिष्ट समस्या सामने आती है: सावधानीपूर्वक, सही दूसरी-भाषा वाली अंग्रेज़ी को मशीन-जनित पाठ समझ लिया जाता है।
गैर-मातृभाषी अंग्रेज़ी बोलने वालों को जन्मसिद्ध (native) वक्ताओं की तुलना में लगभग 2.5 गुना अधिक अस्वीकृति दरों का सामना करना पड़ता है। जब उसी के ऊपर कोई एआई डिटेक्टर गलत फ़्लैग जोड़ देता है, तो केवल दूसरी-भाषा लेखक के वाक्य-गठन के ढंग के कारण किसी मानव-लिखित मेथड्स सेक्शन को संदेहास्पद माना जा सकता है, कोई अन्य कारण नहीं। यह गाइड बताती है कि भारतीय शोधकर्ताओं के साथ ऐसा क्यों होता है, और इसे स्पष्ट रूप से कैसे संभालें।
एआई ह्यूमनाइज़र भारतीय शोधकर्ताओं को अंग्रेज़ी में प्रकाशित करने में मदद करता है
हमारा एआई ह्यूमनाइज़र (AI humanizer) भारतीय शोधकर्ताओं को अंग्रेज़ी में प्रकाशित करने में मदद करता है, बिना इस बात के कि उनकी सावधानीपूर्ण लेखन शैली को एआई आउटपुट समझ लिया जाए। यह आपके अपने एआई-सहायता वाले मसौदे पर काम करता है, आपके अर्थ, शब्दावली और उद्धरणों को उसी तरह जगह पर रखता है, और उन लय/रिद्म तथा शब्द-चयन में बदलाव करता है जिन्हें डिटेक्टर आम तौर पर फ़्लैग करते हैं।
यह 60 से अधिक भाषाओं को सपोर्ट करता है। यदि आप पहले हिंदी, तमिल, बंगाली, तेलुगु या मराठी में किसी तर्क को सोचकर तैयार करते हैं, तो भाषा-संवेदनशील text humanizer शैक्षणिक अंग्रेज़ी में जाते समय आपकी वाक्य-रचना और अर्थ को सुरक्षित रखता है।
हिंदी में लिख रहे हैं? यह भी अपने-आप डिटेक्ट होता है और ह्यूमनाइज़ भी
कई भारतीय शोधकर्ता अंग्रेज़ी में जाने से पहले हिंदी में (और अक्सर सोचते-लिखते भी) हैं, और उसी के लिए यह ह्यूमनाइज़र बनाया गया है। आप एक हिंदी अनुच्छेद पेस्ट करें और ProofreaderPro देवनागरी लिपि को स्वचालित रूप से पहचान लेता है, फिर इसे भाषा-संवेदनशील मॉडल के माध्यम से प्रोसेस करता है जो आपके पाठ, शब्दावली और संदर्भों को वैसा ही बनाए रखता है जैसा आपने लिखा था। एआई ह्यूमनाइज़र आपके हिंदी मसौदे पर भी अंग्रेज़ी की तरह स्वाभाविक रूप से चलता है, इसलिए पहले किसी अनुवाद की जरूरत नहीं होती। स्वचालित पहचान 60 से अधिक भाषाओं में विस्तारित है, और हर भाषा को उसकी अपनी “आवाज़” में ह्यूमनाइज़ किया जाता है।
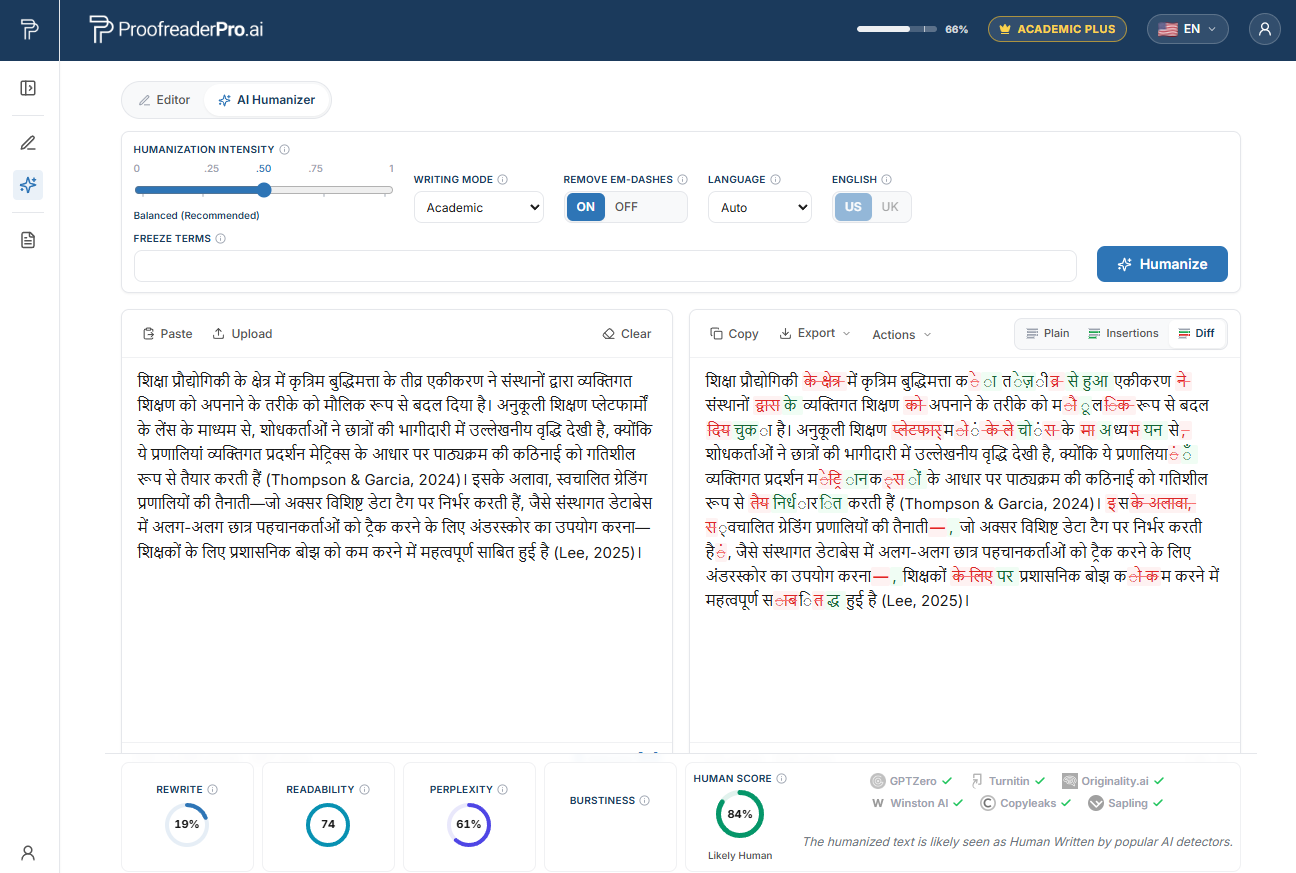
हिंदी अकादमिक पाठ को फिर से लिखकर ह्यूमनाइज़ करता ProofreaderPro AI Humanizer। before/after diff आपके अर्थ और उद्धरण बनाए रखता है, और डिटेक्टर चेक पुष्टि करते हैं कि पढ़ना प्राकृतिक, मानवीय है।
भारतीय शोधकर्ता एआई डिटेक्टरों द्वारा फ़्लैग किए जाने पर क्यों आते हैं
2023 में, Liang और सहयोगियों के नेतृत्व वाली एक Stanford टीम ने Cell Press जर्नल Patterns में "GPT detectors are biased against non-native English writers." शीर्षक से एक अध्ययन प्रकाशित किया। उन्होंने मानव-लिखित TOEFL निबंधों को सात व्यापक रूप से इस्तेमाल किए जाने वाले डिटेक्टरों के माध्यम से चलाया। औसतन, गैर-मातृभाषी निबंधों में लगभग 61% को एआई के रूप में फ़्लैग किया गया, जबकि अंग्रेज़ी के मातृभाषी लेखकों के लिए यह आँकड़ा लगभग 5% था। लगभग एक पाँचवें गैर-मातृभाषी निबंधों (करीब 19.8%) को हर डिटेक्टर ने एकमत होकर फ़्लैग किया। हर निबंध एक मानव द्वारा लिखा गया था।
इसका तंत्र ‘पर्प्लेक्सिटी’ (perplexity) है। कई डिटेक्टर यह स्कोर करते हैं कि किसी भाषा मॉडल के संदर्भ में हर शब्द-चयन कितना “अनपेक्षित” (surprising) है। दूसरी-भाषा के सावधानीपूर्वक लेखक सामान्य शब्दों और मानक, पूर्वानुमेय वाक्य-प्रयोगों का उपयोग करते हैं, जिससे पर्प्लेक्सिटी कम हो जाती है, और यह मशीन-टेक्स्ट की तरह पढ़ा जाता है। गैर-मातृभाषी अकादमिक गद्य को स्पष्ट और सही बनाकर रखने वाली आदतें वही हैं जिन्हें इन टूल्स ने फ़्लैग करने के लिए प्रशिक्षित किया है। हम इसे विस्तार से why AI detectors flag non-native writers में कवर करते हैं।
गलत फ़्लैग के पीछे हिंदी और क्षेत्रीय भाषाओं के पैटर्न
भारतीय अकादमिक अंग्रेज़ी में हिंदी, तमिल, बंगाली, तेलुगु, मराठी और अन्य पहली भाषाओं से आने वाला व्यवस्थित प्रभाव दिखता है। ये लापरवाह गलतियाँ नहीं हैं। यह वे पूर्वानुमेय, मानकीकृत तरीके हैं जिनसे सावधानीपूर्वक लेखक अपनी पहली भाषा और अंग्रेज़ी के बीच की दूरी की भरपाई करते हैं, और यही पूर्वानुमेयता पर्प्लेक्सिटी-आधारित डिटेक्टरों को उच्च एआई स्कोर देने में मदद करती है।
Articles. कई भारतीय भाषाओं में आर्टिकल सिस्टम नहीं होता, इसलिए "the" बनाम "a" बनाम आर्टिकल-न होना, यह फर्क हिंदी में मौजूद ही नहीं है। जो लेखक आर्टिकल छोड़ने की अपनी आदत से बाहर निकलने का अभ्यास कर लेते हैं, वे अक्सर बहुत नियमित, पाठ्यपुस्तक-टाइप वाक्य-प्रयोगों की ओर overcorrect कर बैठते हैं, जैसे: "The experiment was conducted using a modified protocol." सही, मानक, और कम पर्प्लेक्सिटी।
Prepositions. "discuss about," "comprises of," और "interested on" जैसे पैटर्न सीधे हिंदी से ट्रांसफर होते हैं। जब इन्हें मानक अंग्रेज़ी के रूप में संपादित कर दिया जाता है, तो वाक्य हर बार सबसे सामान्य, सबसे पूर्वानुमेय preposition पर आकर टिकता है, यही वह है जिसकी डिटेक्टर किसी मॉडल से अपेक्षा करते हैं।
Word order and agreement. हिंदी में विषय-कर्त्ता (subject), कर्म (object), क्रिया (verb) क्रम (order) का पालन होता है। लंबे अंग्रेज़ी वाक्य बनाते समय भारतीय शोधकर्ता अक्सर सही बने रहने के लिए उन्हें सबसे सुरक्षित, सबसे पारंपरिक subject-verb-object संरचना में पुनर्गठित कर देते हैं। सुरक्षित और पारंपरिक होने का अर्थ कम पर्प्लेक्सिटी के रूप में भी पढ़ा जाना है।
Tense consistency. अंग्रेज़ी के टेंस-मार्कर अधिकांश भारतीय भाषाओं की तुलना में अधिक कठोर (rigid) होते हैं, इसलिए सावधानीपूर्वक लेखक मेथड्स सेक्शन को एकसमान भूतकाल (uniform past tense) में ‘लॉक’ कर देते हैं। एकसमान, नियमित, और पूर्वानुमेय, एक बार फिर।
Sentence length. भारतीय अकादमिक गद्य अक्सर लंबे और विस्तृत ढांचे वाले वाक्यों की ओर झुकता है। जब इन्हें जर्नल की अपेक्षाओं के अनुसार काटा/संक्षिप्त किया जाता है, तो वे अक्सर छोटे, समान, और लगभग एक-जैसी संरचना वाले वाक्यों में ढल जाते हैं, जिन्हें एक डिटेक्टर मशीन की cadence (लय) की तरह पढ़ता है।
भारत का एआई-डिटेक्शन संदर्भ और Turnitin
भारत में थीसिस और जर्नल सबमिशन को अक्सर समानता (similarity) और एआई संकेतों, दोनों के लिए Turnitin या iThenticate से जांचा जाता है। अधिकांश विश्वविद्यालय थीसिस स्वीकार करने से पहले एक अनिवार्य plagiarism चेक चलाते हैं, और अब कई संस्थान उसी रिपोर्ट में एआई-राइटिंग संकेतक भी पढ़ते हैं। शैक्षणिक अखंडता (academic integrity) पर UGC के मार्गदर्शन ने समानता (similarity) जांच को शोध मूल्यांकन का नियमित हिस्सा बना दिया है।
यह भी सटीक समझना जरूरी है कि ये टूल वास्तव में क्या करते हैं। स्वयं Turnitin 1 से 19% के रेंज में एआई स्कोर को दबा देता है, जहाँ संख्या की जगह एक तारांकन (asterisk) दिखता है, और चेतावनी देता है कि उसकी रेटिंग को अकेले उपयोग करके अखंडता का निर्णय नहीं लेना चाहिए। विदेश के कई संस्थानों, जैसे Vanderbilt, ने 2023 में Turnitin के एआई डिटेक्टर को और आगे जाकर निष्क्रिय कर दिया, क्योंकि false positives और गैर-मातृभाषी लेखकों के प्रति पक्षपात (bias) का हवाला दिया गया था। Michigan State, UT Austin, Northwestern, Pittsburgh, SMU, और Waterloo ने भी इसी तरह के कदम उठाए। डिटेक्टर का स्कोर किसी बात का दावा (claim) है जिसे चुनौती दी जा सकती है, न कि कोई अंतिम फैसला (verdict)।
साथ ही, फंडर और जर्नल अब तेजी से लेखकों से यह बताने (disclose) को कह रहे हैं कि उन्होंने एआई का उपयोग कैसे किया। भारतीय शोधकर्ता के लिए समझदारी भरा रुख यह नहीं है कि एआई उपयोग छिपाया जाए। समझदारी यह है कि सावधानी से लिखा और संपादित किया जाए, उस सावधानीपूर्ण लेखन को गलत फ़्लैग से सुरक्षित रखा जाए, और फिर यह बिल्कुल स्पष्ट रूप से बताया जाए कि आपने क्या किया।
अपने सावधानीपूर्वक अंग्रेज़ी को गलत AI फ्लैग से सुरक्षित रखें
अपने AI-सहायता प्राप्त ड्राफ्ट को मानव-सदृश बनाइए, अपना आशय और उद्धरण बनाए रखें, फिर बताइए। यह Scopus और Web of Science जर्नल्स के लिए अंग्रेज़ी में लिख रहे भारतीय शोधकर्ताओं के लिए बनाया गया है।
Humanizer को निःशुल्क आज़माइएशीर्ष भारतीय विश्वविद्यालय और जहाँ एआई चेक दिखाई देते हैं
भारत का शोध-उत्पादन उच्च-स्तरीय संस्थानों के एक नेटवर्क में केंद्रित है, और इन सभी संस्थानों में काम आगे बढ़ने से पहले थीसिस और पांडुलिपियों (manuscripts) की समानता (similarity) तथा एआई के लिए जांच होती है।
- IISc Bengaluru (भारतीय विज्ञान संस्थान): भारत का शीर्ष-रैंक शोध संस्थान (NIRF 2025 में क्रमांक एक), भौतिक विज्ञान, इंजीनियरिंग और जैविक विज्ञान में सबसे मजबूत।
- IIT Madras, IIT Delhi, IIT Bombay, IIT Kharagpur, और IIT Kanpur (भारतीय प्रौद्योगिकी संस्थान): मूल पाँच IITs, इंजीनियरिंग, कंप्यूटर साइंस और मैटेरियल साइंस में शोध के लिए लगातार शीर्ष दस में शामिल।
- IIT Roorkee, IIT Guwahati, और IIT Hyderabad: नए IITs, जिनमें इंजीनियरिंग और अनुप्रयुक्त विज्ञान (applied sciences) में तेजी से बढ़ता शोध प्रोफाइल है।
- AIIMS New Delhi (अखिल भारतीय आयुर्विज्ञान संस्थान): भारत का प्रमुख चिकित्सा शोध संस्थान, उच्च-प्रभाव (high-impact) जर्नल्स में बायोमेडिकल और क्लिनिकल काम प्रकाशित करता है।
- Jawaharlal Nehru University (जवाहरलाल नेहरू विश्वविद्यालय): विश्वविद्यालय श्रेणी में NIRF 2025 में क्रमांक दो, सामाजिक विज्ञान और मानविकी में सबसे मजबूत।
- University of Delhi (दिल्ली विश्वविद्यालय): भारत के सबसे बड़े शोध विश्वविद्यालयों में से एक, विज्ञान और मानविकी, दोनों में व्यापक कवरेज के साथ।
- Banaras Hindu University (काशी हिन्दू विश्वविद्यालय): विज्ञान, इंजीनियरिंग और आयुर्वेदिक चिकित्सा में बड़ा आउटपुट।
- Jadavpur University: इंजीनियरिंग और विज्ञान में मजबूत शोध, भारत के विश्वविद्यालयों की सूची में लगातार शीर्ष दस में रैंक।
- Homi Bhabha National Institute: न्यूक्लियर साइंस, फिजिक्स और इंजीनियरिंग; BARC और अन्य DAE संस्थानों से संबद्ध।
इनमें से हर संस्थान करियर उन्नति के लिए शोधकर्ताओं को अंग्रेज़ी भाषा की अंतरराष्ट्रीय जर्नल्स में प्रकाशित करने की अपेक्षा करता है, और इन सभी में ऐसे AI और similarity चेक चलाए जाते हैं जिनमें गलत फ़्लैग फँस सकता है।
भारतीय शोधकर्ताओं के लिए एआई ह्यूमनाइज़र कैसे काम करता है
भारतीय शोधकर्ताओं के लिए एआई ह्यूमनाइज़र एक ही वर्कफ़्लो के इर्द-गिर्द बनाया गया है, कोई शॉर्टकट नहीं। नीचे वही क्रम है जिसकी हम अनुशंसा करते हैं।
पहला चरण: Draft तैयार करें। यदि मदद मिले, तो पहले उसी भाषा में लिखें जिसमें आप सोचते हैं, हिंदी या तमिल या बंगाली, फिर उसे अंग्रेज़ी में अनुवादित करें, या अंग्रेज़ी में AI सहायता के साथ मसौदा बनाएं। दूसरा चरण: व्याकरण (grammar) को प्रूफरीड करें ताकि articles, prepositions और tenses सही हों। तीसरा चरण: text humanizer के जरिए परिणाम चलाएँ, ताकि आपकी सावधानीपूर्ण, मानकीकृत (standardized) लेखन-शैली में लय और शब्द-चयन के संदर्भ में प्राकृतिक विविधता (natural variation) बनी रहे, और उसे मशीन-आउटपुट समझे जाने की संभावना कम हो। आपका अर्थ, तकनीकी शब्दावली, और उद्धरण ठीक वहीं बने रहते हैं जहाँ आप उन्हें रखते हैं।
हमारा ह्यूमनाइज़र एआई टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में पुनर्गठित करता है, जिससे एआई संकेत (AI signal) कम होता है और कठिन डिटेक्टरों के खिलाफ आपके परिणाम के बेहतर होने की संभावना बढ़ती है (शैक्षणिक टेक्स्ट में व्याकरण की शुद्धता ऊँची रहती है)। यह गारंटियों के बजाय परीक्षण (testing) पर आधारित है। डिटेक्टर हर कुछ महीनों में पुनः-ट्रेन होते हैं, इसलिए हम केवल यह बताते हैं कि टूल ने क्या किया है, कभी यह वादा नहीं करते कि कोई टेक्स्ट हमेशा undetectable रहेगा, और न ही इसे किसी चेक को बायपास करने का तरीका मानते हैं।
फिर: Disclosure करें। अपने संस्थान और लक्षित जर्नल द्वारा मांगे गए प्रारूप (format) में एक AI-use स्टेटमेंट जोड़ें। सावधानीपूर्ण लेखन, जो गलत फ़्लैग से सुरक्षित हो, उसके बाद स्पष्ट disclosure, आपको अखंडता (integrity) के नियमों के भीतर बनाए रखता है। यही सिद्धांत हमारे भारत में शोधकर्ताओं के लिए शैक्षणिक संपादन गाइड के पीछे भी है, और यह हमारे व्यापक बहुभाषी एआई ह्यूमनाइज़र हब में शामिल है।
स्थानीय फंडिंग संस्थाएँ, जर्नल्स, और एआई-disclosure की अपेक्षाएँ
DST-SERB, CSIR, ICMR, या DBT से फंडिंग पाने वाले शोधकर्ताओं से आम तौर पर अपने ग्रांट deliverables के हिस्से के रूप में अंतरराष्ट्रीय जर्नल्स में प्रकाशन की अपेक्षा की जाती है, और भाषा-संपादन (language editing) को इन अधिकांश संस्थाओं के लिए मान्यता प्राप्त, अनुमेय (allowable) खर्च माना जाता है। यह इसलिए महत्वपूर्ण है क्योंकि इसका अर्थ है कि एआई-सहायता वाले मसौदे पर proofread और humanize करने वाला टूल इस्तेमाल करना एक वैध शोध-खर्च है, न कि कोई workaround।
भारतीय शोधकर्ता अंतरराष्ट्रीय और घरेलू, दोनों ही प्रकार के जर्नल्स में प्रकाशित करते हैं। कई प्रमुख भारतीय जर्नल्स ऐसे अंग्रेज़ी की अपेक्षा करते हैं जो प्रकाशन-योग्य हो, और सबमिशन के समय एआई उपयोग के बारे में बढ़ती संख्या में पूछते हैं:
- Current Science: भारत का सबसे पुराना बहु-विषयक जर्नल, जिसकी स्थापना 1932 में C.V. Raman ने की थी।
- Indian Journal of Medical Research (IJMR): ओपन एक्सेस, ICMR द्वारा प्रकाशित; केवल अंग्रेज़ी में, और भारत के सबसे उच्च-प्रभाव (highest-impact) जर्नल्स में से एक।
- Pramana (Journal of Physics): Indian Academy of Sciences; Springer के साथ सह-प्रकाशित (co-published)।
- Economic & Political Weekly (EPW): प्रमुख सामाजिक विज्ञान जर्नल, Scopus-सूचीकृत।
- Journal of Biosciences और Journal of Earth System Science: दोनों Indian Academy of Sciences से।
- Sadhana: Indian Academy of Sciences से इंजीनियरिंग विज्ञान (engineering sciences); Q1 और Q2 में रैंक।
- The National Medical Journal of India: peer-reviewed क्लिनिकल और चिकित्सा शोध।
भारतीय विज्ञान अकादमी के सभी जर्नल्स अंग्रेज़ी पांडुलिपियाँ (English manuscripts) अनिवार्य करते हैं। आप जहाँ भी सबमिट करें, सबसे सुरक्षित आदत यही है कि जर्नल के आवश्यक प्रारूप में अपने एआई उपयोग का disclosure करें, और यदि कभी किसी गलत फ़्लैग के खिलाफ अपील करनी पड़े तो आपने क्या किया था, उसका एक छोटा निजी नोट रखकर चलें।
अक्सर पूछे जाने वाले प्रश्न
प्र: क्या भारतीय शोधकर्ताओं के लिए एआई ह्यूमनाइज़र का उपयोग धोखाधड़ी (cheating) का रूप है?
नहीं। सही उपयोग यह है कि आप अपने एआई-सहायता वाले मसौदे को humanize करें, अर्थ और उद्धरणों को अक्षुण्ण रखें, और फिर अपने संस्थान तथा जर्नल द्वारा आवश्यक प्रारूप में अपने एआई उपयोग का disclosure करें। आप किसी सावधानीपूर्ण, मानवीय शोध को गलत फ़्लैग से बचा रहे हैं, न कि कोई गढ़ा हुआ काम या किसी और की लेखन-शैली छुपाकर प्रस्तुत कर रहे हैं।
प्र: क्या ह्यूमनाइज़र की गारंटी है कि मेरा पेपर Turnitin के एआई डिटेक्टर से पास हो जाएगा?
नहीं। कोई भी टूल यह वादा नहीं कर सकता, और जो टूल ऐसा करता है वह आपको भ्रामक स्थिति में रखता है। प्रमुख डिटेक्टरों के खिलाफ परीक्षण (tested) करने पर हमारा ह्यूमनाइज़र एआई टेक्स्ट को अधिक प्राकृतिक मानवीय रूप में फिर से लिखता है, जिससे एआई संकेत (AI signal) कम होता है और कठिन डिटेक्टरों के खिलाफ संभावना बेहतर होती है। डिटेक्टर लगातार retrain होते रहते हैं, इसलिए कोई भी परिणाम स्थायी (permanent) नहीं होता। हम वही बताते हैं जो testing में सामने आया, और हम कभी यह दावा नहीं करते कि टेक्स्ट हमेशा undetectable रहेगा।
प्र: क्या यह हिंदी, तमिल, बंगाली और अन्य भारतीय भाषाओं के लिए काम करता है?
हाँ। ह्यूमनाइज़र 60 से अधिक भाषाओं को सपोर्ट करता है। आप जिस भाषा में सोचते हैं, उसी में मसौदा बना सकते हैं, फिर उसे शैक्षणिक अंग्रेज़ी में ले जा सकते हैं, और भाषा-संवेदनशील (language-aware) मॉडल आपकी वाक्य-रचना और अर्थ को सुरक्षित रखता है। यह हिंदी, तमिल, बंगाली, तेलुगु, मराठी और अन्य पहली भाषाओं से जुड़े वे आम हस्तक्षेप (interference) पैटर्न संभालता है।
प्र: क्या मैं इसे अपने DST-SERB या CSIR ग्रांट से भुगतान कर सकता/सकती हूँ?
भाषा-संपादन अधिकांश भारतीय फंडिंग निकायों के अंतर्गत मान्यता प्राप्त, अनुमेय खर्च है, जिनमें DST-SERB, CSIR, ICMR, और DBT शामिल हैं। संपादन और humanizing सॉफ़्टवेयर की subscriptions सामान्यतः अनुमेय शोध-खर्चों के दायरे में आती हैं। यह सुनिश्चित करने के लिए अपने ग्रांट की विशिष्ट शर्तें (terms) जांचें।
प्र: मेरे उद्धरण और तकनीकी शब्दों का क्या होगा?
वे ठीक वहीं बने रहते हैं जहाँ आप उन्हें रखते हैं। ह्यूमनाइज़र लय और शब्द-चयन में विविधता लाता है तथा repetitive cadence को हटाता है, लेकिन आपका अर्थ, आपकी तकनीकी शब्दावली, और हर उद्धरण सुरक्षित रहता है। सबमिट करने से पहले आप परिणाम की समीक्षा करते हैं।
अपना आशय, शब्दावली, और उद्धरण बनाए रखें। लय (रिदम) को बदलें, ताकि पहचानकर्ता फ्लैग कम करें। यह उन भारतीय शोधकर्ताओं के लिए बनाया गया है जो अंग्रेज़ी को दूसरी या तीसरी भाषा के रूप में लिखते हैं।

मो प्राकृतिक भाषा प्रसंस्करण में PhD वाला एक NLP इंजीनियर है। उनके शोध में कम्प्यूटेशनल भाषाविज्ञान, पाठ विश्लेषण और मशीन लर्निंग शामिल है, और यह सीधे ProofreaderPro के पीछे संपादन और मानवीकरण मॉडल में शामिल है। वह प्रक्रिया के उस हिस्से के बारे में लिखते हैं जिसे ज्यादातर लोग कभी नहीं देखते हैं: कैसे एक भाषा मॉडल एक वाक्य को पढ़ता है, उसे स्कोर करता है, और निर्णय लेता है कि क्या बदलना है।


