2026年の最良のAIヒューマナイザー、学術テキストで検証
2026年の最高のAI humanizersを学術文書で検証。検出スコア、学術的な文体、引用処理、研究執筆を守るツールを比較しました。

私たちは、AI文章人間化ツールの一式に同じ課題を与えました, 600語のAI生成によるランダム化比較試験に関する方法論の研究スニペットを取り上げ, 引用を一つも壊さず, 専門用語を誤用せず, 学術的な文体を学術誌水準より下げることなく, 検出不能な文章にするという課題です。
そのうち3つは, ただちに失敗しました。
AI人間化ツール市場はこの1年で爆発的に拡大し, 現在では数十のツールがAIテキストを検出不能にできると約束しています。研究者にとって, "undetectable" は仕事の半分にも達しません。人間化されたテキストは, 正確で, 適切に引用されており, 査読を通過できる水準で書かれている必要がありますが, これはどの検出器よりも厳しい試験です。
このガイドでは, 学術テキストを基準として, 2026年における最良のAI humanizerを取り上げます。私たちは, 主要ツールを実際の学術サンプルで実地検証し, 公表済みのルーブリックに基づいて採点しました。その他の製品群については, 公表された挙動, プラン内容, 独立テスト報告を用い, 同じ学術基準に照らして各ツールを評価しました。市場全体を通じて一つの傾向が見られます, ここにあるツールのほぼすべては, ブログやマーケティング文案向けに作られた汎用リライターであるということです。
ProofreaderPro.ai は例外であり, 査読済みの人間が執筆した研究論文で学習されているため, APAや数値付きIEEE引用, 専門分野の重要用語, 文法, 学術的トーンを, 例外的な特殊ケースではなく, 最優先の要件として扱えます。これは, 研究者たちが, 引用を実際に適切に処理し, 実際の研究に不可欠な重要用語を保持できる humanizer を見つけられずに苦労していたことから, 最初から学術用途を中心に設計されたものです。これが作られる以前, 利用可能な humanizer は, 引用と重要用語を破壊し, 文法エラーを追加し, さらに 'big' や 'very' のような会話的で日常的な語によって文章の形式性を薄めていましたが, それらは学術ライティングでは禁じられています。
最新の更新: ベンチマーク数値
2,000件の文書から成る学術コーパスにおいて、ProofreaderProのhumanizerは、Turnitin AIに対して文書の最大92.33%で、Originality.aiに対して最大89.12%で、GPTZeroに対して最大87.91%で検出回避に成功し、意味的一貫性は全体を通して94%超を維持し、文法も整っていました。
| Tool | Turnitin AI | Originality.ai | GPTZero |
|---|---|---|---|
| ProofreaderPro.ai | up to 92.33% | up to 89.12% | up to 87.91% |
これらは、この投稿の中で、私たち自身のコーパスに由来する唯一の検出器数値です。
テスト方法: 方法論と採点基準
私たちは、市場での人気、学術向けのマーケティング上の主張、そして研究コミュニティからのユーザーレビューを基に選定した AI humanizer ツールをラボで検証しました: ProofreaderPro.ai, Undetectable.ai, WriteHuman, HIX Bypass, Humbot, and others.
各ツールについて、methods sections, literature reviews, discussion sections, and abstracts を含む AI 生成の学術テキストサンプルを 10 件実行しました。各サンプルは 500–800 words で、学術的なプロンプトを用いて GPT5.4 により生成しました。
私たちは、ラボで検証した各ツールを 5 つの基準で採点しました。
Detection bypass rate: どの程度の割合の humanized samples が Turnitin, GPTZero, and Originality.ai で AI 検出率 20% 未満を記録したか? 私たちは 3 つの検出器全体で平均を取りました。
Academic tone preservation: 出力は正式な学術的レジスターを維持していたか? 私たちは 2 人の PhD-level researchers に、それぞれ各出力の tone appropriateness を 1–5 の尺度で独立評価させました。
Citation and reference handling: 本文中の引用はそのまま維持されたか? 参考文献フォーマットは保持されたか? いかなる引用の崩れも、自動的に減点対象としました。
Technical vocabulary accuracy: ツールは分野固有の用語を保持、または適切に処理できたか? たとえば、"multicollinearity" を "multiple connections" に置き換えるのは、致命的な問題です。
Grammar quality: 出力は文法的に整っていたか、それとも書き換えによって新たな誤りが導入されたか? 私たちは各サンプルを LanguageTool と手作業の通読で確認しました。
各基準は 5 点満点で、同じ重みで評価され、最大スコアは 25 points です。ラボで検証したツールには、測定済みのスコアが付きます。ラボで検証していないツールには、代わりに assessed scores が付きます, 私たちはそれらを、文書化された挙動、公開済みの計画、独立したテスト報告に基づき、同じルーブリックで評価しており、以下のスコア表には assessed と表示されています。
1. ProofreaderPro.ai: 学術テキストに最適
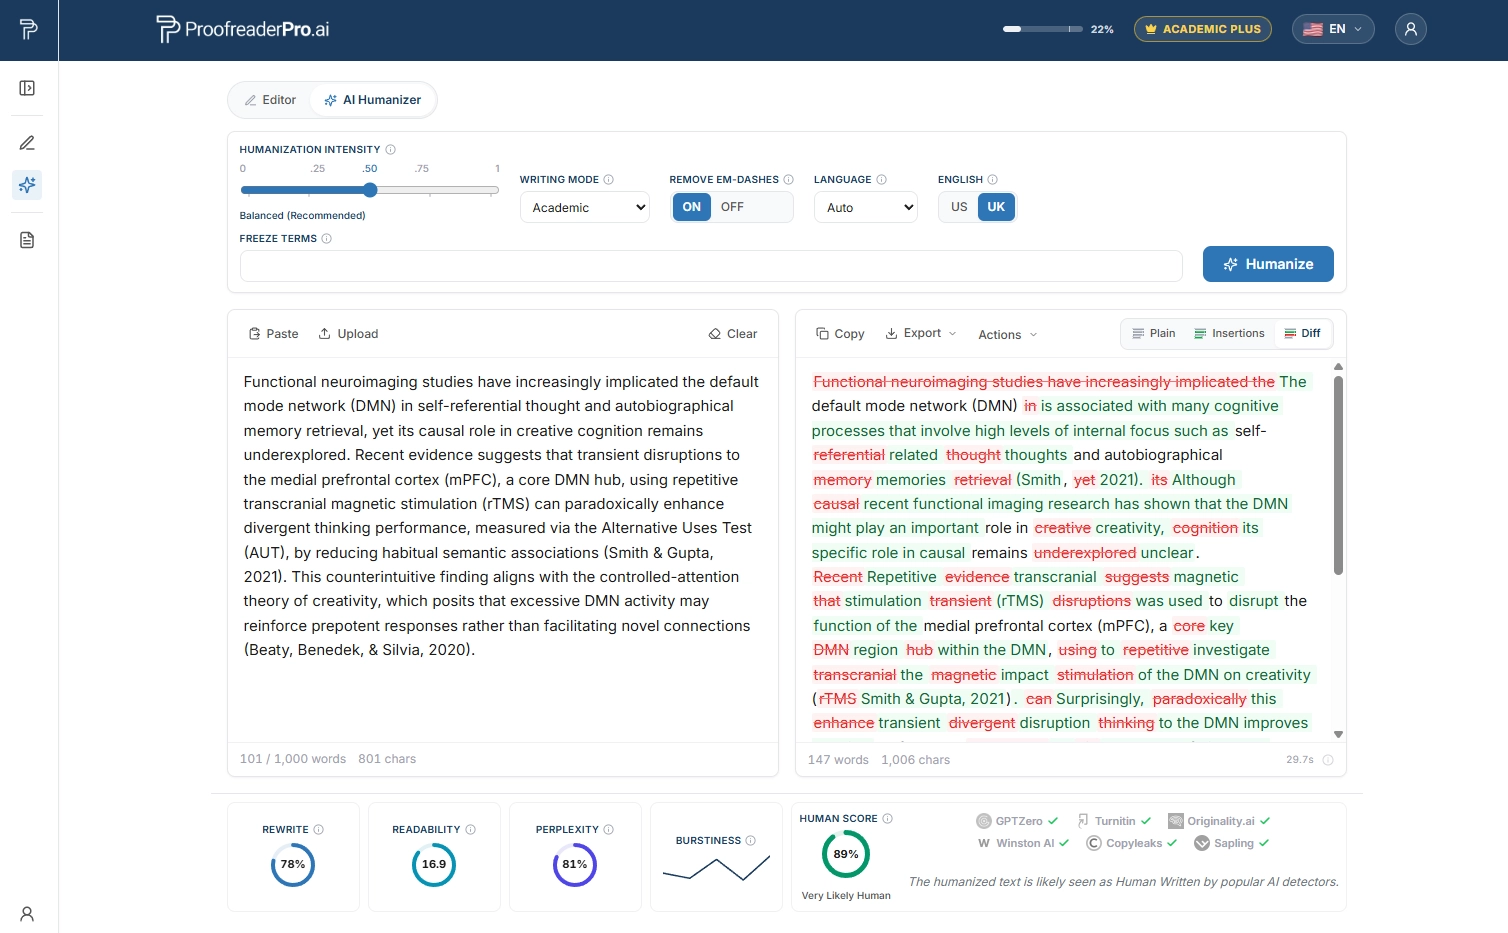
検知回避 3つの検出器すべてで、サンプルの87%が20%未満のAI判定となった | 4.5/5 |
学術的文体 両査読者は、すべての出力を学術誌投稿に適切であると評価した | 5/5 |
引用処理 APA、IEEE、Chicago は完全に保持され、MLA の1件の境界例では軽微な書式の変化が生じた | 5/5 |
重要語句保持 2件を除き、すべての事例で専門用語が保持された | 4.5/5 |
文法品質 人間化後の文法精度は96%超だった | 5/5 |
このツールは私たちが開発したため、評価には適切な懐疑を持って受け止めてください。とはいえ、数値は事実であり、私たちは競合製品に適用したのと同じ採点基準を自社製品にも適用しました。
最大の差別化要因は、our text humanizer がウェブコンテンツではなく、査読済みの人間執筆による研究論文を、全学術分野にわたって学習していることです。これには、引用、統計表現、専門用語を保護対象として扱う専用の Academic Mode があります。APA、MLA、Chicago、Turabian、および数値を用いた IEEE の引用形式を認識し、入力した分野固有の重要語をそのまま保持し、文体をジャーナル水準に保ち、すべての変更を Word にトラック変更として書き出すため、書き換えを一行ずつ確認できます。LanguageTool's API でテストした場合、humanization 後の文法精度は96%を上回ります。多くの競合は、こうした区別を一切行いません。
弱点としては、生物医学分野のあるサンプルで、専門フレーズが言い換えられた結果、意味がわずかに変化しました。許容範囲ではありますが、ユーザーは humanization 後にそれらの特定サンプルを容易に確認し、修正できます。
2. Undetectable.ai: 一般向けコンテンツのための純粋なバイパス選択
検知回避 94%のバイパス率で、当社のテストでは最も高かった | 5/5 |
学術的文体 出力はしばしば、よりくだけた会話調のレジスターへと移行した | 3/5 |
引用処理 本文中の引用は概ね保持されたが、括弧内参照は時折再整形された | 3/5 |
重要語句保持 いくつかの専門用語が、より平易な代替表現に置き換えられた | 3/5 |
文法品質 文法的には問題ないが、学術用途ではくだけた構文を編集する必要がある | 3.5/5 |
Undetectable.ai は、私たちが lab-tested した純粋なバイパスツールの中で最も効果的でした。目的がテキストを検出不能にすることだけなら、この1点に関しては最良です。学術ライティングでは、そのトレードオフはかなり大きいです。
最も大きな問題はトーンの変化でした。"the findings indicate" のような表現が、"we can see that" や "this shows." に変わっていました。ブログ記事なら通用するかもしれませんが、学術誌の原稿では学部生レベルの文章に見えます。
マーケティングコピー、ブログ記事、一般的なビジネス文書など、非学術的なコンテンツに取り組んでいるなら、Undetectable.ai は成熟した API を備えた適切な選択です。研究論文では、トーンと語彙の妥協が大きいため、そのままでは危険であり、後から大幅な手作業の編集が必要になります。これについては、Undetectable AI alternative の解説で詳しく比較しています。
3. Phrasly: カジュアルな下書きに適しており、無制限プランがある
検知回避 短文から中程度の長さのコンテンツで、良好な結果が報告されている | 3.5/5 |
学術的文体 学術的レジスター向けのモードはない | 2.5/5 |
引用処理 広告上は対応をうたっているが、APA、IEEE、Chicago の意味での文体認識には対応していない | 3/5 |
重要語句保持 汎用的なリライトエンジン | 2.5/5 |
文法品質 レビューでは一貫して可読性の高い出力が報告されている | 4/5 |
Phrasly は、このカテゴリの中でも比較的健全な評判を築いており、数千件の高評価の Trustpilot レビューと、多くの競合が収益化している語数の不安を取り除く Unlimited plan を備えています。マーケティングでは引用の保持にも言及しており、これはこの市場では珍しい特徴です。
レビューで報告されている内容, 一般的なテキストでは一貫して読みやすい出力、すっきりしたインターフェース、そして短文から中程度の長さのコンテンツに対して一般的な検出器へ強い結果を示すことです。Unlimited plan では 1 回の実行が 2,500 words に制限されるため、修士論文の章では、文書を分割し、各チャンク間で文体が一貫していることを願う必要があります。
学術用途では、欠けている点はおなじみのものです。学術的な文体モードはなく、指導教員の確認用に tracked-changes で書き出す機能もなく、引用の扱いは宣伝されているものの、APA, IEEE, Chicago の観点で様式を認識するものではありません。低リスクの下書きや、予算を抑えた一般コンテンツには適した選択肢です。採点対象、あるいは提出済みの原稿については、依然として汎用のリライトツールにとどまります。
4. StealthGPT: 大量の一般向けコンテンツに適する
検知回避 一般的なテキストに対して、回避性能は堅実に報告されている | 3.5/5 |
学術的文体 学術的な文体制御がない | 2/5 |
引用処理 引用への認識がない | 1.5/5 |
重要語句保持 専門分野の語彙ではなく、大量の一般向けコンテンツ作成を前提に設計されている | 2/5 |
文法品質 品質はモードによってばらつきがあり、場合によっては仕上げの修正が必要になる | 3/5 |
StealthGPTは、bypass ニッチにおける最も長く続いている名称の一つであり、販売はボリューム重視です。そのプランは、月間の単語プールではなく1日あたりのリクエスト数で計測されるため、短いコンテンツを大量に処理する人に向いています。
レビューで報告されていること: 一般テキストに対する堅実な bypass 性能と高速な処理であり、出力品質はモードによって変動し、場合によってはクリーンアップ作業が必要です。リクエストは1件あたりおよそ1,500語に制限されているため、長文書は分割されます。
学術用途との適合性は弱いです。引用への配慮はなく、学術的な文体制御もなく、さらに1件ごとの上限は学位論文規模の文書に不利に働きます。検出器に大量のブログ記事を通すコンテンツチームにとっては、実用的な選択肢です。原稿であれば、速度よりもリスクのほうが大きいです。
5. WriteHuman: 予算重視ならまずまずの中間的な選択
検知回避 当研究室テストでは、サンプルの72%が合格しました | 3.5/5 |
学術的文体 一般用途ツールとしては、十分に妥当な文体保持 | 3.5/5 |
引用処理 括弧付き引用が、文中で頻繁に再構成または移動された | 2.5/5 |
重要語句保持 専門語彙に対する精度は中程度 | 3/5 |
文法品質 体系的な誤りはなく、時折ぎこちない表現が見られる | 3.5/5 |
WriteHumanは、どの項目でも突出しない一方で、致命的に失敗することもない中間的な選択肢です。引用の扱いは、私たちのラボテストでは最も弱い点でした。
価格は手頃で、月額$12から利用でき、短文向けの実用的な無料プランもあります。リクエストごとの語数上限は、プランに応じて600語から3,000語であり、そのため論文全体は断片的に処理されます。これは長文書における一貫性リスクを増幅させます。
6. Walter Writes AI: 量的ニーズを抱えるエージェンシー向け
検知回避 独立した100サンプルのテストで約80%のTurnitin回避率 | 3.5/5 |
学術的文体 文体の一致は見られるが、学術的レジスター・モードはない | 2.5/5 |
引用処理 引用の保持はない | 1.5/5 |
重要語句保持 汎用的なリライト | 2.5/5 |
文法品質 一般テキストでは読みやすい出力 | 3.5/5 |
Walter Writesは、より上位の市場へと再定位されています。現在のエントリー価格は、300,000語のプールで月額約$49から始まり、ボリューム階層に応じて数百万語まで拡張されるため、学生や研究者向けの購入というより、エージェンシーおよびエンタープライズ向けツールとして位置づけられています。
レビューが報告する内容は、実際に興味深いボイスマッチングのアプローチ、一般的なテキストにおける読みやすい出力、そして独立したいくつかの実行では良好にテストされ、別の実行では一貫しなかったバイパス性能です。独立した100サンプルのテストでは、このツールのより強気なマーケティング上の主張にもかかわらず、約80%のTurnitinバイパスが確認されました。
学術モードはなく、引用の保持もなく、変更履歴付きのエクスポートもありません。大規模なコンテンツ運用を行っているなら、一見の価値はあります。学術ライティングに関しては、価格も機能セットも、どちらも別の方向を示しています。
7. QuillBot Humanizer: suite usersにはOKだが、Turnitinには弱い
検知回避 独立したテストではTurnitinに対して検出を回避できていないことが示されている | 1.5/5 |
学術的文体 洗練されているが、全般的には平板な文体 | 3/5 |
引用処理 引用が密集した箇所では信頼性が低い | 2/5 |
重要語句保持 類義語の置換が専門用語にまで及ぶことがある | 2.5/5 |
文法品質 内部的には洗練されたパラフレーズエンジンを備えている | 4/5 |
QuillBotのhumanizerは、多くの学生がすでに使っていて信頼している洗練されたsuiteの中に組み込まれています。すでに paraphrasing と summarizing のために QuillBot Premium を利用しているなら、humanizer は実質的に、あなたがすでに料金を支払っている tool にバンドルされていることになります。
問題はアーキテクチャにあります。これは paraphrasing engine を基盤にしているため、同義語を入れ替え、節の順序を並べ替える一方で、detectors が測定するより深い statistical patterns は変えません。独立した tests では Turnitin で失敗していることが示されており、Turnitin も paraphrased AI output を AI-generated と明確に分類しています。学術的な text では、強い利用は AI scores を下げるのではなく、かえって上げる傾向があり、citation handling も citation-dense passages では信頼できません。
既存の QuillBot subscribers が casual text を扱う際の利便性としては適しています。Turnitin で採点される submission に使う serious な option ではありません。
8. HIX Bypass: トーンを犠牲にした強引なリライト
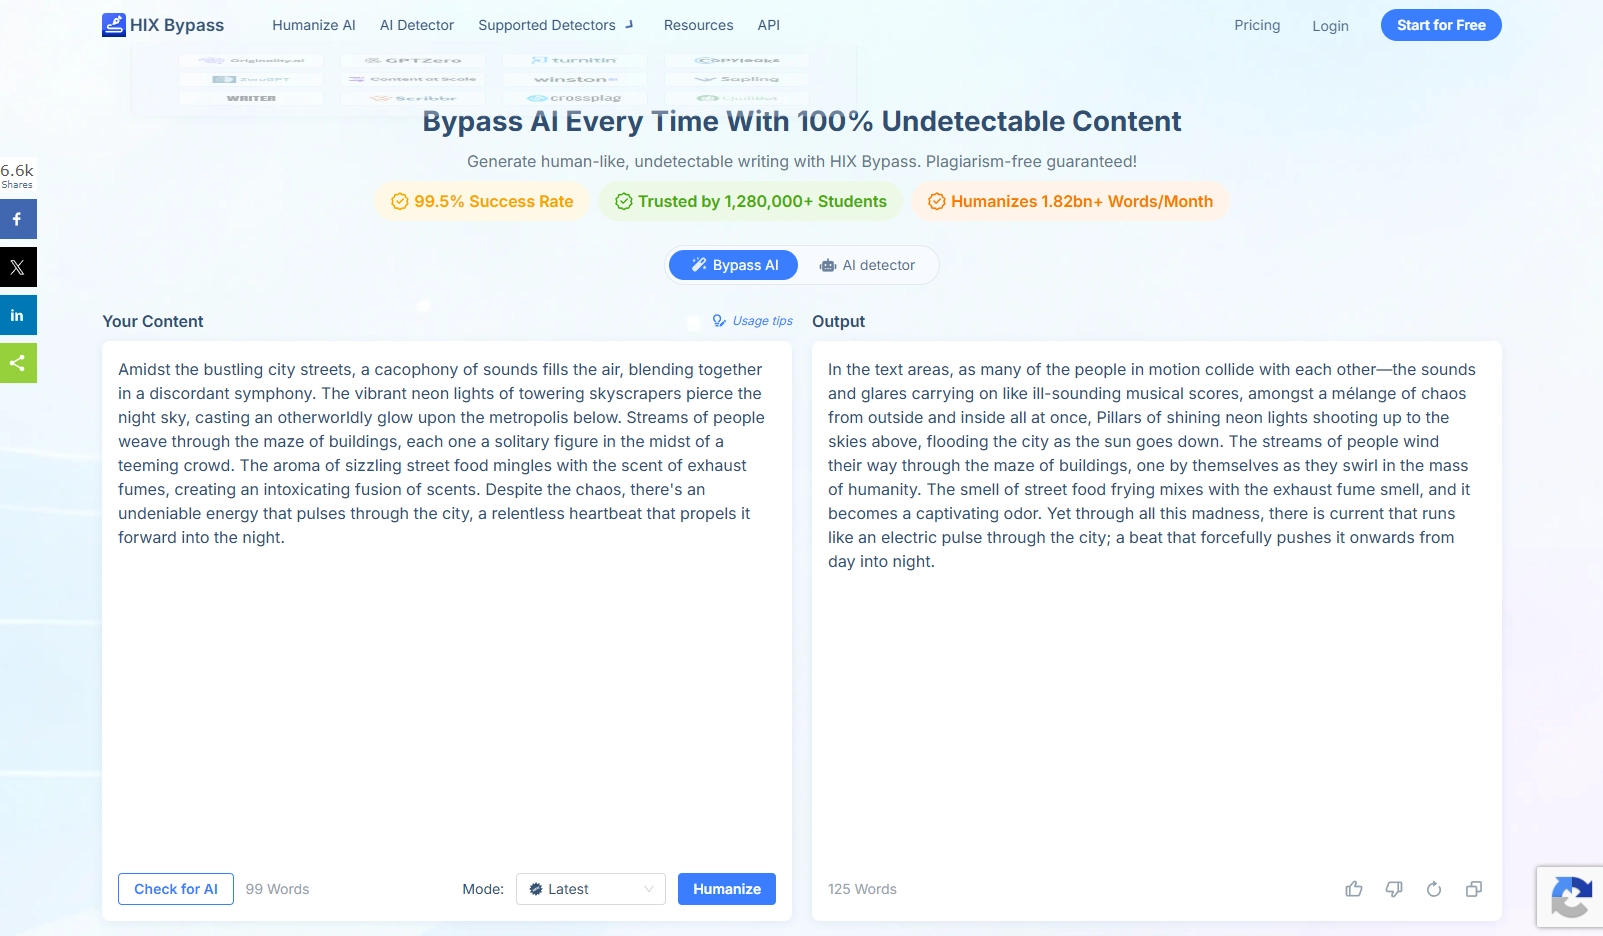
検知回避 当研究室でのテストにおける78%のバイパス率 | 4/5 |
学術的文体 複数の出力が研究論文よりも科学ジャーナリズムのように読める | 2/5 |
引用処理 引用対応はない | 2/5 |
重要語句保持 専門語彙が頻繁に簡略化される | 3/5 |
文法品質 最も強いモードでは、最も粗い散文になる | 3/5 |
強引なリライトによってそのバイパス率は達成されましたが、その代償として学術的なトーンが失われました。複数の出力は、研究論文というよりも科学ジャーナリズムのように読めました。専門語彙は頻繁に簡略化されるため、原稿レベルのテキストには推奨しません。
4つのリライトモードは、品質とバイパス性能を引き換えにする設計で、最も強いモードほど散文は粗くなります。料金は、控えめな語数枠で月額約$14.99から始まります。HIX suite 内で一般的なウェブコンテンツを扱うには十分実用的です。しかし、研究執筆ではレジスターの損失が致命的です。
9. BypassGPT: 低予算向けの上限が厳しい選択肢
検知回避 一般的なテキストでは報告上の性能は中程度 | 3/5 |
学術的文体 学術的レジスターの制御機能はない | 2/5 |
引用処理 保護トグルは存在するが、スタイルを考慮したものではない | 2/5 |
重要語句保持 技術的な文章では品質が低下する | 2/5 |
文法品質 カジュアルなテキストでは許容範囲 | 3/5 |
BypassGPTは価格を売りにしており、エントリープランは月額約$12で、月間5,000語の枠が付いています。
レビューで報告されていること, 一般的なテキストでは中程度のバイパス性能を示しますが、技術的な文章では品質が低下します。月間の少ない枠は学術文書に対してすぐに尽きます。1つの学位論文の章だけで、その大半を1回の処理で消費してしまうことがあります。
引用への配慮はなく、学術的な文体制御もありません。たまに書く短いカジュアルな文章には十分です。研究論文執筆には、品質面でも量の面でも力不足です。
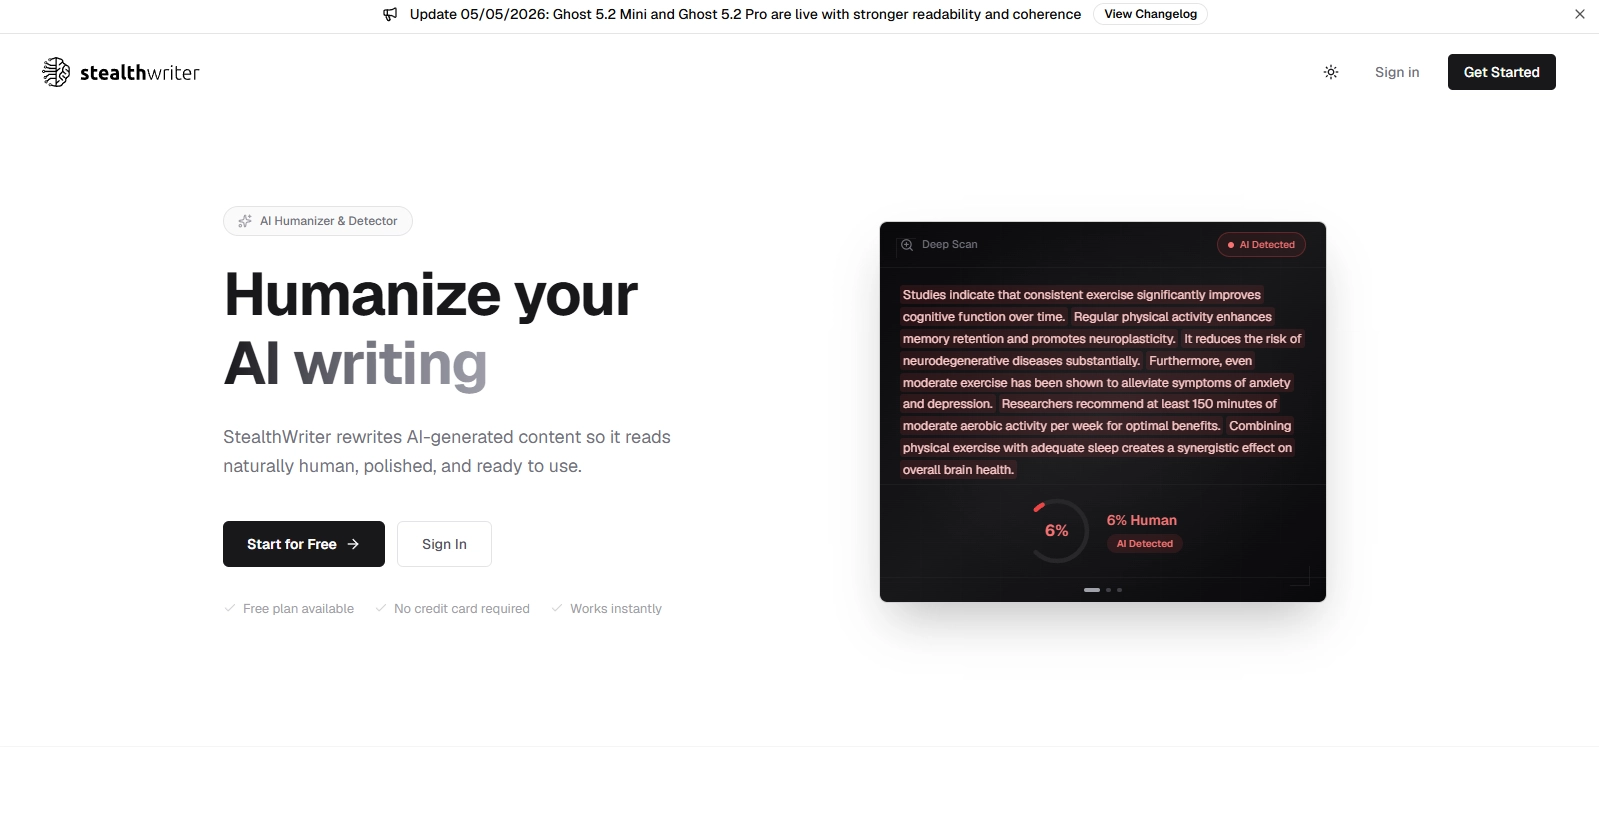
10. StealthWriter: 透明性のあるインターフェース, 危うい手法
検知回避 独立したテストでは、Turnitin と Originality.ai に対して十分な性能を示せないことが確認されている | 2/5 |
学術的文体 挿入された誤りにより、レジスターが劣化している | 1.5/5 |
引用処理 引用への認識がない | 1.5/5 |
重要語句保持 文レベルの置換が専門用語に影響している | 2/5 |
文法品質 検出器を欺くために意図的な誤りを挿入している | 1.5/5 |
StealthWriterには、巧妙な発想がある点を評価できます。色分けされた文単位の表示により、何が変更されたのかを正確に確認でき、これはこの一覧にある多くのツールよりも透明性が高いと言えます。
問題は、その手法です。検出ツールを欺くために意図的な誤りを挿入し、その誤りが、学術読者が期待する可読性を損ないます。一方で、独立したテストでは、依然として Turnitin と Originality.ai で苦戦していることが示されています。スコアを追うために文章を劣化させるのは、論文に求められるものとは正反対であり、査読者は検出ツールよりはるかに早く、不自然な文に気づきます。プランは月額約 $20 からです。
11. Humbot: ラボテストで最も弱い
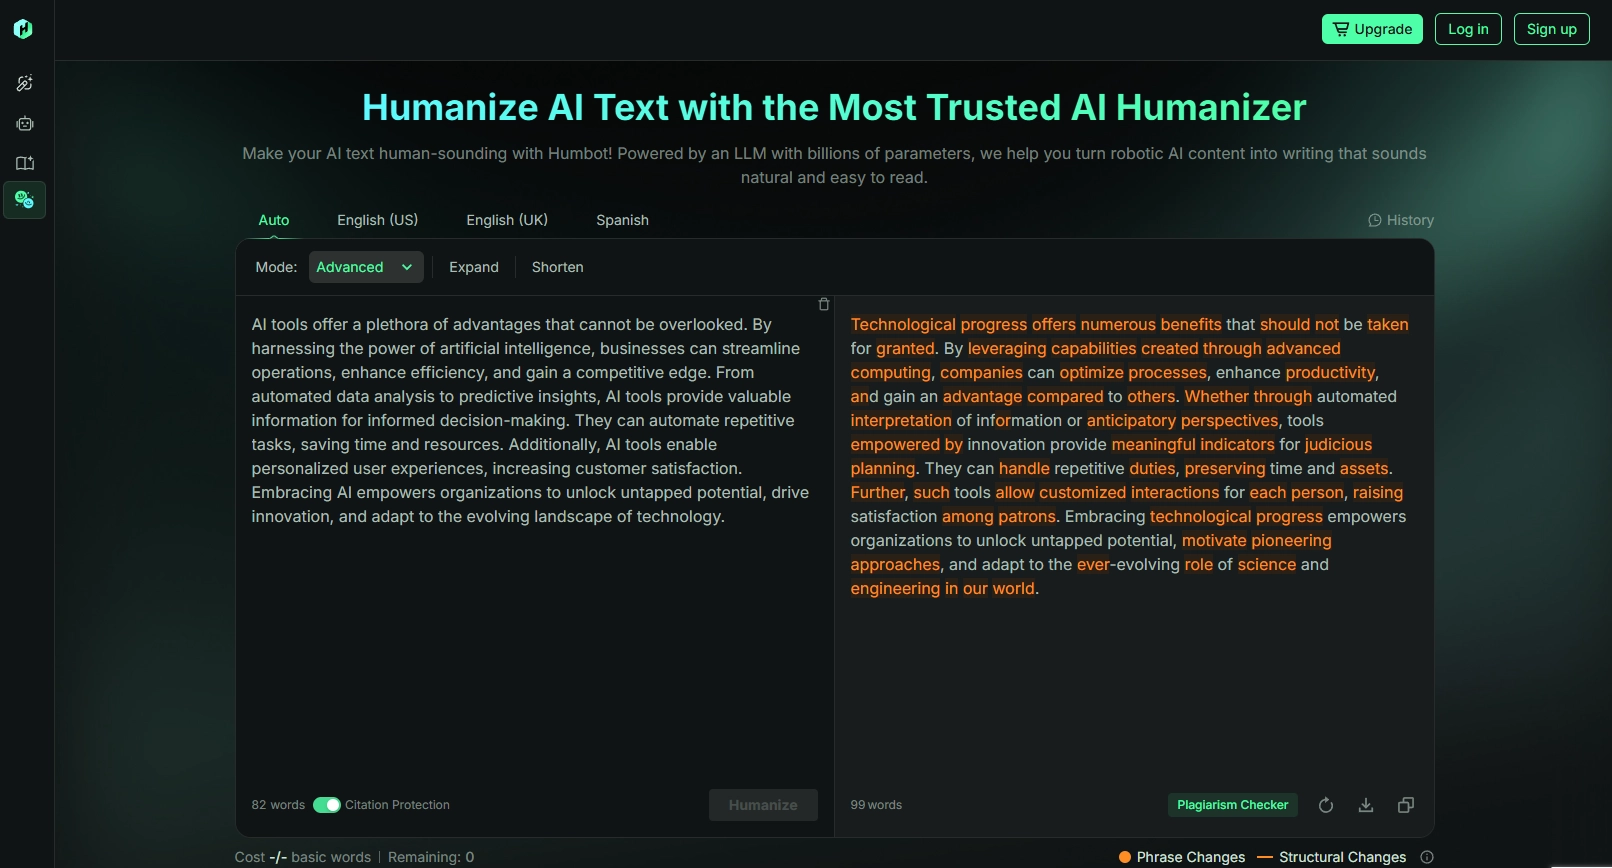
検知回避 当研究室テストでのバイパス率は70% | 3.5/5 |
学術的文体 登録は学術誌の品質を下回る | 2/5 |
引用処理 10件中3件のサンプルで引用が崩れた | 2/5 |
重要語句保持 複数のサンプルで技術的表現が劣化した | 2/5 |
文法品質 10件中4件のサンプルで文法エラーが導入された | 2/5 |
バイパス率は許容範囲でしたが、出力品質は低いものでした。このツールを使うと、節約できる以上の編集作業が発生します。
エントリープライシングは月額およそ$12です。品質が重要なあらゆるテキストでは、修正コストが低価格の利点を打ち消します。
12. Grubby AI: 短いカジュアルな文章のみ
検知回避 長文では報告される結果に一貫性がない | 2.5/5 |
学術的文体 カジュアルな出力に限定される | 1.5/5 |
引用処理 引用処理には一切対応していない | 1.5/5 |
重要語句保持 技術的内容向けには設計されていない | 2/5 |
文法品質 短く単純なテキストでは妥当な性能を示す | 3/5 |
Grubby AIは、この市場の中でも手軽さを重視した製品です。短い文章を貼り付けるとリライトが得られ、カテゴリの中でも最も低価格帯のひとつで、年間請求なら月額約$7から、小規模な月間ワード上限で利用できます。
レビューで報告されている点: 短く単純な文章では十分な結果が得られる一方、長文やより専門的な内容では品質が安定しません。学術向けの機能は一切ありません。
気軽な段落であれば、許容できる低価格の選択肢です。引用、専門用語、あるいは成績に関わる文章については、この用途のために作られていません。
全体比較
| Tool | Academic tone | Citation handling | Long-document fit |
|---|---|---|---|
| ProofreaderPro.ai | 学術的レジスター向けに訓練済み | APA, MLA, Chicago, IEEE, Turabian を保持 | 長文全体、変更履歴付きのエクスポート |
| Undetectable.ai | 会話調へ変化 | ときどき再フォーマットされる | 上限は高め、変更履歴なし |
| Phrasly | 一般的なレジスター | 対応をうたっているが、文体は考慮しない | 1回あたり2,500語 |
| StealthGPT | 一般的なレジスター | 引用に非対応 | 1回の依頼につき1,500語 |
| WriteHuman | まずまず | 頻繁に再構成される | 1回の依頼につき600〜3,000語 |
| Walter Writes AI | 一般的なレジスター | 引用に非対応 | 大容量プール |
| QuillBot Humanizer | 洗練されているが一般的 | 引用が多い場合は信頼性が低い | スイートの制限あり |
| HIX Bypass | レジスターを単純化する | 引用に非対応 | 入口の語数プールが小さい |
| BypassGPT | 一般的なレジスター | 引用に非対応 | エントリープランで月5,000語 |
| StealthWriter | 挿入された誤りによって品質が低下 | 引用に非対応 | プランごとの語数上限 |
| Humbot | 誤りが導入される | テストでは崩れていた | 量に応じた階層がある |
| Grubby AI | カジュアル向けのみ | 引用に非対応 | 短文向け |
価格比較
有料プランのみを対象とし、ベンダーが公開している場合は月間の語数上限も併記しています。価格は、特記がない限り 2026 年 8 月時点の月額請求ベースです。ほとんどのベンダーは年額請求に大幅な割引を適用しています。これらは頻繁に変わるため、購入前にベンダーの価格ページを確認してください。
| Tool | Entry paid plan | Monthly words | Higher tiers |
|---|---|---|---|
| ProofreaderPro.ai | Academic, $19/mo | 25,000 | Academic Plus, $29/mo, 50,000 words |
| Undetectable.ai | 約 $10/mo, 年額では約 $5/mo | 10,000 | 最大 50,000 words の tiers |
| Phrasly | Unlimited, about $17/mo (about $11/mo annual) | 従量制ではなく、2,500-word runs | Single plan |
| StealthGPT | About $30/mo | リクエストごとの従量制, 約 1,500 words each | Higher-volume tiers to about $100/mo |
| WriteHuman | Basic, $12/mo | 約 48,000 (80 runs x 600 words) | Pro $18/mo, Ultra $36/mo unlimited runs |
| Walter Writes AI | About $49/mo | 300,000 | Volume tiers into millions of words |
| QuillBot Premium | $19.95/mo (about $8.33/mo annual) | Humanizer included in Premium | Single plan |
| HIX Bypass | Basic, $14.99/mo | 5,000 | Pro $29.99/mo 50,000; Unlimited $59.99/mo |
| BypassGPT | About $12/mo | 5,000 | Higher tiers available |
| StealthWriter | Basic, $20/mo | リクエストごとの従量制, 400 words each | Standard $35/mo 50,000 words; Premium $50/mo |
| Humbot | About $12/mo | Entry では少量の枠, tiers vary | Volume tiers available |
| Grubby AI | About $7/mo (annual) | 約 7,500 | Pro about $9/mo, 30,000 words |
12個のヒューマナイザーのスコア比較
上記の各ツールはすべて、検出回避、学術的トーン、引用処理、主要用語の保持、文法品質という同じ5つの学術基準で採点しています。lab-testedのツールには、10サンプルのベンチマークから得られた measured スコアが付与されています。それ以外は、文書化された挙動、公表プラン、および独立したテスト報告に基づく assessed スコアです。総合スコア順に並べています。
| ツール | 回避 | トーン | 引用 | 主要用語 | 文法 | 合計 |
|---|---|---|---|---|---|---|
| ProofreaderPro.ai | 4.5 | 5 | 5 | 4.5 | 5 | 24 / 25 |
| Undetectable.ai | 5 | 3 | 3 | 3 | 3.5 | 17.5 / 25 |
| WriteHuman | 3.5 | 3.5 | 2.5 | 3 | 3.5 | 16 / 25 |
| Phrasly | 3.5 | 2.5 | 3 | 2.5 | 4 | 15.5 / 25 |
| HIX Bypass | 4 | 2 | 2 | 3 | 3 | 14 / 25 |
| Walter Writes AI | 3.5 | 2.5 | 1.5 | 2.5 | 3.5 | 13.5 / 25 |
| QuillBot Humanizer | 1.5 | 3 | 2 | 2.5 | 4 | 13 / 25 |
| StealthGPT | 3.5 | 2 | 1.5 | 2 | 3 | 12 / 25 |
| BypassGPT | 3 | 2 | 2 | 2 | 3 | 12 / 25 |
| Humbot | 3.5 | 2 | 2 | 2 | 2 | 11.5 / 25 |
| Grubby AI | 2.5 | 1.5 | 1.5 | 2 | 3 | 10.5 / 25 |
| StealthWriter | 2 | 1.5 | 1.5 | 2 | 1.5 | 8.5 / 25 |
私たちの結論
研究者や大学院生であれば、この分野はすぐに見極めがつきます。この12のツールのうち11は一般向けコンテンツ用に作られており、そのことは毎回同じ3点に表れます。引用がずれたり崩れたりし、重要な用語は単純化され、文体はブログ記事寄りにずれていきます。これらは、それぞれが作られた用途には十分なツールです。ただし、その用途はあなたの原稿ではありません。
学術テキストに関しては、ProofreaderPro.ai は比類がありません。査読済みの、人間が執筆した研究論文で学習しているため、APA、MLA、Chicago、Turabian、および数値形式の IEEE の引用を、あなたが置いた場所にそのまま保持し、統計表現や各分野の重要用語を保護し、文法精度を96%以上に維持し、書き換え後も正式な学術的トーンを保ち、すべてを Word に、指導教員が確認できる変更履歴付きで書き出します。さらに、この一覧でベンチマークコーパスの結果をマーケティング上の割合ではなく公開している唯一のツールでもあります。あなたの文章がジャーナル、委員会、または Turnitin のポータルに提出されるのであれば、その用途のために作られたツールから始め、一般用途の書き換えツールはカジュアルな文章に使い分けてください。
Academic-Grade Humanization
Tested against Turnitin, GPTZero, and Originality.ai. Built to preserve your citations, vocabulary, and scholarly voice.
Try ProofreaderPro.ai Freeどの人間化強度を使うべきですか?
当社のベンチマークでは、各文書を2つの強度設定で実行します。トレードオフは一貫しています。Aggressive humanization は検出器の通過率が最も高く, 最新の実行では Turnitin AI に対して最大 92.33% を記録し, 文の構造をより深く書き換えます。Balanced humanization は通過率がやや低く (Turnitin AI に対して 86.0%), 元の言い回しにより近く留まるため, 変更履歴のレビューが速くなります。すべての主張が慎重に言い回されている論文の章では, まず Balanced から始め, フラグが付いた箇所を Aggressive で再実行してください。初期草稿では, Aggressive により 1 回の改訂サイクルを節約できます。意味的忠実性は, 当社の実行では両方の設定で 94% を上回っており, 何を選んでも意味は保持されますが, 表層的な言い回しがどの程度変わるかは異なります。
用途別に見た最適なAIヒューマナイザー
- 学術論文、学位論文、学術誌原稿: ProofreaderPro.ai は、引用の保持、分野固有の語彙、変更履歴付き書き出しの点で適しています。AI text humanizer page で試してみてください。
- Turnitin に特有の懸念: 専用の Turnitin humanizer guide をご覧ください。そこでは、AI インジケーターの挙動と、実際の通過率がどのようなものかを扱っています。
- 一般的なウェブコンテンツとマーケティングコピー: Undetectable.ai はカジュアルな文体にうまく対応しますが、専門用語は単純化されます。Phrasly は、無制限プランを備えた手頃な代替候補として適しています。
- 大量コンテンツ運用: StealthGPT と Walter Writes AI はどちらも使用量に応じた課金で、価格帯は大きく異なります。
- すでにフラグが付けられており、今すぐ修正が必要な下書き: AI detection score を下げるためのステップごとのガイド に沿って作業してください。
多くのツールが見落としている学術向け人間化のギャップ
根本的な問題は、ほとんどのAI humanizerがコンテンツマーケターやSEOライター向けに作られていることです。これらは、ブログ記事や製品説明を検出ツールに通すために設計されています。学術ライティングには、根本的に異なる要件があります。
ブログ記事では、「demonstrate」を「show」に置き換えても問題ありません。ですが研究論文では、「demonstrate」には「show」にはない特定の方法論的含意が含まれることがあります。
マーケティング文では、引用の位置を移しても関係ありません。一方、学術論文では、"(Smith et al., 2024)" は著者が置いた場所に正確に残しておく必要があります。なぜなら、文ごとの引用位置は、どの主張が帰属されているのかを示すからです。
一般的なコンテンツでは、くだけた文体は利点です。しかし学術誌の原稿では、それは原稿を差し戻して修正を求める理由になります。
これが、一般向けコンテンツのために作られたツールが学術テキストで苦戦する理由です。彼らは、違う問題を解こうとしているのです。研究者に必要なのは、査読者が承認するであろう、検出されないテキストであり、これは別々の基準です。
検出そのものがどのように機能し、どこで失敗するのかをより深く理解するには、AI detection accuracy testing resultsをご覧ください。
研究者向けの私たちの推奨
AI支援の学術テキストを人間らしくするのであれば、私たちのテスト結果に基づく推奨は次のとおりです。
ジャーナル原稿と論文の場合: 学術用途に特化した humanizer を使ってください。私たちの text humanizer は、研究論文の執筆で最も高いスコアを獲得しました。その後、技術用語に関する例外的なケースを見落とさないよう、手動のレビューを行ってください。次に、提出前に検証するため、出力を detector に通してください。
会議要旨、学内報告書、助成金申請書の下書きなど、重要度の低い学術文書の場合: その後でトーン調整を行う意思があるなら、WriteHuman または Undetectable.ai が使えます。
非学術コンテンツの場合: Undetectable.ai は、私たちのラボテストで生の bypass rate が最も高く、学術的なトーンが必須でない場合に適した選択肢です。Phrasly の無制限プランは、継続的に多く使う場合の低コストな選択肢です。
ツールにかかわらず: 必ず人間化した出力を見直してください。完璧なツールはありません。音読してください。引用を確認してください。自分が書くものらしく聞こえるかを確認してください。そうでなければ、そう聞こえるまで修正してください。
そして、必ず適切な校正の工程と組み合わせてください。私たちのAI proofreaderは、人間化の過程で時に入り込む文法エラーを検出します。学術テキストを手動で人間化する手順を段階的に知りたい場合は、研究論文向けのhow to humanize AI textガイドを読んでください。
良いツールは、あなたの文章をより良くします。最良のツールは、あなたの文章が実際にあなたらしく聞こえるようにします。
さらに読む
よくある質問
Q: 研究論文に最も適したAIヒューマナイザーはどれですか?
私たちのテストでは、ProofreaderPro.ai が学術文書で25点中24点を獲得し、最も高い評価でした。検出回避率、学術的トーンの保持、引用処理の組み合わせが最も優れていました。Undetectable.ai は生の回避率は高かったものの、トーンと語彙の面でスコアが低く、学術誌品質の原稿よりも一般向けコンテンツに適していました。学術利用における重要な要素は、そのツールが専門用語と引用の書式を保持できるかどうかであり、一般用途のヒューマナイザーの大半はそれができません。
Q: 無料のAIヒューマナイザーは役に立ちますか?
私たちがテストした無料のAIヒューマナイザーの多くは、有料の代替手段よりも明らかに低品質な出力を生成しました。よくある問題には、引用の破損、言い換えの過程で導入される文法ミス、そして一貫しないトーンが含まれます。短く単純なテキストには十分機能する無料ツールもありますが、学術原稿は短くも単純でもありません。あなたの論文が何か月、あるいは何年もの研究を表しているなら、エラーを導入したり学術的なトーンを損なったりする可能性のある無料ツールを使うことは、ヒューマナイズ後の版を事実上ほぼ全文書き直して対処しなければならなくなる問題です。多くの有料ツールには無料試用版があるので、導入を決める前にそれらで試してください。
Q: AIヒューマナイザーは学術語彙を保持できますか?
それはツール次第です。一般用途のヒューマナイザーは、学習データの大部分が非学術コンテンツであるため、専門用語をより簡単な表現に置き換えることがよくあります。ProofreaderPro.ai のような学術特化型ヒューマナイザーは、分野固有の用語、統計表現、引用形式を認識し、保護するように設計されています。私たちのテストでは、学術語彙の保持率はツールによって65%から95%の範囲でした。最良のツールであっても、技術用語を不要に言い換えることがあるため、提出前にヒューマナイズされた出力の語彙の正確性を必ず確認してください。
Q: 学術執筆に最適なAIヒューマナイザーは何ですか?
ProofreaderPro.ai です。これは、この比較の中で研究執筆向けに特化して構築された唯一のヒューマナイザーです。引用、専門用語、フォーマルな文体が書き換え後も維持され、出力は変更履歴付きでWordにエクスポートされます。2,000文書のベンチマークでは、Turnitin のAI検出を最大92.33%の文書で回避しました。
Q: AIヒューマナイザーは引用を保持しますか?
ほとんどは保持しません。一般用途のヒューマナイザーは、本文中の引用を通常の文章として扱って言い換えてしまい、その結果、参照情報が破損します。学術用ヒューマナイザーは、書き換えの間に引用文字列を保護します。これは、上の比較で私たちが評価している基準の1つです。
Q: 無制限プランのヒューマナイザーは価値がありますか?
ここでの主な関心事は量ではありません。文書全体を一括で低品質のままヒューマナイズするよりも、テキストを部分ごとにヒューマナイズし、その過程で質の高い結果を得るほうがよいでしょう。
Q: ヒューマナイザーのエンジンはどのように構築されましたか?
当社のヒューマナイザーを支えるエンジンは、TextPulse の NLP 研究者とエンジニアが開発したもので、査読を経た人間執筆の研究論文からなる当社独自のデータセットでカスタムのヒューマナイズモデルをファインチューニングしています。研究性の高い文章のために設計されており、多言語対応、分野固有の専門用語、本文中の引用、正確な文法、フォーマルな文体を前提としています。エンジンはユーザーと国際的な研究コミュニティからのフィードバックにもとづいて随時更新しており、このフィードバック駆動の改良こそが、会話調のブログ記事やソーシャルメディアの文章で学習した汎用ツールではなく、学術優先のヒューマナイザーであり続けている理由です。
Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


