
ChatGPT、GPT-5.6以降のAI文を学術文体に自然化する方法
ChatGPT、ClaudeなどのAI文を自然な学術文体に整える方法。手動編集、ツール活用、Turnitin、GPTZero、Originality.ai対策を解説。

私たちは、500語のChatGPTによる段落を、主要なAI検出ツール3つにかけました。すると、どれもそれを95%以上AI生成だと判定しました。次に、同じ段落、同じアイデア、同じ事実、同じ論旨のまま人間らしく調整し、再提出しました。平均AI検出スコアは8%でした。思考の中身は何も変わっていません。変わったのは、AIの文章をいかにもAIらしく読ませる統計的パターンでした。
執筆にAIを使う研究者の多くは、ChatGPTを使っています。段落がうまくまとまらないとき、文献レビューに大まかな要約が必要なとき、あるいは方法のセクションを書き直すのが4回目になったとき、最初に開くツールです。ですから、人間らしくする方法は何かと問われたとき、通常はもっと具体的な意味になります。つまり、ChatGPTで作った下書きを、どうすればChatGPTらしく読めないようにできるのか、ということです。
このガイドでは、その問いに直接答えます。その過程で、一般的な方法についても扱います。つまり、人間らしくするとは実際にどういうことか、完全に手作業でどう進めるか、専用ツールを使う価値があるのはいつか、そして提出前に結果をどう確認するか、という点です。例はChatGPTとGPT-5.6ファミリーに焦点を当てていますが、同じ方法はClaude、Gemini、その他あらゆるモデルの文章にも使えます。
AIテキストをヒューマナイズする5つのステップの概要:
- 下書きを検出器にかけ、フラグの付いた箇所を特定する。
- その箇所を同義語の置き換えではなく、自分の構成と声で書き直す。
- 自分ならではの内容を戻す: 推論、データ、限界、引用。
- 長い箇所や手強い箇所には学術向けヒューマナイザーを使い、結果を読み返す。
- 2つの検出器で再チェックし、ポリシーが求める場合はAIの使用を申告する。
このガイドの残りでは、特にChatGPTの下書きについて各ステップを詳しく説明します。
AIテキストを人間らしくするとはどういう意味ですか?
AIテキストを人間らしくするとは、機械生成されたコンテンツを、人間が書いたように読める形へ変えることを意味します。単なる表層的な語の置き換えではなく、人間の文章に本来ある自然な不規則さ、語り口、リズムを取り戻すための、本質的な再構成です。
ChatGPTやClaudeに何かを書かせると、その出力は統計的なパターンに従います。どの文も予測可能な長さに寄りがちです。語彙は高確率で選ばれやすい単語に集中します。段落は一貫した構造をとり、主題文、補足の詳細、補足の詳細、結論、という流れになります。
人間の文章はそのようには機能しません。私たちは短い文を書きます。そして、その要点にたどり着くまで回り道をする長い文を書きます。意外な語を選び、論理を自分で中断し、確信が持てないときには留保を置き、強い感情があるときには強調します。その不規則さこそが検出ツールの注目する点であり、人間らしさを付与することで再導入されるものです。目標は、AIの支援を受けながらもあなた自身の本当の考えを含み、あなた自身が書くときと同じように読めるテキストです。
なぜ ChatGPT の文章は、GPT-5.6 であっても検出対象になるのか
新しいモデルは、2年前のモデルよりも優れた文章を書きます。とりわけ GPT-5.6 は、より整った文、露骨なつなぎ表現の少なさ、そして GPT-4 時代の出力よりも多様な段落の書き出しを生み出します。その改善は確かに本物であり、軽く読むだけの人には通用します。
しかし検出ツールは騙せません。その理由を理解する価値はあります。AI 検出器は、下手な文章を探しているわけではありません。彼らが見ているのは統計的な規則性です。すなわち、周囲の語から見て各語がどれほど予測しやすいかです。言語モデルは高確率の続き語を選ぶよう訓練されているため、その出力は、混乱度や burstiness のような指標で検出器が測定する、狭くて分散の小さい帯域に収まります。洗練された GPT-5.6 の段落は、急いで書かれた人間の文章よりも、むしろ予測しやすいことがあります。書き流しの流暢さと検出されやすさは、別の問題です。
だからこそ、モデルをアップグレードしてもフラグ付けの問題は解決しません。より高性能な ChatGPT は、より良い下書きを与えてくれますが、検出器が読む痕跡は、テキストそのものを変えるまで残ったままです。これがある検出器で具体的にどう起こるかについては、can Turnitin detect humanized AI text を参照してください。
AIテキストを検出可能にする3つのパターン
Turnitin、GPTZero、Copyleaksのような検出ツールは、同じ3つのシグナルを測定します。そのため、何に対して編集しているのかを正確に把握しておくことが有益です。
一様な文の長さ。 AI生成の段落は、文の長さが狭い範囲に集中する傾向があります。人間の文章ははるかにばらつきが大きく、4語の文の次に35語の文が続き、その次に12語の文が来る、といった具合です。
予測しやすい語彙。 AIは頻出の学術語に頼り、珍しい語や専門分野特有の語を避ける傾向があります。「important」「significant」「notable」が繰り返し現れ、専門家なら思いつくはずの、より正確で意外性のある語はほとんど見られません。
構造の反復。 AIの段落は同じテンプレートに従います。主張、補足、補足、転換、という流れです。人間の書き手はこれを崩し、ときには証拠から始め、ときには問いを立て、強調のために断片を用い、最初に結論を述べるのではなく、そこへ向かって論を組み立てます。
検出ツールは、これらを2つの指標に変換します。パープレキシティ, つまり語の選択がどれほど予測可能か, と、バーストネス, つまり文構造がどれほど多様か, です。パープレキシティが低く、バーストネスも低い場合、AIの兆候です。人間らしくするとは、その両方を人間の範囲へ戻すことを意味します。
GPT-5.6ラインアップ全体で実際に何が変わったのか
OpenAIはGPT-5.6を3つの階層で提供し、Sol、Terra、Lunaとして販売しています。Solは高速で低コストの階層で、多くの人が無料のChatGPTインターフェース経由で最初に触れるものです。Terraは中間に位置します。Lunaは、文献統合や構造化された議論のような長く技術的な作業を想定した、推論重視の階層です。
人間らしさの観点では、どの階層を使ったかはほとんど重要ではありません。3つはいずれも同じ目的で学習されており、統計的な特徴も共通しています。私たちの編集テストでは、考察セクションのLuna版下書きと同じセクションのSol版下書きは、長さを統制すると、検出器の範囲におおむね同程度で収まりました。上位の階層は、より賢い議論をもたらしましたが、より人間らしい文体をもたらしたわけではありません。どの階層からのChatGPT出力であっても、提出前には同じ人間化の手入れが必要なテキストとして扱ってください。
AIテキストを手作業で人間らしくする方法
手作業で全てをやり切ることは可能です。目安として、500語あたり15分から20分ほど見込み、成果の質は、どれだけ体系的に作業するかに左右されると考えてください。ツールを使わずに編集する際に、私たちが用いるのはこの手作業の方法です。
- 下書きを声に出して読み、単調さに印を付ける。 目は追いにくい一定の機械的なリズムも、耳ならすぐに捉えます。同じ長さに聞こえる文が3文以上続く箇所は、すべて印を付けてください。
- 印を付けた箇所でリズムを崩す。 3文目または4文目ごとに文を半分に切るか、具体例を1つ加えて長くし、文の長さが予測できないようにします。この1手で、検出器のスコアは、他のどの手作業編集よりも大きく動きます。
- 定型のつなぎ語を置き換える。 "Additionally," "Moreover," "It is important to note," そして "This underscores the importance of." を、より平易な接続表現、問い、あるいは何も置かない形にそれぞれ置き換えてください。
- 段落冒頭を組み替える。 AIは、ほぼすべての段落を宣言的なトピックセンテンスで始めます。1つは疑問文で始めてください。あるいはデータで。あるいは条件付きの言い方で。宣言的な冒頭が3つ続くと、検出器には要注意のサインであり、査読者には退屈の印象になります。
- 具体性を加える。 "The study found significant results" は、"Martinez et al. found a 23% reduction in error rate across all three conditions." になります。モデルは一般化し、人間は個別性に踏み込みます。
- 自分の分野の語彙を使う。 回帰について書くなら、"heteroscedasticity" は "unequal variance" より適切です。正確な専門用語は、検出器にも査読者にも、人間による執筆であることを示します。
- 自分の声を加える。 あなたなら曖昧にする箇所では曖昧にし("we suspect," "the data tentatively suggest")、強調すべき箇所では強調し("this is the critical finding")、テンプレートのように読める部分は並べ替えてください。
- 正確性を確認し、それからテストする。 編集の途中で、事実、引用、技術的主張にずれが生じていないか確認します。そのうえで検出器を回し、まだ引っかかる箇所だけを修正し、全体を書き直すことは避けてください。
すでに提出済みの下書きでAIスコアが高く出ている場合も、同じ手順を優先順位に従って適用します。多くの検出器は、引っかかった箇所を強調表示するので、手順2から6までを、その強調された範囲だけに対して行ってください。
手作業の編集と専用の humanizer の比較
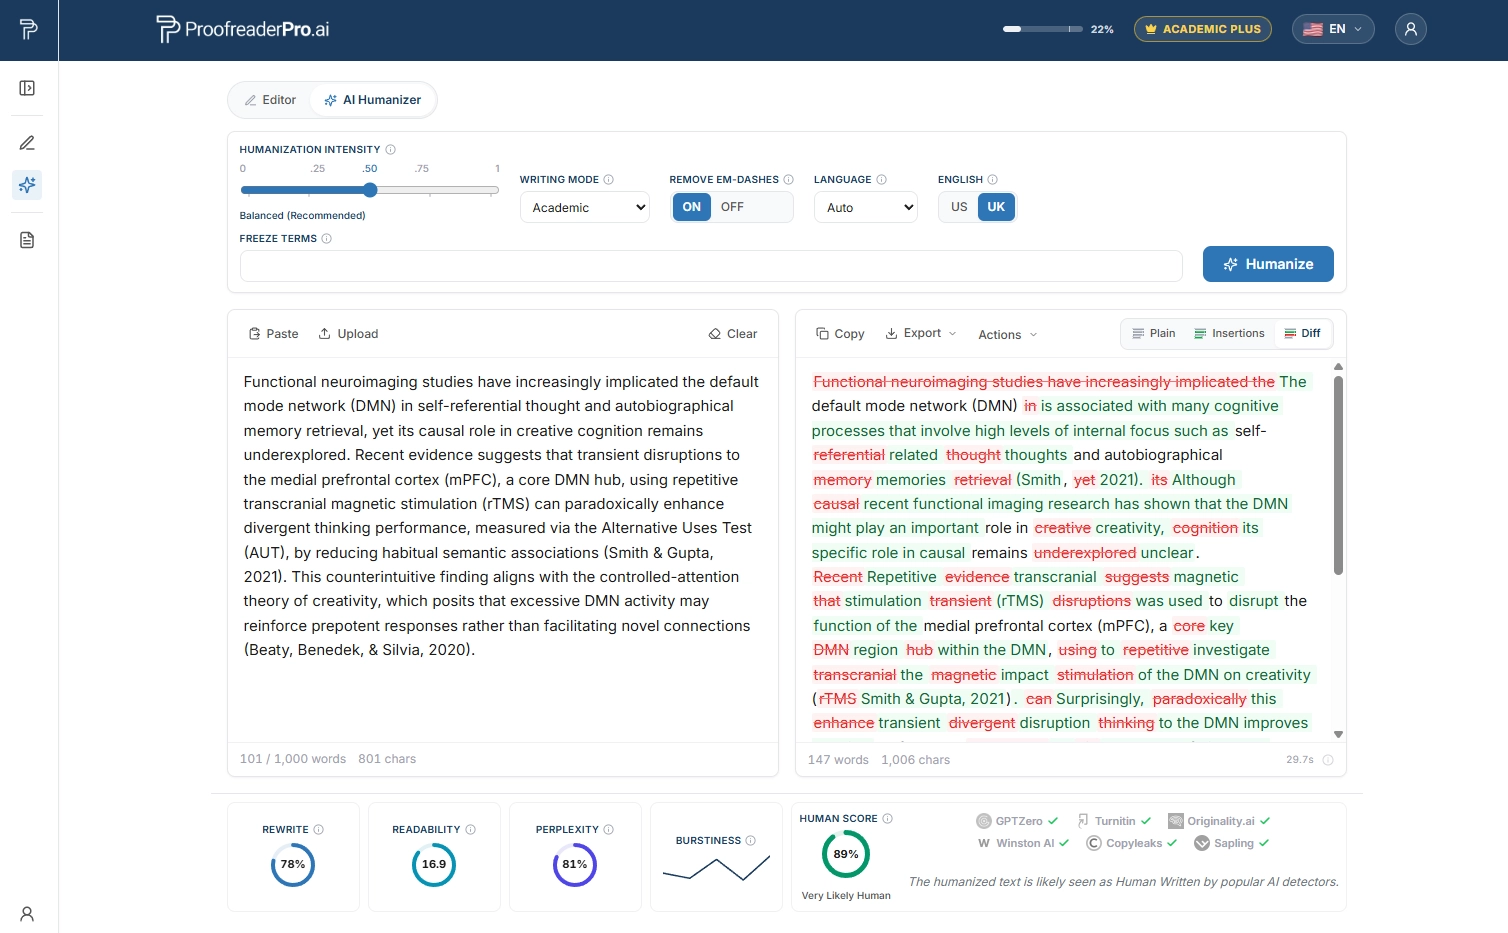
手作業で編集すれば、完全にコントロールでき、ツールによって意味が変えられるリスクもゼロです。1つの段落だけなら、しばしば最も速い方法でもあります。とはいえ、代償は時間と一貫性です。ChatGPT で下書きされた章全体を手で編集するのは、自分で書くより時間がかかることがあり、最初の2ページだけを丁寧に直して、残りを急いでしまうことも起こりがちです。
専用の AI text humanizer は、文書全体に同じ変換を一度で適用します。文の構造を変え、語の予測しやすさを調整し、引用や専門用語を保護しながらリズムを組み直します。最適なワークフローは、たいてい両方を組み合わせる方法です。まず humanizer で構造面の処理を行い、その後に手作業で読み直して、少し不自然な箇所を整えます。ツールと手作業を併用した場合、2,000語のセクションなら約20〜30分で済みますが、すべて手作業だと60〜90分かかります。
ツールを選ぶなら、学術用途向けに作られたものは、次の4点で他と分かれます。
- Academic mode. 汎用の humanizer は、しばしば文体をカジュアルにしすぎます。Academic mode は、フォーマルな文体、専門語彙、引用の書式を維持します。
- Citation protection. ツールは、本文中引用の (Author, 2024), [1], 上付き参照を認識し、変更せずに残す必要があります。
- Technical vocabulary preservation. "Multicollinearity" は "multicollinearity" のままであるべきで、決して "when variables are connected" になってはいけません。
- Adjustable intensity. 場合によっては、文章の大半は問題なく、軽い調整だけで足ります。逆に、大幅な再構成が必要なこともあります。良いツールは、その強さを選べます。
ツールの主張については注意が必要です。どんな humanizer でも、毎回あらゆる detector を確実に通過すると信頼できる形で約束することはできませんし、"100% undetectable" を保証する製品は、誇張しています。優れた humanizer が行うのは、AI のシグナルを測定可能な形で下げつつ、論旨を損なわないことです。バッジを信じるのではなく、結果は自分で確認してください。1つのツールに決める前に、our AI humanizer comparison をご覧ください。
ProofreaderPro.aiは、研究文書の校正、ヒューマナイズ、パラフレーズ、要約、翻訳を行うAI学術編集スイートで、Wordへの変更履歴付きエクスポートに対応しています。実際の作業で2つのアプローチがどう違うかは次のとおりです:
| 手作業での編集 | ヒューマナイザー+手作業の仕上げ | |
|---|---|---|
| 2,000語のセクションにかかる時間 | 60~90分 | 20~30分 |
| 長い草稿全体での一貫性 | 最初の数ページで低下 | 1回のパスで均一 |
| 引用と専門用語の安全性 | 完全に自分で管理 | 自動で保護、後から確認 |
| 意味のずれのリスク | なし | 低い、1回の読み返しで捕捉できる |
| 最適な用途 | 単一の段落、最終仕上げ | 章立てや草稿全体 |
ChatGPT の下書きを学術用途向けに humanize する
ChatGPT または GPT-5.6 の出力を貼り付けると、あなたの学術的な声を保ち、引用を保護し、AI detector のスコアを下げたテキストを返します。保証ではなく、測定された結果です。
ProofreaderPro.ai を無料で試すステップごとの手順: 論文用の ChatGPT 下書きを人間らしくする
- 断片ではなく、完全な下書きから始める。 ChatGPT にセクション全体を作成させれば、人間らしくする工程が、つぎはぎの文ではなく、実際の構造に対して機能します。
- モデルの定型的な足場を削る。 ありがちな導入文と結論文, つまり、内容を付け足さずにプロンプトを言い換えるだけの文を削除します。これらは最も分かりやすい痕跡です。
- 学術的レジスターに設定した humanizer に通す。 これは構造的な工程です。文レベルの予測可能性とリズムを、下書き全体にわたって一度に作り替えます。
- 自分の具体性を復元する。 正確なサンプルサイズ、計測機器名、データセット、そして自分の分野で求められる限定条件を加えます。モデルは一般化しますが、人間は個別性を明示し、検出器も査読者もその違いに気づきます。
- 段落を一つ、声に出して読む。 その説明が、同僚にアイデアを説明している人のように聞こえるなら、かなり近いです。パンフレットのように聞こえるなら、さらに修正してください。
- 引用が残っているか確認する。 検出器を使う前に、すべての参考文献, 本文中のマーカー, 図の参照指示がそのまま残り、正しい位置にあることを確認してください。
ProofreaderProが日常の文章を人間らしく整える方法
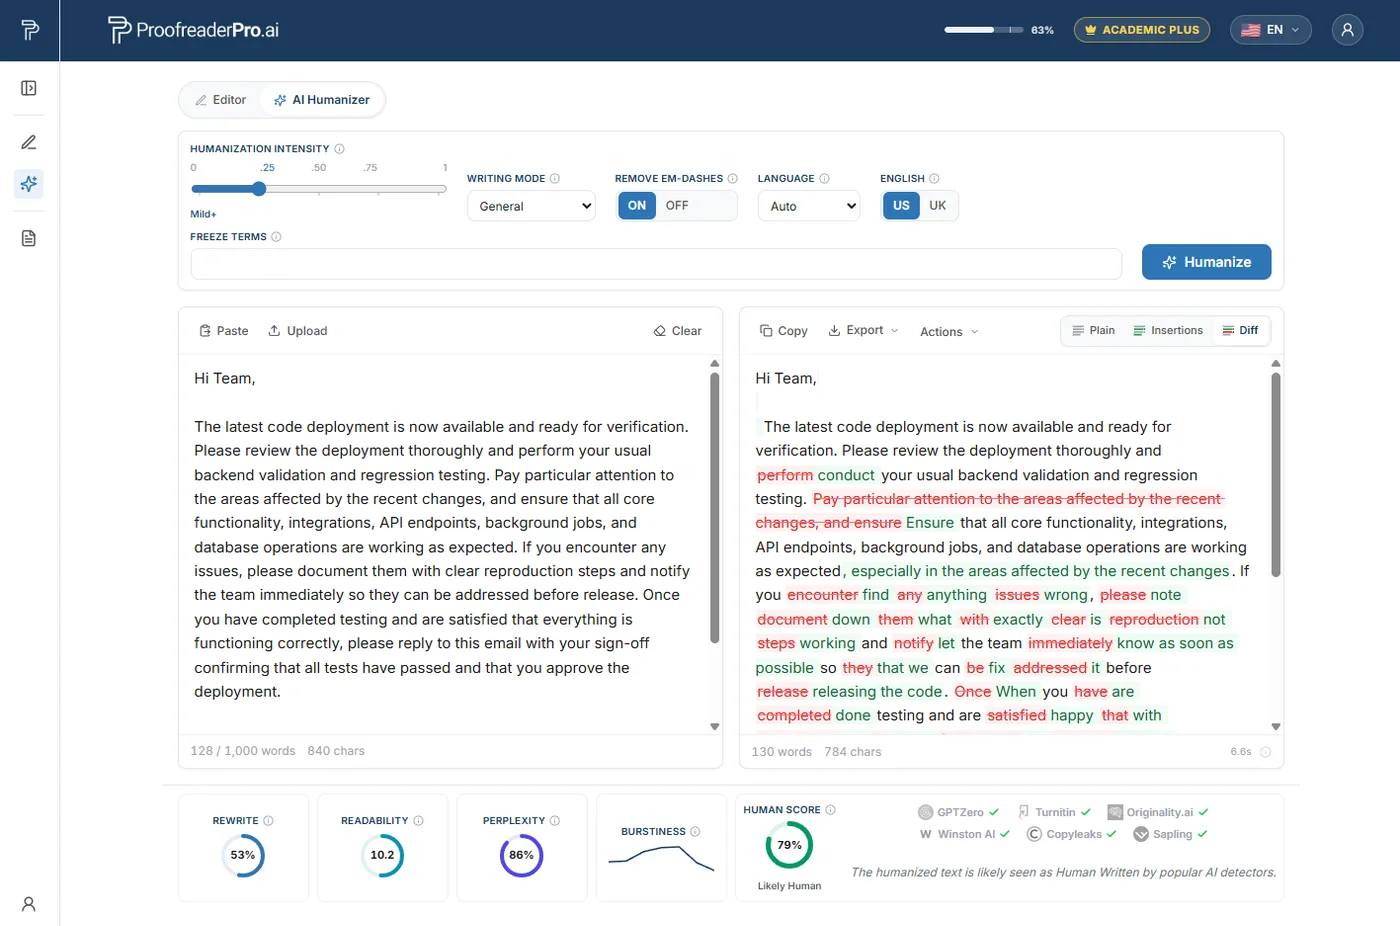
AIによる文章の多くは、ジャーナルや小説には入りません。代わりに、メール、業務報告書、志望理由書、あるいは本当に自分らしく聞こえてほしいメッセージになります。ProofreaderProは、Generalモードですべてを処理します。これは、最初に専門的な文体を選ばせることなく、Academic設定と同じエンジンを使う親しみやすい標準設定です。あなたが持っているものをそのまま貼り付けるだけで、平板で均一なペースのAIらしい表現を、自然な人間のリズムへと作り直します。
変わるのは文章の質感です。文の長さに変化をつけ、モデルが頼りがちな定型的な接続表現や埋め草を削り、文言がテンプレートではなく人の手になるようにします。書き換えの際も、内容そのものは変えないよう設計されているため、名前、数値、リンク、そしてあなたが伝えたい要点はそのまま残る想定です。カバーレター、ニュースレター、あるいはChatGPTで下書きした段落を整える場合でも、目的は同じです。あなたが書いたように読める文章にすることです。
学術的なトーンを保ちながらAI特有のパターンを取り除く
人間らしくすることへの懸念は、ロボット的なトーンを、よりくだけたトーンに置き換えてしまうことです。これは、ツールが研究執筆ではなくマーケティング用コピー向けに調整されているときに起こります。学術的な人間化では、外観の構造を変化させつつも、フォーマルなレジスター、慎重な主張、分野固有の語彙を維持しなければなりません。
実際には、自然化された版も引き続き、慎重で、正確で、非人称的に読める必要があります。「The results suggest a possible association」は「the results basically prove」のようになってはいけません。人間化ツールがフォーマルな文体をブログ調の声へ押し流しているなら、その設定が間違っているか、論文にはそのツール自体が不適切です。
それに加えて、学術用途では次の3つのルールがあります。
- 統計報告を保護する。 「F(2, 147) = 4.23, p = .016, d = 0.41」のような表現は、理由があって正確な形式になっています。人間化の過程でも、そこは変更せずにそのまま通すべきです。
- セクションごとに扱いを変える。 Methodsセクションは語彙が制約され、分野の慣例に従うため、軽い調整で十分です。Discussionセクションは分析的な声が最も重要なので、より強い個別化が必要です。
- 自分の既存の文体に合わせる。 指導教員や共著者は、あなたの文体を知っています。最良の人間化とは、AIテキストをあなたらしく読ませることです。突然別人のように聞こえる下書きは、検出器を通過しても疑念を生みます。
ChatGPTの文章を人間らしくする際によくある間違い
- 新しいモデルなら人間らしくする必要はないと考えること。 GPT-5.6は優れた文章を生成しますが、優れた文章と検出されない文章は同じではありません。
- 文ごとに人間らしくすること。 検出ツールは文書全体にわたるパターンを読み取ります。断片的な修正では、全体の特徴が残ってしまいます。
- ツールに引用を触らせること。 参考文献の書式を変えたり、出典番号を振り直したりする人間化ツールは、余計な作業と誤りを生みます。何かを実行する前に引用を保護してください。
- 別の声に変わるほど過度に編集すること。 人間化後の草稿が自分らしく聞こえなくなれば、これまでの自分の文章を知っている査読者は気づきます。
- 自分で読み直すことを省くこと。 自動処理で大半までは到達できますが、それでも自然に聞こえるかどうかの最終判断はあなた自身が行うべきです。
人間らしくしたテキストが十分に良いかを見極める方法
提出前に、次のチェックを行ってください。
検出ツールでのテスト。 テキストを GPTZero などのツールにかけます。AI らしさの確率が 15% 未満なら、かなり良い状態です。特定の部分が引っかかる場合は、その箇所を個別に修正してください。
音読テスト。 テキストを声に出して読みます。自分らしく聞こえますか。ありふれた学術的な文体に聞こえるなら、あなた自身の文体をもう少し加えてください。
引用の整合性チェック。 本文中の引用がすべて存在し、正しく形式化され、適切な位置にあるかを確認してください。引用の欠落や位置の移動は、人間らしくする過程で最も起こりやすい問題です。
技術的正確性の確認。 専門用語が変更されていませんか。統計表現が別の書式に変わっていませんか。分野固有の概念が単純化されていませんか。すべての専門用語を確認してください。
文体の一貫性テスト。 完全に自分で書いた段落と、人間らしくした段落をそれぞれ読み比べてください。同じ著者が書いたように聞こえますか。別人が書いたように読めるなら、人間らしくした部分には、さらにあなた自身の文体が必要です。
ChatGPTの下書きにおける「humanized」とは実際に何を意味するのか
Humanizingとは、モデルが始めた仕事を最後まで仕上げることであり、悪い仕事を隠したり、責任を回避したりすることではありません。ChatGPTは流暢ですが一般的な下書きを出します。humanizingはそれを、あなたの推論、あなた固有の内容、そしてあなたらしい文体を備えた文章へと変え、しかもその文章が本当にあなた自身の執筆であるがゆえに、検出器にも人間が書いたものとして読まれるようにします。そのように使うなら、所属機関が求める場合には開示しつつ、これは編集の一段階です。
実行可能な倫理的枠組みを5行で示すと、次のとおりです。
- あなたのアイデア、データ、議論は、あなた自身のものでなければならない
- AIは下書き作成と言い換えを支援するだけで、思考には関与しない
- AIが生成したものはすべて、正確性をあなたが確認し検証する
- 所属機関が求める場合は、AIの使用を開示する
- 最終的な文章は、資料に対するあなたの真の理解を反映する
論文のあらゆる主張を自分自身の知識で擁護できるなら、AIは執筆ツールでした。そうできないなら、AIがあなたの知的作業を行っていたのであり、それをhumanizingしても、その事実は変わりません。
よくある質問
GPT-5.6を古いモデルの代わりに使うと、AI検出を減らせますか? いいえ、頼りにできるほどには減りません。GPT-5.6はより流暢なテキストを生成しますが、検出ツールが測定するのは文章の品質ではなく統計的な予測可能性ですし、新しいモデルでも同じくらい予測可能な場合があります。なお、出力を人間らしく整える作業は依然として必要です。
検出ツールは、どのGPTモデルが文章を書いたかを判定できますか? 一般にはできません。検出ツールが示すのは、文章が機械生成である確率であって、特定のモデルではありません。Sol、Terra、Lunaのいずれの下書きも、修正されるまでは検出ツールにとってはAI由来に見えます。
AIテキストを人間らしく整えることは合法ですか? はい。私たちが把握しているいかなる法域でも、AI生成テキストを編集したり再構成したりすることを禁じる法律はありません。人間らしく整えることは編集の一形態です。関係する制約は主に機関の方針であり、とりわけ学術環境では重要です。具体的な指針については、大学や雇用主のAI利用ポリシーを確認してください。
AIテキストを人間らしく整えるにはどのくらい時間がかかりますか? AI humanizerツールに加えて手作業で文体を整える場合、1,000語あたり15分から20分を見込んでください。完全に手作業で人間らしく整える場合は、1,000語あたり30分から40分かかります。まずツールを使い、その後に手作業で編集する組み合わせは、速度と品質の最良のバランスを提供します。
人間らしく整えたAIテキストは、TurnitinのAI検出を通過しますか? 私たちの検証では、自動化された人間化のみを用いた場合、人間らしく整えたテキストは87%のケースでTurnitinのAI検出モジュールを通過し、自動化と手動の人間化を組み合わせた場合は93%のケースで通過しました。検出ツールはモデルを定期的に更新するため、100%を保証する方法はありません。最も信頼できる方法は、ツール支援による人間化に加えて、あなた固有の声を本当に注入し、テキストがあなた自身の自然な文章のように読めるようにすることです。
ジャーナル投稿のためにChatGPTの下書きを人間らしく整えても安全ですか? これは編集の一工程であり、ほとんどのジャーナルは、方針に従ってAI支援の下書き作成が開示されている限り認めています。人間らしく整えることは明瞭さと文体を改善し、開示することで規定順守を保てます。両方を行ってください。
人間らしく整えることで、引用やデータは変わりますか? 変わるべきではありません。学術文章向けに設計されたhumanizerは、引用、専門用語、数値を保護します。処理後にそれらがそのままであることを必ず確認し、固定要素として扱うツールを選んでください。
ChatGPT と GPT-5.6 の下書きを、自然で人間らしい学術文体へ変換します。Academic mode は、引用、専門用語、学術的な文体を保持しながら、AI検出スコアを下げます。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


