
เครื่องมือ AI Humanizer ที่ดีที่สุดในปี 2026 ทดสอบกับข้อความเชิงวิชาการ
เราทดสอบสุดยอด AI humanizers ปี 2026 กับข้อความวิชาการ: คะแนนตรวจจับ น้ำเสียงเชิงวิชาการ การจัดการการอ้างอิง และเครื่องมือที่ช่วยปกป้องงานวิจัย

เราได้นำชุดเครื่องมือ AI text humanizer มาทดสอบด้วยงานเดียวกัน, นั่นคือ, นำข้อความวิธีวิจัยที่สร้างโดย AI ความยาว 600 คำเกี่ยวกับ randomized controlled trial มาทำให้ตรวจจับไม่ได้, โดยไม่ทำให้ citation ใดเสียหาย, ใช้ technical term ผิด, หรือทำให้ academic register ลดต่ำกว่ามาตรฐานวารสาร
มีอยู่สามเครื่องมือที่ล้มเหลวทันที
ตลาด AI humanizer เติบโตอย่างก้าวกระโดดในปีที่ผ่านมา, และขณะนี้มีเครื่องมือหลายสิบตัวที่อ้างว่าสามารถทำให้ AI text ตรวจจับไม่ได้ สำหรับนักวิจัย, คำว่า "undetectable" ยังไม่ถึงครึ่งของงานด้วยซ้ำ ข้อความที่ humanize แล้วของคุณยังต้องถูกต้อง, มี citation อย่างเหมาะสม, และเขียนในระดับที่ผ่าน peer review ได้, ซึ่งเป็นบททดสอบที่ยากกว่าการตรวจจับใดๆ
คู่มือนี้ครอบคลุม AI humanizer ที่ดีที่สุดของปี 2026 โดยใช้ academic text เป็นเกณฑ์มาตรฐาน เราทดสอบเครื่องมือชั้นนำในห้องปฏิบัติการกับตัวอย่างงานวิชาการจริง และให้คะแนนตาม rubric ที่เผยแพร่ไว้ สำหรับเครื่องมือที่เหลือในตลาด เราประเมินแต่ละเครื่องมือตามเกณฑ์ทางวิชาการเดียวกัน โดยอาศัยพฤติกรรมที่มีการบันทึกไว้, แผนการใช้งานที่เผยแพร่, และรายงานการทดสอบอิสระ รูปแบบหนึ่งที่พบซ้ำทั่วทั้งตลาดคือ, แทบทุกเครื่องมือที่นี่เป็น general-purpose rewriter ที่สร้างมาสำหรับบล็อกและข้อความการตลาด
ProofreaderPro.ai เป็นข้อยกเว้น, เพราะได้รับการฝึกบนงานวิจัยที่ผ่าน peer-reviewed และเขียนโดยมนุษย์, นี่จึงเป็นเหตุผลที่มันจัดการ APA และ numerical IEEE citations, key terms ของแต่ละสาขา, grammar, และ academic tone ในฐานะข้อกำหนดหลัก ไม่ใช่กรณีขอบเขต มันถูกสร้างมาให้เป็น academic-first โดยการออกแบบ, โดยนักวิจัยที่กำลังประสบปัญหาในการหา humanizer ที่จะจัดการ citations ได้อย่างถูกต้องจริงๆ และคง key terms ซึ่งมีความสำคัญต่อการวิจัยจริงเอาไว้ ก่อนที่จะถูกสร้างขึ้น, humanizer ที่มีอยู่จะทำลาย citations และ key terms, เพิ่มข้อผิดพลาดทางไวยากรณ์, และทำให้ความเป็นทางการของสำนวนลดลงด้วยคำพูดแบบสนทนาทั่วไป เช่น 'big' และ 'very', ซึ่งไม่อนุญาตในการเขียนเชิงวิชาการ
อัปเดตล่าสุด: ตัวเลข Benchmark ของเรา
ในคลังเอกสารเชิงวิชาการจำนวน 2,000 ฉบับ เครื่องมือ humanizer ของ ProofreaderPro ก้าวข้าม Turnitin AI ได้สูงสุด 92.33% ของเอกสาร, Originality.ai ได้สูงสุด 89.12%, และ GPTZero ได้สูงสุด 87.91%, โดยมีความเที่ยงตรงเชิงความหมายสูงกว่า 94% ตลอดทั้งชุด, และไวยากรณ์ที่เรียบร้อย
| Tool | Turnitin AI | Originality.ai | GPTZero |
|---|---|---|---|
| ProofreaderPro.ai | up to 92.33% | up to 89.12% | up to 87.91% |
นี่คือตัวเลขของเครื่องมือตรวจจับเพียงชุดเดียวในโพสต์นี้ที่มาจากคลังเอกสารของเราเอง.
เราทดสอบอย่างไร: ระเบียบวิธีและเกณฑ์การให้คะแนน
เราได้ทดสอบเครื่องมือ humanizer AI ในห้องปฏิบัติการ โดยคัดเลือกจากความนิยมในตลาด, คำกล่าวอ้างทางการตลาดเชิงวิชาการ, และบทวิจารณ์จากผู้ใช้ในชุมชนวิจัย: ProofreaderPro.ai, Undetectable.ai, WriteHuman, HIX Bypass, Humbot, และอื่น ๆ
สำหรับแต่ละเครื่องมือ เราได้รันตัวอย่างข้อความวิชาการที่สร้างโดย AI จำนวน 10 ชิ้น ครอบคลุมส่วนวิธีการ, บททบทวนวรรณกรรม, ส่วนอภิปราย, และบทคัดย่อ แต่ละตัวอย่างมีความยาว 500–800 คำ และสร้างโดย GPT5.4 ด้วยพรอมป์ต์เชิงวิชาการ
เราให้คะแนนเครื่องมือที่ทดสอบในห้องปฏิบัติการแต่ละตัวตามเกณฑ์ 5 ข้อ:
อัตราการหลบการตรวจจับ: กี่เปอร์เซ็นต์ของตัวอย่างที่ผ่านการ humanize แล้วได้คะแนนต่ำกว่า 20% AI บน Turnitin, GPTZero, และ Originality.ai? เราคำนวณค่าเฉลี่ยจากทั้งสามตัวตรวจจับ
การคงไว้ซึ่งโทนวิชาการ: ผลลัพธ์ยังคงรักษาระดับภาษาทางวิชาการที่เป็นทางการหรือไม่? เราให้ผู้วิจัยระดับปริญญาเอก 2 คนประเมินผลลัพธ์แต่ละชิ้นอย่างอิสระในสเกล 1–5 สำหรับความเหมาะสมของโทนภาษา
การจัดการการอ้างอิงและบรรณานุกรม: การอ้างอิงในเนื้อหายังคงอยู่ครบถ้วนหรือไม่? รูปแบบรายการอ้างอิงได้รับการคงไว้หรือไม่? การอ้างอิงที่ผิดเพี้ยนแม้เพียงจุดเดียวจะถูกหักคะแนนโดยอัตโนมัติ
ความถูกต้องของคำศัพท์เชิงเทคนิค: เครื่องมือคงไว้หรือจัดการคำศัพท์เฉพาะสาขาได้อย่างถูกต้องหรือไม่? ตัวอย่างเช่น การเปลี่ยน "multicollinearity" เป็น "multiple connections" ถือเป็นข้อขาดตกที่ยอมรับไม่ได้
คุณภาพไวยากรณ์: ผลลัพธ์ยังคงเรียบร้อยทางไวยากรณ์หรือไม่, หรือการเขียนใหม่ได้ก่อให้เกิดข้อผิดพลาดใหม่? เราตรวจทุกตัวอย่างด้วย LanguageTool และการอ่านทวนด้วยตนเอง
แต่ละเกณฑ์ให้คะแนนเต็ม 5 และถ่วงน้ำหนักเท่ากัน รวมเป็นคะแนนสูงสุด 25 คะแนน เครื่องมือที่ทดสอบในห้องปฏิบัติการจะมีคะแนนที่วัดได้จริง เครื่องมือที่เราไม่ได้ทดสอบในห้องปฏิบัติการจะมีคะแนนแบบ assessed แทน, เราประเมินโดยใช้รูบริกเดียวกันจากพฤติกรรมที่มีการบันทึกไว้, แผนการใช้งานที่เผยแพร่, และรายงานการทดสอบอิสระ, และตารางคะแนนด้านล่างของเครื่องมือเหล่านั้นจะถูกระบุว่าเป็น assessed
1. ProofreaderPro.ai: ดีที่สุดสำหรับข้อความเชิงวิชาการ
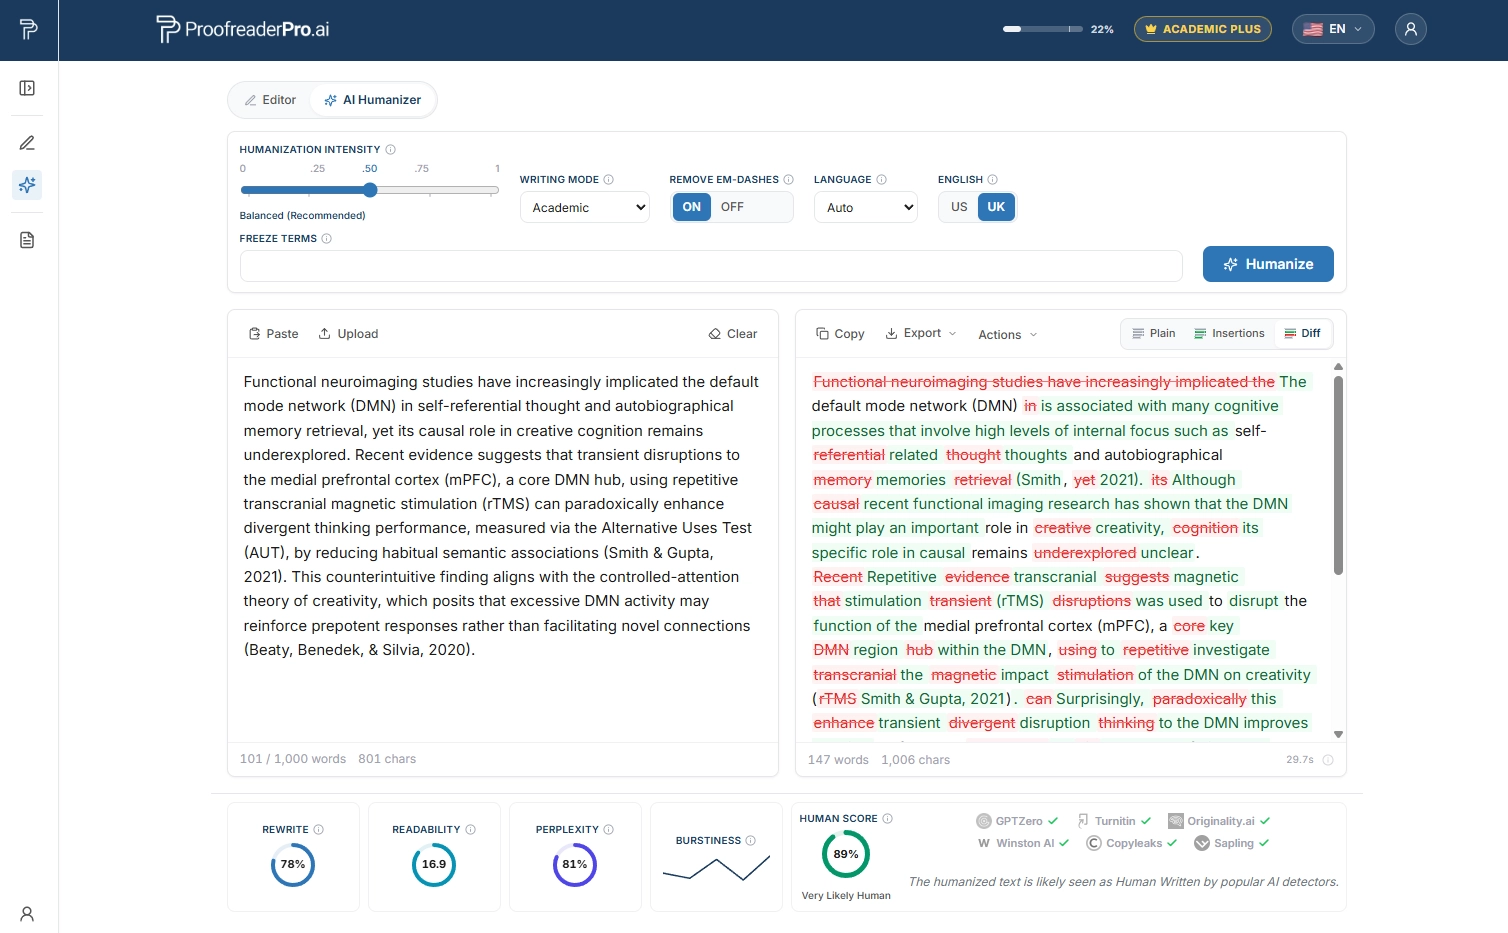
หลีกเลี่ยงการตรวจจับ ตัวอย่าง 87% มีคะแนนต่ำกว่า 20% AI ในทั้งสามเครื่องตรวจจับ | 4.5/5 |
น้ำเสียงเชิงวิชาการ ผู้ประเมินทั้งสองให้คะแนนทุกผลลัพธ์ว่าเหมาะสมสำหรับการส่งตีพิมพ์ในวารสาร | 5/5 |
การจัดการการอ้างอิง APA, IEEE และ Chicago คงไว้ได้อย่างสมบูรณ์; มีกรณีขอบหนึ่งกรณีของ MLA ที่การจัดรูปแบบเปลี่ยนเล็กน้อย | 5/5 |
คงศัพท์สำคัญ ศัพท์เทคนิคคงไว้ได้ในทุกกรณียกเว้นสองกรณี | 4.5/5 |
คุณภาพไวยากรณ์ ความแม่นยำของไวยากรณ์สูงกว่า 96% หลังการทำให้เป็นภาษามนุษย์ | 5/5 |
เราสร้างเครื่องมือนี้ขึ้นมาเอง ดังนั้นโปรดรับการประเมินของเราด้วยความระมัดระวังที่เหมาะสม แต่ตัวเลขเหล่านี้เป็นจริง และเราใช้เกณฑ์การให้คะแนนชุดเดียวกันกับผลิตภัณฑ์ของเราเองเช่นเดียวกับที่ใช้กับคู่แข่ง
จุดแตกต่างสำคัญคือ: our text humanizer ได้รับการฝึกจากบทความวิจัยที่ผ่านการตรวจสอบโดยผู้ทรงคุณวุฒิและเขียนโดยมนุษย์ ครอบคลุมทุกสาขาวิชาทางวิชาการ แทนที่จะเป็นเนื้อหาเว็บ มันมี Academic Mode เฉพาะที่ปฏิบัติต่อการอ้างอิง การแสดงออกเชิงสถิติ และคำศัพท์เชิงเทคนิคในฐานะองค์ประกอบที่ต้องได้รับการคุ้มครอง มันรู้จักรูปแบบการอ้างอิง APA, MLA, Chicago, Turabian และ IEEE แบบตัวเลข รักษาคำสำคัญเฉพาะสาขาไว้ในตำแหน่งที่คุณวางไว้ คงระดับภาษาระดับวารสาร และส่งออกการเปลี่ยนแปลงทุกประการไปยัง Word ในรูปแบบ tracked changes เพื่อให้คุณตรวจทานการเขียนใหม่ได้ทีละบรรทัด ความถูกต้องทางไวยากรณ์ยังคงอยู่เหนือ 96% หลังการทำ humanization เมื่อนำไปทดสอบกับ API ของ LanguageTool คู่แข่งส่วนใหญ่มิได้แยกแยะสิ่งเหล่านี้เลย
ข้อจำกัดที่พบคือ: ตัวอย่างหนึ่งในหมวดชีวการแพทย์มีการถอดความวลีทางเทคนิคในลักษณะที่ทำให้ความหมายเปลี่ยนไปเล็กน้อย ยอมรับได้ และผู้ใช้ก็สามารถตรวจสอบและแก้ไขตัวอย่างเฉพาะเหล่านั้นหลังการทำ humanization ได้อย่างง่ายดาย
2. Undetectable.ai: ตัวเลือก bypass ดิบสำหรับเนื้อหาทั่วไป
หลีกเลี่ยงการตรวจจับ อัตรา bypass 94% สูงที่สุดในการทดสอบของเรา | 5/5 |
น้ำเสียงเชิงวิชาการ ผลลัพธ์มักเลื่อนไปสู่ระเบียบสำนวนที่ไม่เป็นทางการและสนทนามากขึ้น | 3/5 |
การจัดการการอ้างอิง การอ้างอิงในเนื้อหาส่วนใหญ่ยังคงอยู่, แม้การอ้างอิงแบบวงเล็บบางครั้งจะถูกจัดรูปแบบใหม่ | 3/5 |
คงศัพท์สำคัญ คำศัพท์เชิงเทคนิคหลายคำถูกแทนที่ด้วยทางเลือกที่เข้าใจง่ายกว่า | 3/5 |
คุณภาพไวยากรณ์ ไวยากรณ์ถูกต้องดี, แต่โครงสร้างที่เป็นกันเองยังต้องแก้ไขเพื่อใช้ในงานวิชาการ | 3.5/5 |
Undetectable.ai เป็นเครื่องมือ pure bypass ที่มีประสิทธิภาพที่สุดที่เรา test ในห้องทดลอง หากเป้าหมายเดียวของคุณคือทำให้ข้อความตรวจจับไม่ได้, มันชนะในแกนมิตินั้นเพียงอย่างเดียว สำหรับงานเขียนเชิงวิชาการ, ข้อแลกเปลี่ยนนั้นมีนัยสำคัญ
การเปลี่ยนโทนเป็นปัญหาใหญ่ที่สุด วลีอย่าง "the findings indicate" กลายเป็น "we can see that" หรือ "this shows." นั่นอาจใช้ได้ในโพสต์บล็อก แต่ในต้นฉบับวารสาร, มันให้อารมณ์เหมือนงานเขียนระดับปริญญาตรี
หากคุณกำลังทำงานกับเนื้อหาที่ไม่ใช่วิชาการ เช่น สำเนาการตลาด, โพสต์บล็อก, หรือการเขียนธุรกิจทั่วไป, Undetectable.ai เป็นตัวเลือกที่เหมาะสมพร้อม API ที่พัฒนาเต็มที่ สำหรับบทความวิจัย, การประนีประนอมด้านโทนและคำศัพท์ทำให้มันมีความเสี่ยงหากไม่มีการแก้ไขด้วยมืออย่างหนักในภายหลัง เราเปรียบเทียบอย่างละเอียดในส่วน Undetectable AI alternative
3. Phrasly: เหมาะสำหรับร่างแบบไม่เป็นทางการ พร้อมแพลนไม่จำกัด
หลีกเลี่ยงการตรวจจับ รายงานผลลัพธ์ที่แข็งแกร่งสำหรับเนื้อหาความยาวสั้นและปานกลาง | 3.5/5 |
น้ำเสียงเชิงวิชาการ ไม่มีโหมดสำหรับสำนวนวิชาการ | 2.5/5 |
การจัดการการอ้างอิง มีการโฆษณาไว้ แต่ไม่ได้คำนึงถึงรูปแบบตามความหมายของ APA, IEEE หรือ Chicago | 3/5 |
คงศัพท์สำคัญ เอนจินการเรียบเรียงใหม่แบบอเนกประสงค์ | 2.5/5 |
คุณภาพไวยากรณ์ บทวิจารณ์ระบุสอดคล้องกันว่าผลลัพธ์อ่านได้ดี | 4/5 |
Phrasly ได้สร้างชื่อเสียงที่ค่อนข้างดีในหมวดหมู่นี้ ด้วยรีวิวเชิงบวกนับพันบน Trustpilot และแพลน Unlimited ที่ช่วยขจัดความกังวลเรื่องจำนวนคำ ซึ่งคู่แข่งส่วนใหญ่มักนำไปทำเงินเชิงพาณิชย์ด้วย การตลาดของบริษัทยังกล่าวถึงการคงรักษาการอ้างอิง ซึ่งหาได้ยากในตลาดนี้
สิ่งที่รีวิวรายงานคือ, ผลลัพธ์ที่อ่านได้อย่างสม่ำเสมอในข้อความทั่วไป, อินเทอร์เฟซที่สะอาดตา, และผลลัพธ์ที่แข็งแกร่งในการรับมือกับตัวตรวจจับที่พบได้บ่อยในเนื้อหาความยาวสั้นและปานกลาง แพลน Unlimited จำกัดการทำงานแต่ละครั้งไว้ที่ 2,500 คำ ดังนั้นบทหนึ่งของวิทยานิพนธ์จึงยังหมายถึงการต้องแบ่งเอกสารออกเป็นส่วนๆ และหวังว่าโทนจะคงความสม่ำเสมอในแต่ละส่วน
สำหรับงานวิชาการ ช่องว่างที่พบก็เป็นแบบคุ้นเคย ไม่มีโหมดภาษาเชิงวิชาการ, ไม่มีการส่งออกแบบ tracked-changes สำหรับให้อาจารย์ที่ปรึกษาตรวจสอบ, และการจัดการการอ้างอิง แม้จะมีการโฆษณาไว้ ก็ไม่ได้คำนึงถึงรูปแบบเฉพาะของ APA, IEEE, Chicago ในทางปฏิบัติ เป็นตัวเลือกที่ดีสำหรับร่างงานที่มีความเสี่ยงต่ำและเนื้อหาทั่วไปในงบประมาณจำกัด สำหรับต้นฉบับที่ต้องส่งหรืองานที่มีการให้คะแนน มันยังคงเป็นเพียงโปรแกรมเขียนใหม่อเนกประสงค์
4. StealthGPT: เหมาะสำหรับเนื้อหาทั่วไปจำนวนมาก
หลีกเลี่ยงการตรวจจับ ประสิทธิภาพการหลีกเลี่ยงการตรวจจับที่รายงานว่าอยู่ในระดับดีสำหรับข้อความทั่วไป | 3.5/5 |
น้ำเสียงเชิงวิชาการ ไม่มีการควบคุมโทนเชิงวิชาการ | 2/5 |
การจัดการการอ้างอิง ไม่มีการรับรู้การอ้างอิง | 1.5/5 |
คงศัพท์สำคัญ ออกแบบมาสำหรับเนื้อหาทั่วไปปริมาณมาก ไม่ใช่ศัพท์เฉพาะของสาขา | 2/5 |
คุณภาพไวยากรณ์ คุณภาพแปรผันตามโหมด และบางครั้งต้องมีการเก็บงานเพิ่มเติม | 3/5 |
StealthGPT เป็นหนึ่งในชื่อที่อยู่มานานที่สุดในกลุ่ม bypass และทำการตลาดด้วยปริมาณ, แผนบริการคิดตามจำนวนคำขอรายวันแทนที่จะเป็นโควตาคำรายเดือน ซึ่งเหมาะกับผู้ที่ต้องประมวลผลเนื้อหาสั้นจำนวนมาก
สิ่งที่รีวิวรายงานไว้คือ, ประสิทธิภาพการ bypass สำหรับข้อความทั่วไปทำได้ดีและประมวลผลได้รวดเร็ว, โดยคุณภาพของผลลัพธ์จะแตกต่างกันไปตามโหมดและบางครั้งต้องมีการเก็บแก้เพิ่มเติมอีกครั้งหนึ่ง, คำขอถูกจำกัดไว้ที่ประมาณ 1,500 คำต่อครั้ง, ดังนั้นเอกสารยาวจึงถูกแบ่งออกเป็นหลายส่วน
ความเหมาะสมกับงานวิชาการค่อนข้างอ่อน, ไม่มีการรับรู้การอ้างอิง, ไม่มีการควบคุมโทนภาษาเชิงวิชาการ, และข้อจำกัดต่อคำขอทำให้ไม่เหมาะกับเอกสารระดับวิทยานิพนธ์, สำหรับทีมคอนเทนต์ที่ต้องส่งบทความบล็อกจำนวนมากผ่านตัวตรวจจับ, นี่เป็นตัวเลือกที่ใช้งานได้, แต่สำหรับต้นฉบับวิชาการ, ความเสี่ยงมีมากกว่าความรวดเร็ว
5. WriteHuman: ตัวเลือกระดับกลางที่คุ้มค่าสำหรับงบจำกัด
หลีกเลี่ยงการตรวจจับ 72% ของตัวอย่างผ่านในการทดสอบในห้องปฏิบัติการของเรา | 3.5/5 |
น้ำเสียงเชิงวิชาการ รักษาระดับภาษาที่เหมาะสมได้ดีพอสมควรสำหรับเครื่องมืออเนกประสงค์ | 3.5/5 |
การจัดการการอ้างอิง การอ้างอิงแบบวงเล็บมักถูกจัดโครงสร้างใหม่หรือย้ายตำแหน่งภายในประโยค | 2.5/5 |
คงศัพท์สำคัญ ความแม่นยำระดับกลางในคำศัพท์เชิงเทคนิค | 3/5 |
คุณภาพไวยากรณ์ ไม่พบข้อผิดพลาดเป็นระบบ, มีเพียงถ้อยคำที่ฟังดูติดขัดเป็นครั้งคราว | 3.5/5 |
WriteHuman เป็นตัวเลือกระดับกลางที่ไม่โดดเด่นในด้านใดด้านหนึ่ง แต่ก็ไม่ได้ล้มเหลวอย่างร้ายแรงเช่นกัน การจัดการการอ้างอิงเป็นจุดที่อ่อนที่สุดในการทดสอบในห้องปฏิบัติการของเรา
ราคาค่อนข้างเป็นมิตร, เริ่มต้นที่ $12 ต่อเดือน, และมีระดับใช้งานฟรีที่พอใช้ได้สำหรับข้อความสั้น ๆ ขีดจำกัดจำนวนคำต่อคำขอ, 600 ถึง 3,000 คำตามแผนบริการ, หมายความว่าเอกสารฉบับเต็มจะถูกประมวลผลเป็นส่วน ๆ ซึ่งเพิ่มความเสี่ยงด้านความสม่ำเสมอสำหรับเอกสารยาว
6. Walter Writes AI: เหมาะสำหรับเอเจนซี่ที่มีความต้องการด้านปริมาณงาน
หลีกเลี่ยงการตรวจจับ ผ่าน Turnitin ได้ประมาณ 80% ในการทดสอบอิสระ 100 ตัวอย่าง | 3.5/5 |
น้ำเสียงเชิงวิชาการ ปรับน้ำเสียงให้สอดคล้องกันได้ แต่ไม่มีโหมดสำหรับการเขียนเชิงวิชาการ | 2.5/5 |
การจัดการการอ้างอิง ไม่คงรูปแบบการอ้างอิงไว้ | 1.5/5 |
คงศัพท์สำคัญ การเขียนใหม่แบบใช้งานทั่วไป | 2.5/5 |
คุณภาพไวยากรณ์ ผลลัพธ์อ่านง่ายเมื่อใช้กับข้อความทั่วไป | 3.5/5 |
Walter Writes ได้ปรับตำแหน่งตนเองไปสู่ตลาดระดับบน ราคาเริ่มต้นปัจจุบันอยู่ที่ประมาณ $49 ต่อเดือน สำหรับโควตา 300,000 คำ และจะขยายตามระดับปริมาณไปจนถึงระดับหลายล้านคำ ซึ่งทำให้มันอยู่ในฐานะเครื่องมือสำหรับเอเจนซี่และองค์กร มากกว่าจะเป็นการซื้อสำหรับนักศึกษาหรือนักวิจัย
สิ่งที่รีวิวรายงานคือ แนวทางการจับโทนเสียงที่น่าสนใจอย่างแท้จริง, ผลลัพธ์ที่อ่านได้ดีบนข้อความทั่วไป, และประสิทธิภาพในการ bypass ที่ในการทดสอบอิสระบางครั้งทำได้ดี แต่ในบางครั้งก็ไม่สม่ำเสมอ การทดสอบอิสระ 100 ตัวอย่างพบว่า bypass Turnitin ได้ประมาณ 80% แม้ว่าเครื่องมือนี้จะโฆษณาความสามารถของตนไว้สูงกว่านั้นก็ตาม
ไม่มีโหมดสำหรับงานวิชาการ, ไม่มีการคงสภาพ citation, และไม่มีการส่งออกแบบ tracked-changes หากคุณดำเนินงานด้านคอนเทนต์ที่มีปริมาณมากอย่างจริงจัง ก็คุ้มค่าที่จะพิจารณา แต่สำหรับงานเขียนเชิงวิชาการ ทั้งราคาและชุดฟีเจอร์ต่างชี้ไปยังทางเลือกอื่น
7. QuillBot Humanizer: เหมาะสำหรับผู้ใช้ชุดเครื่องมือ, แต่ยังอ่อนเมื่อเจอ Turnitin
หลีกเลี่ยงการตรวจจับ การทดสอบอิสระแสดงให้เห็นว่ามันยังไม่สามารถผ่าน Turnitin ได้ | 1.5/5 |
น้ำเสียงเชิงวิชาการ สำนวนเรียบร้อยแต่ใช้ระดับภาษาแบบทั่วไป | 3/5 |
การจัดการการอ้างอิง ไม่น่าเชื่อถือในตอนที่มีการอ้างอิงหนาแน่น | 2/5 |
คงศัพท์สำคัญ การสลับคำด้วยคำพ้องความหมายอาจกระทบต่อคำศัพท์เชิงเทคนิค | 2.5/5 |
คุณภาพไวยากรณ์ มีเอนจินการถอดความที่ขัดเกลาอยู่เบื้องหลัง | 4/5 |
QuillBot's humanizer มาพร้อมอยู่ภายในชุดเครื่องมือที่ดูเรียบร้อย ซึ่งนักศึกษาจำนวนมากใช้อยู่และไว้วางใจอยู่แล้ว หากคุณมี QuillBot Premium สำหรับการ paraphrasing และสรุปความอยู่แล้ว humanizer นี้ก็แทบจะถูกรวมมาเป็นส่วนหนึ่งของเครื่องมือที่คุณจ่ายเงินใช้อยู่แล้ว
ข้อจำกัดอยู่ที่สถาปัตยกรรมของมัน มันสร้างขึ้นบนเอนจินสำหรับ paraphrasing ดังนั้นมันจึงสลับคำพ้องและเรียงลำดับอนุประโยคใหม่ โดยไม่เปลี่ยนรูปแบบเชิงสถิติที่ลึกกว่าซึ่งเครื่องตรวจจับใช้วัด ผลการทดสอบอิสระแสดงว่ามันไม่ผ่าน Turnitin และ Turnitin จัดประเภท output ของ AI ที่ถูก paraphrase ว่าเป็น AI-generated โดยตรง การใช้งานหนักมักทำให้คะแนน AI สูงขึ้น มากกว่าจะลดลง บนข้อความเชิงวิชาการ และการจัดการการอ้างอิงก็ไม่น่าเชื่อถือในข้อความที่มีการอ้างอิงหนาแน่น
เหมาะเป็นตัวเลือกเพื่อความสะดวกสำหรับผู้ใช้ QuillBot ที่มีอยู่แล้วและกำลังทำงานกับข้อความทั่วไป ไม่ใช่ตัวเลือกที่เหมาะสำหรับงานส่งที่ถูกประเมินด้วย Turnitin
8. HIX Bypass: การเขียนใหม่แบบเข้มข้นโดยแลกกับน้ำเสียงเชิงวิชาการ
หลีกเลี่ยงการตรวจจับ 78% อัตราการหลบเลี่ยงในผลทดสอบห้องแล็บของเรา | 4/5 |
น้ำเสียงเชิงวิชาการ ผลลัพธ์หลายชุดอ่านคล้ายงานสื่อวิทยาศาสตร์ | 2/5 |
การจัดการการอ้างอิง ไม่รับรู้การอ้างอิง | 2/5 |
คงศัพท์สำคัญ ศัพท์เทคนิคมักถูกทำให้ง่ายลง | 3/5 |
คุณภาพไวยากรณ์ โหมดที่แข็งที่สุดให้ร้อยแก้วที่หยาบที่สุด | 3/5 |
การเขียนใหม่แบบเข้มข้นทำให้อัตราการหลบเลี่ยงอยู่ในระดับนั้น แต่ต้องแลกมากับน้ำเสียงเชิงวิชาการ ผลลัพธ์หลายชุดอ่านคล้ายงานสื่อวิทยาศาสตร์มากกว่างานวิจัย คำศัพท์เทคนิคถูกทำให้ง่ายลงบ่อยครั้ง ดังนั้นเราจึงไม่แนะนำสำหรับข้อความระดับต้นฉบับเชิงวิชาการ
โหมดการเขียนใหม่ทั้งสี่โหมดแลกคุณภาพกับความแข็งแรงของการหลบเลี่ยง และโหมดที่แข็งที่สุดให้ร้อยแก้วที่หยาบที่สุด แผนบริการเริ่มต้นที่ประมาณ $14.99 ต่อเดือนสำหรับโควตาคำจำนวนไม่มาก สำหรับเนื้อหาเว็บทั่วไปภายในชุด HIX นั้นถือว่าใช้งานได้ แต่สำหรับงานเขียนวิจัย การสูญเสียน้ำเสียงเชิงวิชาการนั้นถือว่าไม่เหมาะสม
9. BypassGPT: ตัวเลือกประหยัดงบพร้อมข้อจำกัดที่เข้มงวด
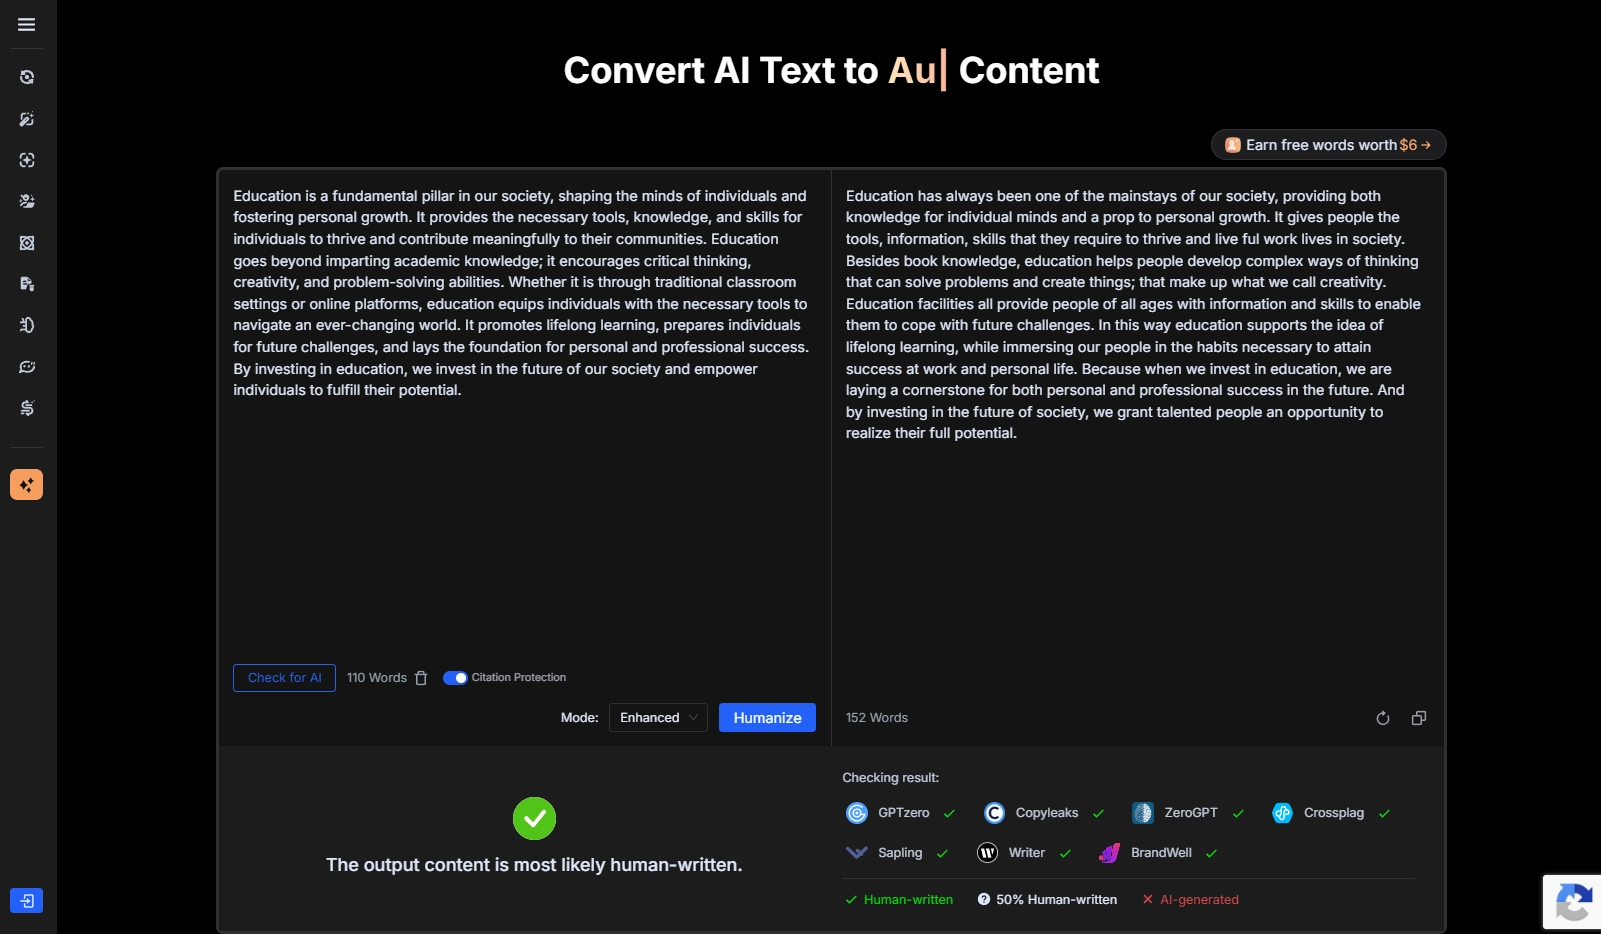
หลีกเลี่ยงการตรวจจับ ประสิทธิภาพที่รายงานอยู่ในระดับปานกลางสำหรับข้อความทั่วไป | 3/5 |
น้ำเสียงเชิงวิชาการ ไม่มีการควบคุมระดับภาษาเชิงวิชาการ | 2/5 |
การจัดการการอ้างอิง มีตัวเลือกสลับการป้องกัน แต่ไม่รับรู้ลักษณะสไตล์การเขียน | 2/5 |
คงศัพท์สำคัญ คุณภาพลดลงเมื่อเป็นข้อความเชิงเทคนิค | 2/5 |
คุณภาพไวยากรณ์ ยอมรับได้กับข้อความไม่เป็นทางการ | 3/5 |
BypassGPT ขายด้วยจุดเด่นด้านราคา โดยแผนเริ่มต้นอยู่ที่ประมาณ $12 ต่อเดือน สำหรับโควตารายเดือน 5,000 คำ
สิ่งที่รีวิวรายงานคือ ประสิทธิภาพในการหลีกเลี่ยงการตรวจอยู่ในระดับปานกลางสำหรับข้อความทั่วไป โดยคุณภาพจะลดลงเมื่อเป็นเนื้อหาทางเทคนิค โควตารายเดือนที่มีขนาดเล็กหมดลงอย่างรวดเร็วเมื่อใช้กับเอกสารเชิงวิชาการ, บทหนึ่งของวิทยานิพนธ์เพียงบทเดียวอาจใช้ไปเกือบทั้งหมดในครั้งเดียว
ไม่มีการรับรู้การอ้างอิง, ไม่มีการควบคุมระดับภาษาทางวิชาการ เหมาะสำหรับงานสั้นๆ เป็นครั้งคราวที่เป็นข้อความไม่เป็นทางการ ความสามารถไม่เพียงพอสำหรับงานเขียนเชิงวิจัย ทั้งในด้านคุณภาพและปริมาณ
10. StealthWriter: อินเทอร์เฟซโปร่งใส, วิธีการเสี่ยง
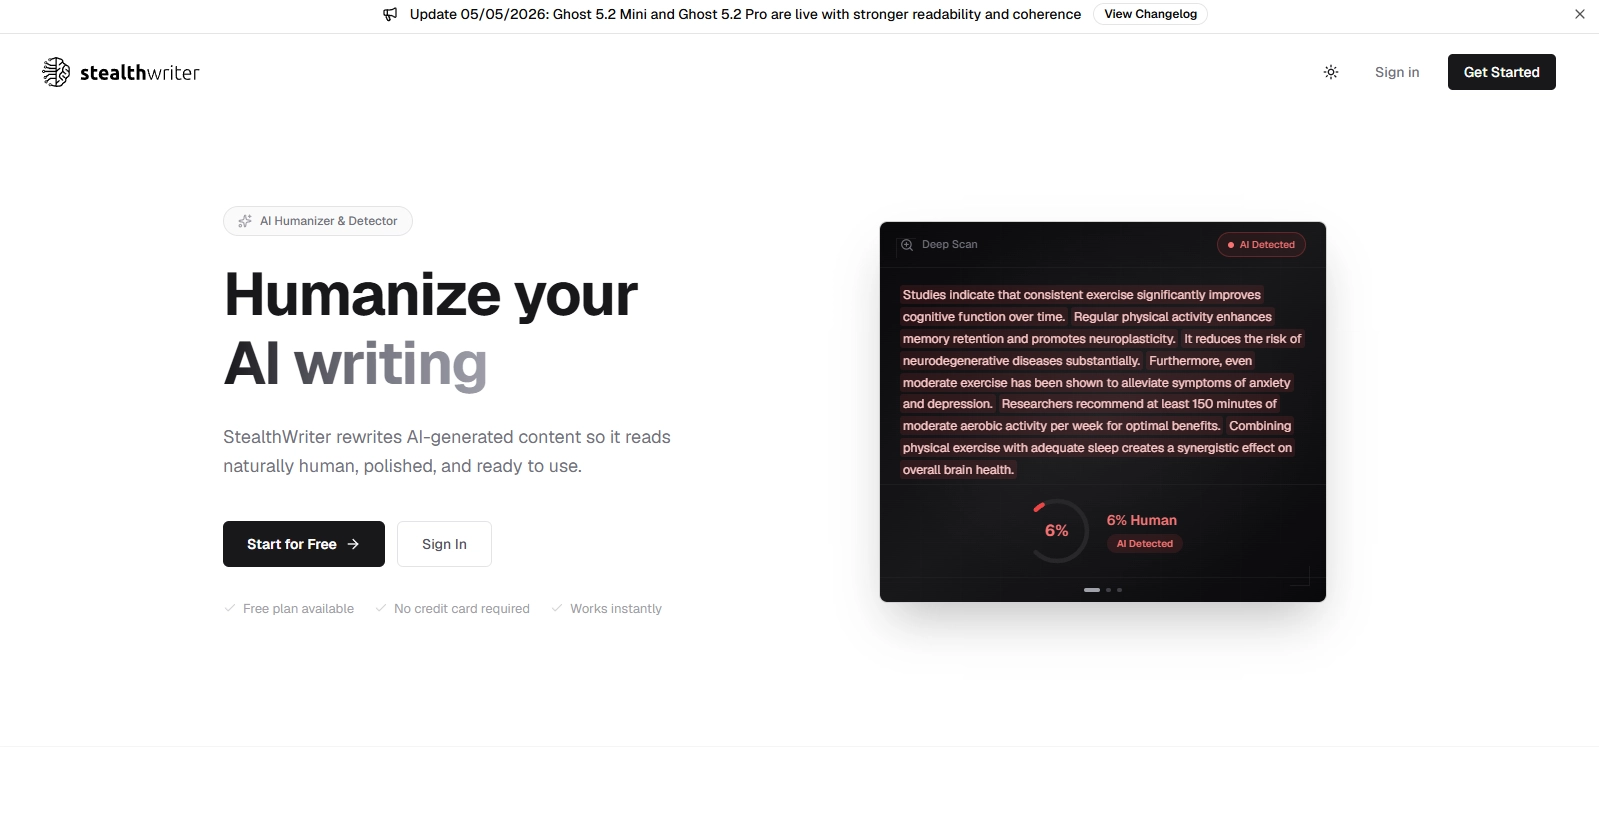
หลีกเลี่ยงการตรวจจับ การทดสอบอิสระแสดงให้เห็นว่ายังคงมีปัญหาเมื่อใช้กับ Turnitin และ Originality.ai | 2/5 |
น้ำเสียงเชิงวิชาการ ระดับภาษาเสื่อมลงจากการแทรกข้อผิดพลาด | 1.5/5 |
การจัดการการอ้างอิง ไม่มีการรับรู้เรื่องการอ้างอิง | 1.5/5 |
คงศัพท์สำคัญ การสลับในระดับประโยคกระทบต่อคำศัพท์เฉพาะทาง | 2/5 |
คุณภาพไวยากรณ์ แทรกข้อผิดพลาดโดยเจตนาเพื่อหลอกเครื่องมือตรวจจับ | 1.5/5 |
StealthWriter สมควรได้รับเครดิตสำหรับแนวคิดที่ชาญฉลาด มุมมองระดับประโยคที่ใช้รหัสสีช่วยให้คุณเห็นอย่างชัดเจนว่าอะไรเปลี่ยนไปบ้าง ซึ่งให้ความโปร่งใสมากกว่าเครื่องมือส่วนใหญ่ในรายการนี้
ปัญหาอยู่ที่วิธีการ เพื่อหลอกเครื่องมือตรวจจับ มันจะใส่ข้อผิดพลาดโดยตั้งใจ และข้อผิดพลาดเหล่านั้นทำลายความอ่านง่ายที่ผู้อ่านเชิงวิชาการคาดหวัง ขณะเดียวกันการทดสอบอิสระก็ยังแสดงให้เห็นว่ามันยังมีปัญหากับ Turnitin และ Originality.ai การลดคุณภาพร้อยแก้วของคุณเพื่อไล่ตามคะแนนเป็นสิ่งที่ตรงข้ามกับสิ่งที่บทความต้องการ และผู้ประเมินจะสังเกตประโยคที่ไม่เรียบร้อยได้ก่อนที่เครื่องมือตรวจจับจะทำเสียอีก แผนมีตั้งแต่ประมาณ $20 ต่อเดือน
11. Humbot: อ่อนที่สุดในการทดสอบในแล็บของเรา
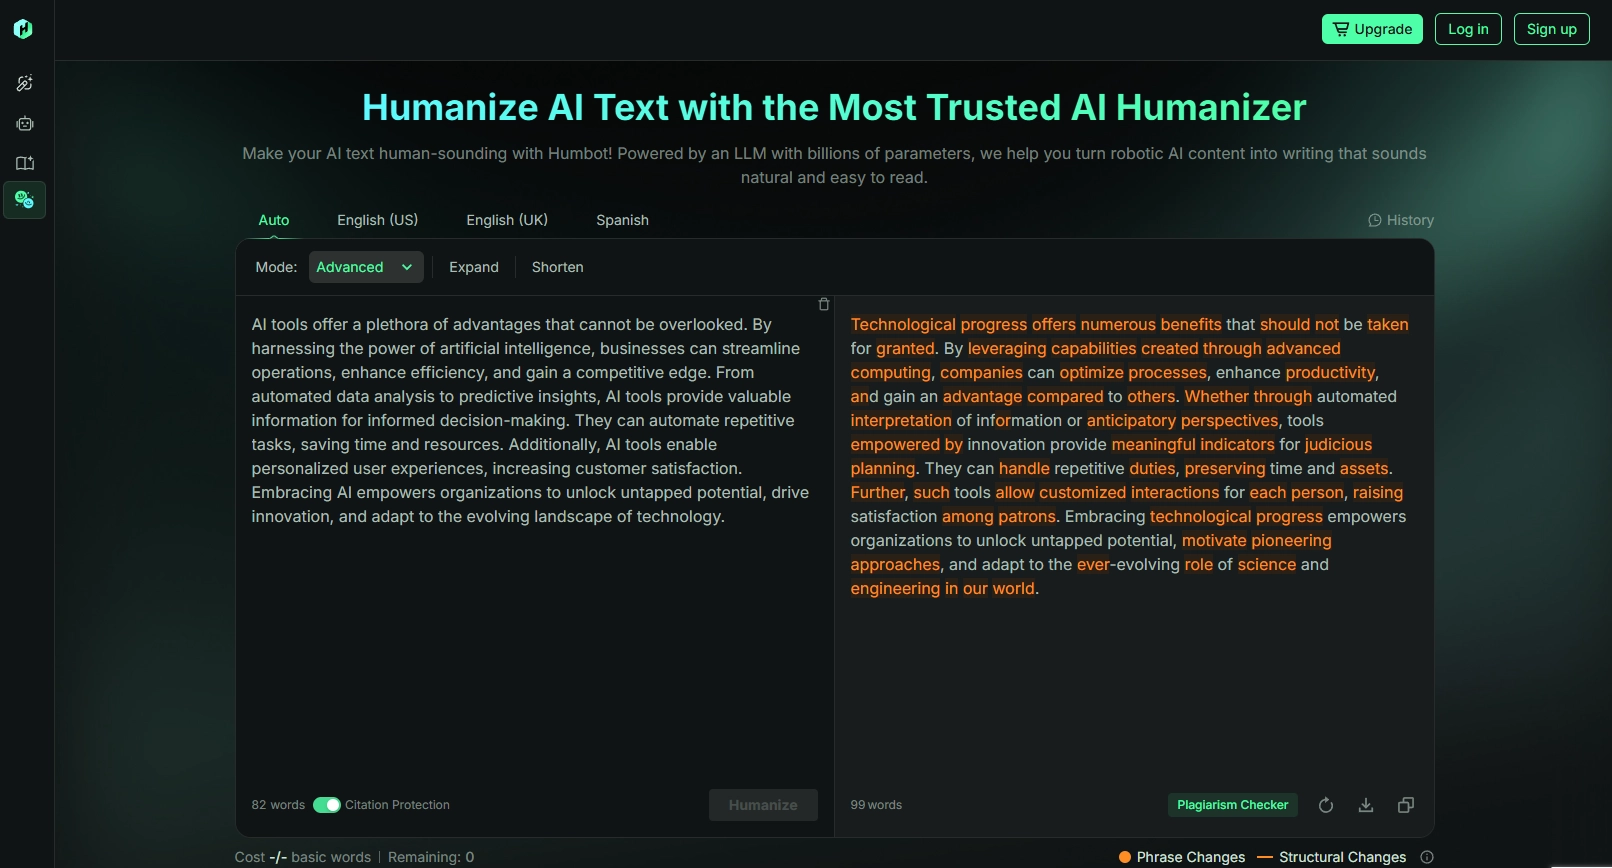
หลีกเลี่ยงการตรวจจับ อัตราการ bypass 70% ในการทดสอบในแล็บของเรา | 3.5/5 |
น้ำเสียงเชิงวิชาการ ระดับภาษาตกต่ำกว่าคุณภาพระดับวารสาร | 2/5 |
การจัดการการอ้างอิง การอ้างอิงเพี้ยนใน 3 จาก 10 ตัวอย่าง | 2/5 |
คงศัพท์สำคัญ ถ้อยคำเชิงเทคนิคเสื่อมคุณภาพในหลายตัวอย่าง | 2/5 |
คุณภาพไวยากรณ์ เกิดข้อผิดพลาดทางไวยากรณ์ใน 4 จาก 10 ตัวอย่าง | 2/5 |
อัตรา bypass อยู่ในระดับที่ยอมรับได้ แต่คุณภาพของผลลัพธ์ต่ำ การใช้เครื่องมือนี้จะสร้างภาระในการแก้ไขมากกว่าที่ช่วยประหยัดได้
ราคาเริ่มต้นอยู่ที่ประมาณ $12 ต่อเดือน สำหรับข้อความใดก็ตามที่คุณภาพมีความสำคัญ ค่าใช้จ่ายในการปรับแก้จะหักล้างความถูกของราคาไปจนหมด
12. Grubby AI: ข้อความสั้นแบบไม่เป็นทางการเท่านั้น
หลีกเลี่ยงการตรวจจับ ผลลัพธ์ที่รายงานไม่สอดคล้องกันเมื่อใช้กับข้อความที่ยาวขึ้น | 2.5/5 |
น้ำเสียงเชิงวิชาการ ให้ผลลัพธ์ในโทนไม่เป็นทางการเท่านั้น | 1.5/5 |
การจัดการการอ้างอิง ไม่มีการจัดการการอ้างอิงในรูปแบบใดเลย | 1.5/5 |
คงศัพท์สำคัญ ไม่ได้ออกแบบมาสำหรับเนื้อหาเชิงเทคนิค | 2/5 |
คุณภาพไวยากรณ์ ทำงานได้พอสมควรกับข้อความสั้นและเรียบง่าย | 3/5 |
Grubby AI คือกลุ่มผลิตภัณฑ์สายแก้ไขด่วนของตลาด, วางข้อความสั้นลงไปแล้วได้ฉบับเรียบเรียงใหม่กลับมา, ในระดับราคาที่ต่ำที่สุดกลุ่มหนึ่ง, เริ่มต้นที่ประมาณ $7 ต่อเดือนเมื่อชำระรายปี สำหรับโควตาคำรายเดือนขนาดเล็ก
สิ่งที่รีวิวรายงาน: ได้ผลพอใช้กับข้อความสั้นและเรียบง่าย, แต่คุณภาพไม่สม่ำเสมอเมื่อเป็นเนื้อหาที่ยาวขึ้นหรือมีความเป็นเทคนิคมากขึ้น. ไม่มีเครื่องมือสำหรับงานวิชาการในทุกรูปแบบ
สำหรับย่อหน้าข้อความแบบไม่เป็นทางการ, นี่เป็นตัวเลือกประหยัดที่ยอมรับได้. แต่สำหรับงานใดก็ตามที่มีการอ้างอิง, ศัพท์เทคนิค, หรือมีคะแนนกำกับ, มันไม่ได้ถูกออกแบบมาเพื่อใช้งานนั้น
การเปรียบเทียบฉบับเต็ม
| Tool | Academic tone | Citation handling | Long-document fit |
|---|---|---|---|
| ProofreaderPro.ai | ได้รับการฝึกสำหรับรูปแบบเชิงวิชาการ | รักษา APA, MLA, Chicago, IEEE, Turabian ไว้ | เอกสารฉบับเต็ม, ส่งออกแบบ tracked-changes |
| Undetectable.ai | เปลี่ยนไปเป็นสำนวนสนทนา | บางครั้งมีการจัดรูปแบบใหม่ | รองรับข้อความยาวได้ดี, ไม่มี tracked changes |
| Phrasly | รูปแบบทั่วไป | โฆษณาว่ารองรับ, แต่ไม่รับรู้รูปแบบสไตล์ | 2,500 words ต่อครั้ง |
| StealthGPT | รูปแบบทั่วไป | ไม่รับรู้การอ้างอิง | 1,500 words ต่อคำขอ |
| WriteHuman | พอใช้ได้ | มักมีการปรับโครงสร้างใหม่ | 600–3,000 words ต่อคำขอ |
| Walter Writes AI | รูปแบบทั่วไป | ไม่รับรู้การอ้างอิง | กลุ่มปริมาณขนาดใหญ่ |
| QuillBot Humanizer | เนี้ยบแต่ยังเป็นแบบทั่วไป | ไม่น่าเชื่อถือเมื่อมีการอ้างอิงหนาแน่น | มีข้อจำกัดตามชุดเครื่องมือ |
| HIX Bypass | ทำให้รูปแบบเรียบง่ายลง | ไม่รับรู้การอ้างอิง | ปริมาณคำขนาดเล็กเมื่อเริ่มใช้งาน |
| BypassGPT | รูปแบบทั่วไป | ไม่รับรู้การอ้างอิง | 5,000 words ต่อเดือนเมื่อเริ่มใช้งาน |
| StealthWriter | คุณภาพลดลงจากการใส่ข้อผิดพลาด | ไม่รับรู้การอ้างอิง | จำกัดจำนวนคำตามแผน |
| Humbot | มีการใส่ข้อผิดพลาดเข้าไป | บิดเบือนในชุดทดสอบของเรา | มีระดับตามปริมาณใช้งาน |
| Grubby AI | ใช้ได้เฉพาะงานไม่เป็นทางการ | ไม่รับรู้การอ้างอิง | ข้อความสั้น |
การเปรียบเทียบราคา
เฉพาะแผนแบบชำระเงิน พร้อมโควตาคำต่อเดือนเมื่อผู้ให้บริการเผยแพร่ไว้ ราคาเป็นราคารายเดือน ณ เดือนสิงหาคม 2026 เว้นแต่จะระบุไว้เป็นอย่างอื่น, ผู้ให้บริการส่วนใหญ่มักลดราคารายปีอย่างมาก ตรวจสอบหน้าราคาของผู้ให้บริการก่อนซื้อ, เพราะราคาเหล่านี้เปลี่ยนแปลงบ่อย
| Tool | Entry paid plan | Monthly words | Higher tiers |
|---|---|---|---|
| ProofreaderPro.ai | Academic, $19/mo | 25,000 | Academic Plus, $29/mo, 50,000 words |
| Undetectable.ai | About $10/mo (about $5/mo annual) | 10,000 | Up to 50,000 words tiers |
| Phrasly | Unlimited, about $17/mo (about $11/mo annual) | Not metered, 2,500-word runs | Single plan |
| StealthGPT | About $30/mo | Metered per request, about 1,500 words each | Higher-volume tiers to about $100/mo |
| WriteHuman | Basic, $12/mo | About 48,000 (80 runs x 600 words) | Pro $18/mo, Ultra $36/mo unlimited runs |
| Walter Writes AI | About $49/mo | 300,000 | Volume tiers into millions of words |
| QuillBot Premium | $19.95/mo (about $8.33/mo annual) | Humanizer included in Premium | Single plan |
| HIX Bypass | Basic, $14.99/mo | 5,000 | Pro $29.99/mo 50,000; Unlimited $59.99/mo |
| BypassGPT | About $12/mo | 5,000 | Higher tiers available |
| StealthWriter | Basic, $20/mo | Metered per request, 400 words each | Standard $35/mo 50,000 words; Premium $50/mo |
| Humbot | About $12/mo | Small pool at entry, tiers vary | Volume tiers available |
| Grubby AI | About $7/mo (annual) | About 7,500 | Pro about $9/mo, 30,000 words |
คะแนน humanizer ทั้ง 12 รายการเปรียบเทียบกัน
เครื่องมือทั้งหมดข้างต้นได้รับคะแนนตามเกณฑ์วิชาการ 5 ข้อเดียวกัน ได้แก่ การหลบเลี่ยงการตรวจจับ, โทนเชิงวิชาการ, การจัดการการอ้างอิง, การคงรักษาคำสำคัญ, และคุณภาพไวยากรณ์ เครื่องมือที่ผ่านการทดสอบในห้องปฏิบัติการมีคะแนนที่วัดได้จาก benchmark 10 ตัวอย่างของเรา ส่วนที่เหลือเป็นคะแนนที่ประเมินจากพฤติกรรมที่มีเอกสารรองรับ, แผนการใช้งานที่เผยแพร่, และรายงานการทดสอบอิสระ จัดเรียงตามคะแนนรวม:
| Tool | Bypass | Tone | Citations | Key terms | Grammar | Total |
|---|---|---|---|---|---|---|
| ProofreaderPro.ai | 4.5 | 5 | 5 | 4.5 | 5 | 24 / 25 |
| Undetectable.ai | 5 | 3 | 3 | 3 | 3.5 | 17.5 / 25 |
| WriteHuman | 3.5 | 3.5 | 2.5 | 3 | 3.5 | 16 / 25 |
| Phrasly | 3.5 | 2.5 | 3 | 2.5 | 4 | 15.5 / 25 |
| HIX Bypass | 4 | 2 | 2 | 3 | 3 | 14 / 25 |
| Walter Writes AI | 3.5 | 2.5 | 1.5 | 2.5 | 3.5 | 13.5 / 25 |
| QuillBot Humanizer | 1.5 | 3 | 2 | 2.5 | 4 | 13 / 25 |
| StealthGPT | 3.5 | 2 | 1.5 | 2 | 3 | 12 / 25 |
| BypassGPT | 3 | 2 | 2 | 2 | 3 | 12 / 25 |
| Humbot | 3.5 | 2 | 2 | 2 | 2 | 11.5 / 25 |
| Grubby AI | 2.5 | 1.5 | 1.5 | 2 | 3 | 10.5 / 25 |
| StealthWriter | 2 | 1.5 | 1.5 | 2 | 1.5 | 8.5 / 25 |
คำตัดสินของเรา
หากคุณเป็นนักวิจัยหรือนักศึกษาระดับบัณฑิตศึกษา หมวดหมู่นี้จะคัดแยกตัวมันเองได้อย่างรวดเร็ว เครื่องมือทั้งสิบเอ็ดจากสิบสองรายการนี้ถูกสร้างขึ้นสำหรับเนื้อหาทั่วไป และสิ่งนี้ก็ปรากฏให้เห็นในจุดเดิม ๆ สามจุดทุกครั้ง, การอ้างอิงถูกย้ายหรือบิดเบือน, คำสำคัญถูกทำให้ง่ายเกินไป, และระดับภาษาค่อย ๆ เบี่ยงไปทางบทความบล็อก พวกมันเป็นเครื่องมือที่ใช้ได้ดีสำหรับงานที่ถูกสร้างมาให้นั้น แต่งานนั้นไม่ใช่ต้นฉบับของคุณ
สำหรับข้อความเชิงวิชาการ ProofreaderPro.ai ไม่มีคู่แข่ง มันถูกฝึกด้วยงานวิจัยที่ผ่านการทบทวนโดยผู้ทรงคุณวุฒิและเขียนโดยมนุษย์ ดังนั้นจึงคงการอ้างอิงแบบ APA, MLA, Chicago, Turabian, และ IEEE เชิงตัวเลขไว้ตรงตำแหน่งเดิมที่คุณวางไว้ ปกป้องนิพจน์ทางสถิติและคำสำคัญเฉพาะสาขา รักษาความแม่นยำทางไวยากรณ์ให้อยู่เหนือ 96%, คงโทนภาษาเชิงวิชาการที่เป็นทางการตลอดการปรับแก้, และส่งออกทุกอย่างไปยัง Word ในรูปแบบ tracked changes ที่อาจารย์ที่ปรึกษาของคุณตรวจสอบได้ นอกจากนี้ยังเป็นเครื่องมือเดียวในรายการนี้ที่เผยแพร่ผลลัพธ์ corpus สำหรับ benchmark ของตน แทนที่จะเป็นเปอร์เซ็นต์ทางการตลาด หากงานเขียนของคุณจะไปอยู่ต่อหน้าวารสาร คณะกรรมการ หรือพอร์ทัลของ Turnitin ให้เริ่มจากเครื่องมือที่สร้างมาเพื่อสิ่งนั้น และเก็บตัวปรับถ้อยคำอเนกประสงค์ไว้สำหรับข้อความทั่วไปของคุณ
การทำให้ข้อความดูเป็นงานวิชาการ
ผ่านการทดสอบกับ Turnitin, GPTZero, และ Originality.ai สร้างขึ้นเพื่อรักษาการอ้างอิง คำศัพท์ และน้ำเสียงเชิงวิชาการของคุณ
ลองใช้ ProofreaderPro.ai ฟรีควรใช้ระดับการทำให้เป็นธรรมชาติมนุษย์ระดับใด?
การทดสอบมาตรฐานของเราจะประมวลผลเอกสารแต่ละฉบับที่การตั้งค่าความเข้มข้นสองระดับ แนวแลกเปลี่ยนมีความสม่ำเสมอ การทำให้เป็นธรรมชาติมนุษย์แบบเข้มข้นให้ผลอัตราการผ่านของตัวตรวจจับสูงที่สุด, สามารถทำได้สูงถึง 92.33% เมื่อเทียบกับ Turnitin AI ในการรันล่าสุด และจะเขียนโครงสร้างประโยคใหม่อย่างลึกซึ้งกว่า ส่วนการทำให้เป็นธรรมชาติมนุษย์แบบสมดุลผ่านได้บ่อยน้อยกว่าเล็กน้อย (86.0% เมื่อเทียบกับ Turnitin AI) และคงอยู่ใกล้เคียงถ้อยคำต้นฉบับมากกว่า ทำให้การตรวจทานการเปลี่ยนแปลงที่ติดตามไว้รวดเร็วขึ้น สำหรับบทหนึ่งของวิทยานิพนธ์ที่ทุกข้ออ้างถูกถ้อยคำไว้อย่างรอบคอบ ให้เริ่มที่ Balanced และรันส่วนที่ถูกตั้งค่าสถานะใหม่ด้วย Aggressive สำหรับร่างช่วงต้น Aggressive ช่วยประหยัดหนึ่งรอบของการแก้ไข ความสอดคล้องเชิงความหมายยังคงสูงกว่า 94% ในทั้งสองการตั้งค่าในการรันของเรา ดังนั้นคุณยังคงรักษาความหมายไว้ไม่ว่าจะอย่างไร เพียงแต่เปลี่ยนว่าถ้อยคำบนผิวหน้าจะเปลี่ยนไปมากเพียงใด
AI humanizer ที่ดีที่สุดตามกรณีการใช้งาน
- งานวิชาการ วิทยานิพนธ์ และต้นฉบับบทความวารสาร: ProofreaderPro.ai, สำหรับการคงรูปแบบการอ้างอิง การรักษาศัพท์เฉพาะสาขา และการส่งออกแบบ tracked changes ลองใช้งานได้ที่ หน้า AI text humanizer
- ข้อกังวลเฉพาะ Turnitin: ดู คู่มือ Turnitin humanizer ของเรา ซึ่งอธิบายการทำงานของตัวบ่งชี้ AI และผลอัตราการผ่านที่พบในการใช้งานจริง
- เนื้อหาเว็บทั่วไปและงานเขียนการตลาด: Undetectable.ai จัดการกับสำนวนแบบไม่เป็นทางการได้ดี แม้ว่าจะทำให้คำศัพท์เชิงเทคนิคเรียบง่ายลงก็ตาม Phrasly เป็นทางเลือกที่เหมาะสมในด้านงบประมาณ พร้อมแผนไม่จำกัดของมัน
- การดำเนินงานด้านเนื้อหาปริมาณมาก: StealthGPT และ Walter Writes AI ต่างก็คิดค่าบริการตามปริมาณ แต่มีจุดราคาที่แตกต่างกันอย่างมาก
- ฉบับร่างที่ถูกทำเครื่องหมายไว้แล้วและต้องแก้ไขทันที: ทำตาม คู่มือทีละขั้นตอนเพื่อช่วยลดคะแนนการตรวจจับ AI ของเรา
ช่องว่างด้านการทำให้เป็นมนุษย์ในงานวิชาการที่เครื่องมือส่วนใหญ่พลาด
ปัญหาหลักคือ ตัว humanizer AI ส่วนใหญ่ถูกสร้างขึ้นมาสำหรับนักการตลาดคอนเทนต์และนักเขียน SEO พวกมันถูกออกแบบมาเพื่อทำให้บล็อกโพสต์และคำอธิบายสินค้าเล็ดรอดจากตัวตรวจจับ งานเขียนเชิงวิชาการมีข้อกำหนดที่แตกต่างกันอย่างสิ้นเชิง
ในบล็อกโพสต์ การสลับคำว่า "demonstrate" เป็น "show" ก็ไม่เป็นไร แต่ในงานวิจัย คำว่า "demonstrate" อาจมีนัยเชิงวิธีวิจัยเฉพาะที่ "show" ไม่มี
ในงานเขียนการตลาด การย้ายการอ้างอิงไปตำแหน่งอื่นไม่ใช่เรื่องสำคัญ แต่ในบทความวิชาการ "(Smith et al., 2024)" ต้องคงอยู่ตรงตำแหน่งเดิมที่ผู้เขียนวางไว้ เพราะการวางการอ้างอิงในระดับประโยคบ่งชี้ว่าข้อความใดกำลังถูกอ้างอิง
ในเนื้อหาทั่วไป การใช้ภาษาระดับไม่เป็นทางการถือเป็นจุดเด่น แต่ในต้นฉบับบทความวารสาร กลับเป็นเหตุผลให้ส่งต้นฉบับกลับไปแก้ไข
นี่คือเหตุผลที่เครื่องมือที่สร้างมาสำหรับเนื้อหาทั่วไปจึงมีปัญหาเมื่อเจอกับข้อความเชิงวิชาการ พวกมันกำลังแก้ปัญหาผิดจุด นักวิจัยต้องการข้อความที่ตรวจจับไม่ได้ซึ่งผู้ประเมินบทความจะยอมรับ และนั่นคือมาตรฐานสองแบบที่ไม่เหมือนกัน
หากต้องการเข้าใจลึกขึ้นว่า การตรวจจับทำงานอย่างไร และล้มเหลวตรงไหน โปรดดู ผลการทดสอบความแม่นยำของการตรวจจับ AI.
คำแนะนำของเราสำหรับนักวิจัย
หากคุณกำลังทำให้ข้อความวิชาการที่ช่วยด้วย AI ดูเป็นมนุษย์มากขึ้น นี่คือสิ่งที่เราแนะนำตามผลการทดสอบของเรา:
สำหรับต้นฉบับบทความวิชาการและวิทยานิพนธ์: ใช้ humanizer ที่ออกแบบมาสำหรับงานวิชาการโดยเฉพาะ text humanizer ของเราได้คะแนนสูงสุดสำหรับงานเขียนเชิงวิจัย ควรตามด้วยการตรวจทานด้วยตนเองอีกครั้งเพื่อจับกรณีเฉพาะที่เกี่ยวข้องกับคำศัพท์เชิงเทคนิค จากนั้นนำผลลัพธ์ไปผ่าน detector เพื่อยืนยันก่อนส่งงาน
สำหรับงานเขียนเชิงวิชาการที่ไม่สำคัญมาก เช่น abstracts สำหรับการประชุม รายงานภายใน และร่างข้อเสนอโครงการขอทุน: WriteHuman หรือ Undetectable.ai อาจใช้งานได้ หากคุณพร้อมที่จะปรับโทนภายหลัง
สำหรับเนื้อหาที่ไม่ใช่งานวิชาการ: Undetectable.ai ให้ผลการหลบตรวจที่ดิบสูงที่สุดในการทดสอบในห้องทดลองของเรา และเป็นตัวเลือกที่เหมาะสมเมื่อโทนเชิงวิชาการไม่ใช่ข้อกำหนด Phrasly แผนไม่จำกัดของ Phrasly เป็นตัวเลือกคุ้มค่าสำหรับงานปริมาณสม่ำเสมอ
ไม่ว่าจะใช้เครื่องมือใด: ควรตรวจทานผลลัพธ์ที่ผ่านการ humanize เสมอ ไม่มีเครื่องมือใดสมบูรณ์แบบ อ่านออกเสียง ตรวจสอบการอ้างอิงของคุณให้ดี ตรวจให้แน่ใจว่ามันฟังดูเหมือนสิ่งที่คุณจะเขียนเอง หากไม่ใช่ ให้แก้ไขจนกว่าจะใช่
และควรจับคู่การ humanize กับการตรวจพิสูจน์อักษรที่เหมาะสมเสมอ AI proofreader ของเราช่วยจับข้อผิดพลาดด้านไวยากรณ์ที่บางครั้งเกิดขึ้นจากการ humanize ได้ สำหรับเวิร์กโฟลว์แบบทีละขั้นตอนในการ humanize ข้อความวิชาการด้วยตนเอง โปรดอ่านคู่มือของเราเกี่ยวกับ how to humanize AI text สำหรับบทความวิจัย
เครื่องมือที่ดีทำให้งานเขียนของคุณดีขึ้น เครื่องมือที่ดีที่สุดทำให้งานเขียนของคุณฟังดูเป็นตัวคุณจริง ๆ
อ่านเพิ่มเติม
- ประโยชน์ของการทำให้ข้อความ AI เป็นธรรมชาติสำหรับนักวิจัย
- วิธีหลีกเลี่ยงการตรวจจับ AI ในงานเขียนเชิงวิชาการ
- ProofreaderPro.ai vs ChatGPT สำหรับงานเขียนเชิงวิชาการ
คำถามที่พบบ่อย
Q: AI humanizer ตัวไหนใช้งานได้ดีที่สุดสำหรับบทความวิจัย?
จากการทดสอบของเรา ProofreaderPro.ai ได้คะแนนสูงสุดสำหรับข้อความเชิงวิชาการ ด้วยคะแนน 24 จาก 25 คะแนน โดยมีการผสมผสานที่ดีที่สุดระหว่างอัตราการหลบเลี่ยงการตรวจจับ การคงโทนทางวิชาการ และการจัดการการอ้างอิง Undetectable.ai มีอัตราการหลบเลี่ยงแบบดิบที่สูงกว่า แต่ได้คะแนนต่ำกว่าในด้านโทนและคำศัพท์ ทำให้เหมาะกับเนื้อหาทั่วไปมากกว่าต้นฉบับคุณภาพระดับวารสาร ปัจจัยสำคัญสำหรับการใช้งานทางวิชาการคือเครื่องมือนั้นสามารถคงคำศัพท์เชิงเทคนิคและรูปแบบการอ้างอิงไว้ได้หรือไม่ ซึ่ง humanizer ทั่วไปส่วนใหญ่ทำไม่ได้
Q: AI humanizer ฟรีดีไหม?
AI humanizer ฟรีส่วนใหญ่ที่เราทดสอบให้ผลลัพธ์คุณภาพต่ำกว่าทางเลือกแบบเสียเงินอย่างเห็นได้ชัด ปัญหาที่พบบ่อย ได้แก่ การอ้างอิงเสียหาย คำศัพท์ถูกทำให้ง่ายลง ความผิดพลาดทางไวยากรณ์ที่เกิดขึ้นระหว่างการเขียนใหม่ และโทนที่ไม่สม่ำเสมอ เครื่องมือฟรีบางตัวใช้งานได้พอสมควรกับข้อความสั้น ๆ ที่ไม่ซับซ้อน แต่ต้นฉบับเชิงวิชาการไม่ใช่ทั้งสั้นและไม่ซับซ้อน หากบทความของคุณสะท้อนงานวิจัยที่ใช้เวลาหลายเดือนหรือหลายปี การใช้เครื่องมือฟรีที่อาจสร้างข้อผิดพลาดหรือทำลายโทนเชิงวิชาการของคุณ เป็นปัญหาที่คุณจะต้องกลับไปจัดการทีหลัง โดยในทางปฏิบัติแล้วอาจต้องเขียนเวอร์ชันที่ humanize ใหม่ทั้งฉบับเสียเกือบทั้งหมด เครื่องมือแบบเสียเงินส่วนใหญ่มักมีทดลองใช้ฟรี ดังนั้นควรใช้ส่วนนี้ในการทดสอบก่อนตัดสินใจซื้อ
Q: AI humanizer สามารถคงคำศัพท์เชิงวิชาการไว้ได้หรือไม่?
ขึ้นอยู่กับเครื่องมือ Humanizer แบบใช้งานทั่วไปมักแทนที่คำศัพท์เทคนิคด้วยคำที่ง่ายกว่า เพราะข้อมูลฝึกสอนของพวกเขาส่วนใหญ่เป็นเนื้อหาที่ไม่ใช่เชิงวิชาการ Humanizer เฉพาะทางด้านวิชาการอย่าง ProofreaderPro.ai ถูกออกแบบมาให้รู้จักและปกป้องคำศัพท์เฉพาะสาขา สำนวนเชิงสถิติ และรูปแบบการอ้างอิง จากการทดสอบของเรา อัตราการคงไว้ซึ่งคำศัพท์เชิงวิชาการอยู่ระหว่าง 65% ถึง 95% ขึ้นอยู่กับเครื่องมือ ควรตรวจสอบผลลัพธ์ที่ humanize แล้วทุกครั้งเพื่อความถูกต้องของคำศัพท์ก่อนส่งงาน เพราะแม้แต่เครื่องมือที่ดีที่สุดก็ยังอาจถอดความคำเทคนิคใหม่โดยไม่จำเป็นเป็นครั้งคราว
Q: AI humanizer ที่ดีที่สุดสำหรับการเขียนเชิงวิชาการคืออะไร?
ProofreaderPro.ai มันเป็น humanizer เพียงตัวเดียวในการเปรียบเทียบนี้ที่สร้างขึ้นมาโดยเฉพาะสำหรับงานเขียนเชิงวิจัย, การอ้างอิง, คำศัพท์เทคนิค, และภาษาระดับทางการยังคงอยู่หลังการเขียนใหม่ และผลลัพธ์สามารถส่งออกไปยัง Word ในรูปแบบ tracked changes ได้ ใน benchmark ที่มีเอกสาร 2,000 ฉบับของเรา เครื่องมือนี้ผ่านการตรวจจับ AI ของ Turnitin ได้ในเอกสารสูงสุดถึง 92.33%
Q: AI humanizer คงการอ้างอิงไว้ได้หรือไม่?
ส่วนใหญ่ไม่สามารถทำได้ Humanizer แบบใช้งานทั่วไปมองการอ้างอิงในเนื้อหาเป็นร้อยแก้วธรรมดาและเขียนใหม่ จนทำให้เอกสารถูกรบกวน Humanizer เชิงวิชาการจะปกป้องสตริงของการอ้างอิงระหว่างการเขียนใหม่ นี่เป็นหนึ่งในเกณฑ์ที่เราให้คะแนนในการเปรียบเทียบข้างต้น
Q: แผน humanizer แบบไม่จำกัดคุ้มค่าหรือไม่?
ปริมาณไม่ใช่ข้อกังวลหลักในที่นี้ การ humanize ข้อความของคุณทีละส่วนและได้คุณภาพที่ดีจากกระบวนการ ย่อมดีกว่าการ humanize ทั้งเอกสารแบบจำนวนมากแล้วได้ผลลัพธ์คุณภาพต่ำ
Q: เอ็นจิน humanizer ถูกสร้างขึ้นมาอย่างไร?
เอ็นจินเบื้องหลัง humanizer ของเราพัฒนาโดยนักวิจัยและวิศวกร NLP ที่ TextPulse ซึ่งได้ fine-tune โมเดลการทำให้เป็นภาษามนุษย์แบบเฉพาะทางบนชุดข้อมูลของเราเองที่ประกอบด้วยบทความวิจัยที่ผ่านการพิชญพิจารณ์และเขียนโดยมนุษย์ เอ็นจินนี้สร้างขึ้นสำหรับเนื้อหาเชิงวิจัยโดยเฉพาะ ทั้งการรองรับหลายภาษา ศัพท์เฉพาะสาขา การอ้างอิงในเนื้อหา ไวยากรณ์ที่ถูกต้อง และน้ำเสียงที่เป็นทางการ เราปรับปรุงเอ็นจินเป็นระยะจากความคิดเห็นของผู้ใช้และประชาคมวิจัยนานาชาติ และการปรับปรุงที่ขับเคลื่อนด้วยความคิดเห็นเหล่านี้เองที่ทำให้มันยังเป็น humanizer ที่เน้นงานวิชาการเป็นอันดับแรก ไม่ใช่เครื่องมือทั่วไปที่ฝึกจากบล็อกโพสต์แบบสนทนาและเนื้อหาโซเชียลมีเดีย

Moe เป็นวิศวกร NLP ที่มี PhD ในการประมวลผลภาษาธรรมชาติ งานวิจัยของเขาครอบคลุมภาษาศาสตร์เชิงคำนวณ การวิเคราะห์ข้อความ และการเรียนรู้ของเครื่อง และป้อนโดยตรงไปยังโมเดลการแก้ไขและการทำให้มีมนุษยธรรมที่อยู่เบื้องหลัง ProofreaderPro เขาเขียนเกี่ยวกับส่วนหนึ่งของกระบวนการที่คนส่วนใหญ่ไม่เคยเห็นมาก่อน เช่น วิธีที่โมเดลภาษาอ่านประโยค ให้คะแนน และตัดสินใจว่าจะเปลี่ยนแปลงอะไร


