Claude do pisania prac naukowych: praktyczny przewodnik
Praktyczne przepływy pracy z użyciem Claude jako asystenta do pisania naukowego, a także które aplikacje Claude, modele, poziomy zaangażowania i plany najlepiej pasują do poważnych badań.
W zeszłym miesiącu koleżanka udostępniła zrzut ekranu, pokazujący rozmowę z Claude, w której brainstormowała, tworzyła konspekt, pisała i przerabiała kompletny wstęp do artykułu naukowego w mniej niż godzinę. Ten sam fragment w poprzednim tygodniu zajmował jej trzy dni.
Korzystała z właściwego narzędzia AI na właściwym etapie procesu pisania.
Spędziliśmy miesiące, integrując Claude z przepływami pracy w pisaniu akademickim: naszymi i naszych użytkowników. Model ma realne mocne strony do pisania pod badania, ale ma też wyraźne ograniczenia. Wiedza o tym, kiedy używać go, a kiedy przełączyć się na inne narzędzie, robi różnicę między przeciętnym eksperymentem z AI a realnym zyskiem produktywności.
Dlaczego Claude dobrze sprawdza się w pisaniu akademickim
Claude radzi sobie z niuansami lepiej niż większość modeli językowych, które testowaliśmy, w tym ChatGPT, Gemini, Grok i Deepseek, a także inne. To ważne w pisaniu akademickim, ponieważ prawie całe pisanie akademickie opiera się na niuansach.
Kiedy prosisz Claude o pomoc w napisaniu sekcji dyskusji, zwykle zachowuje Twoje stopniowanie pewności. „Wyniki sugerują” zamiast „wyniki dowodzą”. Pochodzi za wskazówkami dotyczącymi rejestru i tonu bardziej konsekwentnie niż GPT w naszych testach porównawczych. A także rzadziej wytwarza nadmierną pewność, tam gdzie właściwe jest niepewne ujęcie.
Zauważyliśmy trzy konkretne mocne strony:
Obsługa długiego kontekstu. Claude potrafi przetwarzać bardzo długie dokumenty, nawet do 200K tokenów w obecnej wersji. To oznacza, że możesz wkleić całą część przeglądu literatury, pełną sekcję metod albo nawet szkic manuskryptu i zadać pytania na jego podstawie. Model utrzymuje spójność w całym tekście, zamiast gubić wątek po kilku tysiącach słów.
Podążanie za instrukcjami. Gdy mówisz Claude: „użyj czasu przeszłego, strony biernej, formalnego rejestru i nie interpretuj wyników”, to faktycznie to robi. Konsekwentnie. Mniejsze modele i nawet niektóre konkurencyjne duże modele potrafią odchodzić od konkretnych instrukcji w dłuższych odpowiedziach.
Szczera niepewność. Claude częściej powie „nie jestem pewien” albo „nie mam wystarczających informacji” zamiast zmyślać odpowiedź. W pracy naukowej, gdzie pewna halucynacja może podważyć Twoją wiarygodność, ma to ogromne znaczenie.
To wszystko nie znaczy, że Claude pisze za Ciebie Twoje artykuły. To oznacza, że jest naprawdę użytecznym asystentem, jeśli kierujesz nim właściwie.
Przepływ 1: burza mózgów i rozwijanie pomysłów
To właśnie tutaj rekomendujemy zacząć z Claude. Zanim napiszesz choć jedno słowo swojego artykułu.
Otwórz rozmowę i wyjaśnij swoje badania prostym językiem. Nie martw się akademicką formą. Powiedz Claude, co badałeś, co znalazłeś i co Twoim zdaniem to oznacza. Następnie poproś, by pomógł Ci zidentyfikować najmocniejsze perspektywy dla Twojego artykułu.
Oto szkielet promptu, którego używamy:
I'm writing a paper about [topic]. My main finding is [finding].
The existing literature says [brief summary]. I think my contribution
is [your interpretation].

Help me think through: What's the strongest framing for this paper?
What counterarguments should I address? What's the most interesting
aspect of my findings that I might be underemphasizing?
Zamień każdy [wstawiany w nawiasie placeholder] na własną treść, tutaj i w każdym kolejnym monicie. Linie z ograniczeniami to to, co oddziela użyteczne wyjście od ogólnego tekstu, więc zachowaj je.
Kiedy chcesz uporządkowanej odpowiedzi zamiast otwartej dyskusji, doprecyzuj prośbę:
I'm writing a paper about [topic] for [target journal]. My main finding is
[finding]. The closest prior work is [paper A] and [paper B], which concluded
[their conclusion]. State three candidate framings for my contribution, rank
them by novelty and defensibility, and name the strongest counterargument
against each.
Claude świetnie się do tego nadaje, ponieważ jest partnerem do myślenia, a nie maszyną do pisania. Model będzie pchać się w opór wobec słabych ujęć, podsuwał perspektywy, o których nie pomyślałeś, i pomagał ci wyraźniej sformułować własny wkład.
Użyliśmy tego w pracy z doktorantem po stażu, który miał trudność z ujęciem badania opartego na metodach mieszanych. W 20 minut ustaliła, że jej wyniki jakościowe przeczą powszechnie cytowanej ramie. To przeformułowanie stało się osią napędową jej artykułu. Przyjęte przy pierwszym zgłoszeniu.
Przepływ 2: synteza literatury i identyfikacja luk
Claude nie czyta artykułów. Musimy to jasno powiedzieć: model nie ma dostępu do baz danych i będzie halucynować cytowania, jeśli poprosisz go o nie. Może jednak syntetyzować informacje, które mu podasz.
Przebieg pracy:
- Przeczytaj samodzielnie swoje źródła. Sporządź notatki z kluczowych wyników, metod i wniosków.
- Wklej te notatki do Claude. Zorganizuj je według tematu lub chronologii.
- Poproś Claude, aby zidentyfikował wzorce, sprzeczności i luki w twoich notatkach.
Here are my notes on 12 papers about [topic]:
[paste organized notes]

Synthesize these into 3-4 thematic paragraphs for a literature review.
Identify where authors disagree, where methods differ, and what questions
remain unanswered. Use (Author, Year) citation format. Do not add any
sources I haven't provided.
To ostatnie polecenie jest kluczowe. Bez niego Claude czasem wstawi wiarygodnie brzmiące, ale całkowicie fikcyjne odniesienia. Każde cytowanie w wyniku musi być jednym z tych, które podałeś w danych wejściowych.
Odkryliśmy, że ten przepływ pracy skraca czas pisania przeglądu literatury o około 50%. To, co jest nadal twoje, to myślenie: które prace uwzględnić, jakie wyłaniają się wątki, gdzie są luki. Claude porządkuje twoje rozważania w formę tekstu.
Więcej monitu zaprojektowanych pod każdą sekcję twojego artykułu znajdziesz w naszej kolekcji sprawdzonych AI promptów do pisania akademickiego.
Przepływ 3: pisanie i strukturyzowanie sekcji
Tutaj Claude staje się asystentem pisania w tradycyjnym sensie. Masz swoje pomysły, dane i strukturę argumentacji. Potrzebujesz wsparcia w przekształcaniu wypunktowań w akapity.
Zalecamy podejście krok po kroku, sekcja po sekcji, zamiast prosić Claude'a o napisanie całego tekstu naraz. Jakość spada drastycznie, gdy prosisz o więcej niż 800 do 1 000 słów w jednej odpowiedzi.
Preferujemy taki przebieg:
- Dodaj konspekt. Przekaż Claudeowi strukturę rozdziału z wypunktowaniami pod każdym nagłówkiem.
- Określ ograniczenia. Liczba słów, czas, strona, rejestr, styl cytowań.
- Pisze jedną sekcję na raz. Przejrzyj każdą sekcję przed przejściem do następnej.
- Iteruj w trakcie rozmowy. Poproś Claudea, aby dostosował konkretne akapity: skróć ten, rozwiń tamten, aby przejście było płynniejsze.
Kluczowy wniosek: traktuj Claude'a jak ghostwritera, któremu potrzebne jest szczegółowe przygotowanie i obszerne briefingowanie. "Napisz moją sekcję dyskusji" generuje ogólny tekst. "Napisz akapit liczący 300 słów porównujący moje wyniki X ze Smith (2023) i Chen (2024), wskazując różnicę metodologiczną, która wyjaśnia rozbieżność" generuje coś przydatnego.
Trzy szablony obejmują większość sesji pisania. Aby zarysować sekcję przed jej napisaniem:
Build a paragraph-level outline for the [introduction/discussion] of a paper
on [topic]. Audience: [field] researchers. The section must move from
[opening premise] to [closing claim] in no more than [N] paragraphs. For
each paragraph give a one-line purpose and the evidence it should cite from
my notes: [paste notes].
Napisz akapit metodologiczny, który mieści się w tym, co faktycznie zrobiłeś:
Draft a [word count]-word methods paragraph describing [procedure]. Past
tense, passive voice, formal register, [citation style]. Include these
details exactly as given: [sample size, instruments, parameters]. Do not
add any procedure or measurement I have not listed.
Aby zamieniać wyniki w prozę, nie pozwalając modelowi ich interpretować:
Turn these results into two paragraphs of formal prose: [paste table or
bullet results]. Report every statistic exactly as written. Describe
patterns without interpreting them; interpretation belongs in the
discussion section.
Workflow 4: korekta i autokorekta
Po przygotowaniu szkicu, niezależnie od tego, czy powstał odręcznie, z pomocą Claude'a, czy jako połączenie, Claude staje się potężnym narzędziem do korekty.
Wklej fragment i zadawaj ukierunkowane pytania:
Review this paragraph for logical flow. Does the argument progress
clearly from premise to evidence to conclusion? Identify any gaps
in reasoning.
Reduce this paragraph from [current] to [target] words without losing any
claim, number, or citation: [paste paragraph]. Keep the academic register
and my terminology.
Read this section as a hostile reviewer for [journal]: [paste section].
List the five weakest points in order of severity, quote the exact sentence
each weakness lives in, and say what evidence or rewording would fix it.
Ten ostatni prompt to nasz ulubiony. Persona Claude’a „wrogiego recenzenta” wychwytuje luki logiczne, niepoparte twierdzenia i słabości strukturalne, które po wielu iteracjach stały się dla Ciebie niewidoczne. Nie wyłapie wszystkiego, co wychwyciłby prawdziwy recenzent, ale wychwytuje na tyle dużo, że warto te pięć minut.
Używamy też Claude’a do sprawdzania spójności między sekcjami przed złożeniem pracy:
Here are my abstract and conclusion: [paste both]. List every claim in the
abstract that the conclusion does not support, and every conclusion claim
missing from the abstract. Then check that every number appearing in both
matches exactly.
Niedopasowanie między sekcjami jest jednym z najczęstszych problemów na etapie poprawek i trudno je zauważyć, gdy tygodniami żyjesz w swoim tekście.
Kiedy przestać używać Claude i przełączyć się na inne narzędzia
Claude to uogólniony asystent. Sprawdza się w wielu zadaniach i jest świetny w niektórych. Ale w konkretnych etapach procesu akademickiego pisania dedykowane narzędzia wypadają od niego lepiej.
Do korekty: Przełącz się na nasz korektor AI. Claude potrafi wykrywać błędy gramatyczne, ale nie zapewnia śledzonych zmian ani systematycznego przeglądu zdanie po zdaniu. Dedykowany korektor jest szybszy i bardziej szczegółowy, aby doprowadzić tekst do gotowości do złożenia.
Do podsumowywania: Nasz AI podsumowujący obsługuje kompresję tekstu akademickiego w sposób bardziej systematyczny, zachowując kluczowe wyniki, szczegóły statystyczne oraz informacje z cytatów, które Claude czasem pomija.
Do humanizacji tekstu wspomaganego przez AI: Dedykowane narzędzie do humanizacji radzi sobie z konkretnymi wzorcami, które wykrywacze sygnalizują. Claude nie potrafi skutecznie zneutralizować wzorców we własnym wyniku, bo odtwarza te same statystyczne sygnatury nawet wtedy, gdy prosi się, by pisał "bardziej naturalnie."
Dla formatowania cytowań: Użyj Zotero, Mendeley lub swojego menedżera referencji. Claude sformatuje cytowania tak, że wyglądają poprawnie, ale zawierają subtelne błędy: nieprawidłowe formaty dat, niespójne style, czasem zmyślone DOI.
Idealny przepływ pracy wykorzystuje Claude do myślenia i tworzenia wstępnego tekstu, a następnie przełącza się na wyspecjalizowane narzędzia do dopracowania i finalizacji. Tak wygląda profesjonalne pisanie.
Przepływ pracy 5: odpowiadanie recenzentom
Struktura odpowiedzi oraz kontrola tonu wynagradzają to, w czym model językowy jest dobry: tworzeniu odpowiedzi. Wklej pismo z decyzją i przejdź punkt po punkcie: poproś Claude'a, aby wyodrębnił każdą odrębną krytykę do ponumerowanej listy, przygotował neutralny szkielet odpowiedzi do każdego punktu oraz oznaczył, które punkty wymagają nowej analizy, a nie jedynie przepisania. Zadbaj samodzielnie o merytorykę naukową: co zmieniło się w manuskrypcie, co bronisz i gdzie recenzent jest merytorycznie w błędzie. Wkład modelu polega na przygotowaniu dokumentu odpowiedzi, który już za pierwszym razem brzmi spokojnie i uporządkowanie. Jeden prompt ustawia całą strukturę:
Here is the decision letter for my manuscript: [paste letter]. Extract every
distinct criticism into a numbered list. For each point, draft a two-sentence
neutral response skeleton and label it: revise, defend, or needs new analysis.
Do not invent any changes I have not described.
Nasza zestaw promptów do pisania akademickiego zawiera więcej gotowych promptów do odpowiedzi dla recenzentów.
Claude, Cowork lub Claude Code: który najlepiej pasuje do pracy badawczej?
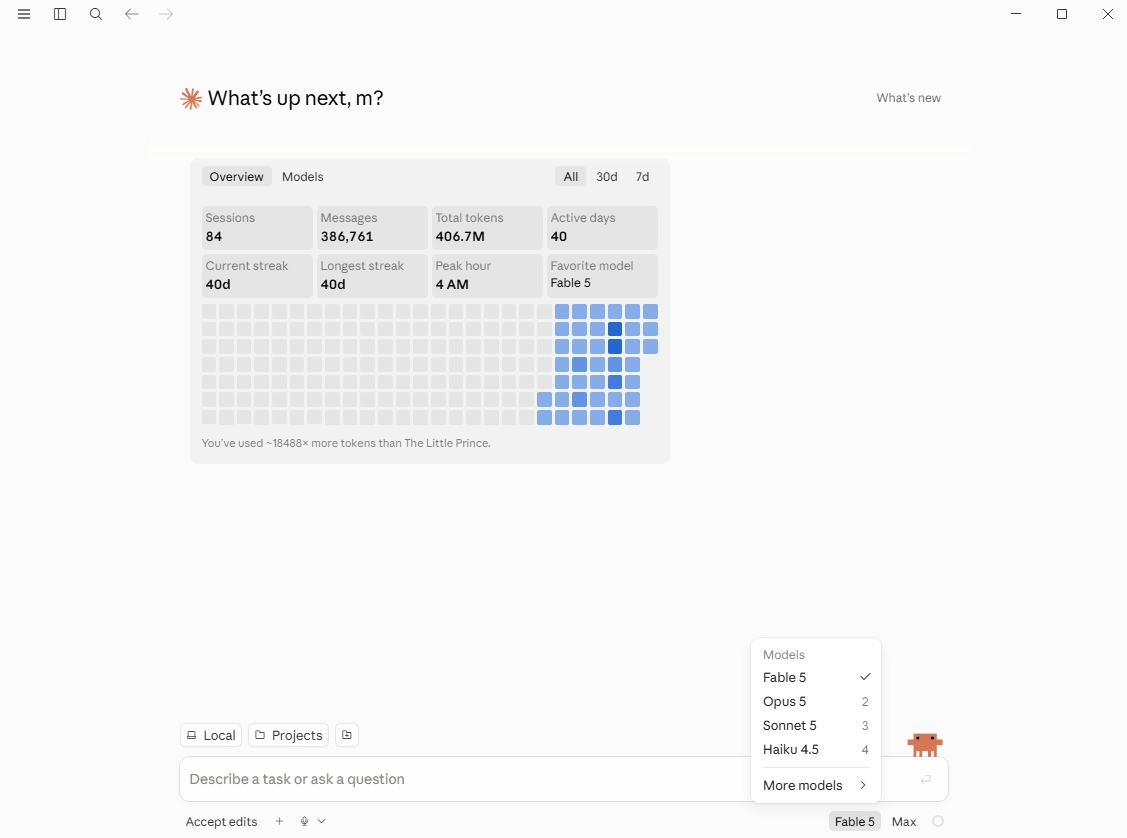
Anthropic udostępnia teraz Claude w trzech głównych formach, a właściwy wybór zależy od tego, jaki efekt ma dać twoje zadanie.
Claude (czat web i desktop) to właściwe narzędzie do każdego etapu opisanego w tym przewodniku: burza mózgów, synteza z twoich notatek, pisanie pierwszych wersji rozdziałów oraz poprawki. To narzędzie jest rozmowne, uruchamia się natychmiast i zawiera wyszukiwanie w sieci.
Opcją agentową do pracy z wiedzą jest Claude Cowork. Agent działa wewnątrz aplikacji Claude na pulpicie. Nie wymaga konfiguracji. Zadania wieloetapowe są obsługiwane samodzielnie (zorganizuj folder z notatkami z lektur, zbuduj tabelę porównawczą z kilkunastu artykułów albo przygotuj pierwszą wersję adnotowanej bibliografii). Działa w odizolowanym środowisku. To oznacza, że to bezpieczniejszy agent do pracy z wrażliwymi wersjami roboczymi. Gdy zadanie tworzy dokument zamiast rozmowy, Cowork zwykle wygrywa z czatem.
Claude Code działa w terminalu i jest zbudowany dla osób, które piszą oprogramowanie. Dla badaczy znajduje swoje miejsce w pracy analitycznej: czyszczeniu danych, uruchamianiu skryptów statystycznych, tworzeniu powtarzalnych rysunków oraz pracy w repozytorium projektu. Jeśli nigdy nie korzystasz z wiersza poleceń, pomiń go. Cowork obejmuje obszar agentowy bez konieczności konfiguracji.
Który model Claude powinni wybrać badacze?
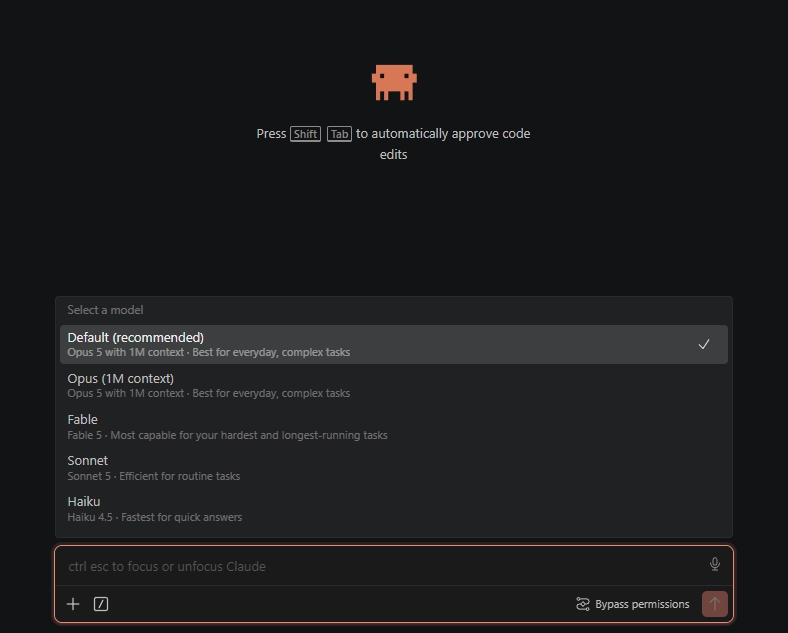
W momencie, gdy piszemy, zestaw zaczyna się od Fable 5, potem Opus 5, Sonnet 5 oraz szybki i niedrogi Haiku 4,5.
Sonnet 5 to rozsądny domyślny wybór do codziennej pracy nad tekstem: planowanie, pisanie akapitów oraz prompty do poprawek. Jest szybki, a jego górny pułap jakości obejmuje większość sekcji w większości artykułów.
Fable 5 to model, po który sięga się, gdy najtrudniejsza jest część rozumowania: uzgadnianie sprzecznych wyników w ramach literatury, testowanie pod presją argumentu metodologicznego albo utrzymywanie całego manuskryptu w kontekście podczas sprawdzania spójności wewnętrznej. Zużywa limity planu szybciej, więc traktuj go jak specjalistę, którego wzywasz do pytań, na które naprawdę zasługuje.
Opus 5 znajduje się pomiędzy tymi dwoma: jest mocniejszy od Sonnet w długim rozumowaniu i tańszy w uruchamianiu przez cały dzień niż Fable. Jeśli twoje liczniki planu ciasno ograniczają topowy model, Opus to kompromisowy koń roboczy.
Haiku 4.5 obsługuje szybkie, mechaniczne prośby: formatowanie, definicje, poprawki czasu. Nie używaj go do niczego, co miałbyś cytować ani składać do publikacji.
Humanize Your Claude Draft Before a Detector Reads It
Humanization bezpieczna dla cytowań, która zachowuje akademicki ton, terminologię i znaczenie. Krok pomiędzy wersją roboczą wspieraną przez Claude a złożeniem pracy.
Wypróbuj bezpłatnie AI humanizerNajlepszy model Claude do pisania akademickiego w październiku 2026
Najlepszym modelem Claude do większości pisania akademickiego jest Claude Opus 5.5, który przewodnik po modelach Anthropic rekomenduje teraz jako punkt wyjścia dla większości zadań. Najnowsze modele to Fable 5.1, Opus 5.5 i Sonnet 5.5. Anthropic sugeruje Claude Fable 5.1 do wymagającego rozumowania i zadań długotrwałych albo gdy Opus 5.5 w wyższym ustawieniu wysiłku nie daje wystarczająco dobrych wyników.
Anthropic opisuje Claude Sonnet 5.5 jako najlepsze połączenie szybkości i inteligencji, co sprawdza się przy rutynowym planowaniu i pisaniu. Claude Haiku 4.5 jest najszybszym modelem i jest odpowiednie do szybkiego formatowania oraz definicji.
| Model | Opis Anthropic | Okno kontekstu | Rzetelny moment zakończenia na wiedzę (cutoff) | Cena API za milion tokenów wyjściowych |
|---|---|---|---|---|
| Claude Fable 5.1 | Wymagające rozumowanie i zadania agencyjne o długim horyzoncie | 1M tokenów | Czerwiec 2026 | US$50 |
| Claude Opus 5.5 | Długotrwałe kodowanie agencyjne i prace oparte na wiedzy | 1M tokenów | Czerwiec 2026 | US$20 |
| Claude Sonnet 5.5 | Najlepsze połączenie szybkości i inteligencji | 1M tokenów | Czerwiec 2026 | US$10 |
| Claude Haiku 4.5 | najszybszy model z niemal przełomową inteligencją | 200K tokenów | Luty 2025 | US$5 |
Liczy się aktualność wiedzy dla badań. Niezawodny zakres aktualności Claude Haiku 4.5 to luty 2025, więc nie polegaj na nim w przypadku najnowszej literatury w swojej dziedzinie. Pozostałe trzy modele mają zakres aktualności na czerwiec 2026 i wciąż powinieneś sprawdzić każde źródło, które wymienia, bezpośrednio w samym artykule.
Do syntezy literatury na podstawie wielu źródeł lub weryfikacji spójności całego manuskryptu najlepszy wybór to Fable 5.1. Do codziennego pisania wystarczą Opus 5.5 lub Sonnet 5.5. Nasze porównanie najlepszego AI modelu do pisania akademickiego według sekcji obejmuje również ChatGPT i Gemini.
Poziomy wysiłku: jak mocno powinien myśleć model?
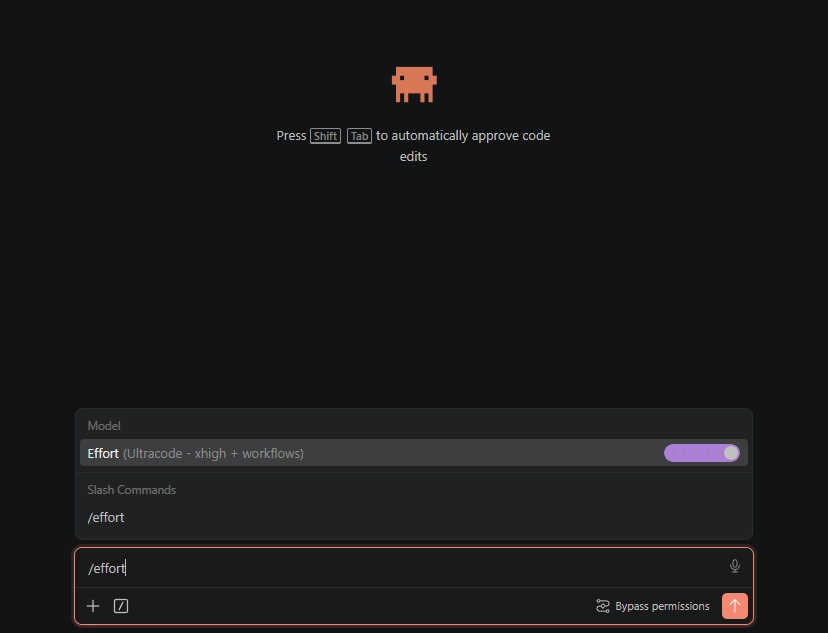
Narzędzia agencyjne Claude udostępniają ustawienie wysiłku, które kontroluje, ile rozumowania model zużywa, zanim odpowie: low, medium, high, xhigh oraz limit maksymalny tylko na sesję. Dostępne jest też wzmocnienie na pojedyncze polecenie: włącz słowo "ultrathink" do prośby, a ta jedna odpowiedź dostanie głębsze rozumowanie bez zmiany ustawienia sesji.
Dopasuj poziom do wagi pytania. Medium wystarcza do mechanicznego porządkowania. High sprawdza się w zwykłych sesjach pisania i rewizji. Zachowaj xhigh i max dla pytań, które niosą realny ciężar analityczny: synteza na podstawie trzydziestu źródeł, decyzja projektowa w oparciu o statystykę albo pełna weryfikacja spójności całego manuskryptu. Wyższy wysiłek kosztuje więcej tokenów i więcej czasu na odpowiedź, więc ustawianie wszystkiego na max spowalnia rutynę i wyczerpuje plan bez zysku. Używaj go tylko wtedy, gdy wykonujesz faktyczne badania, które muszą być wysoce dokładne.
Kiedy zwężać sesję
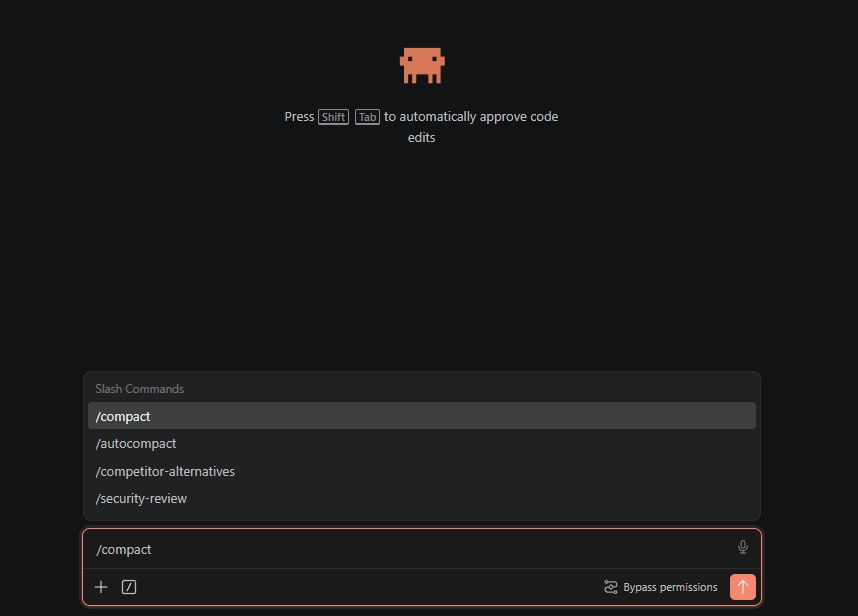
Długie rozmowy się pogarszają. Każda wiadomość niesie ze sobą całą historię rozmowy, więc sesja, która na początku była trafiona, później działa wolniej i zaczyna pomijać wcześniejsze instrukcje, gdy wypełnia się okno kontekstowe. Badacze to zauważają jako zmęczenie: model, który precyzyjnie obsłużył pierwsze trzy polecenia, po piętnastu produkuje ogólnikowe odpowiedzi.
Naprawa polega na kompresji: zwinięciu dotychczasowej rozmowy do podsumowania, które model dalej przenosi. Dwie praktyczne zasady działają szczególnie dobrze. Kompresuj po każdym zakończonym zadaniu, w naturalnym momencie, gdy kończy się część dotycząca literatury, a zaraz ma rozpocząć się metody. Albo obserwuj licznik tokenów i wykonuj kompresję mniej więcej przy 25 proc. wykorzystania kontekstu, zamiast czekać, aż narzędzie wymusi ją tuż przed limitem. Wskazówki samego Anthropic mówią to samo: kompresuj proaktywnie na granicach zadań, a nie wtedy, gdy jakość już zaczęła spadać. Kompresja na czystej granicy nic nie kosztuje; wymuszona kompresja w trakcie zadania traci niuanse, które chciałeś zachować.
Czy plan Claude Max jest wart tego dla badaczy?
Claude Pro kosztuje US$20 miesięcznie. Max jest w przedziałach US$100, czyli pięć razy większe zużycie niż w Pro, oraz US$200, czyli dwadzieścia razy. Dla okazjonalnego użytku, kilka rozmów dziennie, Pro w zupełności wystarcza i Max jest niewykorzystaną rezerwą możliwości.
Dla rzetelnej, „twardej” pracy badawczej Max zdecydowanie jest tego wart. Synteza literatury na długich dokumentach, pełne kontrole spójności całego manuskryptu oraz sesje agentowe w Cowork lub Claude Code szybko pochłaniają limit. Limity w Pro przerywają dokładnie te sesje, które są najważniejsze. Przedział US$100 przekracza codzienny limit dla większości indywidualnych badaczy. Przedział US$200 jest dla osób, które korzystają z tych narzędzi przez cały dzień. Jeśli zawieszona sesja poprzedniej nocy, przed terminem oddania, kosztuje Cię więcej niż US$100, rachunek sam się domyka.
Czy istnieje darmowy plan Claude dla akademickich badaczy?
Tak, plan Claude Team dla naukowców firmy Anthropic zapewnia zweryfikowanym grupom badawczym Claude bez kosztów na start. Kierownicy projektów (PI) na akredytowanych uczelniach oraz w instytutach badawczych organizacji non-profit mogą złożyć wniosek. Program obejmuje nauki przyrodnicze, matematykę, informatykę, inżynierię i pokrewne dziedziny oraz jest otwarty dla 10 000 naukowców na całym świecie.
Zwolennik PI po weryfikacji otrzymuje plan Claude Team i bezpłatnie dodaje swoją grupę na miejscach Standard albo na miejscach Premium za US$15 miesięcznie. Miejsca Standard kosztują regularnie US$20 miesięcznie, a miejsca Premium US$100 miesięcznie, a cena promocyjna obowiązuje przez 12 miesięcy od rejestracji. Rozliczanie roczne kosztuje US$0 albo US$180 za miejsce za rok. Anthropic twierdzi, że dostępność jest ograniczona, a ostateczna cena jest potwierdzana po weryfikacji.
| Miejsce | Cena za 12 miesięcy | Cena regularna | Co obejmuje |
|---|---|---|---|
| Standard | US$0 miesięcznie | US$20 miesięcznie | Claude Science, Claude Code i Cowork, łączniki do baz danych badań, współdzielone projekty, logowanie jednokrotne (SSO) |
| Premium | US$15 miesięcznie | US$100 miesięcznie | Wszystko w Standard, plus 5 razy większe zużycie i wyższe limity do długich analiz |
Grupy mają od 1 do 25 miejsc, a większe grupy mogą skontaktować się z Anthropic. Weryfikacja trwa 5 do 7 dni roboczych dla większości wniosków. Gdy projekt wymaga więcej miejsc, niż przewiduje plan, grupa może ubiegać się o dodatkowe kredyty za pośrednictwem programu dofinansowań Anthropic w ramach grantów AI for Science.
Jeśli pracujesz poza tymi dziedzinami albo samodzielnie, Claude Pro kosztuje US$20 miesięcznie lub US$17 miesięcznie rozliczane rocznie. Niezależnie od tego, który plan wybierzesz, przed złożeniem sprawdź ostateczny tekst dzięki edycji w naszym AI korektor.
Dlaczego Claude, a nie ChatGPT ani Gemini?
W pracach badawczych Claude obecnie okazał się najbardziej wiarygodnym z trzech asystentów z najwyższej półki. W 2026 roku niezależne systemy monitorowania dokładności oszacowały, że wskaźnik omamień Claude'a wynosi około 3 procent, podczas gdy modele flagowe GPT i Gemini miały go mniej więcej dwukrotnie wyższy. Znaczenie ma też zachowanie w warunkach niepewności: Claude mówi, że nie wie, zanim zacznie wymyślać odpowiedź. Pewna, „wymyślona” treść to tryb porażki, który najbardziej szkodzi pracy akademickiej.
Dwie ważne uwagi. Wszystkie modele tworzą cytowania. Porównanie z 2026 roku recenzowane przez ekspertów wykazało, że żaden z asystentów nie potrafił wygenerować list odnośników, które dałoby się zweryfikować. Oznacza to, że nic, co modele przywołują, nie trafia do Twojej pracy bez sprawdzenia. Jeśli robisz tylko proste, mechaniczne zadania, takie jak formatowanie tabel czy szybkie konwertowanie, to między tymi trzema modelami nie ma dużej różnicy. Tam jednak, gdzie liczy się wynik, czyli w długim procesie rozumowania na podstawie Twoich własnych źródeł, różnice stają się istotne.
Jak korzystać z Claude'a, nie narażając się na wykrycie AI
Tekst, który Claude przygotowuje, zawiera statystyczne wzorce, których szukają detektory AI, a uczelnie coraz częściej przepuszczają zgłoszenia przez wskaźnik AI Turnitin. Trzy praktyki zwiększają bezpieczeństwo. Używaj Claude'a do pracy polegającej na myśleniu (strukturyzowanie, krytyczna ocena, streszczanie źródeł), a końcowy opis pisz samodzielnie tam, gdzie tego wymaga polityka. Ujawniaj wsparcie AI, gdy tego wymaga Twój dziennik lub instytucja; nasz przewodnik do oświadczenia o użyciu AI ma gotowe szablony. A gdy polityka dopuszcza pisanie wspomagane przez AI, przerób wynik na własny styl albo przepuść go przez humanizer AI tekstu akademickiego, który zachowuje cytowania i terminologię, a następnie sprawdź efekt detektorem przed złożeniem. Czego nie powinieneś robić: nie wysyłaj surowego wyniku działania modelu. Detekcja zawodnie go nie odróżnia, a egzaminatorom, którzy znają Twój styl pisania, brzmi jak ogólnikowa proza.
Co Claude myli w piśmie akademickim
Transparentność ma znaczenie. Oto miejsca, w których widzieliśmy, że Claude zawodzi:
Cytowania. Claude może tworzyć wiarygodnie brzmiące nazwiska autorów, tytuły czasopism i lata publikacji, które nie istnieją. Nigdy nie pozwalaj Claude'owi dostarczać odnośników, których nie zweryfikowałeś. Możesz też poprosić Claude'a, aby rzeczywiście zweryfikował, że cytowanie istnieje, i podał DOI. Później możesz wejść w DOI każdego cytowania, aby sprawdzić, czy dane rzeczywiście istnieją.
Konwencje właściwe dla dziedziny. Claude może pomijać normy specyficzne dla dyscypliny. Znasz konwencje swojej dziedziny lepiej niż Claude, więc zaufaj własnym kompetencjom ponad wynik modelu.
Twierdzenia ilościowe. Claude czasem wprowadza twierdzenia statystyczne, których nie ma w Twoich oryginalnych danych. Jeśli pojawia się liczba, której nie podałeś, zweryfikuj ją.
Dopasowanie tonu. Claude pisze dobrze, ale nie pisze tak jak Ty. Zawsze zrób „przegląd głosu” - zastąp ogólne sformułowania własnymi schematami. Twój promotor regularnie czyta Twoje teksty. To ma brzmieć jak Ty.
To nie są powody, by unikać Claude'a. To są powody, by używać go pod nadzorem.
Najczęściej zadawane pytania
Q: Czy korzystanie z Claude'a do pisania akademickiego jest akceptowane przez uczelnie?
To zależy od polityki Twojej instytucji. Większość uczelni rozróżnia korzystanie z AI jako narzędzia do pisania (akceptowane po ujawnieniu) oraz składanie pracy wygenerowanej przez AI jako własnej (nieakceptowane). Korzystanie z Claude'a do burzy mózgów, tworzenia konspektu i pisania wstępnej wersji, a potem rewizja i dodanie własnego głosu, mieści się w kategorii użycia narzędzia. Zawsze sprawdzaj wytyczne i ujawniaj użycie tam, gdzie tego wymagają.
Q: Jak wypada Claude w porównaniu z ChatGPT do pisania prac badawczych?
Claude lepiej radzi sobie z długimi dokumentami i niuansowymi instrukcjami. Jest bardziej niezawodny w spełnianiu wymagań dotyczących formatowania i rzadziej tworzy nieprawdziwe twierdzenia. ChatGPT częściej sprawdza się w zadaniach stricte technicznych, takich jak przestawianie tabel. W zadaniach pisarskich dajemy Claude przewagę, ale oba rozwiązania działają. Zobacz nasze AI prompts do pisania akademickiego dla promptów, które działają w różnych modelach.
Q: Czy Claude może napisać całą pracę badawczą?
Teoretycznie tak. Czy powinien? Nie. Jakość pracy wygenerowanej w jednym przebiegu jest znacznie niższa niż w przypadku przygotowania rozdział po rozdziale, gdy badacz w każdym etapie wnosi swój wkład. Twoja interpretacja danych, ujęcie teoretyczne i budowanie argumentacji muszą pochodzić od Ciebie. Claude jest najbardziej przydatny, gdy przejmuje mechaniczne aspekty pisania, czyli strukturę, dobór sformułowań i oszczędność słów, podczas gdy Ty kierujesz treścią merytoryczną.
Q: Czy tekst napisany przez Claude'a zostanie wykryty przez detektory AI?
Prawdopodobnie tak, jeśli wyślesz surowy wynik bez edycji. Wzorce pisania Claude'a są wykrywalne przez narzędzia takie jak Turnitin i GPTZero. Rozwiązaniem jest Jak „humanizować” szkic napisany przez Claude’a (Opus 4.8 i Fable 5) do Twojego własnego głosu, czyli dodanie Twojego sposobu pisania, zróżnicowanie konstrukcji zdań i przeprowadzenie przebiegu humanizującego. Dobrze zredagowany tekst z Claude'a, spersonalizowany i przejrzany, zwykle uzyskuje wyniki znacznie poniżej progów wykrywania.
Q: Czy uczelnie potrafią wykryć tekst napisany z użyciem Claude?
Detektory nie identyfikują, który model napisał dany fragment, ale surowy wynik Claude'a zachowuje te same statystyczne prawidłowości co wyniki innych modeli, a detektory Turnitin-grade wykrywają go z wysoką częstotliwością. Ryzyko wykrycia zależy od tego, ile nieedytowanego tekstu wygenerowanego przez model przetrwa do złożenia pracy, i dotyczy to wszystkich modeli równie. Dlatego najlepiej ręcznie dopracować surowy wynik Claude'a przed złożeniem w dowolnym miejscu.
Q: Który model Claude jest najlepszy do badań akademickich?
Sonnet 5 najlepiej sprawdza się do codziennego tworzenia szkiców i poprawek, a Fable 5 wtedy, gdy rozumowanie jest naprawdę trudne: synteza między źródłami, krytyka metod albo utrzymywanie całego manuskryptu w kontekście. Opus 5 to opcja pośrednia na długie sesje w ramach uporządkowanego planu, a Haiku 4.5 jest wyłącznie do szybkich zadań mechanicznych. Bez względu na model, zweryfikuj każdą cytację i każdą liczbę, zanim trafią do manuskryptu.
Q: Jak często powinieneś zwężać długą sesję Claude?
Zwęczaj po każdym zakończonym zadaniu albo mniej więcej przy 25 procentach wykorzystania kontekstu, zależnie od tego, co nastąpi wcześniej. Zwiń rozmowę do podsumowania, które model przejmie dalej, aby odpowiedzi były precyzyjne i zapobiec stopniowemu „zapominaniu” instrukcji spowodowanemu długimi sesjami. Czekanie aż narzędzie zmusi do zwięźnięcia tuż przy limicie kontekstu zwykle oznacza, że jakość już spadła, a podsumowanie traci szczegóły, które Cię interesowały.
Q: Czy istnieje darmowy plan Claude dla badaczy akademickich?
Tak. Plan Claude Team od Anthropic dla naukowców zapewnia zweryfikowanym głównym badaczom plan Team bez kosztów na start. Ich grupa dołącza na darmowych miejscach Standard albo na płatnych miejscach Premium US$15, z rabatem w stosunku do US$20 i US$100 miesięcznie przez 12 miesięcy. Oferta jest dla akredytowanych uczelni oraz instytucji badawczych typu non profit w naukach ścisłych, matematyce, informatyce i inżynierii.
Q: Który model Claude jest najlepszy do pisania akademickiego dzisiaj?
Claude Opus 5.5 to najlepszy punkt startu dla większości pisania akademickiego i to model, który Anthropic rekomenduje do większości prac. Użyj Claude Fable 5.1 do trudniejszego wnioskowania, na przykład gdy trzeba pogodzić wiele źródeł naraz. Sonnet 5.5 sprawdzi się w rutynowym tworzeniu konspektów i pisaniu, a Haiku 4.5 do szybkiego formatowania.
Q: Czy Claude Pro wystarczy do badań akademickich?
Claude Pro wystarczy większości indywidualnych badaczy do pisania i redakcji. Kosztuje US$20 miesięcznie albo US$17 miesięcznie przy rozliczeniu rocznym. Jeśli kierujesz zespołem badawczym w naukach ścisłych, to bezpłatne miejsca Standard w programie dla naukowców dają większe możliwości wykorzystania niż Pro, zgodnie z Anthropic.
Q: Czy Claude Haiku 4.5 zna aktualne badania?
Nie, niezawodny limit wiedzy Claude Haiku 4.5 to luty 2025, więc nie zna najnowszych badań. Opus 5.5, Sonnet 5.5 i Fable 5.1 mają limit wiedzy z czerwca 2026. Używaj Haiku do szybkich poprawek i sprawdzaj wszystko, co dotyczy nowszej literatury, na podstawie własnych źródeł.
Bezpieczna względem cytowań humanizacja, która utrzymuje akademicki ton. Krok między szkicem wspomaganym przez Claude'a a każdym detektorem AI.
Moe jest inżynierem NLP z PhD w przetwarzaniu języka naturalnego. Jego badania obejmują lingwistykę obliczeniową, analizę tekstu i uczenie maszynowe, a następnie zostały wykorzystane bezpośrednio w modelach edycji i humanizacji stojących za ProofreaderPro. Pisze o części procesu, której większość ludzi nigdy nie widzi: o tym, jak model językowy czyta zdanie, ocenia je i decyduje, co zmienić.