
先月、同僚がスクリーンショットを共有してくれました。そこには、Claudeの会話でブレインストーミング、アウトライン作成、下書き、そしてジャーナル論文の導入文全体の推敲までを1時間未満で進めていた様子が写っていました。同じセクションは、先週は3日かかっていたそうです。
彼女は、執筆プロセスの適切な段階で正しいAIツールを使っていました。
私たちは数か月かけてClaudeを学術執筆のワークフローへ統合してきました。私たち自身と、ユーザーのワークフローの両方です。モデルには研究執筆における実際の強みがありますが、同時に明確な制限もあります。どこで使い、どこで別のツールへ切り替えるかを知ることが、まずまずのAI実験と本当の生産性向上の違いになります。
なぜClaudeは学術執筆にうまく機能するのか
Claudeは、私たちがテストしたほとんどの言語モデルよりもニュアンスを適切に扱えます。ChatGPT、Gemini、Grok、Deepseekなどを含みます。学術文書ではニュアンスがほぼすべてを左右するため、これは重要です。
Claudeにディスカッションセクションの下書きを手伝わせると、概ねあなたの“慎重な表現”を保ちます。「結果は示唆する」ではなく「結果を証明する」といった具合です。書き方のレジスターやトーンに関する指示に、私たちの並行テストではGPTよりも一貫して従います。そして、不確実性がより適切な場面で自信に満ちた断定を捏造してしまう可能性が低くなります。
私たちは次の3つの具体的な強みを見つけました:
長いコンテキストの扱い。 Claudeは非常に長い文書を処理できます。現在のバージョンでは最大200Kトークンです。つまり、文献レビュー全体、完全な方法セクション、あるいは草稿原稿そのものを貼り付けて、その内容について質問できます。モデルは、数千語あたりで見失うのではなく、全文にわたって一貫性を維持します。
指示への追従。 Claudeに「過去形、受動態、フォーマルなレジスターで書き、結果を解釈しないでください」と伝えると、それを実際に実行します。きちんと一貫して。小規模モデルや、競合する一部の大規模モデルでは、出力が長くなるほど特定の指示から逸れてしまう傾向があります。
不確実性を率直に提示。 Claudeは「わかりません」や「十分な情報がありません」と言う可能性がより高く、回答を捏造しにくいです。確信的な幻覚によって信頼性が損なわれうる学術作業では、これは非常に大きな意味を持ちます。
これらのことは、Claudeがあなたの論文を書いてくれるという意味ではありません。適切に指示すれば、本当に役立つアシスタントになりうるということです。
ワークフロー1:ブレインストーミングとアイデアの発展
ここからClaudeを始めることを私たちはおすすめします。論文の最初の1語もまだ書いていない段階です。
会話を開き、研究内容を平易な言葉で説明してください。学術的な言い回しは気にしなくて大丈夫です。何を研究したのか、何を見つけたのか、そしてそれが何を意味すると思うのかをClaudeに伝えます。その後、あなたの論文で最も強い切り口を見つける手伝いをさせてください。
私たちが使っているプロンプトの枠組みは次のとおりです:
I'm writing a paper about [topic]. My main finding is [finding].
The existing literature says [brief summary]. I think my contribution
is [your interpretation].

Help me think through: What's the strongest framing for this paper?
What counterarguments should I address? What's the most interesting
aspect of my findings that I might be underemphasizing?
ここから下のすべてのプロンプトでも、すべての[角括弧で囲まれたプレースホルダー]を自分の内容に置き換えてください。利用可能な出力と一般的な文章を分けるのは、制約の行なので、それを維持してください。
オープンな議論ではなく、構造化された回答がほしいときは、依頼をより具体的にしてください:
I'm writing a paper about [topic] for [target journal]. My main finding is
[finding]. The closest prior work is [paper A] and [paper B], which concluded
[their conclusion]. State three candidate framings for my contribution, rank
them by novelty and defensibility, and name the strongest counterargument
against each.
Claudeがこれに優れているのは、ライティング用の機械というより思考のパートナーだからです。モデルは弱い構成に対しては押し返し、あなたが思いつかなかった切り口を提案し、あなたの貢献をより明確に言語化する手助けをします。
私たちは、混合研究法の研究デザインを組み立てるのに苦労しているポスドクにこれを使いました。20分で、彼女は自分の質的な結果が、広く引用されている枠組みに反することを特定しました。その組み替えが、彼女の論文のフックになりました。初回投稿で採択。
ワークフロー2: 文献の統合とギャップの特定
Claudeは論文を読めません。これをはっきり理解する必要があります。モデルはデータベースにアクセスできず、引用文献を求めると捏造の引用が出てくる可能性があります。しかし、あなたが提供した情報は統合できます。
ワークフロー:
- ソースを自分で読んでください。重要な発見、方法、結論についてメモを取ります。
- それらのメモをClaudeに貼り付けます。テーマごとか時系列で整理します。
- Claudeに、メモ全体に共通するパターン、矛盾、抜けている点を特定するよう依頼します。
Here are my notes on 12 papers about [topic]:
[paste organized notes]

Synthesize these into 3-4 thematic paragraphs for a literature review.
Identify where authors disagree, where methods differ, and what questions
remain unanswered. Use (Author, Year) citation format. Do not add any
sources I haven't provided.
最後の指示は重要です。これがないと、Claudeがそれっぽいもののまったく架空の参考文献を挿入することがあります。出力内のすべての引用は、入力としてあなたが提供したものに限ってください。
このワークフローは、文献レビューの下書きを作成する時間をおおむね50%短縮することがわかりました。何を考えるか、どの論文を含めるか、どんなテーマが浮かび上がるか、どこにギャップがあるかといった思考は、あなた自身のものです。Claudeがあなたの考えを文章に整理します。
論文のあらゆるセクションに対応した追加のプロンプトは、研究論文の執筆を実際に改善する21のAIプロンプトのコレクションをご覧ください。
ワークフロー3: セクションを下書きし構成する
ここで Claude は、従来の意味でのライティングアシスタントになります。アイデア、データ、主張の構成があります。箇条書きを段落にするのに手助けが必要です。
Claude に最初から論文全体を一度に下書きさせるのではなく、セクションごとのアプローチをおすすめします。1 回の返信で 800 から 1,000 words 以上を求めると、品質は劇的に下がります。
私たちの推奨プロセス:
- 概要を作成してください。 Claudeに、各見出しの下に箇条書きを付けたセクション構成を渡します。
- 制約を指定してください。 分量、時制、文体、レジスター、引用スタイル。
- 1つのセクションずつ下書きを作成します。 次に進む前に各セクションを確認してください。
- 会話の中で反復します。 Claudeに特定の段落を調整するよう依頼します。この段落を引き締めて、あの段落を広げて、そしてこのつなぎをより滑らかにして、といった具合に。
重要な洞察として、Claudeをゴーストライターのように扱い、十分なブリーフィングが必要だと考えましょう。『Write my discussion section』では汎用的な文章しか出てきません。『Write a 300-word paragraph comparing my finding X with Smith (2023) and Chen (2024), noting the methodological difference that explains the discrepancy』なら、役に立つ内容が生成されます。
ほとんどの執筆セッションは、3つのテンプレートでカバーできます。ドラフト前にセクションを構成するには:
Build a paragraph-level outline for the [introduction/discussion] of a paper
on [topic]. Audience: [field] researchers. The section must move from
[opening premise] to [closing claim] in no more than [N] paragraphs. For
each paragraph give a one-line purpose and the evidence it should cite from
my notes: [paste notes].
実際に行ったことの範囲内に収める方法段落を作成するには:
Draft a [word count]-word methods paragraph describing [procedure]. Past
tense, passive voice, formal register, [citation style]. Include these
details exactly as given: [sample size, instruments, parameters]. Do not
add any procedure or measurement I have not listed.
そして、モデルに解釈させずに結果を文章に変換するには:
Turn these results into two paragraphs of formal prose: [paste table or
bullet results]. Report every statistic exactly as written. Describe
patterns without interpreting them; interpretation belongs in the
discussion section.
ワークフロー4: リビジョンと自己編集
下書きを作成したら。手書きでも、Claudeの支援を使った場合でも、両方を組み合わせても。Claudeは強力なリビジョンツールになります。
セクションを貼り付けて、的を絞った質問をします:
Review this paragraph for logical flow. Does the argument progress
clearly from premise to evidence to conclusion? Identify any gaps
in reasoning.
Reduce this paragraph from [current] to [target] words without losing any
claim, number, or citation: [paste paragraph]. Keep the academic register
and my terminology.
Read this section as a hostile reviewer for [journal]: [paste section].
List the five weakest points in order of severity, quote the exact sentence
each weakness lives in, and say what evidence or rewording would fix it.
最後のプロンプトが私たちのお気に入りです。Claudeの「hostile reviewer」ペルソナは、論理の飛躍、根拠のない主張、そして複数回の推敲の後にあなたが見落としてしまった構造上の弱点を見つけてくれます。これは本物の査読者が見つけるすべては拾いませんが、5分の価値があるだけのものは拾ってくれます。
また、提出前にはClaudeを使って各セクション間の整合性をチェックしています。
Here are my abstract and conclusion: [paste both]. List every claim in the
abstract that the conclusion does not support, and every conclusion claim
missing from the abstract. Then check that every number appearing in both
matches exactly.
セクション間の不整合は、最もよくある改稿段階の問題の1つで、何週間も原稿の中で暮らしていると見つけにくいです。
Claudeを使うのをやめてツールに切り替えるタイミング
Claudeは汎用型です。多くの作業に対応でき、いくつかの分野では特に優れています。しかし、学術執筆プロセスの特定の段階では、専用ツールのほうがそれよりも優れた結果になります。
校正用: AI校正者に切り替えてください。Claudeは文法の誤りを見つけられますが、追跡された変更や、体系的な文ごとのレビューは提供しません。専用の校正者なら、提出用に仕上げるための磨き込みが、より速く、より徹底的です。
要約のために: 私たちの AIサマライザー は、学術テキストの圧縮をより体系的に扱います。重要な知見、統計的な詳細、そして Claude がときどき省略する引用情報を保持します。
AI支援の文章をhumanizerするために: 専用のhumanizerツールが、検出器が指摘する特定のパターンを処理します。Claudeは自身の出力を効果的に脱パターン化できません。同じ統計的シグネチャを再現してしまい、"より自然に"書くよう求められても変わりません。
引用の書式設定のために: Zotero、Mendeley、またはリファレンス管理ツールを使いましょう。Claudeは正しく見える引用を作成しますが、細かな誤りが含まれることがあります。日付の形式が間違っている、スタイルが一貫していない、時には捏造されたDOIが混ざることもあります。
理想的なワークフローでは、Claudeで考えて下書きをし、その後、文章の磨き込みと最終化には専用ツールに切り替えます。これがプロの文章作成です。
ワークフロー5: 査読者への返信
査読者の回答に対する報酬の仕組みやトーンの制御は、まさに言語モデルが得意とすることです。判断通知文と作業ポイントを貼り付けて、点ごとに進めてください。Claudeに、あらゆる個別の指摘をすべて番号付きリストとして抽出させ、各ポイントごとに中立的な返信の下書きひな形を作成し、言い換えではなく新たな分析が必要なポイントを明示します。科学的な中身は自分で持ちましょう。原稿で何が変わったのか、あなたが何を擁護するのか、そして査読者が事実としてどこで間違っているのかを示します。モデルの貢献は、最初の一通目で落ち着いて整理された「返信文書」を作ることです。ひとつのプロンプトが構造全体を用意してくれます:
Here is the decision letter for my manuscript: [paste letter]. Extract every
distinct criticism into a numbered list. For each point, draft a two-sentence
neutral response skeleton and label it: revise, defend, or needs new analysis.
Do not invent any changes I have not described.学術執筆のためのプロンプト集には、すぐに使える査読者向けの返信用プロンプトがさらに多数含まれています。
Claude、Cowork、または Claude Code: 研究作業にはどれが合う?
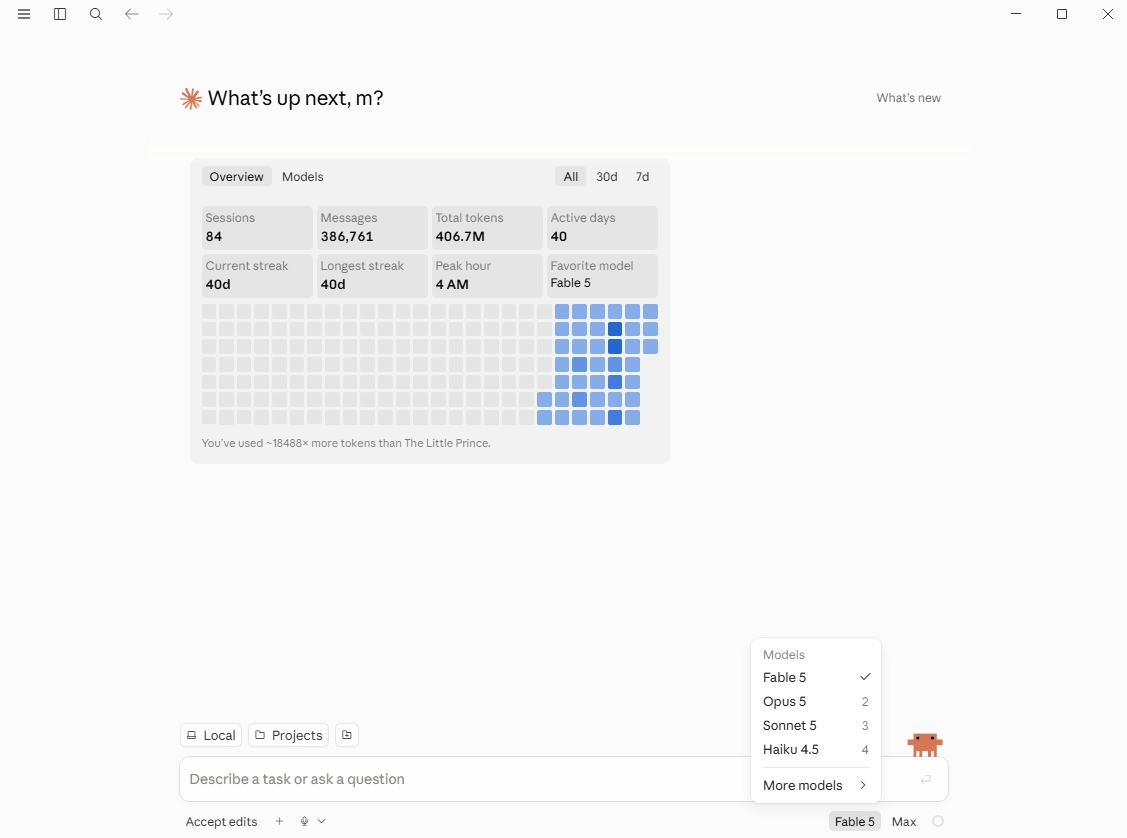
Anthropicは現在、Claudeを3つの主要な形で提供しており、適切な選択はその作業が何を生み出すかで決まります。
**Claude(Webとデスクトップのチャット)**は、このガイドのあらゆるワークフローに最適なツールです。ブレインストーミング、メモからの統合、セクションの下書き、そして改稿の各段階に対応します。会話型で、すぐに開始でき、Web検索も含まれます。
知識作業におけるエージェント型の選択肢は Claude Cowork です。エージェントはClaudeデスクトップアプリの中に存在します。セットアップは不要です。複数ステップのタスクはそれ単体で処理されます(読書メモのフォルダを整理する、十数本の論文から比較表を作る、あるいは一次案として注釈付き文献目録を組み立てるなど)。それは隔離された環境で動作するためです。つまり、機密性の高い下書きを扱う際は、より安全なエージェントだということです。タスクが会話ではなく文書を生成する場合、Coworkは通常チャットよりも優れます。
Claude Code はターミナルで動作し、ソフトウェアを書く人のために作られています。研究者にとっては、分析作業でその価値を発揮します。データのクリーニング、統計スクリプトの実行、再現可能な図の作成、プロジェクトのリポジトリ内での作業です。コマンドラインを一度も触らないなら飛ばして構いません。Coworkはセットアップなしで、エージェント型の領域をカバーします。
Claudeの下書きを検出前にhumanizerする
検出に引っかかりにくい引用対応のhumanizationで、学術的なトーン、専門用語、そして意味をそのまま保ちます。Claude支援の下書きから投稿までのステップ。
AI humanizer無料で試す研究者はどのClaudeモデルを選ぶべき?
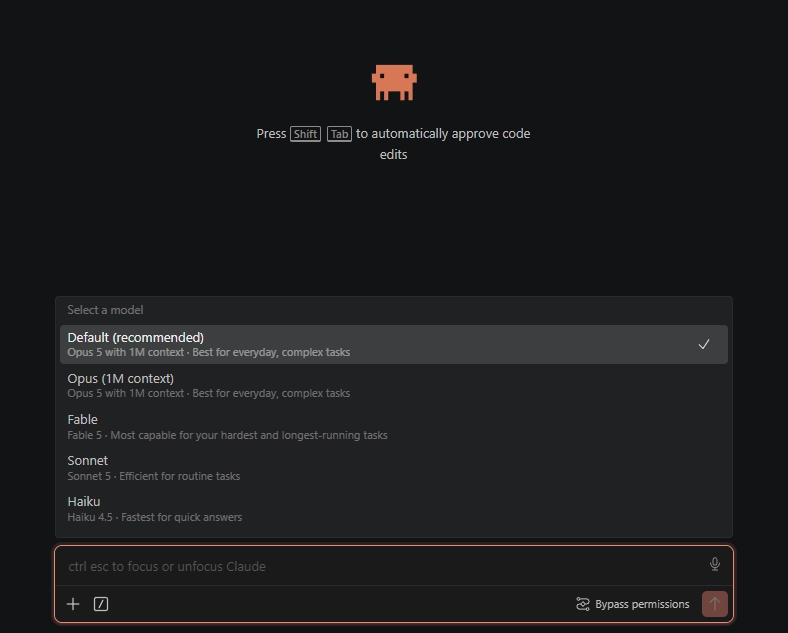
本記事執筆時点のラインナップは、まずFable 5がトップ。その次にOpus 5、Sonnet 5、そして速くて安価なHaiku 4.5です。
Sonnet 5 は、日々の執筆作業のための妥当なデフォルトです。アウトライン作成、段落の下書き、改稿用プロンプトなどに適しています。速く、品質面での上限が幅広く、ほとんどの論文の多くのセクションをカバーします。
Fable 5 は、推論が難しい局面に取りにいくモデルです。文献間で矛盾する結果を突き合わせるとき、方法論の主張をストレステストするとき、あるいは全原稿をコンテキストに保持しながら内部整合性を確認するときに向いています。プランの上限をより早く消費するため、強く求めるべき質問に対して呼ぶ専門家として扱ってください。
Opus 5 はその中間で、長い推論はSonnetよりも強く、Fableよりも日中ずっと回しても安く済みます。最上位モデルの上限が厳密に計測されるなら、Opusは実務上の妥協案としての主力になります。
Haiku 4.5 は素早い機械的な依頼をさばきます。体裁の整形、定義、時制の修正などです。引用したり提出したりする可能性がある内容に対しては使わないでください。
2026年10月の学術執筆に最適なClaudeモデル
ほとんどの学術執筆に最適なClaudeモデルは Claude Opus 5.5 です。これは、Anthropicのモデルガイドで、ほとんどの作業の出発点として現在推奨されています。最新モデルは Fable 5.1、Opus 5.5、Sonnet 5.5 です。Anthropicは、要求水準の高い推論や長時間稼働が必要な場合、またはより高い労力設定の「Opus 5.5」で十分な結果が得られない場合に、Claude Fable 5.1を推奨しています。
AnthropicはClaude Sonnet 5.5を「速度と知性の最良の組み合わせ」と表現しており、日常的なアウトライン作成や下書きに適しています。Claude Haiku 4.5は最速のモデルで、素早い体裁調整や定義には問題ありません。
| モデル | Anthropicの説明 | コンテキストウィンドウ | 信頼できる知識のカットオフ | API 出力トークン 100万あたりの価格 |
|---|---|---|---|---|
| Claude Fable 5.1 | 負荷の高い推論と長期的なエージェント作業 | 1M トークン | 2026年6月 | US$50 |
| Claude Opus 5.5 | 速度と知性の最良の組み合わせ | 1M トークン | 2026年6月 | US$20 |
| Claude Sonnet 5.5 | 速度と知性の最良の組み合わせ | 1M トークン | 2026年6月 | US$10 |
| Claude Haiku 4.5 | 最速のモデルでほぼ最先端の知性 | 200K トークン | 2025年2月 | US$5 |
知識のカットオフは研究において重要です。Haiku 4.5 の信頼できるカットオフは2025年2月です。そのため、分野の最新文献には依存しないでください。その他3つのモデルは2026年6月のカットオフなので、言及している各出典は論文そのものに対して必ず確認してください。
多数の情報源にまたがる文献の統合を行う場合、または全文原稿の整合性チェックをする場合は、Fable 5.1 が最も強い選択です。日常的な文章作成なら、Opus 5.5 または Sonnet 5.5 で十分です。セクション別にみる学術執筆に最適なAIモデル で、ChatGPT と Gemini についても比較しています。
努力レベル: モデルはどれくらい考えるべきか
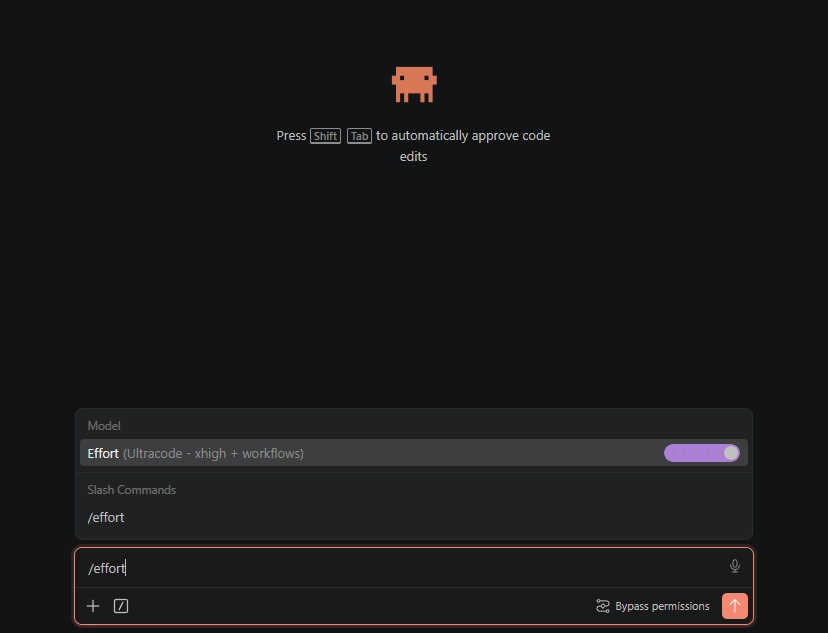
Claude のエージェント機能には、回答するまでにモデルが費やす推論量を調整する努力設定があります。低、中、高、xhigh、そしてセッション限りの最大値です。さらにプロンプトごとのブーストもあります。依頼文に "ultrathink" という語を含めると、その1ターンだけ推論が深くなり、セッション設定は変わりません。
質問の重み(内容の比重)に合わせてレベルを選びましょう。機械的な整形のためなら中で十分です。通常の文章作成や修正作業のセッションには高が向いています。xhigh と最大値は、本当に分析負荷の高い問いに限って使ってください。たとえば30本の情報源にまたがる統合、統計的な設計判断、全文原稿の整合性チェックです。努力を高くすると、必要なトークン数と回答あたりの時間が増えます。そのため毎回を最大に固定するとルーティン作業が遅くなり、得られるものがないのに計画の余力を消費します。必要な精度が非常に高い実際の研究を行うときだけ使いましょう。
いつセッションをコンパクトにするか
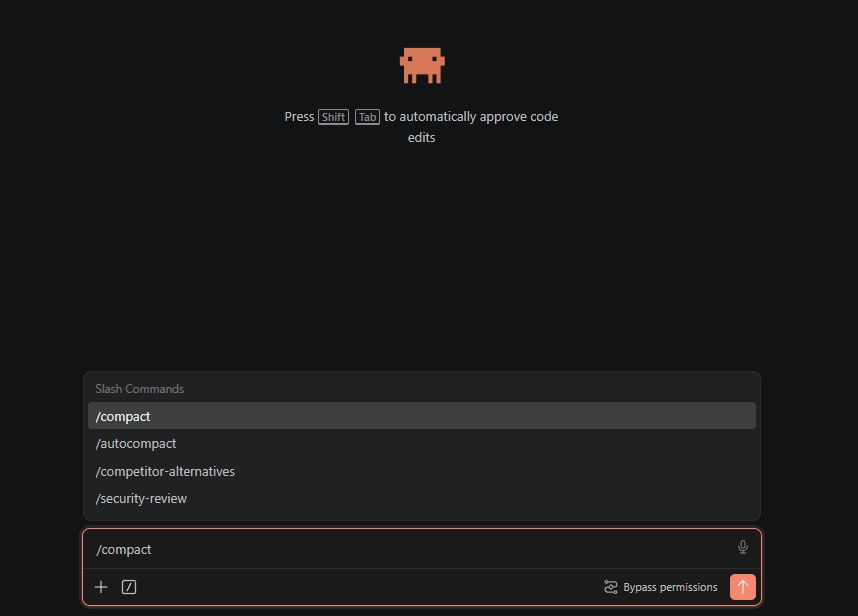
長い会話は劣化します。メッセージごとに会話全体が持ち運ばれるため、最初は冴えていたセッションでも、コンテキストウィンドウが埋まってくると遅くなり、より早い段階から指示が落ちていきます。研究者はこれを疲労として気付きます。最初の3つのプロンプトを正確に処理したモデルが、15回目には曖昧な出力を出すのです。
解決策は圧縮です。これまでの会話内容を要約に畳み込み、その要約をモデルが引き継ぐ形にします。うまく機能する経験則は2つあります。タスクが完了したら、文献セクションが終わり、方法の作成に入ろうとする自然な境界で圧縮することです。あるいは、トークンメーターを見て、ツールに上限ギリギリまで強制されるのを待つのではなく、コンテキスト使用量の約25パーセント時点で圧縮します。 Anthropicの公式ガイダンスでも同じことが述べられており、品質がすでに下がってからではなく、タスク境界で先回りして圧縮するよう推奨しています。きれいな境界での圧縮ならコストはかかりませんが、タスク途中で無理に圧縮すると、本来保持したかったニュアンスが失われます。
研究者にとってClaude Maxの料金プランは価値がありますか?
Claude Proは月額$20です。MaxはProの使用量の5倍に相当する$100の階層と、20倍に相当する$200の階層があります。カジュアルに使う場合、1日に数回程度の会話ならProで十分で、Maxは余裕が持て余します。
信頼性の高い本格的な研究作業なら、Maxは確実に価値があります。長文書に対する文献の統合、全文原稿レベルでの一貫性チェック、そしてCoworkやClaude Codeでのエージェント型セッションは、使用量を素早く消費します。そのためProの上限は、最も重要な場面であるまさにそのセッションを中断させてしまいます。$100の階層なら、多くの個人研究者にとって日次の上限を超えずに済みます。$200の階層は、これらのツールを1日中使う人向けです。もし、締切前日の夜に止まったセッションが$100以上の損失につながるなら、計算上の答えは自ずと明らかになります。
学術研究者向けの無料のClaudeプランはありますか?
はい、Anthropicの 科学者向けClaude Teamプランでは、検証済みの研究グループにClaudeを無料で開始できます。認定された大学の研究責任者(PI)や非営利の研究機関の研究者が申請可能です。対象は自然科学、数学、コンピュータ科学、工学および関連分野で、世界中の10,000人の科学者まで受け付けています。
検証済みのPIはClaude Teamプランを受け取り、Standard席に自分のグループを無料で追加できます。またはPremium席に追加する場合は月額US$15です。Standard席は通常月額US$20、Premium席は月額US$100で、キャンペーン価格はサインアップから12か月間有効です。年払いの費用は、年あたり席1つでUS$0またはUS$180です。Anthropicは提供枠に限りがあり、最終価格は検証後に確定するとしています。
| 席 | 12か月間の料金 | 通常価格 | 含まれる内容 |
|---|---|---|---|
| Standard | 月額US$0 | 月額US$20 | Claude Science、Claude Code、Cowork、研究データベースのコネクタ、共有プロジェクト、シングルサインオン |
| Premium | 月額US$15 | 月額US$100 | Standardのすべてに加え、長時間の分析向けに使用量が5倍で上限も高い |
グループの席数は1から25までで、より大規模なグループはAnthropicに連絡できます。検証は、ほとんどの申請で5営業日から7営業日かかります。必要な席数を超えるプロジェクトでは、AnthropicのAI for Science助成金プログラムを通じて追加クレジットを申請できます。
これらの分野に該当しない場合、または一人で使う場合は、Claude Proの費用は月額US$20、もしくは年払いで月額換算US$17です。どのプランを使う場合でも、提出前に弊社のAI校正ツールで編集のパスを通して最終文面を確認してください。
なぜClaudeなのですか。ChatGPTやGeminiではだめですか?
研究用途では、Claudeは3つのフロンティア型アシスタントのうち現時点で最も信頼性が高いと実証されています。2026年、独立した精度トラッカーはClaudeの幻覚(ハルシネーション)率を約3パーセントと推定し、主力のGPTおよびGeminiモデルはそのほぼ倍でした。不確実性への対応も同じくらい重要です。Claudeは、答えを捏造するより先に「分からない」と言うことが多いからです。自信満々の捏造が、学術作業を最も傷つける失敗モードです。
資格が2つあります。どのモデルも引用文献を作り上げます。査読付き2026年比較では、3人のアシスタントはいずれも検証可能な参考文献リストを作成できませんでした。つまり、モデルが挙げた引用であっても、確認せずにあなたの論文に載ることはありません。単なる基本的な作業で、表の体裁を整える、物をすばやく変換する程度なら、3つの間に大きな違いはありません。ただし重要なのは、あなた自身の出典に基づく継続的な推論です。
Claudeを使ってAI検出に引っかからない方法
Claudeが下書きした文章には、AI検出器が検出しようとする統計的なパターンが含まれており、大学は提出物をTurnitinのAIインジケーターにかけることがますます増えています。安全を保つには3つの実践があります。Claudeは思考作業(構成、批評、出典の要約)に使い、ポリシーで求められる場合を除き、最終的な文章は自分で書きます。ジャーナルや所属機関がAI支援の開示を求める場合は開示してください。私たちのAI開示ステートメントのガイドにはテンプレートがあります。そして、ポリシーがAIによる下書きを許可している場合は、その出力を自分の文体に合わせて書き直すか、引用と用語を保持する学術テキスト humanizerに通し、その後提出前に検出器で結果を確認します。やってはいけないのは、モデルの出力をそのまま提出することです。検出に関して確実に失敗しやすく、文章のクセを知っている試験担当者には、ありふれた一般的な文章に見えてしまいます。
学術文書でClaudeが間違える点
透明性は重要です。ここで私たちが見てきたClaudeの失敗例はこちらです:
引用文献。 Claudeは、実在しない著者名、雑誌名、出版年をもっともらしく生成することがあります。Claudeが検証していない参考文献を提供することは決して許さないでください。また、Claudeに「実際にその引用が存在するか」を確認させ、そのDOIを提示させることもできます。そうすれば、後で各引用のDOIを開いて、本当に存在するかを確かめられます。
分野固有の慣習。 Claudeは分野別の規範を見落とす可能性があります。分野の慣習はClaudeよりあなたのほうがよく知っているはずです。モデルの出力よりも、あなたの専門知識を信頼してください。
定量的な主張。 Claudeは、ときどき元のデータにない統計的な主張を導入します。あなたが提示していない数字が出てきたら、それを検証してください。
文体の調整。 Claudeは文章が上手いのですが、あなたのようには書けません。必ず声(自分の文体)を確認してください。一般的な言い回しを自分のパターンに置き換えることです。あなたの指導教員は定期的にあなたの文章を読んでいます。それはあなたらしく聞こえるべきです。
これらはClaudeを避ける理由ではありません。監督のもとで使う理由です。
よくある質問
Q: 大学は学術文書のためにClaudeの使用を認めていますか?
それは所属機関の方針次第です。ほとんどの大学では、AIを文章作成ツールとして使うこと(開示があれば許容される)と、AIで生成したものを自分の成果として提出すること(許容されない)を区別しています。ブレインストーミング、アウトライン作成、下書き作成にClaudeを使い、その後に自分の文体に合わせて書き直し、加筆する場合は、ツール利用のカテゴリに入ります。必ずガイドラインを確認し、求められる場合は開示してください。
Q: Claudeは研究執筆でChatGPTと比べてどうですか?
Claudeは長文と繊細な指示への対応が得意です。書式要件を守ることにおいてより信頼性が高く、根拠のない主張を作り込む可能性も低めです。ChatGPTは、表の組み替えなどの機械的な作業のほうが得意です。主要な執筆タスクではClaudeに優位性がありますが、どちらも使えます。AIによる学術ライティング用プロンプトでは、複数のモデルで機能するプロンプトをご紹介しています。
Q: Claudeは研究論文を丸ごと書けますか?
技術的には可能です。ただし、やるべきではありません。1回で生成した全文の質は、研究者の入力を各段階で反映しながら章ごとに作り込んだ論文よりも大幅に低くなります。データの解釈、理論的な枠組み、そして主張の組み立ては、あなた自身から生み出す必要があります。Claudeが最も価値を発揮するのは、構造、言い回し、語数効率といった執筆の機械的な部分を扱うときで、知的な内容はあなたが指揮します。
Q: Claudeで下書きした文章はAI検出器に引っかかりますか?
おそらく引っかかります。編集せずにそのまま提出すると、Claudeの文章パターンはTurnitinやGPTZeroのようなツールで検出可能です。解決策は、Claude下書きをhumanizer化することです。自分の文体を加え、文の構造を変え、humanizationの手順を通します。十分に編集されて個別化され、見直しが行われたClaudeの下書きは、通常、検出のしきい値を下回るスコアになりやすいです。
Q: 大学はClaudeで書いた文章を見抜けますか?
検出器は、その文章を書いたのがどのモデルかは特定できません。ただし、Claudeの生出力は他のモデルの出力と同様の統計的な規則性を持っており、Turnitin-gradeの検出器で高い割合でフラグが立ちます。検出リスクは、どれだけ編集せずにモデルの文章が提出物に残るかに依存し、これはすべてのモデルに等しく当てはまります。したがって、提出先のどこであっても、生のClaude出力を手作業で必ず推敲するのが最善です。
Q: 学術研究にはどのClaudeモデルが最適ですか?
日常的な下書きと推敲にはSonnet 5、推論が本当に難しい場合にはFable 5が適しています。たとえば、複数ソースの統合、方法の批評、あるいは原稿全体を文脈として保持する作業です。Opus 5は、計画に沿った長めのセッション向けの中間オプションで、Haiku 4.5は素早い機械的タスクだけに向いています。どのモデルでも、原稿に届く前にすべての引用と数値を必ず検証してください。
Q: 長いClaudeセッションはどれくらいの頻度で圧縮すべきですか?
完了したタスクの境界ごと、またはコンテキスト使用量の約25パーセントに到達した時点まで、どちらか早いほうで圧縮してください。会話をモデルが引き継げる要約に圧縮し、回答を鋭く保ち、長時間セッションによって徐々に指示を忘れてしまうことを防ぎます。ツールがコンテキスト上限付近で圧縮を強制するまで待つと、通常すでに品質が劣化しており、重要だと思っていた詳細が要約から落ちます。
Q: 学術研究者向けにClaudeの無料プランはありますか?
はい。AnthropicのClaude Teamプランは科学系の研究者向けで、確認済みのPI(主要研究責任者)に対して、無料でTeamプランを開始できます。所属チームは無料のStandard席、またはUS$15のPremium席で参加し、12か月間で割引が適用されます。US$20とUS$100 a月から割引になります。対象は、科学、数学、コンピュータサイエンス、工学の分野で、認可された大学および非営利の研究機関です。
Q: 今日の学術執筆に最適なClaudeモデルはどれですか?
Claude Opus 5.5は、ほとんどの学術執筆の最初の選択として最適で、Anthropicが多くの作業に推奨しているモデルです。一度に多くの情報源を突き合わせて整合させるような難しい推論には、Claude Fable 5.1を使ってください。Sonnet 5.5は日常的なアウトライン作成や下書きに向いており、Haiku 4.5は素早い書式設定のみを行う用途に適しています。
Q: Claude Proは学術研究に十分ですか?
Claude Proは、ほとんどの個人研究者の執筆や推敲に十分です。月額US$20で、年払いの場合は月額US$17です。科学分野で研究グループを率いている場合は、Anthropicによると、科学者向けプログラムの無料Standard席のほうがProよりも利用量が多くなります。
Q: Claude Haiku 4.5は最近の研究を知っていますか?
いいえ。Claude Haiku 4.5の信頼できる知識の更新期限は2025年2月なので、最近の研究を十分に把握していません。Opus 5.5、Sonnet 5.5、Fable 5.1の更新期限は2026年6月です。Haikuは素早い編集に使い、最近の文献に関する内容は必ずご自身の出典と照合してください。
学術的なトーンを保ちつつ、引用にも配慮したhumanization。Claude支援の下書きから、AI検出器に対するあらゆる提出までの間に入れるステップ。
Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。