학술 연구 작성을 위한 Claude: 실전 가이드
학술 글쓰기 보조로서 Claude를 사용하는 실용적인 워크플로와, 진지한 연구에 어떤 Claude 앱, 모델, 작업 수준, 플랜이 맞는지

지난달 한 동료가 스크린샷을 공유했는데, 그 안에는 Claude 대화가 담겨 있었습니다. 그녀는 1시간도 안 되어 브레인스토밍, 아웃라인 작성, 초안 작성, 그리고 저널 논문 서론 전체 수정까지 진행했죠. 같은 부분은 이전 주에 그녀가 3일 걸렸던 작업이었습니다.
그녀는 글쓰기 과정의 올바른 단계에서 올바른 AI 도구를 사용하고 있었습니다.
우리는 수개월 동안 Claude를 학술 글쓰기 워크플로에 통합해 왔습니다. 우리와 사용자들의 흐름 모두요. 이 모델은 연구 글쓰기에 실제 강점이 있지만, 한계도 분명합니다. 어디에 사용하고 어디에서 다른 도구로 전환할지 아는 것이, 평범한 AI 실험과 진짜 생산성 향상 사이를 가릅니다.
Claude가 학술 글쓰기에 잘 맞는 이유
Claude는 우리가 테스트한 대부분의 언어 모델보다 뉘앙스를 더 잘 처리합니다. ChatGPT, Gemini, Grok, Deepseek 등을 포함해요. 학술 글쓰기에 이 점이 중요한 이유는, 학술 글쓰기가 거의 전부 뉘앙스이기 때문입니다.
Claude에게 토론 섹션을 초안으로 써 달라고 하면, 보통 당신의 완곡 표현을 유지합니다. "결과는 시사한다"처럼 쓰고 "결과가 입증한다"처럼 단정하지 않습니다. 또한 비교 테스트에서 GPT보다 등록(문체)과 톤에 관한 지시를 더 일관되게 따릅니다. 그리고 불확실성이 더 적절한 상황에서 과도한 확신을 만들어 낼 가능성도 더 낮습니다.
우리는 다음 세 가지 구체적인 강점을 확인했습니다:
긴 문맥 처리. Claude는 현재 버전 기준 매우 긴 문서를 처리할 수 있습니다. 최대 200K 토큰입니다. 즉, 전체 문헌 검토, 완전한 방법 섹션, 또는 초안 원고 전체를 그대로 붙여 넣고 그에 대해 질문할 수 있습니다. 모델은 수천 단어 이후에 길을 잃기보다, 전체 텍스트에 걸쳐 일관성을 유지합니다.
지시 준수. Claude에게 "과거 시제, 수동태, 격식 있는 문체로 쓰고 결과를 해석하지 말라"고 지시하면, 실제로 그렇게 합니다. 일관되게요. 더 작은 모델이나 일부 경쟁 대형 모델은 더 긴 출력에서 특정 지시에서 벗어나는 경향이 있습니다.
솔직한 불확실성. Claude는 "잘 모르겠습니다" 또는 "충분한 정보를 가지고 있지 않습니다"라고 말할 가능성이 더 큽니다. 답을 지어내는 대신 말이죠. 학술 작업에서는 자신감 있는 환각이 신뢰도를 크게 무너뜨릴 수 있기 때문에, 이 점이 매우 중요합니다.
이 모든 것이 Claude가 당신의 논문을 대신 써 준다는 뜻은 아닙니다. 올바르게 지시할 때, Claude는 정말 유용한 어시스턴트가 됩니다.
워크플로 1: 브레인스토밍과 아이디어 개발
여기가 Claude로 시작하는 것을 권장하는 지점입니다. 논문에서 단 한 글자도 쓰기 전이라면 말이죠.
대화를 열고 연구를 쉬운 말로 설명하세요. 학술 문장 표현은 걱정하지 마세요. 무엇을 연구했고 무엇을 발견했으며 그 의미가 무엇이라고 생각하는지 Claude에게 알려 주세요. 그런 다음 논문에서 가장 강력한 관점을 찾는 데 도움을 요청하세요.
다음은 우리가 사용하는 프롬프트 틀입니다:
I'm writing a paper about [topic]. My main finding is [finding].
The existing literature says [brief summary]. I think my contribution
is [your interpretation].

Help me think through: What's the strongest framing for this paper?
What counterarguments should I address? What's the most interesting
aspect of my findings that I might be underemphasizing?
아래 모든 [대괄호로 묶인 자리표시자]를 여러분의 고유한 자료로 바꾸세요. 여기와 아래의 모든 프롬프트에서요. 제약 조건 줄이 일반적인 산문과 실제로 사용할 수 있는 출력을 가르는 기준이므로, 이것을 그대로 유지하세요.
개방형 토론 대신 구조화된 답변을 원할 때는 요청을 더 구체적으로 다듬으세요:
I'm writing a paper about [topic] for [target journal]. My main finding is
[finding]. The closest prior work is [paper A] and [paper B], which concluded
[their conclusion]. State three candidate framings for my contribution, rank
them by novelty and defensibility, and name the strongest counterargument
against each.
Claude는 이 부분에서 사고 파트너이기 때문에 빛납니다. 단순한 글쓰기 기계가 아닙니다. 모델은 약한 프레이밍에는 반박하고, 당신이 생각하지 못한 관점의 각도를 제안하며, 당신의 기여를 더 명확하게 표현하도록 도와줍니다.
이 도구를 사용해 동급의 박사후 연구원이 혼합 방법 연구를 구성하는 데 어려움을 겪고 있었습니다. 20분 안에 그녀는 자신의 질적 연구 결과가 널리 인용되는 한 프레임워크와 모순된다는 점을 파악했습니다. 그 재구성이 그녀 논문의 핵심 고리가 되었습니다. 첫 제출에서 승인되었습니다.
워크플로 2: 문헌 종합 및 공백(갭) 파악
Claude는 논문을 읽을 수 없습니다. 이 점을 분명히 해야 합니다. 이 모델은 데이터베이스에 접근할 수 없으며, 이를 요청하면 인용문을 환각으로 만들어낼 수 있습니다. 하지만 사용자가 제공한 내용을 종합할 수는 있습니다.
워크플로:
- 출처를 직접 읽어보세요. 핵심 발견, 방법, 결론에 대해 메모하세요.
- 그 메모를 Claude에 붙여넣으세요. 주제나 연대순으로 정리하세요.
- Claude에게 요청해 메모 전반에서 나타나는 패턴, 모순, 빈틈을 파악하게 하세요.
Here are my notes on 12 papers about [topic]:
[paste organized notes]

Synthesize these into 3-4 thematic paragraphs for a literature review.
Identify where authors disagree, where methods differ, and what questions
remain unanswered. Use (Author, Year) citation format. Do not add any
sources I haven't provided.
마지막 지시는 매우 중요합니다. 이 지시가 없으면 Claude가 가끔 그럴듯하지만 완전히 허구인 참고문헌을 삽입할 때가 있습니다. 출력에 있는 모든 인용은 입력에서 제공한 것만 사용해야 합니다.
이 워크플로우는 문헌 검토 초안 작성 시간을 대략 50% 줄여주는 것을 확인했습니다. 어떤 사고를 하는지는, 즉 어떤 논문을 포함할지, 어떤 주제가 나타나는지, 어떤 공백이 있는지 등은 여전히 사용자 것이며, Claude는 사용자의 사고를 산문으로 정리해 줍니다.
논문 각 섹션에 맞게 설계된 더 많은 프롬프트는 학술 작성을 위한 검증된 AI 프롬프트 모음을 참고하세요.
워크플로 3: 섹션을 초안으로 작성하고 구조화하기
여기서 Claude는 전통적인 의미의 글쓰기 도우미가 됩니다. 아이디어, 데이터, 주장 구조를 이미 갖고 계신 거죠. 불릿 포인트를 문단으로 바꾸는 데 도움이 필요합니다.
Claude에게 한 번에 전체 논문을 초안으로 작성해 달라고 요청하기보다는 섹션별 접근 방식을 권장합니다. 한 번의 응답에서 800~1,000 단어 이상을 요구하면 품질이 극적으로 떨어집니다.
저희가 선호하는 프로세스:
- 개요를 제공하세요. 섹션 구조를 Claude에 전해 주세요. 각 제목 아래에 글머리표를 사용하세요.
- 제약을 지정하세요. 분량, 시제, 태, 문체, 격식, 인용 스타일을 정해 주세요.
- 한 번에 한 섹션씩 초안을 작성하세요. 다음으로 넘어가기 전에 각 섹션을 검토하세요.
- 대화 중에 반복하세요. Claude에게 특정 문단을 조정해 달라고 요청하세요. 이를테면 이 부분을 더 간결하게, 저 부분은 더 확장하고, 이 전환을 더 매끄럽게 만들어 달라고요.
핵심 통찰: Claude를 광범위한 브리핑이 필요한 유령작가처럼 대하라. "논의 섹션을 써줘"는 일반적인 글을 만든다. "내 발견 X를 Smith (2023) 및 Chen (2024)와 비교하는 300단어 단락을 작성하되, 그 불일치를 설명하는 방법론적 차이를 언급해줘"는 유용한 결과를 만든다.
대부분의 초안 작성 세션을 커버하는 세 가지 템플릿이 있습니다. 초안을 쓰기 전에 한 섹션을 개요로 만들려면:
Build a paragraph-level outline for the [introduction/discussion] of a paper
on [topic]. Audience: [field] researchers. The section must move from
[opening premise] to [closing claim] in no more than [N] paragraphs. For
each paragraph give a one-line purpose and the evidence it should cite from
my notes: [paste notes].
실제로 수행한 범위 안에 머무르는 방법(Methods) 문단 초안을 작성하려면:
Draft a [word count]-word methods paragraph describing [procedure]. Past
tense, passive voice, formal register, [citation style]. Include these
details exactly as given: [sample size, instruments, parameters]. Do not
add any procedure or measurement I have not listed.
그리고 모델이 이를 해석하지 못하게 하면서 결과를 산문으로 바꾸려면:
Turn these results into two paragraphs of formal prose: [paste table or
bullet results]. Report every statistic exactly as written. Describe
patterns without interpreting them; interpretation belongs in the
discussion section.
작업 흐름 4: 수정과 자기 교정
초안을 작성한 다음에는, 손으로 쓴 것이든 Claude의 도움을 받은 것이든, 또는 둘을 섞은 것이든, Claude가 강력한 수정 도구가 됩니다.
한 구간을 붙여 넣고 구체적인 질문을 해 보세요:
Review this paragraph for logical flow. Does the argument progress
clearly from premise to evidence to conclusion? Identify any gaps
in reasoning.
Reduce this paragraph from [current] to [target] words without losing any
claim, number, or citation: [paste paragraph]. Keep the academic register
and my terminology.
Read this section as a hostile reviewer for [journal]: [paste section].
List the five weakest points in order of severity, quote the exact sentence
each weakness lives in, and say what evidence or rewording would fix it.
마지막 프롬프트는 우리가 가장 좋아하는 것. Claude의 "적대적인 심사자" 페르소나가 논리적 허점, 근거 없는 주장, 그리고 여러 차례 수정한 뒤에는 당신이 더는 보지 못하게 된 구조적 약점을 잡아냅니다. 실제 심사자가 잡아내는 모든 것은 아니지만, 5분의 가치가 있을 만큼은 잡아냅니다.
제출 전에 섹션 전반에서 일관성을 확인하기 위해서도 Claude를 사용합니다:
Here are my abstract and conclusion: [paste both]. List every claim in the
abstract that the conclusion does not support, and every conclusion claim
missing from the abstract. Then check that every number appearing in both
matches exactly.
섹션 간 불일치는 가장 흔한 수정 단계의 문제 중 하나이며, 몇 주 동안 원고 안에서만 지내다 보면 알아차리기 어렵습니다.
Claude를 계속 사용하다가 언제 도구로 전환해야 하는지
Claude는 만능형 모델입니다. 여러 작업에 두루 강하고, 어떤 작업에서는 특히 뛰어납니다. 하지만 학술 글쓰기 과정의 특정 단계에서는 전용 도구가 더 우수합니다.
교정용: AI 교정 도구로 전환하세요. Claude는 문법 오류를 찾아낼 수 있지만, 추적된 변경이나 체계적인 문장별 검토를 제공하지는 않습니다. 제출용으로 바로 쓸 수 있게 다듬는 데는 전담 교정자가 더 빠르고 더 철저합니다.
요약용: AI 요약기는 학술 텍스트 압축을 더 체계적으로 처리하며 - 핵심 연구 결과, 통계적 세부 정보, 그리고 Claude가 때때로 누락하는 인용 정보를 보존합니다.
AI-assisted 텍스트를 humanizer로 다듬기: 전용 humanization 도구는 감지기가 표시하는 특정 패턴을 처리합니다. Claude는 자신의 출력에서 효과적으로 디패턴을 제거할 수 없습니다. "더 자연스럽게" 쓰라고 요청해도 동일한 통계적 시그니처를 그대로 재현합니다.
인용 형식용: Zotero, Mendeley 또는 참고문헌 관리자를 사용하세요. Claude는 겉보기에는 올바른 인용을 형식화하지만, 미묘한 오류가 포함될 수 있습니다. 예를 들어 날짜 형식이 잘못되거나, 스타일이 일관되지 않거나, 가끔 DOI가 실제와 다르게 만들어집니다.
이상적인 작업 흐름은 사고와 초안을 작성할 때 Claude를 사용한 다음, 다듬기와 최종화를 위해 전문 도구로 전환하는 것입니다. 이것이 전문적인 글쓰기가 작동하는 방식입니다.
작업 흐름 5: 동료 심사자에 대응하기
검토자 응답의 보상 구조와 어조 제어는, 언어 모델이 초안을 작성하는 데 특히 잘하는 부분입니다. 결정 서신과 작업 항목을 항목별로 그대로 붙여 넣으세요. Claude에게 각기 다른 비판을 모두 번호 매긴 목록으로 추출하게 하고, 각 항목에 대해 중립적인 응답 골격을 작성하게 하며, 문구를 바꾸는 것이 아니라 새로운 분석이 필요한 지점을 표시하게 하세요. 과학적 핵심은 직접 유지하세요. 원고에서 무엇이 바뀌었는지, 무엇을 방어하는지, 그리고 심사자가 사실상 어디에서 틀렸는지입니다. 모델의 기여는 첫 번째 시도에서 차분하고 체계적으로 읽히는 응답 문서입니다. 하나의 프롬프트로 전체 구조를 설정합니다:
Here is the decision letter for my manuscript: [paste letter]. Extract every
distinct criticism into a numbered list. For each point, draft a two-sentence
neutral response skeleton and label it: revise, defend, or needs new analysis.
Do not invent any changes I have not described.
저희의 학술 작성을 위한 프롬프트 모음에는 바로 사용할 수 있는 검토자 답변 프롬프트가 더 많이 포함되어 있습니다.
Claude, Cowork, 또는 Claude Code 중 어떤 것이 연구 작업에 맞을까요?
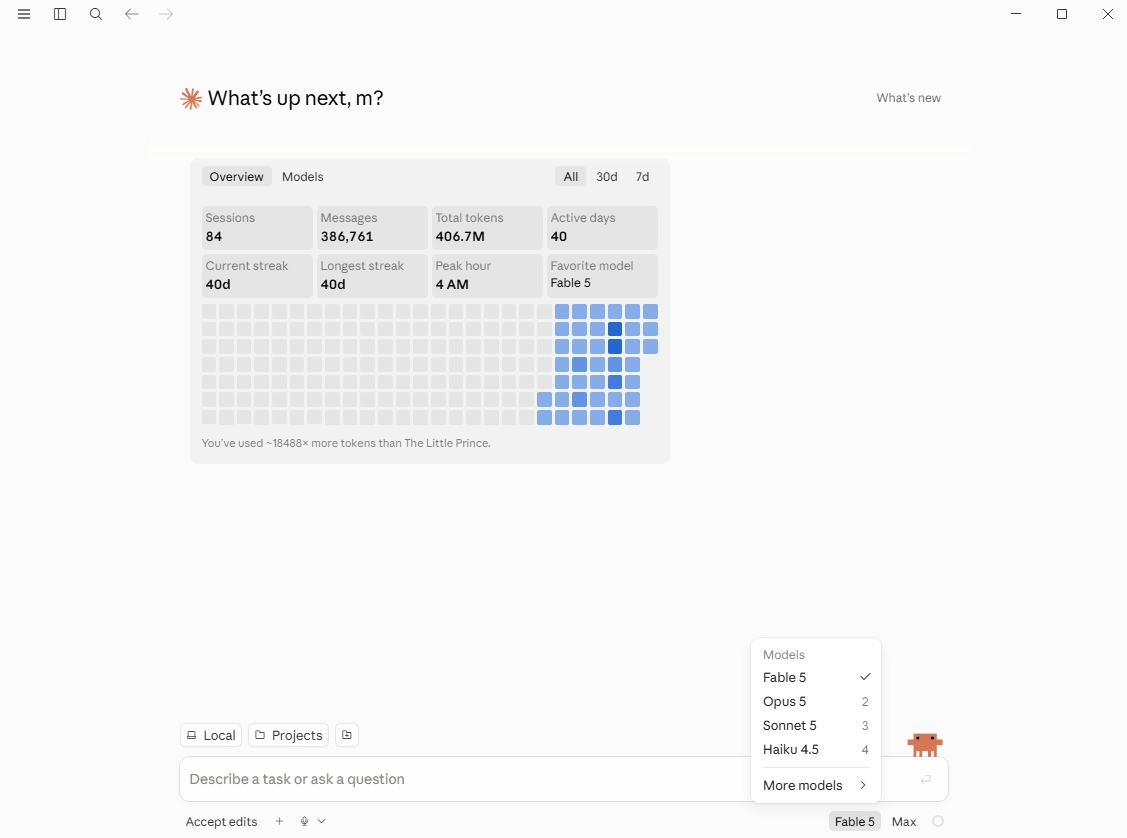
Anthropic은 이제 Claude를 세 가지 주요 형태로 제공하며, 어떤 것을 선택할지는 작업 결과물에 따라 달라집니다.
**Claude(웹 및 데스크톱 채팅)**은 이 가이드의 모든 워크플로에 맞는 도구입니다. 브레인스토밍, 메모로부터의 종합, 섹션 초안 작성, 그리고 수정 라운드까지 모두 가능합니다. 대화형이며 즉시 시작되고 웹 검색 기능이 포함되어 있습니다.
지식 작업을 위한 에이전트형 옵션은 Claude Cowork입니다. 이 에이전트는 Claude 데스크톱 앱 안에 내장되어 있습니다. 설정이 필요 없습니다. 다단계 작업은 그 자체로 처리됩니다(예: 독서 노트 폴더를 정리하고, 스무 편가량의 논문으로 비교 표를 만들고, 1차 주석 달린 참고문헌 초안을 조립하는 것). 또한 격리된 환경에서 실행됩니다. 즉, 민감한 초안을 처리할 때 더 안전한 에이전트입니다. 작업이 대화가 아니라 문서를 만들어내는 경우, Cowork은 보통 채팅보다 더 유리합니다.
Claude Code는 터미널에서 실행되며 소프트웨어를 작성하는 사람들을 위해 만들어졌습니다. 연구자에게는 분석 작업에서 그 가치를 발휘합니다. 데이터를 정리하고, 통계 스크립트를 실행하고, 재현 가능한 그림을 만들고, 프로젝트 저장소 안에서 작업하는 것입니다. 커맨드 라인을 전혀 건드리지 않는다면 건너뛰세요. Cowork은 설정 없이도 에이전트형 범위를 커버합니다.
Humanize Your Claude Draft Before a Detector Reads It
인용문에 안전한 humanization으로 학술 톤, 용어, 의미를 그대로 유지합니다. Claude 도움을 받은 초안과 제출 사이의 한 단계.
AI Humanizer Free를 무료로 사용해 보세요연구자는 어떤 Claude 모델을 선택해야 할까요?
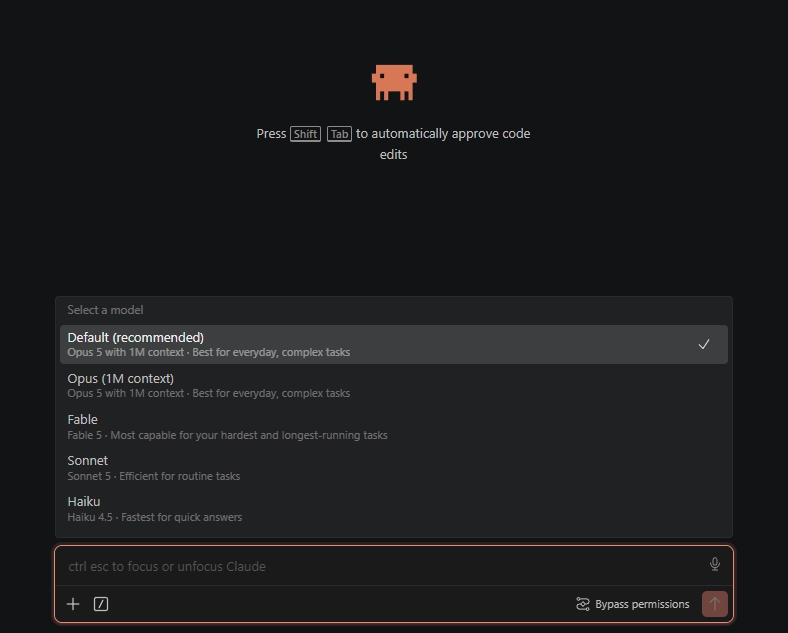
이 글을 쓰는 시점 기준으로, 라인업의 최상단은 Fable 5이고 그다음이 Opus 5, Sonnet 5, 그리고 빠르고 저렴한 Haiku 4.5입니다.
Sonnet 5는 매일의 글쓰기 작업에서 합리적인 기본값입니다. 개요 작성, 문단 초안 작성, 수정 프롬프트 같은 작업에 적합합니다. 빠르며, 품질의 상한이 대부분의 논문 대부분 섹션을 커버합니다.
Fable 5는 추론이 가장 어려운 부분일 때 선택해야 하는 모델입니다. 예를 들어 한 문헌에서 서로 모순되는 연구 결과를 조정하고, 방법론 주장에 대해 스트레스 테스트를 하고, 전체 원고를 문맥 안에서 유지하면서 내부 일관성을 확인하는 경우입니다. 플랜 한도를 더 빨리 소모하므로, 그만큼 가치가 있는 질문에 대해 부르는 전문가는 바로 이 모델이라고 생각하세요.
Opus 5는 그 둘 사이에 있으며, Sonnet보다 긴 추론에서 더 강하고, Fable보다 훨씬 저렴하게 하루 종일 돌릴 수 있습니다. 상위 모델에 대한 플랜 허용량이 빡빡하다면 Opus가 가장 현실적인 타협안인 작업 말(워크호스)입니다.
Haiku 4.5는 빠른 기계적 요청을 처리합니다. 형식 재정리, 정의, 문장 시제 수정 같은 작업에 적합합니다. 인용하거나 제출해야 하는 어떤 작업에도 사용하지 마세요.
2026년 10월 기준 학술 글쓰기에 가장 좋은 Claude 모델
대부분의 학술 글쓰기에 가장 좋은 Claude 모델은 Claude Opus 5.5이며, 이는 Anthropic의 모델 가이드에서 이제 대부분의 작업을 시작하는 지점으로 권장합니다. 최신 모델은 Fable 5.1, Opus 5.5, Sonnet 5.5입니다. Anthropic은 까다로운 추론과 오래 걸리는 작업에는 Claude Fable 5.1을 제안하거나, 상위 노력 설정에서의 Opus 5.5가 충분히 좋은 결과를 주지 못할 때를 말합니다.
Anthropic은 Claude Sonnet 5.5를 속도와 지능의 가장 좋은 조합이라고 설명하며, 이는 일상적인 개요 작성과 초안 작성에 잘 맞습니다. Claude Haiku 4.5는 가장 빠른 모델이며, 빠른 형식 정리와 정의에는 적합합니다.
| 모델 | Anthropic의 설명 | 컨텍스트 창 | 신뢰할 수 있는 지식 컷오프 | API 출력 토큰 100만 개당 가격 |
|---|---|---|---|---|
| Claude Fable 5.1 | 까다로운 추론과 장기형 에이전틱 작업 | 1M 토큰 | 2026년 6월 | US$50 |
| Claude Opus 5.5 | 장시간 실행되는 에이전틱 코딩과 지식 작업 | 1M 토큰 | 2026년 6월 | US$20 |
| Claude Sonnet 5.5 | 속도와 지능의 가장 좋은 조합 | 1M 토큰 | 2026년 6월 | US$10 |
| Claude Haiku 4.5 | 거의 프론티어 수준의 지능을 갖춘 가장 빠른 모델 | 200K 토큰 | 2025년 2월 | US$5 |
지식 컷오프는 연구에 중요합니다. Haiku 4.5의 신뢰할 수 있는 컷오프는 2025년 2월이므로 해당 분야의 최신 문헌에는 의존하지 마세요. 나머지 세 모델은 2026년 6월 컷오프이며, 그들이 언급하는 모든 출처는 논문 자체에서 확인해야 합니다.
다양한 출처를 아우르는 문헌 종합이나, 전체 원고의 일관성 점검에는 Fable 5.1이 가장 강력한 선택입니다. 일상적인 초안 작성에는 Opus 5.5 또는 Sonnet 5.5면 충분합니다. 섹션별로 보는 학술 글쓰기에 가장 적합한 AI 모델 비교에서는 ChatGPT와 Gemini도 함께 다룹니다.
노력 수준: 모델이 얼마나 열심히 생각해야 할까요?
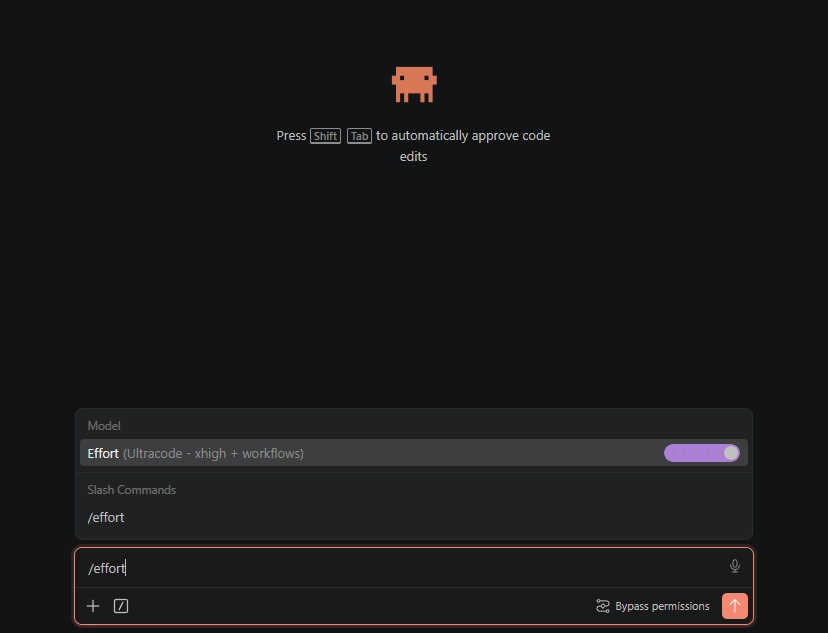
Claude의 에이전틱 도구에는 답변하기 전에 모델이 사용하는 추론의 양을 제어하는 노력 설정이 있습니다. 낮음, 중간, 높음, xhigh, 그리고 세션 전용 최대치가 있습니다. 또한 프롬프트별 부스트도 있습니다. 요청에 "ultrathink"라는 단어를 포함하면 세션 설정을 바꾸지 않으면서 그 한 턴에 더 깊은 추론이 적용됩니다.
질문에 담긴 비중에 맞춰 레벨을 정하세요. 기계적인 정리는 중간이면 충분합니다. 일상적인 초안 작성과 수정 세션에는 높음을 권장합니다. xhigh와 최대치는 실제 분석적 부담이 큰 질문에만 예약하세요. 예를 들어 서른 개 출처에 대한 종합, 통계적 설계 결정, 전체 원고 수준의 일관성 점검 같은 경우입니다. 노력도가 높을수록 답변에 드는 토큰과 시간이 더 늘어나므로, 매 세션을 최대치로 고정하면 작업 속도가 느려지고 얻는 이득이 없어 일상 흐름이 지칩니다. 반드시 정확도가 매우 높아야 하는 실제 연구를 할 때만 사용하세요.
세션을 언제 압축할까요?
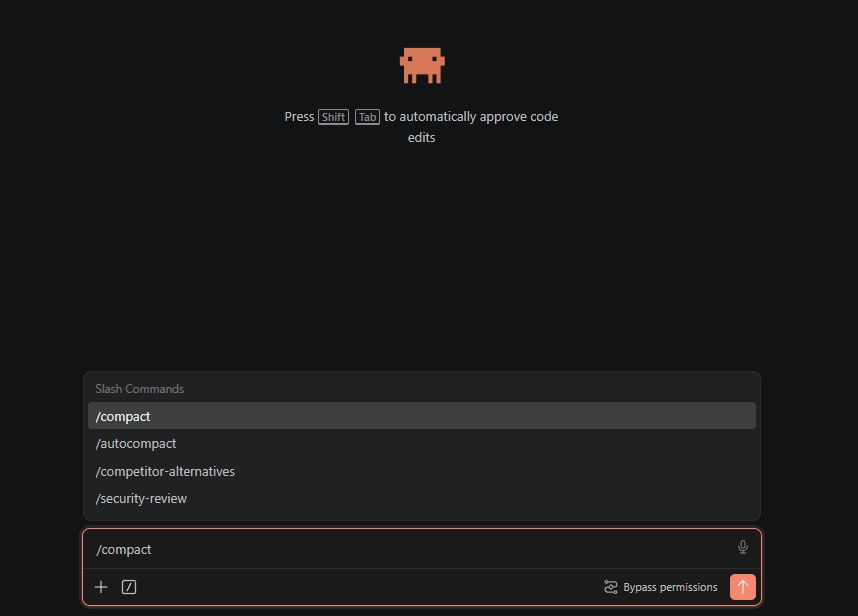
긴 대화는 품질이 떨어집니다. 모든 메시지가 그때까지의 전체 대화를 함께 담고 있으므로, 처음 날카롭게 시작한 세션도 시간이 지나며 더 느려지고 컨텍스트 창이 채워지면서 더 이른 시점부터 지침이 누락되기 시작합니다. 연구자들은 이를 피로로 체감합니다. 예를 들어 처음 세 프롬프트는 정확하게 처리하던 모델이 열다섯 번째에는 모호한 출력이 나오는 식입니다.
해결책은 컴팩팅입니다. 지금까지의 대화를 요약으로 압축해서 모델이 계속 들고 가는 방식이에요. 잘 작동하는 두 가지 경험 법칙이 있습니다. 완료된 작업이 끝날 때마다 자연스러운 경계에서 컴팩팅하세요. 문헌 섹션이 끝나고 방법(Methods) 파트가 시작하려는 지점이 그 경계입니다. 또는 토큰 미터를 보고, 도구가 한계에 가깝게 강제로 처리하도록 기다리는 대신 컨텍스트 사용량의 약 25퍼센트 지점에서 대략 컴팩팅을 하세요. Anthropic의 자체 가이드도 같은 말을 합니다. 품질이 이미 떨어진 뒤가 아니라 작업 경계에서 선제적으로 컴팩팅하라는 거죠. 깔끔한 경계에서의 컴팩팅은 비용이 들지 않습니다. 작업 중간에 강제로 컴팩팅하면, 보존하고 싶었던 뉘앙스가 손실될 수 있습니다.
연구자에게 Claude Max 플랜은 가치가 있나요?
Claude Pro는 한 달에 $20입니다. Max는 Pro 사용량의 5배에 해당하는 $100 티어로 제공되고, Pro 사용량의 20배에 해당하는 $200 티어도 있습니다. 가벼운 사용, 하루 몇 개의 대화라면 Pro로 충분하고 Max는 불필요한 여유(헤드룸)입니다.
신뢰할 수 있고 강도 높은 연구 작업이라면 Max는 분명 그만한 가치가 있습니다. 긴 문서에 대한 문헌 종합, 전체 원고 수준의 일관성 검사, Cowork 또는 Claude Code에서의 에이전틱 세션은 사용량을 빠르게 소모하며, Pro의 제한은 가장 중요한 바로 그 세션을 방해합니다. $100 요금제는 대부분의 개별 연구자가 일일 한도를 넘기지 않도록 해줍니다. $200 요금제는 이런 도구를 하루 종일 사용하는 사람들을 위한 것입니다. 제출 마감 전날 밤 세션이 멈춰서(중단돼서) $100보다 더 큰 비용을 치르게 된다면, 그 산술은 저절로 정리됩니다.
학술 연구자를 위한 무료 Claude 플랜이 있나요?
네, Anthropic의 Claude Team for scientists 플랜은 검증된 연구 그룹에 Claude를 시작 비용 없이 제공합니다. 인가된 대학과 비영리 연구 기관의 책임 연구자(PI)는 신청할 수 있어요. 이 프로그램은 자연과학, 수학, 컴퓨터과학, 공학 및 관련 분야를 포함하며, 전 세계 10,000명의 과학자에게 열려 있습니다.
검증된 PI는 Claude Team 플랜을 받고 Standard 좌석을 무료로 추가하거나 Premium 좌석은 한 달 US$15로 추가할 수 있습니다. Standard 좌석은 보통 한 달 US$20이고 Premium 좌석은 US$100이며, 프로모션 가격은 가입일로부터 12개월간 유효합니다. 연간 청구는 좌석당 US$0 또는 연간 US$180입니다. Anthropic은 이용 가능 수량이 제한되어 있으며, 최종 가격은 검증 후 확정된다고 말합니다.
| 좌석 | 12개월 가격 | 정상 가격 | 포함 내용 |
|---|---|---|---|
| 표준 | 월 US$0 | 월 US$20 | Claude Science, Claude Code 및 Cowork, 연구 데이터베이스 커넥터, 공유 프로젝트, 단일 로그온 |
| 프리미엄 | 월 US$15 | 월 US$100 | 스탠더드의 모든 항목에 더해 긴 분석을 위한 더 많은 사용량(5배)과 더 높은 한도 |
그룹은 125석이 있으며, 더 큰 그룹은 Anthropic에 문의할 수 있습니다. 대부분의 신청에서 검증에는 57영업일이 걸립니다. 프로젝트가 좌석 수로 허용되는 범위를 초과해야 할 때, 해당 그룹은 Anthropic의 AI for Science 그랜트 프로그램을 통해 추가 크레딧을 신청할 수 있습니다.
그 분야 밖에서 일하거나 혼자서 작업한다면, Claude Pro는 월 US$20이며, 또는 매년 청구되는 경우 월 US$17입니다. 어떤 요금제를 사용하든 제출하기 전에 최종 텍스트를 AI 교정자의 편집 처리로 확인하세요.
Claude이냐 ChatGPT나 Gemini냐 중에서 왜 Claude인가요?
연구 작업에서는 Claude가 세 가지 프론티어 보조 도구 중 현재 가장 신뢰할 만하다는 것이 입증되었습니다. 2026년 독립 정확도 추적기들이 Claude의 환각 비율을 약 3퍼센트로 추정했으며, 대표 모델인 GPT와 Gemini는 그에 비해 거의 두 배 수준이었습니다. 불확실성 하에서의 행동은 그만큼 중요합니다. Claude는 답을 지어내기보다 자신이 모른다고 더 먼저 말합니다. 자신감 있는 조작이 실패 방식이 되어 학술 작업을 가장 크게 망가뜨릴 수 있습니다.
두 가지 전제. 모든 모델은 인용문을 만들어냅니다. 동료 검토 2026 비교에 따르면 세 보조 도구 모두 검증 가능한 참고문헌 목록을 생성하지 못했습니다. 즉, 모델이 인용한 내용이 검증 없이 그대로 논문에 실릴 수 있다는 뜻입니다. 단순한 기계 작업만 한다면 표를 재서식하거나 내용을 빠르게 변환하는 정도라면 세 가지 사이에 큰 차이는 많지 않습니다. 하지만 중요한 지점은 본인 자료에 대한 지속적인 추론입니다.
Claude를 사용하되 AI 탐지를 피하는 방법
Claude가 작성한 글에는 AI 탐지기가 찾아내는 통계적 패턴이 담기며, 대학들은 제출물을 점점 Turnitin의 AI 표시기로 돌리고 있습니다. 다음 세 가지를 지키면 안전합니다. Claude는 생각을 정리하는 작업에 사용하세요. 예를 들어 구조화, 비판, 자료 요약 등입니다. 정책상 최종 문장을 직접 써야 한다면 그 부분은 직접 작성하세요. 저널이나 기관에서 AI 보조를 요구하는 경우에는 AI 도움을 공지하세요. 저희의 AI 공지 안내문 가이드에는 서식이 있습니다. 그리고 정책이 AI 도움을 통한 초안 작성을 허용한다면, 결과물을 자신의 문체로 다시 다듬거나 학술 텍스트 humanizer를 통해 인용과 용어를 보존한 뒤, 제출 전에 탐지기와 대조해 확인하세요. 하면 안 되는 것은 원문 그대로의 모델 출력물을 제출하는 것입니다. 탐지 실패가 안정적으로 일어나고, 글을 아는 채점자에게는 일반적인 문장만 늘어놓은 것으로 보이기 때문입니다.
학술 글쓰기에서 Claude가 틀리는 부분
투명성은 중요합니다. 여기서 우리는 Claude가 실패하는 장면을 보았습니다:
인용문. Claude는 존재하지 않는 그럴듯한 저자 이름, 저널 제목, 출판 연도를 생성할 수 있습니다. Claude가 검증되지 않은 참고문헌을 제공하도록 두지 마세요. 또는 실제로 그 인용이 존재하는지 확인해 달라고 요청하고 DOI를 함께 받아두면, 이후 각 참고문헌의 DOI를 직접 방문해 실제 존재 여부를 확인할 수 있습니다.
분야별 관례. Claude는 분야마다 다른 고유 관례를 놓칠 수 있습니다. 여러분은 해당 분야의 관례를 Claude보다 더 잘 알고 있습니다. 모델의 출력물보다 여러분의 전문성을 신뢰하세요.
정량적 주장. Claude는 가끔 원본 데이터에 없던 통계적 주장을 끼워 넣습니다. 여러분이 제공하지 않은 숫자가 등장하면 그 수치를 반드시 확인하세요.
문체 톤 조정. Claude는 글을 잘 쓰지만, 여러분처럼 쓰지는 못합니다. 항상 문체를 한 번 점검하세요. 일반적인 표현을 여러분만의 패턴으로 바꾸는 작업입니다. 지도교수는 여러분의 글을 정기적으로 읽습니다. 여러분의 글답게 들려야 합니다.
이들은 Claude를 피해야 할 이유가 아닙니다. 감독과 함께 사용해야 하는 이유입니다.
자주 묻는 질문
Q: 대학에서는 학술 글쓰기에 Claude 사용을 허용하나요?
기관의 정책에 따라 다릅니다. 대부분의 대학은 AI를 글쓰기 도구로 사용하는 것(공지와 함께 허용)과 AI가 생성한 작업을 자신의 것으로 제출하는 것(허용되지 않음)을 구분합니다. 아이디어 구상, 윤곽 정리, 초안 작성에 Claude를 사용한 뒤, 자신의 목소리를 덧붙이고 다시 다듬는 행위는 도구 사용 범주에 해당합니다. 항상 여러분의 지침을 확인하고 요구되는 경우 공지하세요.
Q: Claude는 연구 글쓰기에 대해 ChatGPT와 어떻게 비교되나요?
Claude는 긴 문서와 뉘앙스가 있는 지침을 더 잘 처리합니다. 서식 요구사항을 지키는 데 더 신뢰할 수 있고, 근거 없는 주장을 지어낼 가능성도 더 낮습니다. ChatGPT는 표를 재구성처럼 기계적인 작업에 더 강한 편입니다. 핵심 글쓰기 작업에서는 Claude에 우위를 둡니다. 하지만 둘 다 활용할 수 있습니다. 모델 전반에서 잘 작동하는 프롬프트는 학술 글쓰기를 위한 AI 프롬프트를 참고하세요.
Q: Claude가 연구 논문 전체를 작성할 수 있나요?
기술적으로는 가능합니다. 하지만 그래야 하나요? 아닙니다. 한 번에 생성된 전체 논문의 품질은, 연구자가 각 단계마다 입력을 주며 부분별로 개발한 논문보다 훨씬 낮습니다. 데이터 해석, 이론적 틀, 주장 구성은 반드시 사용자가 직접 가져와야 합니다. Claude는 글쓰기의 기계적인 부분, 즉 구조, 표현, 문장 절약에는 가장 유용하고, 지적 내용의 방향은 사용자가 이끌어야 합니다.
Q: Claude 초안으로 쓴 글이 AI 탐지기에 걸리나요?
대개는 걸립니다. 편집 없이 Claude의 원출력을 그대로 제출하면, Turnitin 및 GPTZero 같은 도구가 Claude의 글쓰기 패턴을 감지할 수 있습니다. 해결책은 Claude 초안을 AI humanizer로 다듬기입니다. 즉, 자신의 목소리를 입혀 문장을 자신의 스타일로 바꾸고, 문장 구조를 다양화한 뒤, 텍스트를 AI humanizer 단계로 한 번 더 거치는 것입니다. 개인화하고 검토까지 마친 잘 편집된 Claude 초안은 보통 탐지 임계값보다 훨씬 낮은 점수를 보입니다.
Q: 대학은 Claude로 작성된 텍스트를 감지할 수 있나요?
탐지기는 어떤 모델이 특정 구절을 썼는지 식별하지 못합니다. 다만 Claude의 원출력은 다른 모델의 출력과 동일한 수준의 통계적 규칙성을 지니고 있으며, Turnitin-grade 탐지기는 높은 비율로 이를 플래그합니다. 탐지 위험은 제출물에 편집되지 않은 모델 텍스트가 얼마나 많이 남아 있는지에 달려 있고, 이 원칙은 모든 모델에 똑같이 적용됩니다. 따라서 제출 전에 어딘가에서라도 Claude의 원출력을 수동으로 반드시 다듬는 것이 가장 좋습니다.
Q: 학술 연구에 가장 좋은 Claude 모델은 무엇인가요?
일상적인 초안 작성과 수정에는 Sonnet 5, 추론이 정말로 어려운 경우에는 Fable 5가 적합합니다. 예를 들어 여러 출처의 통합, 방법론 비판, 또는 전체 원고를 맥락 속에 두고 검토하는 작업이 그렇습니다. Opus 5는 일정한 플랜 안에서 긴 세션을 진행할 때의 중간 옵션이고, Haiku 4.5는 빠른 기계 작업에만 쓰는 것이 좋습니다. 어떤 모델을 쓰든, 원고에 들어가기 전에 모든 인용과 숫자를 반드시 확인하세요.
Q: 긴 Claude 세션을 얼마나 자주 압축해야 하나요?
각 완료된 작업 경계마다 또는 컨텍스트 사용량이 약 25 퍼센트가 되었을 때, 둘 중 먼저 도달하는 시점에 압축하세요. 대화를 모델이 이어서 처리할 수 있도록 요약으로 접어두면 답변이 선명해지고, 긴 세션에서 발생하는 점진적 지침 망각을 막을 수 있습니다. 도구가 컨텍스트 한계 근처에서 압축을 강제할 때까지 기다리면 보통 이미 품질이 떨어진 상태이며, 요약이 신경 쓰던 디테일을 덜 담게 됩니다.
Q: 학술 연구자를 위한 무료 Claude 플랜이 있나요?
네. Anthropic의 Claude Team 플랜은 과학자를 위한 것으로, 검증된 주요 책임 연구자에게 시작 비용 없이 Team 플랜을 제공합니다. 그룹은 무료 Standard 좌석 또는 US$15 Premium 좌석에 참여하며, 이는 각각 US$20 및 월 US$100(12개월)에서 할인된 가격입니다. 이 서비스는 인가된 대학과 비영리 연구기관의 과학, 수학, 컴퓨터 과학, 공학 분야에 해당합니다.
Q: 오늘날 학술 글쓰기에 가장 좋은 Claude 모델은 무엇인가요?
Claude Opus 5.5는 대부분의 학술 글쓰기를 시작하기에 가장 좋은 선택이며, Anthropic이 대부분의 작업에 권장하는 모델입니다. 한 번에 많은 출처를 조화롭게 정리하는 등 더 어려운 추론이 필요할 때는 Claude Fable 5.1을 사용하세요. Sonnet 5.5는 일상적인 개요 작성과 초안 작성에 적합하고, Haiku 4.5는 빠른 서식 작업만 처리하는 데 적합합니다.
Q: Claude Pro로 학술 연구를 하기에 충분한가요?
Claude Pro는 대부분의 개인 연구자가 글을 작성하고 수정하는 데 충분합니다. 월 US$20이며, 연간 결제 시 월 US$17입니다. 과학 분야에서 연구 그룹을 이끌고 있다면, Anthropic에 따르면 과학자 프로그램의 무료 Standard 좌석이 Pro보다 더 많은 사용량을 제공합니다.
Q: Claude Haiku 4.5는 최신 연구를 알고 있나요?
아니요, Claude Haiku 4.5의 신뢰할 수 있는 지식 기준일은 2025년 2월이어서 최신 연구를 잘 알지 못합니다. Opus 5.5, Sonnet 5.5, Fable 5.1의 지식 기준일은 2026년 6월입니다. Haiku는 빠른 수정에 사용하고, 최신 문헌에 대한 내용은 본인 소스와 대조해 확인하세요.
학술적 톤을 유지하는 인용문 안전 humanization. Claude의 보조 초안과 어떤 AI 탐지기든 사이에 놓이는 단계.
Moe는 자연어 처리 분야에 PhD를 갖춘 NLP 엔지니어입니다. 그의 연구는 컴퓨터 언어학, 텍스트 분석 및 기계 학습을 다루며 ProofreaderPro의 편집 및 인간화 모델에 직접 적용됩니다. 그는 대부분의 사람들이 전혀 보지 못하는 프로세스의 일부, 즉 언어 모델이 문장을 읽고 점수를 매기고 무엇을 변경할지 결정하는 방법에 대해 글을 씁니다.